RF-DETR:Tutorial:06-ViT-DINOv2
lastmod 2026-11-18created 2026-11-184 edits
Vision Transformer 와 DINOv2는 RF-DETR 튜토리얼의 6장이다. 5장에서 만든 Transformer 인코더에 그림을 넣기 위해 그림을 작은 조각(패치)의 열로 바꾸는 Vision Transformer(ViT)를 만들고, 그 ViT 를 라벨 한 장 없이 학습시키는 방법인 DINO 와 그 후속작 DINOv2 를 다룬다. DINOv2 로 사전 학습한 ViT 가 바로 RF-DETR 의 백본이며, 다음 장에서는 Transformer 로 탐지를 정면에서 푼 첫 탐지기 DETR 을 만든다.
다루는 내용은 패치 임베딩이 합성곱 하나와 같은 계산인 이유, 토큰 수 \(N = (H/p)(W/p)\) 와 ViT-S 의 매개변수 약 2,200만 개의 부품별 손계산, 해상도 · 패치 크기에 따른 계산량과 위치 임베딩 보간(12장 NAS 손잡이의 바탕), ViT 가 큰 데이터를 필요로 하는 이유와 사전 학습 · 미세 조정, DINO 자기 증류(학생과 EMA 교사, 온도, 교차 엔트로피, 붕괴와 그것을 막는 centering · sharpening), DINOv2 와 레지스터 토큰, RF-DETR 이 이 백본을 고른 이유, 그리고 MiniViT 와 미니 DINO 의 PyTorch 구현과 그 결과다.
- 원문: 06. Vision Transformer 와 DINOv2
- 실습 코드:
code/ch06_vit.py(패치 임베딩 · 매개변수 수 검산, MiniViT 지도 학습, 해상도 바꾸기, 위치 임베딩, 미니 DINO, 붕괴 실험, 선형 분류기, CLS 어텐션). 8GB 노트북 GPU 로 전체 실험에 약 10분 30초,--quick은 오류 확인용 축소판이다. 진짜 DINOv2 의 패치 특징은code/ch06_dinov2_features.py로 본다. 원문 기준 읽는 시간 약 90분, 난이도 ★★★☆☆. - 이전: 05. 어텐션과 Transformer / 다음: 07. DETR: 탐지를 집합 예측으로
탐지기의 눈: 백본
1장에서 본 RF-DETR 의 큰 그림을 다시 떠올려 보자. 그림이 들어오면 맨 먼저 백본 이 그림을 특징 맵으로 바꾸고, 프로젝터가 그것을 다듬고, 디코더가 특징 맵을 들여다보며 박스와 클래스를 낸다. 디코더가 아무리 똑똑해도 백본이 만든 특징에 “여기에 무언가가 있다” 는 정보가 없으면 찾을 수 없다. 탐지기의 정확도는 백본이 얼마나 좋은 특징을 만드느냐에 크게 달려 있다.
RF-DETR 에서 백본의 자리는 다음과 같다(원문 그림 6-1). 그림 (B, 3, H, W) 가 백본(DINOv2 로 사전 학습한 ViT, 이 장) → 프로젝터(9 · 10장) → 디코더(7 – 10장)를 차례로 지나 박스와 클래스가 된다. 백본은 그림을 “패치마다의 특징 벡터” 로 바꾸고, 뒤의 모든 부품은 이 특징만 본다. 이 장은 백본 상자 하나만 다룬다.
RF-DETR 의 백본을 한 줄로 쓰면 “DINOv2 로 사전 학습한 ViT” 이다. 이 말에는 세 가지 물음이 들어 있고, 이 장은 그 순서대로 간다.
- ViT 가 무엇인가. 그림을 어떻게 토큰 열로 바꿔 Transformer 에 넣는가. 얼마나 크고, 얼마나 느린가.
- 사전 학습이 왜 필요한가, 라벨 없이 어떻게 하는가. DINO 의 자기 증류와 DINOv2.
- RF-DETR 은 왜 이것을 골랐고, 어떻게 고쳐 쓰는가.
그림을 토큰 열로 바꾸기
5장의 Transformer 인코더는 모양이 (B, T, D) 인 텐서, 곧 “길이 \(D\) 인 벡터(토큰)가 \(T\) 개 늘어선 열” 을 받는다. 문장은 낱말이 곧 토큰이라 자연스럽다. 그림은 어떻게 할까? 픽셀 하나를 토큰 하나로 삼으면 96×96 그림만 해도 토큰이 9,216개이다. 자기 어텐션은 모든 토큰 쌍을 계산하므로 쌍이 \(9216^2 \approx 8{,}500\)만 개가 된다. 너무 많다.
Dosovitskiy 등(2020)의 Vision Transformer(ViT) 는 가장 단순한 답을 냈다. 그림을 바둑판처럼 잘라, 한 칸을 토큰 하나로 삼는다. 논문 제목 “An Image is Worth 16x16 Words” 가 그 뜻이다. 16×16 픽셀 한 조각이 낱말 하나이다. 그 뒤는 표준 Transformer 인코더를 거의 그대로 쓴다.
패치로 자르기
그림을 한 변이 \(p\) 픽셀인 정사각형 조각으로 겹치지 않게 자른다. 이 조각을 패치(patch) 라 하고, \(p\) 를 패치 크기라 한다. 그림의 높이를 \(H\), 너비를 \(W\) 라 하면(이 장에서 \(H\), \(W\) 는 늘 그림의 픽셀 크기이다) 세로로 \(H/p\) 줄, 가로로 \(W/p\) 칸이 나오므로 패치의 수 \(N\) 은 다음과 같다.
\(N = \frac{H}{p}\cdot\frac{W}{p} = \frac{HW}{p^2}\)
\(N\) 이 곧 Transformer 가 처리할 토큰 수 이다(곧 붙일 CLS 토큰 1개는 따로 센다). \(H\) 와 \(W\) 는 \(p\) 로 나누어떨어져야 한다. 모델 이름의 “/16”, “/14” 가 패치 크기이다. ViT-S/14 는 “작은(Small) ViT, 패치 크기 14” 라는 뜻이다.
- 토큰 수 손계산
- \(\text{도형 세상: } H = W = 96,\ p = 8 \;\Rightarrow\; \frac{96}{8} = 12,\quad N = 12 \times 12 = 144\)
- 이 장의 실습이 쓰는 설정이다. 한 변에 패치 12개, 모두 144개이다.
- DINOv2 는 패치 크기 14 를 쓰고 대부분의 사전 학습을 224×224 에서 한다.
- DINOv2 는 사전 학습의 끝에 잠깐 518×518 로 해상도를 올린다(뒤에서 다룬다). 공개된 DINOv2 가중치의 위치 임베딩이 37×37 격자인 까닭이다.
- RF-DETR nano 는 해상도 384, 패치 크기 16 이다(논문 표 7). 토큰 576개가 백본을 지나간다.
- 그림: 그림 6-2 왼쪽: 도형 세상의 96×96 그림에 패치 경계를 그은 것. 오른쪽: 잘라 낸 8×8 패치 144개. 토큰 번호는 글을 읽는 순서(왼쪽 위 → 오른쪽 → 다음 줄)로 매긴다.
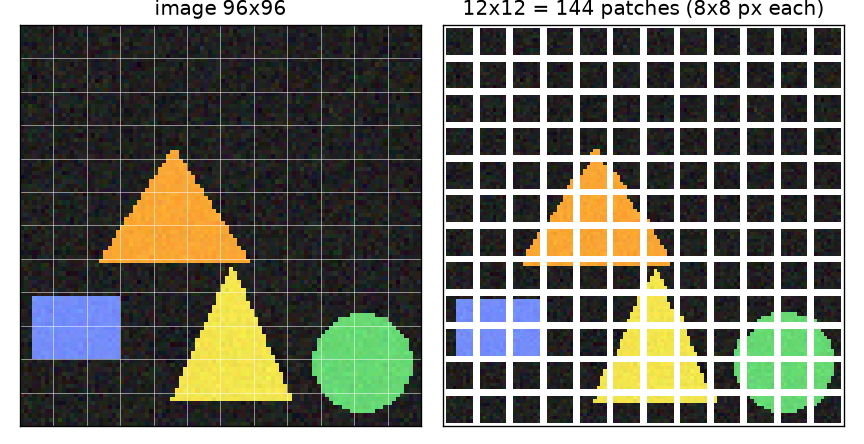
그림 6-2 에서 읽을 것은 두 가지이다. 첫째, 대부분의 패치는 배경 이고, 도형은 몇 개의 패치에 걸쳐 있다. 패치 하나만 봐서는 그것이 원의 일부인지 삼각형의 빗변인지 알기 어렵다. 그래서 패치끼리 정보를 주고받는 자기 어텐션이 필요하다. 둘째, 패치를 한 줄로 늘어놓는 순간 “어느 패치가 어느 패치의 옆 · 아래인지” 가 사라진다. 12번 토큰과 13번 토큰은 열에서는 이웃이지만 그림에서는 오른쪽 끝과 다음 줄의 왼쪽 끝이다. 이 정보는 뒤에서 위치 임베딩으로 되돌려 준다.
패치 임베딩: 펴서 선형 투영
패치 하나는 \(p \times p\) 픽셀에 색 채널 \(C = 3\) 개이므로 숫자 \(C p^2\) 개이다. 이것을 한 줄로 펴면 길이 \(Cp^2\) 인 벡터가 된다. 도형 세상에서는 \(3 \times 8 \times 8 = 192\) 이다. Transformer 는 길이 \(D\) 인 토큰을 받으므로, 이 벡터에 학습되는 선형 층 하나를 적용해 길이 \(D\) 로 바꾼다. \(n\) 번째 패치를 편 벡터를 \(x_n \in \mathbb{R}^{Cp^2}\), 선형 층의 가중치를 \(E \in \mathbb{R}^{D \times Cp^2}\), 편향을 \(b \in \mathbb{R}^{D}\) 라 하면
\(e_n = E\,x_n + b \;\in \mathbb{R}^{D}, \qquad n = 1, \dots, N\)
이다. 이 \(e_n\) 을 패치 임베딩(patch embedding) 이라 한다. 모든 패치가 같은 \(E\), \(b\) 를 쓴다. \(E\) 의 한 줄(길이 \(Cp^2\))은 “이런 무늬의 패치에 크게 반응하라” 는 틀 하나이고, 그런 틀이 \(D\) 개 있다.
그런데 “같은 가중치를 그림의 여러 자리에 똑같이 적용한다” 는 것은 4장에서 본 합성곱의 정의이다. 실제로 패치 임베딩은 커널 크기와 스트라이드가 모두 \(p\) 인 합성곱 하나와 정확히 같은 계산이다. 4장의 끝에서 숫자로만 확인하고 넘어간 사실인데, 여기서 식으로 따져 본다.
- 패치 임베딩 = 커널 · 스트라이드가 p 인 합성곱
- \(y[k, i, j] = \sum_{c=1}^{C}\sum_{u=0}^{p-1}\sum_{v=0}^{p-1} K[k, c, u, v]\; I[c,\; s\,i + u,\; s\,j + v] + b[k]\)
- 합성곱의 정의이다. \(I\) 는 입력 그림, \(K\) 는 모양 \((D, C, p, p)\) 인 커널, \(s\) 는 스트라이드(창을 옮기는 간격), \(y[k, i, j]\) 는 출력의 \(k\) 번째 채널, \(i\) 번째 줄, \(j\) 번째 칸이다.
- 스트라이드를 커널 크기와 같게 두었다. 창이 \(p\) 칸씩 건너뛰므로 창끼리 겹치지 않고, \((i, j)\) 번째 창이 덮는 픽셀은 줄 \(pi \dots pi + p - 1\), 칸 \(pj \dots pj + p - 1\) 이다. 이것은 \((i, j)\) 번째 패치 와 정확히 같은 영역이다.
- \(n = i \cdot (W/p) + j\) 번째 패치를 (채널, 줄, 칸) 순서로 편 것이 \(x_n\) 이다. 커널 \(K\) 도 채널 \(k\) 마다 같은 순서로 펴서 행렬 \(E\) 의 \(k\) 번째 줄로 삼는다. \((c, u, v)\) 는 편 벡터 안의 자리 번호 하나를 가리킨다.
- 세 겹의 합은 벡터 \(x_n\) 과 \(E\) 의 \(k\) 번째 줄의 내적이다. 합성곱 출력의 \((i, j)\) 칸에 놓인 길이 \(D\) 인 벡터가 곧 \(n\) 번째 패치 임베딩이다. 두 계산은 같은 덧셈과 곱셈을 순서만 다르게 한 것이다.
그래서 구현은 합성곱 한 줄이다. 출력 (B, D, H/p, W/p) 의 격자를 펴서 (B, N, D) 로 만들면 토큰 열이다. 아래 patchify 는 “패치로 잘라 펴기” 를 글자 그대로 구현한 것이고, check_patch_embed 가 두 방식의 출력이 같은지 확인한다.
def patchify(images: torch.Tensor, patch_size: int) -> torch.Tensor:
    """그림을 패치로 잘라, 패치 하나하나를 한 줄 벡터로 편다.

    images: (B, C, H, W)  →  돌려주는 값: (B, N, C·p·p),  N = (H/p)·(W/p)
    패치 순서는 글 읽는 순서(왼쪽 위에서 오른쪽으로, 다음 줄로)이고,
    한 패치 안의 값은 (채널, 행, 열) 순서로 편다 — 합성곱 가중치 (D, C, p, p) 를 펼 때와 같은 순서여야 한다.
    """
    B, C, H, W = images.shape
    p = patch_size
    gh, gw = H // p, W // p  # 세로 · 가로 패치 수
    x = images.reshape(B, C, gh, p, gw, p)  # 높이를 (패치 줄, 패치 안 행), 너비를 (패치 칸, 패치 안 열)로 쪼갠다
    x = x.permute(0, 2, 4, 1, 3, 5)  # (B, gh, gw, C, p, p): 패치 위치를 앞으로
    return x.reshape(B, gh * gw, C * p * p)
class PatchEmbed(nn.Module):
    """패치 임베딩: 그림 (B, 3, H, W) → 토큰 열 (B, N, D).

    커널 크기 = 스트라이드 = p 인 합성곱 하나다. 창이 겹치지 않고 p 칸씩 건너뛰므로
    "패치마다 같은 선형 층을 한 번씩 적용" 하는 것과 같은 계산이 된다.
    """

    def __init__(self, patch_size: int, dim: int, in_channels: int = 3):
        super().__init__()
        self.patch_size = patch_size
        self.proj = nn.Conv2d(in_channels, dim, kernel_size=patch_size, stride=patch_size)

    def forward(self, images: torch.Tensor) -> torch.Tensor:
        x = self.proj(images)  # (B, D, H/p, W/p): 격자 한 칸이 패치 하나
        return x.flatten(2).transpose(1, 2)  # (B, D, N) → (B, N, D)

def check_patch_embed(log=print):
    """합성곱 방식과 '펴서 선형 투영' 방식이 같은 값을 내는지 확인한다."""
    torch.manual_seed(0)
    embed = PatchEmbed(patch_size=8, dim=96)
    images = torch.rand(2, 3, 96, 96)
    by_conv = embed(images)  # (2, 144, 96)
    weight = embed.proj.weight.reshape(96, -1)  # (D, C, p, p) → (D, C·p·p) = (96, 192)
    by_linear = patchify(images, 8) @ weight.T + embed.proj.bias  # (2, 144, 192) @ (192, 96) → (2, 144, 96)
    diff = (by_conv - by_linear).abs().max().item()
    log(f"[check] 패치 임베딩: 합성곱 {tuple(by_conv.shape)} vs 펴서 선형 투영 {tuple(by_linear.shape)}, 최대 차이 {diff:.2e}")
    assert diff < 1e-5
차이 \(10^{-6}\) 은 32비트 실수의 반올림 오차이다(덧셈 순서가 달라서 생긴다). 두 방식은 같은 계산이다.
- 참고 · 패치 임베딩은 “아주 거친 합성곱 한 층” 이다
- 보통의 합성곱 신경망은 3×3 같은 작은 커널을 스트라이드 1 – 2 로 여러 층 쌓아 조금씩 해상도를 줄인다. ViT 는 첫 층에서 한 번에 \(p\) 배로 줄이고, 그 뒤로는 해상도를 바꾸지 않는다. 백본을 나온 특징 맵의 한 칸이 원래 그림의 \(p \times p\) 픽셀에 해당하므로, “스트라이드 \(p\) 인 특징 맵” 또는 “1/\(p\) 해상도” 라고 부른다. RF-DETR nano 의 백본 출력은 384×384 그림에 대해 24×24 격자이다.
CLS 토큰과 위치 임베딩
패치 임베딩 \(N\) 개를 Transformer 에 넣기 전에 두 가지를 더한다.
① CLS 토큰. 그림 분류처럼 “그림 전체에 대한 답 하나” 가 필요할 때, \(N\) 개의 패치 출력 중 무엇을 답으로 쓸지 정해야 한다. ViT 는 언어 모델 BERT 를 따라, 어떤 패치에도 속하지 않는 학습되는 벡터 하나 \(x_{\text{cls}} \in \mathbb{R}^D\) 를 열의 맨 앞에 끼워 넣는다. 이것이 CLS 토큰(class token, [CLS]) 이다. 이 토큰은 자기 어텐션을 거치며 모든 패치의 정보를 모으고, 마지막 층에서의 이 토큰의 출력을 그림 전체의 요약 으로 쓴다. 토큰 수는 \(N + 1\) 이 된다.
② 위치 임베딩. 5장에서 보았듯 자기 어텐션은 토큰의 순서를 모른다. 토큰들을 뒤섞어 넣으면 출력도 똑같이 뒤섞여 나올 뿐이다. 그러니 “이 토큰은 그림의 어디에서 왔다” 를 토큰에 직접 적어 주어야 한다. 5장의 원래 Transformer 는 사인 · 코사인으로 만든 고정된 위치 인코딩을 더했다. ViT 는 대신 자리마다 학습되는 벡터를 하나씩 두고 그것을 더한다. 이것이 위치 임베딩(position embedding) 이고, \(N + 1\) 개 자리에 길이 \(D\) 인 벡터가 하나씩이므로 모양이 \((N + 1) \times D\) 인 매개변수 \(E_{\text{pos}}\) 이다.
\(X_0 = \big[\,x_{\text{cls}};\; e_1;\; e_2;\; \dots;\; e_N\,\big] + E_{\text{pos}}, \qquad X_0 \in \mathbb{R}^{(N+1) \times D}\)
\([\,\cdot\,;\,\cdot\,]\) 는 벡터들을 줄로 쌓는다는 뜻이고, \(X_0\) 는 첫 블록에 들어가는 토큰 열이다. 위치 임베딩은 처음에 무작위 값이고, “12번 자리와 13번 자리는 그림에서 멀다” 같은 2차원 구조를 전혀 모른다. 학습하면서 스스로 알아내야 한다 (정말 알아내는지는 뒤의 그림 6-6 에서 확인한다).
- 주의 · 위치 임베딩의 크기는 해상도에 묶여 있다
- 합성곱 커널은 그림이 커져도 그대로 쓸 수 있지만, 위치 임베딩은 자리 수 \(N + 1\) 이 정해진 표이다. 96×96(자리 145개)으로 학습한 모델에 128×128 그림(자리 257개)을 넣으면 더할 표가 모자란다. 이 문제와 해법(보간)은 뒤의 “해상도와 패치 크기를 바꿔 쓰기” 에서 다룬다. RF-DETR 이 해상도를 손잡이로 쓰려면 반드시 넘어야 하는 문턱이다.
인코더 블록을 쌓기
이제 \(X_0\) 를 5장의 Transformer 인코더 블록 \(L\) 개에 차례로 통과시킨다. 블록 하나는 다중 머리 자기 어텐션(토큰끼리 정보를 주고받음)과 MLP(토큰마다 따로 가공함) 두 부분이고, 각 부분 앞에 층 정규화를, 각 부분을 건너뛰는 잔차 연결을 둔다. ViT 논문의 식 (2) – (4) 를 이 장의 기호로 쓰면 다음과 같다(\(\ell = 1, \dots, L\)).
\(\begin{aligned} X'_\ell &= X_{\ell-1} + \mathrm{MSA}\big(\mathrm{LN}(X_{\ell-1})\big) \\ X_\ell &= X'_\ell + \mathrm{MLP}\big(\mathrm{LN}(X'_\ell)\big) \\ Y &= \mathrm{LN}(X_L) \end{aligned}\)
- \(\mathrm{MSA}\) 는 다중 머리 자기 어텐션, \(\mathrm{LN}\) 은 층 정규화이다.
- \(\mathrm{MLP}\) 는 선형 층 두 개 사이에 GELU 활성 함수를 둔 것이다. 5장에서 FFN 이라고 부른 바로 그 부품이고, ViT 논문은 MLP 라고 부른다. 가운데 은닉 차원은 보통 \(4D\) 이고, 이 4 를 MLP 비율이라 한다.
- 층 정규화가 어텐션 · MLP 의 앞 에 있고 잔차 연결의 덧셈은 정규화 밖에 있다. 5장에서 본 두 배치(post-norm · pre-norm) 가운데 pre-norm 이다. 입력이 정규화를 거치지 않고 출력까지 그대로 더해지므로 깊게 쌓아도 학습이 안정적이다.
- 마지막 블록 뒤에 층 정규화를 한 번 더 한다. 출력 \(Y \in \mathbb{R}^{(N+1)\times D}\) 의 첫 줄이 CLS 출력, 나머지 \(N\) 줄이 패치 특징 이다.
그림 분류에서는 CLS 출력에 선형 층 하나(분류 머리)를 달아 클래스 점수를 낸다. 탐지에서는 반대로 패치 특징 \(N\) 줄이 주인공이다. 이것을 다시 \((H/p) \times (W/p)\) 격자로 접으면 채널 \(D\) 개짜리 특징 맵이 되고, 디코더는 이 특징 맵에서 객체를 찾는다.
텐서 모양을 따라가 보기
이 장의 MiniViT(96×96, 패치 8, \(D = 96\), 4층)에서 텐서 모양이 바뀌는 자리는 다음과 같다(원문 그림 6-3).
- 그림
(B, 3, 96, 96)→ 패치 임베딩(Conv 8×8, 스트라이드 8) →(B, 144, 96) - CLS 토큰 붙이기(맨 앞에 1개) →
(B, 145, 96) - 위치 임베딩 더하기(매개변수
(1, 145, 96)) →(B, 145, 96) - pre-norm 블록 × 4(머리 4개, MLP 은닉 384): x + 자기 어텐션(LN(x)) → x + MLP(LN(x)). 모양은 계속
(B, 145, 96) - 마지막 층 정규화 뒤 CLS 출력
[:, 0]은(B, 96)으로 그림 전체의 요약이고, 패치 특징[:, 1:]은(B, 144, 96)으로 12×12 특징 맵이 된다.
모양이 바뀌는 것은 처음 두 단계뿐이고, 블록들은 (B, 145, 96) 을 그대로 유지한다. 분류는 CLS 출력에 머리를 달고, 탐지는 패치 특징을 쓴다.
코드도 이 그림 그대로이다. SelfAttention 과 Block 은 5장에서 만든 것과 같은 계산이고(어텐션 지도를 꺼내 보려고 직접 구현했다. PyTorch 내장 nn.MultiheadAttention 과 값이 같은지는 실행할 때 확인한다), MiniViT 가 전체를 잇는다. embed 안의 위치 임베딩 보간은 잠시 뒤에 설명한다.
class SelfAttention(nn.Module):
    """다중 머리 자기 어텐션 (5장). 어텐션 가중치를 꺼내 볼 수 있게 직접 구현한다.

    x: (B, T, D) → (B, T, D).  T 는 토큰 수(CLS 1개 + 패치 N개), 머리 수 h, 머리 하나의 차원 D/h.
    """

    def __init__(self, dim: int, heads: int):
        super().__init__()
        assert dim % heads == 0
        self.heads = heads
        self.qkv = nn.Linear(dim, dim * 3)  # 질의 · 열쇠 · 값을 한 번에 만든다
        self.proj = nn.Linear(dim, dim)  # 머리들을 다시 합친 뒤의 출력 투영

    def forward(self, x: torch.Tensor, return_attention: bool = False):
        B, T, D = x.shape
        qkv = self.qkv(x).reshape(B, T, 3, self.heads, D // self.heads).permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]  # 각각 (B, h, T, D/h)
        scores = q @ k.transpose(-2, -1) / math.sqrt(D // self.heads)  # (B, h, T, T)
        attention = scores.softmax(dim=-1)  # 행마다 합이 1: 토큰 i 가 토큰 j 를 보는 비율
        out = (attention @ v).transpose(1, 2).reshape(B, T, D)  # (B, h, T, D/h) → (B, T, D)
        out = self.proj(out)
        return (out, attention) if return_attention else out

class Block(nn.Module):
    """pre-norm Transformer 인코더 블록: x + Attn(LN(x)), 그다음 x + MLP(LN(x))."""

    def __init__(self, dim: int, heads: int, mlp_ratio: int = 4):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim)
        self.attn = SelfAttention(dim, heads)
        self.norm2 = nn.LayerNorm(dim)
        self.mlp = nn.Sequential(nn.Linear(dim, dim * mlp_ratio), nn.GELU(), nn.Linear(dim * mlp_ratio, dim))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = x + self.attn(self.norm1(x))  # 층 정규화를 먼저(pre-norm), 잔차 연결은 정규화 밖에서
        return x + self.mlp(self.norm2(x))
class MiniViT(nn.Module):
    """작은 Vision Transformer.

    그림 (B, 3, H, W)
      → 패치 임베딩 (B, N, D)
      → 맨 앞에 CLS 토큰을 붙여 (B, 1 + N, D)
      → 위치 임베딩을 더함
      → pre-norm 블록 L 개
      → 마지막 층 정규화 → (B, 1 + N, D).   [:, 0] 이 CLS(그림 전체의 요약), [:, 1:] 이 패치 특징.
    num_outputs > 0 이면 CLS 위에 선형 분류 머리를 하나 단다.
    """

    def __init__(self, image_size: int = 96, patch_size: int = 8, dim: int = 96, depth: int = 4, heads: int = 4,
                 mlp_ratio: int = 4, num_outputs: int = 0):
        super().__init__()
        self.patch_size = patch_size
        self.grid = image_size // patch_size  # 학습 해상도에서 한 변의 패치 수 (96 / 8 = 12)
        self.dim = dim
        self.patch_embed = PatchEmbed(patch_size, dim)
        self.cls_token = nn.Parameter(torch.zeros(1, 1, dim))
        self.pos_embed = nn.Parameter(torch.zeros(1, 1 + self.grid**2, dim))  # CLS 자리 1개 + 패치 자리 N개
        self.blocks = nn.ModuleList([Block(dim, heads, mlp_ratio) for _ in range(depth)])
        self.norm = nn.LayerNorm(dim)
        self.head = nn.Linear(dim, num_outputs) if num_outputs > 0 else None
        nn.init.trunc_normal_(self.cls_token, std=0.02)
        nn.init.trunc_normal_(self.pos_embed, std=0.02)

    def embed(self, images: torch.Tensor, interpolate: bool = True) -> torch.Tensor:
        """그림 → 위치 임베딩까지 더한 토큰 열 (B, 1 + N, D)."""
        B, _, H, W = images.shape
        assert H == W and H % self.patch_size == 0, "정사각형이고 패치 크기로 나누어떨어지는 그림만 받는다"
        x = self.patch_embed(images)  # (B, N, D)
        x = torch.cat([self.cls_token.expand(B, -1, -1), x], dim=1)  # (B, 1 + N, D)
        pos = self.pos_embed
        new_grid = H // self.patch_size
        if interpolate and new_grid != self.grid:
            # CLS 자리의 위치 임베딩은 그대로 두고, 패치 자리의 것만 2차원 격자로 보간한다
            patch_pos = interpolate_pos_embed(pos[:, 1:], self.grid, new_grid)
            pos = torch.cat([pos[:, :1], patch_pos], dim=1)
        return x + pos  # 보간을 끄고 격자 크기가 다르면 여기서 모양이 맞지 않아 오류가 난다

    def forward_tokens(self, images: torch.Tensor, interpolate: bool = True) -> torch.Tensor:
        x = self.embed(images, interpolate)
        for block in self.blocks:
            x = block(x)
        return self.norm(x)  # (B, 1 + N, D)

    def forward(self, images: torch.Tensor, interpolate: bool = True) -> torch.Tensor:
        cls = self.forward_tokens(images, interpolate)[:, 0]  # (B, D)
        return self.head(cls) if self.head is not None else cls

    @torch.no_grad()
    def last_attention(self, images: torch.Tensor) -> torch.Tensor:
        """마지막 블록에서 CLS 토큰이 각 패치를 보는 비율. (B, h, grid, grid)"""
        x = self.embed(images)
        for block in self.blocks[:-1]:
            x = block(x)
        last = self.blocks[-1]
        _, attention = last.attn(last.norm1(x), return_attention=True)  # (B, h, 1 + N, 1 + N)
        g = images.shape[-1] // self.patch_size
        return attention[:, :, 0, 1:].reshape(len(images), -1, g, g)  # 0번 행(CLS)의 1번 열부터(패치들)
ViT 의 크기 세기
“ViT-S 는 매개변수가 약 2,200만 개” 라는 말을 자주 본다. 이 숫자가 어디서 나오는지 부품별로 세어 보자. 모델의 크기 감각이 생기고, 어디가 무거운지도 보인다. 셈의 규칙은 둘뿐이다.
- 선형 층 \(\text{Linear}(a \to b)\): 가중치 \(a \times b\) 개 + 편향 \(b\) 개 = \(ab + b\) 개
- 층 정규화 \(\text{LayerNorm}(D)\): 배율 \(D\) 개 + 이동 \(D\) 개 = \(2D\) 개
부품별 매개변수 수
ViT-S/16 을 224×224 그림(ImageNet 분류의 표준 설정)에 맞춘 것을 센다. \(D = 384\), 블록 \(L = 12\) 개, 머리 6개, MLP 비율 4(은닉 차원 \(4D = 1536\)), 패치 크기 \(p = 16\), 토큰 수 \(N = (224/16)^2 = 196\), 분류 클래스 1,000개이다.
- ViT-S/16 의 매개변수 수
- \(\text{패치 임베딩: } \underbrace{3 \cdot 16 \cdot 16}_{768} \cdot 384 + 384 = 294{,}912 + 384 = 295{,}296\)
- 패치 하나를 편 길이 \(Cp^2 = 768\) 을 \(D = 384\) 로 보내는 선형 층(= 합성곱 커널 \((384, 3, 16, 16)\) 과 편향)이다.
- CLS 토큰은 길이 \(D\) 인 벡터 하나, 위치 임베딩은 \(N + 1 = 197\) 자리마다 길이 \(D\) 인 벡터 하나이다.
- 질의 · 열쇠 · 값을 만드는 선형 층 셋을 하나로 합친 \(\text{Linear}(384 \to 3 \cdot 384)\) 와, 머리들의 출력을 합친 뒤의 \(\text{Linear}(384 \to 384)\) 이다. 머리 수 6 은 어디에도 나오지 않는다. 머리는 같은 행렬의 출력을 6등분해 쓰는 방식일 뿐이라 매개변수 수를 바꾸지 않는다.
- \(\text{Linear}(384 \to 1536)\) 과 \(\text{Linear}(1536 \to 384)\) 이다. 어텐션의 두 배이다. ViT 매개변수의 3분의 2 는 MLP 에 있다.
- 블록마다 층 정규화가 둘(어텐션 앞, MLP 앞)이다.
- 블록은 모두 같은 구조이다.
- 분류 머리를 뺀 백본만의 크기, 약 2,170만 개이다. DINO 논문의 표 1 이 ViT-S/16 을 “21M” 이라고 적은 것이 이 값이다(그 표는 머리를 빼고 센다).
- 1,000 클래스 분류 머리까지 넣으면 약 2,205만 개. 흔히 말하는 “약 2,200만” 이다. 블록 12개가 전체의 96.6% 를 차지한다.
같은 셈을 함수로 옮기고, 같은 설정으로 실제 모델을 만들어 parameters() 를 센 값과 대조한다.
def vit_param_count(image_size: int, patch_size: int, dim: int, depth: int, mlp_ratio: int = 4, num_classes: int = 0,
                    in_channels: int = 3) -> dict:
    """ViT 의 매개변수 수를 부품별 공식으로 센다 (가중치 + 편향).

    선형 층 Linear(a, b) 는 a·b + b 개, 층 정규화 LayerNorm(d) 는 2d 개(배율 γ 와 이동 β)이다.
    머리 수는 매개변수 수에 영향을 주지 않는다 (같은 qkv 행렬을 머리 수만큼 나눠 쓸 뿐이다).
    """
    n_patches = (image_size // patch_size) ** 2
    hidden = dim * mlp_ratio
    counts = {
        "patch_embed": in_channels * patch_size * patch_size * dim + dim,
        "cls_token": dim,
        "pos_embed": (1 + n_patches) * dim,
        "block.norm x2": 2 * (2 * dim),
        "block.attn.qkv": dim * 3 * dim + 3 * dim,
        "block.attn.proj": dim * dim + dim,
        "block.mlp.fc1": dim * hidden + hidden,
        "block.mlp.fc2": hidden * dim + dim,
        "final_norm": 2 * dim,
        "head": (dim * num_classes + num_classes) if num_classes else 0,
    }
    counts["block"] = sum(v for k, v in counts.items() if k.startswith("block."))
    counts["total"] = (counts["patch_embed"] + counts["cls_token"] + counts["pos_embed"] + depth * counts["block"]
                       + counts["final_norm"] + counts["head"])
    return counts
[count] ViT-S/16: 패치 임베딩 295,296 + CLS 384 + 위치 임베딩 75,648 + 블록 12 × 1,774,464 + 마지막 LN 768 + 분류 머리 385,000 = 22,050,664
        블록 하나: LN 2개 1,536 + qkv 443,520 + proj 147,840 + MLP 591,360 + 590,208
        실제로 만든 모델 22,050,664개 → 일치 (분류 머리 빼면 21,665,664)
[count] ViT-B/16: 패치 임베딩 590,592 + CLS 768 + 위치 임베딩 151,296 + 블록 12 × 7,087,872 + 마지막 LN 1,536 + 분류 머리 769,000 = 86,567,656
        블록 하나: LN 2개 3,072 + qkv 1,771,776 + proj 590,592 + MLP 2,362,368 + 2,360,064
        실제로 만든 모델 86,567,656개 → 일치 (분류 머리 빼면 85,798,656)
| 모델 | 층 \(L\) | 차원 \(D\) | 머리 | MLP 은닉 | 블록 하나 | 전체(분류 머리 포함) | 논문의 표기 |
| ViT-S/16 | 12 | 384 | 6 | 1536 | 1,774,464 | 22,050,664 | 21M (DINO 표 1, 머리 제외) |
| ViT-B/16 | 12 | 768 | 12 | 3072 | 7,087,872 | 86,567,656 | 86M (ViT 표 1) |
ViT-B 는 ViT-S 에서 차원만 두 배로 늘린 것인데 매개변수는 거의 정확히 4배 이다. 블록의 무거운 부분이 모두 \(D \times D\) 에 비례하는 행렬이기 때문이다(\(1{,}774{,}464 \times 4 = 7{,}097{,}856 \approx 7{,}087{,}872\). 편향과 층 정규화처럼 \(D\) 에 비례하는 항만 2배가 되어 살짝 모자란다). ViT 논문의 표 1 에는 Base(86M) · Large(24층, \(D = 1024\), 307M) · Huge(32층, \(D = 1280\), 632M) 만 있고, Small 은 뒤에 나온 변형이다. DINO 논문은 DeiT 의 구현을 따른다며 ViT-S 를 12블록 · \(D = 384\) · 머리 6 으로 적는다.
DINOv2 가 쓰는 크기들
DINOv2 논문(부록 표 17)이 적은 네 가지 크기는 다음과 같다. 모두 패치 크기 14 이다.
| 모델 | 차원 | 머리 | 블록 | MLP 종류 | 만든 방법 |
| ViT-S/14 | 384 | 6 | 12 | MLP | ViT-g 에서 증류 |
| ViT-B/14 | 768 | 12 | 18 (논문 표) / 12 (공개 설정) | MLP | ViT-g 에서 증류 |
| ViT-L/14 | 1024 | 16 | 24 | MLP (증류한 것) | ViT-g 에서 증류 |
| ViT-g/14 | 1536 | 24 | 40 | SwiGLU | 처음부터 학습 |
- ViT-B/14 의 블록 수를 논문 표 17 은 18 로 적었지만, 공개된 설정 파일(RF-DETR 저장소의
dinov2_base.json포함)은num_hidden_layers: 12이다. 이 튜토리얼은 공개 설정의 12 를 따른다. - RF-DETR 은 이 가운데 가장 작은 둘만 쓴다. 탐지 N · S · M · L 은 ViT-S, XL · 2XL · Max 는 ViT-B 이다(논문 표 7).
공개된 DINOv2 ViT-S/14 가중치의 매개변수는 정확히 22,056,576개 이다(이 장의 선택 실습이 실제로 내려받아 센 값). 위에서 센 ViT-S/16 백본 21,665,664 와 조금 다른 까닭도 같은 셈으로 설명된다.
- DINOv2 ViT-S/14 의 22,056,576 은 어디서 오나
- \(\text{패치 임베딩: } 3 \cdot 14 \cdot 14 \cdot 384 + 384 = 225{,}792 + 384 = 226{,}176\)
- 패치가 16 에서 14 로 작아져 커널이 줄었다(\(768 \to 588\)).
- 518×518 해상도의 37×37 격자에 맞춘 표라서 197자리짜리보다 훨씬 크다.
- DINOv2 의 블록에는 어텐션 · MLP 의 출력에 채널별로 곱하는 학습되는 배율(LayerScale)이 하나씩 더 있다. 블록마다 \(2D\) 개이다.
- 마스크 토큰은 사전 학습 때 가린 패치 자리에 넣는 벡터이다(뒤의 iBOT 손실). 합이 실제 값과 한 자리도 틀리지 않는다.
계산량: 토큰 수가 좌우한다
매개변수 수는 해상도와 거의 무관했다(위치 임베딩만 바뀐다). 하지만 계산량 은 해상도에 크게 좌우된다. 같은 가중치를 토큰마다, 토큰 쌍마다 적용하기 때문이다. 5장에서 자기 어텐션의 토큰 쌍이 \(N^2\) 개라는 것을 보았다. 여기서는 한 발 더 들어가, ViT 블록 하나에서 \(N\) 에 비례하는 부분과 \(N^2\) 에 비례하는 부분이 각각 얼마나 되는지 센다. RF-DETR 은 실시간 탐지기이므로 이 셈이 설계의 중심에 있다.
블록 하나의 곱셈 횟수
토큰 \(N\) 개(CLS 는 무시), 차원 \(D\), 머리 \(h\) 개인 블록 하나가 하는 곱셈을 센다. 편향 · 정규화 · 소프트맥스처럼 작은 항은 빼고 어림한다.
- 토큰 수에 비례하는 부분과 제곱에 비례하는 부분
- \(\text{선형 층들: } \underbrace{N \cdot D \cdot 3D}_{\text{qkv}} + \underbrace{N \cdot D \cdot D}_{\text{출력 투영}} + \underbrace{N \cdot D \cdot 4D + N \cdot 4D \cdot D}_{\text{MLP 두 층}} = 12\,N D^2\)
- \(\text{Linear}(a \to b)\) 를 벡터 하나에 적용하면 곱셈이 \(ab\) 번이다. 토큰 \(N\) 개에 따로 적용하므로 \(N\) 배. 토큰 수에 정비례 한다.
- 머리 하나에서 질의 \(N\) 개와 열쇠 \(N\) 개의 모든 쌍에 대해 길이 \(D/h\) 인 내적을 한다. 머리가 \(h\) 개이므로 \(h\) 가 약분된다.
- 토큰마다 어텐션 가중치 \(N\) 개로 값 벡터(길이 \(D/h\)) \(N\) 개를 가중 평균한다.
- 앞 항은 \(N\) 에, 뒤 항은 \(N^2\) 에 비례한다. 두 항의 비가 \(N / 6D\) 이므로, 토큰 수가 \(6D\) 를 넘으면 자기 어텐션의 제곱 항이 더 커진다. ViT-S(\(D = 384\))에서는 \(N = 2304\)(48×48 격자)가 그 경계이다.
“자기 어텐션의 비용은 \(N^2\) 에 비례한다” 는 말은 뒤 항 \(2N^2D\) 를 가리킨다. \(N = HW/p^2\) 를 넣으면
\(\text{자기 어텐션의 쌍의 수} = N^2 = \left(\frac{HW}{p^2}\right)^{2}\)
이다. 정사각형 그림(\(H = W\))이면 \(N^2 = (H/p)^4\), 곧 한 변의 패치 수의 네제곱 이다.
해상도를 올리면, 패치를 줄이면
- 두 배 바꾸기
- \(H, W \to 2H, 2W: \quad N \to \frac{(2H)(2W)}{p^2} = 4N, \qquad N^2 \to 16 N^2\)
- 해상도를 가로세로 2배로 올리면 토큰은 4배, 어텐션 쌍은 16배가 된다.
- 해상도는 그대로 두고 패치를 반으로 줄여도 똑같이 토큰 4배, 쌍 16배이다. \(N\) 은 \(H/p\) 에만 달려 있기 때문이다.
- \(D = 384\) 를 넣은 블록 하나의 어림값이다. 비례 항은 4배, 제곱 항은 16배가 되어 블록 전체는 \(1.27 \to 8.15\), 약 6.4배이다. “해상도 2배 = 계산 4배” 가 아니라 그보다 훨씬 비싸다.
| 설정 | 해상도 / 패치 | 격자 | 토큰 \(N\) | 쌍 \(N^2\) | \(N/6D\) |
| 도형 세상 MiniViT (\(D = 96\)) | 96 / 8 | 12×12 | 144 | 20,736 | 0.25 |
| DINOv2 사전 학습 (ViT-S) | 224 / 14 | 16×16 | 256 | 65,536 | 0.11 |
| RF-DETR nano (ViT-S) | 384 / 16 | 24×24 | 576 | 331,776 | 0.25 |
| RF-DETR small (ViT-S) | 512 / 16 | 32×32 | 1,024 | 1,048,576 | 0.44 |
| RF-DETR medium (ViT-S) | 576 / 16 | 36×36 | 1,296 | 1,679,616 | 0.56 |
| 옛 RF-DETR base (ViT-S) | 560 / 14 | 40×40 | 1,600 | 2,560,000 | 0.69 |
| 같은 격자를 다른 방법으로 | 640 / 16 | 40×40 | 1,600 | 2,560,000 | 0.69 |
표에서 읽을 것은 세 가지이다.
- nano 에서 medium 으로 가면 해상도는 1.5배인데 토큰은 2.25배, 쌍은 5.06배이다. 모델 크기(가중치)는 같은 ViT-S 인데 계산량이 이만큼 다르다. RF-DETR 의 N · S · M · L 은 “같은 백본을 다른 해상도로 돌리는 것” 이 주된 차이이다.
- 마지막 두 줄은 토큰 수가 같다. 560/14 와 640/16 은 둘 다 40×40 격자이다. Transformer 블록의 계산량은 같고, 다른 것은 패치 하나가 담는 픽셀 수뿐이다. RF-DETR 논문 표 5 에 정확히 이 변경(패치 14 → 16, 해상도 560 → 640)이 한 줄로 있는데, AP 는 54.6 → 54.4, 지연 시간은 4.7 ms 그대로였다.
- \(N/6D\) 가 1 보다 작으면 아직 비례 항이 더 크다. 그래도 제곱 항은 해상도를 올릴수록 빠르게 따라붙고, 메모리(어텐션 행렬 \(h \times N \times N\))는 처음부터 \(N^2\) 에 비례한다.
- 핵심 · 중요한 것은 “공간 위치 수” 이다
- ViT 에게 해상도와 패치 크기는 따로따로가 아니라 둘의 비 \(H/p\)(한 변의 토큰 수)로 묶여서 작용한다. 패치 임베딩을 지나고 나면 블록들은 원래 그림이 몇 픽셀이었는지 모른다. RF-DETR 논문의 부록 L 은 NAS 가 찾은 모델들을 살펴 같은 관찰을 보고한다. 성능은 해상도나 패치 크기 각각보다 공간 위치 수(해상도 ÷ 패치 크기) 와 더 관계가 깊었고, 해상도를 640 으로 고정한 채 패치 크기만 27 · 21 · 18 로 바꿔 만든 N · S · M 이 원래의 N · S · M 과 거의 같은 결과를 냈다고 한다. 12장에서 이 두 손잡이를 직접 돌려 본다.
제곱 항을 줄이는 또 하나의 방법은 토큰들을 몇 개의 윈도 로 나눠 윈도 안에서만 어텐션을 하는 것이다. 토큰을 2×2 = 4개 윈도로 나누면 윈도 하나의 쌍은 \((N/4)^2\), 넷을 합쳐 \(N^2/4\) 이다. RF-DETR 백본은 일부 블록을 이렇게 바꾼다. 9장의 주제이다.
해상도와 패치 크기를 바꿔 쓰기
사전 학습은 224×224 에서 했는데 탐지는 384, 512, 640 에서 하고 싶다. 패치 크기도 14 가 아니라 16 을 쓰고 싶다. 가중치를 버리지 않고 그렇게 할 수 있을까? ViT 의 가중치 가운데 그림의 크기에 묶여 있는 것은 딱 두 군데, 위치 임베딩(해상도 ÷ 패치 크기에 묶임)과 패치 임베딩(패치 크기에 묶임)이다. 블록들은 토큰이 몇 개든 그대로 동작한다.
위치 임베딩 보간
위치 임베딩 보간(position embedding interpolation) 은 학습된 위치 임베딩을 다른 격자 크기에 맞게 늘이거나 줄이는 방법이다. 위치 임베딩은 자리마다의 벡터를 모은 표이다. 한 줄로 늘어서 있지만 원래는 \(g \times g\) 격자(\(g = H/p\))의 각 칸에 붙은 벡터이다. 그렇다면 이 표를 “채널이 \(D\) 개인 \(g \times g\) 짜리 작은 그림” 으로 보고, 그림의 크기를 바꾸듯 보간하면 된다. ViT 논문이 제안한 방법이다(3.2절: 사전 학습된 위치 임베딩을 원래 그림에서의 위치에 따라 2차원 보간한다).
- CLS 자리의 위치 임베딩 1개는 떼어 둔다(그림 위의 자리가 아니므로 보간하지 않는다).
- 나머지 \(g^2\) 개를 \((g, g, D)\) 격자로 되돌린다.
- 격자를 새 크기 \((g', g')\) 로 보간한다. 채널마다 따로, 보통의 그림 크기 바꾸기와 같다.
- 다시 한 줄 \(g'^2\) 개로 펴고, 떼어 둔 CLS 자리를 앞에 붙인다.
가장 작은 예로 손계산해 보자. 채널이 하나(\(D = 1\))인 2×2 격자를 3×3 으로 늘린다. 보간은 가로 · 세로를 따로 해도 되므로 먼저 한 줄만 본다.
- 쌍선형 보간으로 2칸을 3칸으로
- \(u_i = (i + 0.5)\cdot\frac{g}{g'} - 0.5, \qquad i = 0, \dots, g' - 1\)
- 새 격자의 \(i\) 번째 칸의 중심이 옛 격자의 좌표로 어디인지 구하는 식이다. 칸의 중심은 칸 번호 + 0.5 에 있고, 전체 길이가 같도록 \(g/g'\) 배로 줄인 뒤 다시 0.5 를 빼 칸 번호로 되돌린다(PyTorch 의
align_corners=False규칙).
- 숫자를 넣었다. 가운데 칸은 옛 두 칸의 정확히 중간(\(0.5\))이고, 양 끝 칸은 옛 격자의 바깥(\(-1/6\), \(7/6\))으로 조금 나간다.
- 쌍선형 보간은 양옆 두 칸의 값을 거리에 반비례하는 가중치로 섞는다. \(u_1 = 0.5\) 는 두 칸에서 같은 거리이므로 반반. 바깥으로 나간 \(u_0\), \(u_2\) 는 가장 가까운 끝 칸의 값을 그대로 쓴다.
- 먼저 줄마다 가로로 보간하면 \([0, 1.5, 3]\) 과 \([6, 7.5, 9]\), 그다음 세로로 같은 규칙을 적용하면 가운데 줄이 두 줄의 평균 \([3, 4.5, 6]\) 이 된다. 원래 있던 “오른쪽으로 갈수록 +3, 아래로 갈수록 +6” 이라는 경향이 새 격자에도 그대로 이어진다.
def interpolate_pos_embed(patch_pos: torch.Tensor, old_grid: int, new_grid: int, mode: str = "bicubic") -> torch.Tensor:
    """패치 위치 임베딩을 다른 격자 크기로 보간한다.

    patch_pos: (1, old_grid², D)  →  (1, new_grid², D)
    ① 한 줄로 늘어선 위치 임베딩을 원래의 2차원 격자로 되돌린다.
    ② 격자를 "D 채널짜리 작은 그림" 으로 보고 크기를 바꾼다 (쌍삼차 보간).
    ③ 다시 한 줄로 편다.
    """
    if old_grid == new_grid:
        return patch_pos
    D = patch_pos.shape[-1]
    grid = patch_pos.reshape(1, old_grid, old_grid, D).permute(0, 3, 1, 2)  # ① (1, D, old, old)
    grid = F.interpolate(grid, size=(new_grid, new_grid), mode=mode, align_corners=False)  # ② (1, D, new, new)
    return grid.permute(0, 2, 3, 1).reshape(1, new_grid * new_grid, D)  # ③
[hand] 2×2 → 3×3 쌍선형: [[0.0, 1.5, 3.0], [3.0, 4.5, 6.0], [6.0, 7.5, 9.0]]
[hand] 2×2 → 3×3 쌍삼차: [[-0.781, 0.979, 2.74], [2.74, 4.5, 6.26], [6.26, 8.021, 9.781]]
손계산과 같다. 둘째 줄은 같은 일을 쌍삼차(bicubic) 보간으로 한 것이다. 쌍삼차는 양옆 두 칸이 아니라 네 칸을 써서 더 매끄러운 곡선을 그리고, 그 때문에 원래 값의 범위(0 – 9)를 살짝 벗어나기도 한다. DINO 와 DINOv2, 그리고 RF-DETR 의 백본 코드(interpolate_pos_encoding)는 쌍삼차를 쓴다. 이 장의 MiniViT 도 쌍삼차가 기본이다.
보간이 통하는 까닭은, 잘 학습된 위치 임베딩이 격자 위에서 매끄럽게 변하기 때문이다(이웃 자리끼리 비슷한 벡터). 매끄러운 것은 사이를 채워도 크게 틀리지 않는다. 그래도 보간된 값은 모델이 학습 때 본 값과 조금 다르므로, 해상도를 바꾼 직후에는 정확도가 다소 떨어지고 그 해상도로 미세 조정하면 회복된다. 얼마나 유지되는지는 이 장의 실험에서 직접 잰다.
- 참고 · RF-DETR 의 위치 임베딩
- RF-DETR 의 설정에는
positional_encoding_size라는 값이 있다. nano 는 24(= 384 ÷ 16), small 은 32(= 512 ÷ 16), 옛 base 는 37(= 518 ÷ 14, DINOv2 원본 그대로)이다. 그 모델이 가진 위치 임베딩 격자의 한 변이다. 입력 해상도가 이것과 다르면 순전파 때 위의 방법으로 보간한다. 논문은 NAS 학습 때 “가장 큰 해상도 ÷ 가장 작은 패치 크기” 에 해당하는 개수의 위치 임베딩을 미리 두고, 더 작은 해상도나 더 큰 패치에는 보간해 쓴다고 설명한다.
패치 크기를 바꾸려면
패치 크기를 14 에서 16 으로 바꾸면 패치 임베딩의 커널이 \((D, 3, 14, 14)\) 에서 \((D, 3, 16, 16)\) 으로 달라져야 한다. 여기에도 같은 생각을 적용할 수 있다. 커널을 “\(p \times p\) 짜리 작은 그림” 으로 보고 크기를 바꾸는 것이다. 다만 위치 임베딩처럼 그냥 보간하면 문제가 하나 생긴다.
패치 임베딩은 내적 \(\langle x, w \rangle\) 이다(\(x\) 는 패치, \(w\) 는 커널의 한 채널). 같은 내용의 패치를 2배 크게 그리면 픽셀 수가 4배가 되므로, 커널도 2배로 보간해서 내적하면 더하는 항이 4배로 늘어 값이 약 4배 가 된다. 토큰의 크기가 갑자기 달라지면 뒤의 블록들은 학습 때 본 적 없는 입력을 받는다.
Beyer 등(2023)의 FlexiViT 는 이것을 정면으로 푼다. 목표를 “크기를 바꾼 패치와 새 커널의 내적이, 원래 패치와 원래 커널의 내적과 같아지게 하라” 로 잡는다. 패치의 크기를 바꾸는 연산(쌍선형 보간)은 선형이므로 행렬 \(R\) 로 쓸 수 있다(\(x' = Rx\)). 새 커널 \(\hat{w}\) 가 만족해야 할 조건은
\(\langle R x,\ \hat{w} \rangle = \langle x,\ w \rangle \ \text{ (모든 } x \text{ 에 대해)} \quad\Longleftrightarrow\quad R^\top \hat{w} = w\)
이고, 패치를 키우는 경우 이 식의 해는 \(R^\top\) 의 의사 역행렬(pseudo-inverse)로 \(\hat{w} = (R^\top)^{+} w\) 이다. 논문은 이것을 PI-resize 라고 부른다. FlexiViT 는 여기에 더해, 학습하는 동안 스텝마다 패치 크기를 무작위로 바꿔(240×240 그림에서 패치 8 – 48) 모든 패치 크기에서 잘 동작하는 하나의 ViT 를 만든다. 패치 임베딩 가중치와 위치 임베딩은 정해진 크기로 하나만 두고, 순전파 때 필요한 크기로 바꿔 쓴다.
RF-DETR 의 NAS 가 패치 크기를 손잡이로 쓸 수 있는 것은 이 덕분이다. 논문은 FlexiViT 식 변환으로 패치 임베딩을 바꿔 쓴다고 밝힌다. 의사 역행렬이 왜 답인지의 유도와 구현은 12장에서 한다. 여기서는 “ViT 에서 그림 크기에 묶인 곳은 위치 임베딩과 패치 임베딩 둘뿐이고, 둘 다 크기를 바꿔 쓸 수 있다” 는 것만 가져간다.
ViT 는 왜 큰 데이터가 필요한가
귀납 편향이 약하다는 것
모델이 데이터를 보기도 전에 구조 자체에 품고 있는 가정을 귀납 편향(inductive bias) 이라고 한다. 합성곱 신경망은 그림에 대한 강한 가정 두 가지를 구조에 새겨 두었다.
- 국소성. 3×3 커널은 이웃한 픽셀끼리만 묶는다. “가까운 픽셀이 서로 관련 있다” 는 가정이다.
- 이동 등변성. 같은 커널을 모든 자리에 쓴다. 고양이가 왼쪽에 있든 오른쪽에 있든 같은 방식으로 반응한다. “무늬의 뜻은 위치와 무관하다” 는 가정이다.
ViT 에는 이런 가정이 거의 없다. ViT 논문의 말로는, CNN 에서는 국소성 · 2차원 이웃 구조 · 이동 등변성이 모델 전체의 모든 층에 박혀 있지만 ViT 에서는 MLP 층만 국소적이고 이동 등변이며 자기 어텐션 층은 전역적이다. 2차원 구조를 쓰는 곳은 맨 처음 그림을 패치로 자를 때와 해상도를 바꾸며 위치 임베딩을 보간할 때뿐이고, 위치 임베딩은 처음에 2차원 위치에 대해 아무것도 모르므로 패치 사이의 공간 관계는 처음부터 배워야 한다.
- 비유
- 합성곱 신경망은 “그림은 이렇게 보는 것” 이라는 요령을 미리 배운 견습생이고, ViT 는 아무 요령도 없이 온 견습생이다. 일감(데이터)이 적으면 요령을 아는 쪽이 낫다. 일감이 아주 많으면 요령 없이 온 쪽이 스스로 더 좋은 요령을 찾아내 앞지른다.
ViT 논문의 실험이 바로 그것을 보였다. ImageNet(약 130만 장) 같은 중간 크기 데이터에서 강한 정규화 없이 학습하면 ViT 는 비슷한 크기의 ResNet 보다 몇 퍼센트포인트 낮다. 그러나 1,400만 – 3억 장으로 사전 학습하면 상황이 뒤집히고, 논문은 이것을 “큰 규모의 학습이 귀납 편향을 이긴다” 고 요약한다. 가장 큰 모델의 이점은 3억 장(JFT-300M)에서야 온전히 드러났다.
사전 학습, 미세 조정, 파운데이션 모델
그런데 우리의 탐지 데이터는 3억 장이 아니다. COCO 가 약 12만 장이고, 현장의 데이터셋은 수백 – 수천 장인 경우가 흔하다. 그래서 ViT 는 늘 두 단계로 쓴다.
- 사전 학습(pre-training): 아주 큰 데이터로, 최종 과제와는 다른(더 일반적인) 과제를 풀며 가중치를 학습한다. 이때 그림을 보는 일반적인 능력이 가중치에 담긴다.
- 미세 조정(fine-tuning): 사전 학습된 가중치에서 출발해, 우리의 작은 데이터와 과제(탐지)로 조금 더 학습한다. 백본 위에 새 부품(프로젝터 · 디코더 · 머리)을 얹고 전체를 함께 학습한다.
사전 학습된 백본을 아예 얼려 두고(가중치를 바꾸지 않고) 그 위의 작은 부품만 학습하는 쓰임도 있다. 백본이 내는 특징이 그만큼 좋다면 가능하다. 이렇게 한 번 크게 사전 학습해 두고 여러 과제의 출발점으로 삼는 모델을 파운데이션 모델(foundation model) 이라고 부른다. DINOv2 논문은 스스로를 “미세 조정 없이도 여러 과제 · 여러 그림 분포에서 통하는 범용 시각 특징” 을 내는 시각 파운데이션 모델로 내세운다.
남은 물음은 사전 학습을 무슨 과제로 하느냐 이다. 가장 쉬운 답은 ImageNet 분류처럼 사람이 라벨을 붙인 데이터로 하는 지도 학습이다. 하지만 라벨을 3억 장에 붙이는 것은 엄청난 일이고, “이 그림은 고양이” 라는 라벨 하나는 그림 전체에 대한 것이라 고양이가 어디 있는지는 가르쳐 주지 않는다. 탐지에는 패치 하나하나의 특징이 좋아야 한다. 라벨 없이, 그림만으로 배울 수는 없을까?
자기 지도 학습과 DINO
라벨 없이 배운다는 것
자기 지도 학습(self-supervised learning, SSL) 은 사람이 붙인 라벨 대신 데이터 자신에서 정답을 만들어 내는 학습이다. 문제를 스스로 내고 스스로 채점한다. 언어 모델이 문장의 낱말을 가리고 그 낱말을 맞히는 것이 대표적인 예이다. 그림에서는 크게 두 갈래가 있다.
- 가리고 맞히기. 패치 일부를 가리고, 가려진 부분을 주변을 보고 맞힌다(masked image modeling, MIM). LW-DETR 이 백본 사전 학습에 쓴 CAEv2 가 이 갈래이다.
- 같은 그림의 다른 모습을 같게. 한 그림을 서로 다르게 변형한 두 장을 만들고, 모델이 두 장에 대해 같은 답 을 내게 한다. “잘라도, 뒤집어도, 색을 바꿔도 같은 그림” 이라는 사실이 정답 노릇을 한다. DINO 가 이 갈래이다.
둘째 갈래에서 변형된 그림 한 장을 뷰(view) 라고 부르고, 변형을 증강(augmentation)이라 한다. 뷰를 만드는 증강이 곧 “무엇이 달라도 같은 것으로 보라” 는 가르침이다. 무작위 자르기는 “일부만 보여도”, 색 바꾸기는 “색이 달라도” 를 가르친다.
- 주의 · 가장 쉬운 정답 — 붕괴
- “두 뷰에 같은 답을 내라” 에는 함정이 있다. 어떤 그림이 들어와도 늘 같은 답을 내면 두 뷰의 답은 당연히 같다. 손실은 0 이 되지만 모델은 아무것도 배우지 않았다. 이것을 붕괴(collapse) 라고 한다. 이 갈래의 방법들은 붕괴를 어떻게 막느냐로 서로 구별된다. DINO 의 답은 뒤에 나오는 centering 과 sharpening 이다.
자기 증류의 뼈대: 학생과 교사
증류(knowledge distillation) 는 본래 큰 모델(교사)의 지식을 작은 모델(학생)에게 옮기는 기법이다. 학생이 정답 라벨 대신 교사의 출력 분포 를 흉내 내도록 학습한다. 교사가 “고양이 0.7, 호랑이 0.2, 개 0.1” 이라고 답하면, 그 분포 전체가 학생의 목표가 된다.
Caron 등(2021)의 DINO(self-distillation with no labels) 는 이 틀을 라벨 없는 학습에 가져온다. 미리 학습된 교사가 없으니, 교사를 학생 자신으로부터 만든다. 그래서 자기 증류(self-distillation) 이다. 구성은 이렇다.
- 그림 \(x\) 한 장에서 무작위 증강으로 뷰 두 장 \(x_1\), \(x_2\) 를 만든다.
- 학생 망 \(g_{\theta_s}\) 와 교사 망 \(g_{\theta_t}\) 는 구조가 똑같고 가중치만 다르다(\(\theta_s\), \(\theta_t\)). 각 망은 백본(ViT)과 그 CLS 출력에 붙인 투영 머리(projection head)(MLP)로 이루어지고, 뷰 하나를 받아 길이 \(K\) 인 점수 벡터를 낸다.
- 점수에 소프트맥스를 씌워 \(K\) 개 항목에 대한 확률 분포로 만든다. 학생의 분포를 \(P_s\), 교사의 분포를 \(P_t\) 라 한다.
- 학생이 뷰 \(x_2\) 를 보고 낸 분포가, 교사가 뷰 \(x_1\) 을 보고 낸 분포와 같아지도록 학생만 기울기로 학습한다(뷰를 맞바꾼 것도 함께).
- 교사는 기울기로 배우지 않는다. 스텝마다 학생의 가중치 쪽으로 조금씩 끌려간다(지수 이동 평균).
DINO 의 구조는 다음과 같다(원문 그림 6-4, DINO 논문 그림 2 를 따라 그린 것. 값은 DINO 논문의 기본값).
- 라벨 없는 그림 \(x\) 를 두 번 증강해 뷰 \(x_1\), \(x_2\) 를 만든다. 학생과 교사는 같은 그림의 서로 다른 뷰를 본다.
- 학생 \(g_{\theta_s}\) (ViT + 투영 머리)의 출력에 온도 \(\tau_s = 0.1\) 의 소프트맥스를 씌워 \(P_s\) 를 만든다.
- 교사 \(g_{\theta_t}\) (같은 구조, 다른 가중치)의 출력에서 중심 \(c\) 를 빼고 온도 \(\tau_t = 0.04\) (더 낮게)의 소프트맥스를 씌워 \(P_t\) 를 만든다. 교사 쪽에는 기울기 차단이 있다.
- 손실은 교차 엔트로피 \(-\sum_k P_t(k) \log P_s(k)\) 이다. 기울기는 학생 쪽으로만 흐르고, 교사는 EMA \(\theta_t \leftarrow m\theta_t + (1-m)\theta_s\) 로 학생을 천천히 따라간다.
- 뷰를 맞바꾼 쌍(학생이 \(x_1\), 교사가 \(x_2\))도 똑같이 계산해 평균한다.
\(K\) 개의 항목이 무엇인지는 아무도 정해 주지 않는다. 이름 없는 \(K\) 개의 “가상 분류 칸” 이고, 학습이 진행되며 망이 스스로 그림들을 이 칸들에 나눠 담게 된다(DINO 논문의 기본값은 \(K = 65{,}536\)). 비슷한 그림은 비슷한 칸에, 다른 그림은 다른 칸에 담기는 쪽으로 가야 두 뷰의 답이 일관되면서도 붕괴하지 않는다. 이제 부품을 하나씩 식으로 본다.
- 주의 · 이름이 같은 다른 것들
- 탐지 분야에는 “DINO” 라는 이름의 탐지기(DETR 계열, Zhang 등 2022)와 그것을 열린 어휘로 넓힌 GroundingDINO 도 있다. 이 장의 DINO · DINOv2 는 그것들과 무관한 자기 지도 사전 학습 방법 이다. 9장에서 LW-DETR 의 질의 선택을 설명할 때 탐지기 쪽의 DINO 가 잠깐 나온다.
교사는 학생의 지수 이동 평균
교사의 가중치 \(\theta_t\) 는 학생의 가중치 \(\theta_s\) 가 한 스텝 갱신될 때마다 다음 규칙으로 바뀐다.
\(\theta_t \leftarrow m\,\theta_t + (1 - m)\,\theta_s\)
\(m\) 은 0 과 1 사이의 수(모멘텀)이고 1 에 아주 가깝게 둔다. 화살표 \(\leftarrow\) 는 “오른쪽 값을 계산해 왼쪽에 새로 넣는다” 는 뜻이다. 교사의 새 값은 옛 교사 \(m\) 만큼 + 지금의 학생 \((1 - m)\) 만큼 을 섞은 것이다. 이런 갱신을 지수 이동 평균(EMA)이라 한다(RF-DETR 도 학습에 EMA 를 쓴다. 11장).
- EMA 를 풀어 쓰면 — 과거 학생들의 가중 평균
- \(\theta_t^{(1)} = m\,\theta_t^{(0)} + (1 - m)\,\theta_s^{(1)}\)
- 첫 스텝 뒤의 교사이다. 위첨자 \((n)\) 은 \(n\) 번째 스텝 뒤의 값이다.
- 둘째 스텝의 식에 첫 스텝의 결과를 넣고 펼쳤다. 한 스텝 전의 학생에는 \(m\) 이 한 번 더 곱해진다.
- 같은 일을 \(n\) 번 되풀이한 꼴이다. \(j\) 스텝 전의 학생은 가중치 \((1 - m)\,m^{j}\) 를 받는다. 오래될수록 \(m\) 이 거듭 곱해져 지수적으로 잊힌다. 그래서 “지수” 이동 평균이다.
- 가중치를 모두 더하면 1 이다(등비급수의 합 \(\sum_{j=0}^{n-1} m^j = \frac{1 - m^n}{1 - m}\)). 교사는 처음 값과 그동안의 학생들을 섞은 평균 이다. 가중치가 \(1/e\) 로 줄어드는 데 걸리는 스텝은 약 \(1/(1 - m)\) 이다.
- 손계산 — 숫자 하나짜리 가중치
- \(\theta_t = 1,\ \theta_s = 2,\ m = 0.9: \quad \theta_t \leftarrow 0.9 \cdot 1 + 0.1 \cdot 2 = 1.1\)
- 교사가 학생 쪽으로 차이(1)의 10% 만큼 움직였다. 학생이 2 에 머문다면 다음은 \(0.9 \cdot 1.1 + 0.2 = 1.19\), 그다음은 \(1.271\) 이다. 남은 차이가 스텝마다 0.9 배(\(1 \to 0.9 \to 0.81 \to 0.729\))가 된다.
- DINO 의 시작 값이다. 한 스텝에 차이의 0.4% 만 움직인다. 교사는 아주 굼뜨다.
- 차이가 반으로 줄기까지의 스텝 수이다. \(m = 0.996\) 이면 교사는 대략 최근 250스텝(\(1/(1 - m)\))의 학생을 평균한 것과 같다.
[hand] EMA m = 0.9: θ_t = 1.1000, 차이가 반으로 줄기까지 6.6 스텝
[hand] EMA m = 0.996: θ_t = 1.0040, 차이가 반으로 줄기까지 172.9 스텝
왜 이렇게 굼뜬 교사가 좋을까? 교사가 학생과 똑같다면(\(m = 0\)) 학생은 자기 자신의 답을 목표로 삼는 셈이라, 목표가 스텝마다 흔들리고 쉽게 무너진다. DINO 논문도 학생의 가중치를 그대로 복사한 교사로는 수렴하지 않는다고 보고한다. 여러 스텝의 학생을 평균한 교사는 흔들림이 줄어든, 더 안정적인 목표 를 준다. 논문은 이 교사가 학습 내내 학생보다 성능이 좋았다고 보고하고(여러 모델을 평균하면 좋아지는 효과와 같다고 해석한다), “조금 더 나은 교사를 따라가며 학생이 좋아지고, 그 학생으로 교사가 다시 좋아지는” 선순환이 생긴다. DINO 는 \(m\) 을 0.996 에서 시작해 코사인 곡선을 따라 1 까지 올린다(DINOv2 는 0.994 에서 1).
- 주의 · 기호
- DINO 논문은 교사의 EMA 비율을 \(\lambda\), 중심의 EMA 비율을 \(m\) 이라고 쓴다. 이 장에서는 교사의 것을 \(m\), 중심의 것을 \(m_c\) 로 쓴다. 또 이 장에서 아래 첨자 \(s\), \(t\) 는 늘 학생(student) · 교사(teacher)이다. 시각(time)이 아니다.
온도가 있는 소프트맥스
망이 낸 점수 벡터를 \(a \in \mathbb{R}^K\) 라 하자(학생의 점수는 \(a = g_{\theta_s}(x)\)). 4장의 소프트맥스는 점수를 확률 분포로 바꾼다. DINO 는 여기에 온도(temperature) \(\tau\)(타우, 0 보다 큰 수) 하나를 넣어, 점수를 \(\tau\) 로 나눈 뒤 소프트맥스를 씌운다.
\(P_s(k) = \frac{\exp(a_k / \tau_s)}{\sum_{j=1}^{K} \exp(a_j / \tau_s)}, \qquad k = 1, \dots, K\)
\(P_s(k)\) 는 학생이 \(k\) 번째 칸에 준 확률, \(\tau_s\) 는 학생의 온도이다. 온도가 낮을수록 점수 차이가 크게 부풀려져 분포가 한 칸으로 쏠리고(날카로워지고), 높을수록 고르게 퍼진다. \(\tau \to 0\) 이면 가장 큰 칸이 1 을 다 갖는 원-핫 분포, \(\tau \to \infty\) 이면 모든 칸이 \(1/K\) 인 균등 분포가 된다.
- 손계산 — 같은 점수, 다른 온도 (\(K = 3\))
- \(a = (0.2,\ 0.1,\ 0.0), \quad \tau = 0.1: \quad a / \tau = (2,\ 1,\ 0)\)
- 점수를 온도로 나눈다. 0.1 로 나누면 10배가 된다.
- 지수를 취하고 합으로 나눈다. 첫 칸이 가장 크지만 다른 칸에도 확률이 꽤 남아 있다.
- 같은 점수를 더 낮은 온도 0.04 로 나누면 25배가 되어 차이가 더 벌어진다.
- 온도를 낮추자 첫 칸의 확률이 0.665 에서 0.918 로 올랐다. 분포가 날카로워졌다.
DINO 는 학생에게 \(\tau_s = 0.1\), 교사에게 그보다 낮은 \(\tau_t\) 를 쓴다(0.04 에서 시작해 처음 30 에폭 동안 0.07 까지 올린다). 교사의 분포가 학생의 분포보다 늘 더 날카롭다는 뜻이다. 위의 숫자가 바로 그 상황이다. 학생과 교사가 똑같은 점수를 냈더라도, 교사의 분포 \((0.918, 0.075, 0.006)\) 가 학생의 분포 \((0.665, 0.245, 0.090)\) 보다 더 확신에 차 있다. 학생은 그 확신에 찬 분포를 따라가야 하므로 점수 차이를 더 벌리는 쪽으로 밀린다. 이것이 sharpening 이고, 붕괴와 어떤 관계인지는 곧 본다.
손실: 두 분포의 교차 엔트로피
학생의 분포 \(P_s\) 를 교사의 분포 \(P_t\) 에 가깝게 만드는 손실로 교차 엔트로피 를 쓴다. 4장의 분류 손실과 같은 꼴이고, 정답 자리에 원-핫 라벨 대신 교사의 분포가 들어간다.
\(\mathrm{CE}(P_t, P_s) = -\sum_{k=1}^{K} P_t(k)\,\log P_s(k)\)
뷰가 둘일 때 DINO 의 손실은 “교사가 \(x_1\), 학생이 \(x_2\)” 와 “교사가 \(x_2\), 학생이 \(x_1\)” 두 쌍의 평균이다(DINO 논문의 알고리즘 1). 같은 뷰끼리는 비교하지 않는다. \(P_t(x_1)\) 은 뷰 \(x_1\) 을 본 교사의 분포라는 뜻이다.
\(\mathcal{L}_{\text{DINO}} = \tfrac{1}{2}\,\mathrm{CE}\big(P_t(x_1),\, P_s(x_2)\big) + \tfrac{1}{2}\,\mathrm{CE}\big(P_t(x_2),\, P_s(x_1)\big)\)
이 손실을 학생의 가중치 \(\theta_s\) 로만 미분한다. 교사 쪽 \(P_t\) 는 기울기 차단(stop-gradient)을 걸어 상수로 취급한다. 교사는 EMA 로만 바뀌어야 하기 때문이다. 학생의 점수 \(a\) 에 대한 기울기를 구해 보면 손실이 학생을 어디로 미는지 보인다.
- 교차 엔트로피를 학생 점수로 미분하기
- \(\log P_s(k) = \frac{a_k}{\tau_s} - \log\sum_{j=1}^{K}\exp\!\left(\frac{a_j}{\tau_s}\right)\)
- 소프트맥스의 정의에 로그를 씌웠다. 분자의 로그에서 분모의 로그를 뺀 것이다.
- \([k = i]\) 는 \(k\) 와 \(i\) 가 같으면 1, 다르면 0 이다. 첫 항 \(a_k/\tau_s\) 는 \(i = k\) 일 때만 \(a_i\) 를 품고, 둘째 항의 미분은 로그의 미분(안쪽의 미분 ÷ 안쪽)이라 소프트맥스 \(P_s(i)\) 가 그대로 나온다.
- \(P_t\) 는 상수(기울기 차단)이므로 합 밖으로 미분이 들어간다. \([k = i]\) 가 있는 항은 \(k = i\) 하나만 남아 \(P_t(i)\) 가 된다.
- \(\sum_k P_t(k) = 1\) 을 썼다. 기울기는 학생의 확률 − 교사의 확률 이다. 학생이 교사보다 확률을 많이 준 칸의 점수는 내리고, 적게 준 칸의 점수는 올린다. \(P_s = P_t\) 이면 기울기가 0 이다.
위의 숫자 예로 값을 넣어 보자. \(P_t = (0.918, 0.075, 0.006)\), \(P_s = (0.665, 0.245, 0.090)\) 일 때 \(\mathrm{CE} = -(0.918 \ln 0.665 + 0.075 \ln 0.245 + 0.006 \ln 0.090) = 0.374 + 0.106 + 0.015 = 0.495\) 이고, 기울기는 \((0.665 - 0.918,\ 0.245 - 0.075,\ 0.090 - 0.006)/0.1 = (-2.53,\ 1.69,\ 0.84)\) 이다. 경사 하강법은 기울기의 반대 방향으로 가므로 첫 칸의 점수는 오르고 나머지는 내린다. 학생이 더 날카로워진다.
교차 엔트로피는 두 조각으로 나눌 수 있고, 이 분해가 붕괴를 재는 자가 된다.
- 교차 엔트로피 = 교사의 엔트로피 + KL 발산
- \(\mathrm{CE}(P_t, P_s) = -\sum_k P_t(k)\log P_s(k) = -\sum_k P_t(k)\log P_t(k) + \sum_k P_t(k)\log\frac{P_t(k)}{P_s(k)}\)
- \(\log P_s = \log P_t - \log(P_t / P_s)\) 를 넣어 둘로 갈랐다. 더하고 뺀 것뿐이다.
- 첫 항 \(\mathrm{Ent}(P_t) = -\sum_k P_t(k)\log P_t(k)\) 는 교사 분포의 엔트로피(얼마나 퍼져 있는가: 원-핫이면 0, 균등이면 \(\log K\)), 둘째 항은 교사와 학생의 KL 발산(두 분포가 얼마나 다른가: 같으면 0)이다. 숫자 예에서는 \(0.495 = 0.305 + 0.191\) 이다.
(출력의 H, h 는 DINO 논문의 표기이다. 이 장의 본문은 그림의 높이 \(H\) 와 헷갈리지 않게 \(\mathrm{CE}\), \(\mathrm{Ent}\) 로 쓴다.) 엔트로피와 KL 에 대해 더 자세히는 World Model 튜토리얼 3장에 있다.
붕괴의 두 형태
붕괴는 “어떤 그림이 들어와도 출력이 같다” 는 것이었다. 분포로 보면 두 가지 극단이 있다.
| 붕괴의 형태 | 모든 그림에 대한 출력 | 교사 엔트로피 \(\mathrm{Ent}(P_t)\) | KL | 손실 |
| 한 칸으로 쏠림 | 늘 같은 칸에 확률 1 | 0 | 0 | 0 |
| 균등 | 모든 칸에 \(1/K\) | \(\log K\) | 0 | \(\log K\) |
| (건강한 상태) | 그림마다 다른 칸 | 그 사이 | 0 보다 큼 | — |
두 경우 모두 교사의 분포가 그림과 무관하므로 학생이 그것을 완벽히 베낄 수 있고, KL 이 0 으로 간다. DINO 논문은 이것을 붕괴의 신호로 쓴다(5.3절: KL 이 0 이면 출력이 상수, 곧 붕괴). 두 붕괴는 엔트로피로 구별된다. 한 칸 쏠림은 0, 균등은 \(\log K\) 이다(\(K = 65{,}536\) 이면 \(\ln 65536 = 16 \ln 2 \approx 11.09\)).
왜 그리로 끌려갈까? 한 칸 쏠림은 손실의 가장 깊은 바닥(0)이다. 교사와 학생이 서로를 따라가는 구조에서 어느 한 칸이 우연히 조금 앞서면, 교사의 낮은 온도가 그 칸을 더 부풀리고, 학생이 따라가고, EMA 로 교사가 다시 그쪽으로 간다. 스스로 커지는 되먹임이다. 반대로 균등은 “아무 칸도 고르지 않는” 안전한 답이다.
centering 과 sharpening
DINO 는 교사 쪽에만 두 가지 조작을 해서 두 붕괴를 서로 상쇄시킨다. 교사의 점수를 \(b = g_{\theta_t}(x) \in \mathbb{R}^K\) 라 하면
\(P_t(k) = \frac{\exp\big((b_k - c_k)/\tau_t\big)}{\sum_{j=1}^{K}\exp\big((b_j - c_j)/\tau_t\big)}\)
- centering(중심 빼기). \(c \in \mathbb{R}^K\) 는 중심 으로, 지금까지 교사가 낸 점수들의 평균이다. 배치마다 교사 점수의 평균으로 EMA 갱신한다(\(B\) 는 배치 크기, \(x^{(i)}\) 는 배치의 \(i\) 번째 그림). \(c \leftarrow m_c\,c + (1 - m_c)\cdot\frac{1}{B}\sum_{i=1}^{B} g_{\theta_t}\big(x^{(i)}\big)\) 모든 그림에서 공통으로 높은 칸은 \(c\) 도 높으므로, \(c\) 를 빼면 그 칸의 우위가 사라진다. 한 칸 쏠림을 막는다. 하지만 centering 만 하면 반대쪽으로 간다. 모든 그림의 점수가 같아질수록 \(b - c\) 가 0 에 가까워지고, 소프트맥스는 균등 분포를 낸다. centering 은 균등 붕괴를 부추긴다.
- sharpening(날카롭게 하기). 교사의 온도 \(\tau_t\) 를 낮게 두는 것이다. 작은 점수 차이도 크게 부풀려 분포를 한쪽으로 쏠리게 하므로 균등 붕괴를 막는다. 하지만 sharpening 만 하면 한 칸 쏠림을 부추긴다.
둘은 정반대 방향으로 밀기 때문에 함께 쓰면 균형이 잡힌다. “배치 전체로는 칸을 고르게 쓰되(centering), 그림 하나하나는 분명하게 한 칸을 고른다(sharpening)” 는 상태이다. 그러려면 그림마다 서로 다른 칸을 골라야 하고, 그것이 바로 그림을 구별하는 특징을 배운다는 뜻이다.
- 손계산 — 한 칸으로 쏠리기 시작한 교사에 centering 을 걸면 (\(K = 3\), 그림 2장, \(\tau_t = 0.04\))
- \(b^{(1)} = (0.30,\ 0.10,\ 0.00), \qquad b^{(2)} = (0.28,\ 0.12,\ 0.02)\)
- 두 그림에 대한 교사 점수이다. 둘 다 첫 칸이 가장 높다. 쏠림이 시작된 상황이다. 하지만 두 그림의 점수가 완전히 같지는 않다.
- \(e^{7.5} = 1808.0\), \(e^{2.5} = 12.2\), \(e^0 = 1\) 이라 첫 칸이 거의 다 가져간다. 둘째 그림도 \(\operatorname{softmax}(7,\ 3,\ 0.5) = (0.981,\ 0.018,\ 0.001)\) 로 같은 칸이다. 두 그림이 구별되지 않는다. 붕괴 직전이다.
- 중심은 두 점수의 평균이다(이동 평균이 이 값에 수렴했다고 친다). 공통으로 높은 첫 칸이 \(c\) 에서도 높다.
- 중심을 빼자 공통 부분이 사라지고 두 그림의 차이 만 남았다. 첫 그림은 평균보다 첫 칸이 조금 높고, 둘째 그림은 조금 낮다.
- 온도 0.04 로 나누어 소프트맥스를 씌웠다. 이제 두 그림의 목표 분포가 서로 다르다. 첫 그림은 첫 칸으로, 둘째 그림은 나머지 칸으로 기울었다. 차이가 0.01 뿐이었는데도 낮은 온도가 그것을 눈에 보이는 차이로 키웠다. centering 이 공통 부분을 지우고, sharpening 이 남은 차이를 키운다.
[hand] 중심 c = [0.29, 0.11, 0.01]
[hand] centering 없이: [[0.9928, 0.0067, 0.0005], [0.9806, 0.018, 0.0015]]
[hand] centering 하고: [[0.4519, 0.2741, 0.2741], [0.2327, 0.3837, 0.3837]]
DINO 논문은 centering 을 “교사에 편향 항 \(c\) 를 더하는 것” 으로도 설명하고, 배치의 1차 통계(평균)에만 의존하므로 배치 크기가 달라도 잘 동작한다고 말한다. 논문 그림 7 의 실험에서, 둘 중 하나라도 빼면 KL 이 0 으로 수렴(붕괴)했고 엔트로피는 centering 을 빼면 0 으로, sharpening 을 빼면 \(\log K\) 로 갔다. 이 장의 실험에서 같은 것을 직접 본다.
멀티 크롭
DINO 는 뷰를 둘만 쓰지 않는다. 멀티 크롭(multi-crop) 은 한 그림에서 크기가 다른 뷰를 여러 장 만드는 방법이다.
- 전역 뷰 2장: 그림의 넓은 영역(예: 넓이의 50% 이상)을 잘라 224×224 로.
- 지역 뷰 여러 장: 좁은 영역(예: 50% 미만)을 잘라 96×96 으로.
학생은 모든 뷰를 보고, 교사는 전역 뷰만 본다. 학생은 그림의 작은 조각만 보고도, 교사가 넓은 뷰를 보고 낸 답을 맞혀야 한다. 논문은 이것이 “부분에서 전체로(local-to-global)” 의 대응을 배우게 한다고 말한다. 지역 뷰는 작아서(96×96 이면 패치 16 기준 6×6 = 36 토큰) 계산이 싸므로, 적은 비용으로 뷰를 많이 늘릴 수 있다. 해상도가 다른 뷰를 같은 ViT 에 넣어야 하니 위치 임베딩 보간 이 여기서도 쓰인다(DINO 는 쌍삼차 보간을 쓴다).
| DINO 의 설정 (논문에서 확인한 값) | 값 |
| 학생 온도 \(\tau_s\) | 0.1 |
| 교사 온도 \(\tau_t\) | 0.04 → 0.07 (처음 30 에폭 동안 선형으로 올림). 부록 D: 0.06 보다 높게 시작하면 붕괴 |
| 교사 EMA 비율 (이 장의 \(m\)) | 0.996 → 1 (코사인) |
| 중심 EMA 비율 (이 장의 \(m_c\)) | 부록 D 의 표: 0 – 0.99 에서 고르게 동작, 0.999 에서는 붕괴 |
| 출력 차원 \(K\) | 65,536 |
| 투영 머리 | 3층 MLP(은닉 2048) → 길이 1 로 정규화 → 가중치를 정규화한 선형 층(\(K\) 차원) |
| 뷰 | 전역 224×224 2장 + 지역 96×96 여러 장 |
| 옵티마이저 · 배치 | AdamW, 배치 1024 (ViT-S/16) |
DINOv2: 더 크게, 더 촘촘하게
Oquab 등(2023)의 DINOv2(DINOv2) 는 새로운 원리를 내놓은 논문이 아니다. DINO 계열의 자기 증류를 훨씬 큰 데이터와 모델로 안정적으로 키우기 위한 개선의 묶음 이다. 논문 스스로 자기 방법을 “DINO 와 iBOT 의 손실을 SwAV 의 centering 과 함께 쓴 것” 이라고 요약한다.
그림 수준과 패치 수준 손실을 함께
DINOv2 의 학습 목표는 다음 부품들의 합이다. 앞의 둘이 핵심이고, 나머지는 이름과 역할만 알아 두면 된다.
- 그림 수준 손실(DINO). 앞 절에서 본 것 그대로이다. 학생과 교사의 CLS 토큰 출력을 투영 머리에 넣고, 서로 다른 뷰 사이에서 교차 엔트로피를 계산한다. “이 그림이 통째로 무엇인가” 를 배운다.
- 패치 수준 손실(iBOT). Zhou 등(2022)의 iBOT(image BERT pre-training with online tokenizer) 에서 온 것이다. 학생에게 주는 그림에서 패치 일부를 가린다(가린 자리에는 학습되는 마스크 토큰을 넣는다). 교사는 가리지 않은 그림을 본다. 학생이 가려진 자리에서 낸 출력이, 교사가 같은 자리의 패치 토큰에서 낸 출력과 같아지도록 교차 엔트로피를 계산한다. 앞에서 본 두 갈래(가리고 맞히기 · 두 뷰를 같게)를 하나로 묶은 셈이다. 픽셀을 맞히는 것이 아니라 교사의 패치 특징 을 맞힌다는 점이 중요하다. 패치 하나하나의 특징 을 직접 다듬는 손실이다.
- 머리를 따로. 두 손실이 투영 머리를 따로 가진다(iBOT 은 공유했지만, 큰 규모에서는 따로가 낫다고 보고한다).
- Sinkhorn-Knopp centering. 교사 쪽의 “중심 빼기 + 소프트맥스” 를 SwAV 의 Sinkhorn-Knopp 정규화(3회 반복)로 바꾼다. 붕괴를 막는 같은 역할을 하는 다른 계산이다.
- KoLeo 정규화. 배치 안에서 각 특징이 가장 가까운 이웃과 너무 붙지 않도록 밀어내, 특징이 공간에 고르게 퍼지게 하는 항이다.
- 해상도 올리기. 사전 학습의 끝에 잠깐 518×518 로 학습한다. 논문은 높은 해상도가 분할 · 탐지 같은 픽셀 수준 과제에 중요하다고(작은 객체가 낮은 해상도에서는 사라지므로) 이유를 든다.
논문의 절제 실험(표 3)은 두 항의 역할을 따로 보여 준다. iBOT 의 패치 수준 항은 밀집 예측 과제(ADE-20k 분할)에 결정적이어서 빼면 약 3% 가 떨어졌고, KoLeo 항은 이웃 찾기 과제(그림 검색)를 8% 넘게 올렸다. 탐지기의 백본으로서 우리가 관심 있는 것은 앞쪽, 패치 특징 이다.
데이터와 모델
- LVD-142M(DINOv2 의 사전 학습 데이터). 라벨 없는 그림 1억 4,200만 장이다. 인터넷에서 긁은 그림을 그대로 쓰지 않고, 잘 정리된 여러 데이터셋의 그림과 비슷한 것을 검색해 골라 모은(그리고 중복을 걸러 낸) 데이터이다. 라벨도 글(캡션)도 쓰지 않는다. 논문은 같은 모델을 ImageNet-22k(1,400만 장)로 학습한 것과 비교해 대부분의 벤치마크에서 LVD-142M 이 낫다고 보고한다.
- 큰 모델을 학습하고, 작은 모델은 증류. 매개변수 약 10억 개인 ViT-g 를 처음부터 학습하고, ViT-S · B · L 은 처음부터 학습하는 대신 ViT-g 를 얼린 교사로 삼아 증류 한다. 이때의 교사는 EMA 로 만든 것이 아니라 이미 학습이 끝난 큰 모델이다. 본래 뜻의 증류이다. RF-DETR 이 쓰는 ViT-S/14 는 이렇게 만들어진 것이고, 작지만 큰 모델의 지식을 물려받았다.
- 패치 크기 14. 논문의 절제 표(표 1)에 “패치 크기 14” 가 개선 항목의 하나로 들어 있다. 16 보다 조금 촘촘하다.
레지스터 토큰
DINOv2 가 나온 뒤, 같은 연구진의 Darcet 등(2023)은 “Vision Transformers Need Registers” 에서 이상한 현상을 보고했다. DINOv2 를 비롯한 여러 ViT 의 어텐션 지도와 특징 맵에, 그림의 내용과 무관한 튀는 점(artifact) 이 군데군데 나타난다는 것이다. 논문이 밝힌 사실은 이렇다.
- 튀는 점은 출력의 크기(노름)가 다른 토큰보다 약 10배 큰 토큰이다.
- 주로 하늘 · 벽 같은 정보가 적은 배경, 곧 이웃 패치와 내용이 거의 같아 없어도 되는 패치에서 생긴다.
- 이 토큰들은 자기 자리의 정보(위치, 원래 픽셀)는 덜 담고, 대신 그림 전체 에 대한 정보를 더 담고 있다.
- 충분히 크고 충분히 오래 학습한 모델에서 나타난다.
논문의 가설은, 모델이 쓸모없는 배경 패치 자리를 전역 정보를 적어 두는 메모장 으로 재활용한다는 것이다. 그 자체는 나쁘지 않지만, 그 자리의 패치 특징이 망가지므로 밀집 예측(패치 특징을 쓰는 과제)에는 해롭다.
해법은 단순하다. 메모장이 필요하다면 따로 주면 된다. 레지스터 토큰(register tokens) 은 CLS 토큰처럼 어떤 패치에도 속하지 않는 학습되는 여분의 토큰 몇 개를 토큰 열에 끼워 넣은 것이다. 블록들을 다 지난 뒤 레지스터의 출력은 버린다. 쓰는 것은 여전히 CLS 와 패치 토큰뿐이다. 논문은 레지스터 하나만 넣어도 튀는 점이 사라지고, 더 넣으면 성능이 더 좋아진다고 보고하며 모든 실험에서 4개를 썼다. 토큰 열은 [CLS, 레지스터 4개, 패치 N개] 가 된다.
- 참고 · RF-DETR 은 레지스터를 쓰나
RF-DETR 의 백본 클래스 이름은 WindowedDinov2WithRegistersBackbone 이라서 레지스터를 쓰는 것처럼 보인다. 공개 코드를 확인하면 사실은 이렇다.
- 이 클래스는 레지스터가 있을 수도 없을 수도 있는 구현이다. 설정값
num_register_tokens가 0 이면 레지스터 토큰을 만들지 않는다. - 인코더 이름에
registers가 들어 있을 때만use_registers=True가 되고, 그렇지 않으면num_register_tokens=0으로 만든다(models/backbone/backbone.py,dinov2.py). - 공개된 모델 설정(
config.py)의 인코더는 모두dinov2_windowed_small또는dinov2_windowed_base이다. 이름에registers가 없다.dinov2_registers_windowed_small이라는 이름은 고를 수 있는 값으로 정의만 되어 있다.
곧, 이 튜토리얼이 확인한 공개 설정(rfdetr 1.12.1 과 1.13.0.dev)의 RF-DETR 백본은 레지스터 없는 DINOv2 이고, 토큰 열은 [CLS, 패치 N개] 이다. RF-DETR 논문에도 레지스터에 대한 언급은 없다.
탐지 백본으로서의 DINOv2
패치 특징이 좋다는 것
그림 분류에는 CLS 출력 하나면 되지만, 탐지에는 패치마다의 특징, 곧 밀집 특징(dense features) 이 좋아야 한다. “이 패치는 어떤 객체의 일부다”, “이 패치와 저 패치는 같은 객체에 속한다” 가 특징에서 읽혀야 디코더가 박스를 그릴 수 있다. DINOv2 논문이 패치 특징에 대해 주장하는 것은 다음과 같다(모두 논문이 직접 보인 범위이다).
- 백본을 얼린 채 패치 특징 위에 선형 층 하나만 학습해도 의미 분할(ADE20K 등)과 깊이 추정에서 경쟁력 있는 결과가 나온다.
- 패치 특징에 주성분 분석(PCA)을 하면, 첫 주성분만으로 그림의 주된 객체와 배경이 갈린다.
- 나머지 주성분은 객체의 “부위” 에 대응하고, 같은 종류의 다른 그림 사이에서도 같은 부위가 같은 색으로 맞춰진다. 논문은 이것을 “창발한 성질” 이라 부른다. 부위를 가르도록 학습시킨 적이 없기 때문이다.
이 논문은 DINOv2 를 탐지기의 백본으로 미세 조정하는 실험은 하지 않았다. 그 근거는 RF-DETR 논문에서 온다.
RF-DETR 논문의 근거
RF-DETR 은 LW-DETR(9장)에서 출발해 백본을 CAEv2 에서 DINOv2 로 바꿨다. 논문의 절제 실험에서 백본에 관한 줄만 뽑으면 다음과 같다(COCO, M 크기).
| 출처 | 설정 | AP | 지연 시간 |
| 표 5 | LW-DETR (M) | 52.6 | 4.4 ms |
| + 순한 하이퍼파라미터(낮은 학습률, 층 정규화 등) | 51.6 | 4.4 ms | |
| + DINOv2 백본 | 53.6 | 4.7 ms | |
| + Objects-365 추가 사전 학습 | 54.3 | 4.7 ms | |
| 표 6 | CAEv2 ViT-S/16 (10층) 백본 | 52.3 | 4.4 ms |
| DINOv2 ViT-S/14 백본 | 54.3 | 4.7 ms | |
| SigLIPv2 ViT-B/32 백본 | 50.4 | 4.8 ms | |
| SAM2 Hiera-S 백본 | 53.6 | 11.2 ms |
논문이 이 표들에서 끌어내는 것은 네 가지이다.
- 백본만 바꿔도 +2 AP. 표 5 에서 51.6 → 53.6, 표 6 에서 52.3 → 54.3 이다. 대신 DINOv2 는 12층이라 10층인 CAEv2 보다 느리다(4.4 → 4.7 ms). 논문은 이 지연 시간을 NAS 로 만회한다고 말한다.
- 작은 데이터셋에서 특히 유리. 논문은 DINOv2 의 사전 학습 가중치로 백본을 초기화하면 작은 데이터셋에서의 탐지 정확도가 크게 오른다고 적는다. 인터넷 규모로 사전 학습한 지식이 적은 데이터를 메워 준다는 것이 RF-DETR 전체의 논지이다.
- 학습률을 낮춰 사전 지식을 보존. RF-DETR 은 학습률을 LW-DETR 의 4e-4 에서 1e-4 로 낮췄고, 논문은 낮은 학습률이 DINOv2 의 사전 학습 지식을 보존하는 데 도움이 된다고 설명한다. 좋은 출발점일수록 거칠게 흔들면 손해이다.
- 층별 학습률 감쇠 0.8. 백본의 층마다 학습률에 0.8 을 거듭 곱해, 입력에 가까운 층일수록 학습률을 낮춘다. 논문은 DINOv2 백본의 정보(특히 앞쪽 층)를 보존하기 위해서라고 밝힌다. 구체적인 셈은 11장에서 한다.
표 6 의 다른 두 백본에 대해 논문은, SAM2 의 Hiera-S 가 매개변수는 적은데도 훨씬 느렸다는 점(11.2 ms)과, 파운데이션 모델들이 보통 ViT-S 같은 가벼운 크기를 공개하지 않아 실시간 용도로 쓰기 어렵다는 점을 짚는다. DINOv2 는 가벼운 ViT-S 가 공개되어 있고, 패치 특징이 좋으며, 순수한 ViT 구조라 최적화가 잘 된다 는 세 조건을 함께 갖춘 선택이었다.
RF-DETR 이 고쳐 쓰는 세 가지
RF-DETR 은 DINOv2 ViT 를 그대로 쓰지 않고 세 군데를 고친다. 이 장에서 배운 것이 각각의 바탕이 된다.
- 일부 블록을 윈도 어텐션으로. 앞에서 센 제곱 항 \(2N^2D\) 를 줄이려고, 12개 블록 가운데 일부는 토큰을 윈도로 나눠 윈도 안에서만 어텐션을 한다. 나머지 블록은 전역 어텐션으로 남겨 윈도 사이의 정보를 잇는다. DINOv2 는 CLS 토큰이 있어야 하므로 윈도마다 CLS 토큰을 복제해 붙이는 처리가 들어간다. → 9장 · 10장
- 패치 크기와 해상도를 바꿔 쓰기. 14 로 사전 학습된 패치 임베딩을 16(탐지 N – L) · 20(XL · 2XL) · 12(분할)로 바꿔 쓰고, 위치 임베딩은 보간한다. 어떤 조합이 좋은지는 NAS 가 고른다. → 12장
- 여러 층의 패치 특징을 꺼내 프로젝터로. 마지막 층의 출력만 쓰지 않고, 중간 블록 몇 개(nano 는 3 · 6 · 9 · 12번째)의 패치 특징을 함께 꺼내 프로젝터가 하나로 합친다. CLS 출력은 탐지에 쓰지 않는다. → 10장
구현과 실험
이제 직접 만들어 돌려 본다. 실습 파일 code/ch06_vit.py 하나가 앞에서 본 검산(check · count · hand)과 다음 실험을 차례로 한다.
-
MiniViT를 라벨로 지도 학습하고, 다른 해상도의 그림에 적용해 본다. - 학습된 위치 임베딩을 들여다본다.
- 라벨 없이 미니 DINO 를 돌리고, centering · sharpening 을 하나씩 꺼서 붕괴를 본다.
- 얼린 백본 위의 선형 분류기로 “무작위 초기화 · 미니 DINO · 지도 학습” 백본의 특징을 비교한다.
실행
$ python ch06_vit.py            # 전체 실험. 8GB 노트북 GPU 로 10분 30초
$ python ch06_vit.py --quick    # 아주 작게 줄여 오류만 확인 (수치는 의미 없음)
데이터는 0장의 약속대로 학습 세트(시드 0) 8,000장, 검증 세트(시드 1) 1,000장, 시험 세트(시드 2) 1,000장이다. 아래의 표와 그림에 적은 최종 수치는 모두 시험 세트의 것이다. 도형 세상의 장면은 정규화 좌표로 적혀 있으므로 같은 시험 장면을 64×64 · 96×96 · 128×128 로 따로 그려 둔다. GPU 에서는 실행할 때마다 셋째 자리 숫자가 조금 달라질 수 있다. 아래 수치는 이 글을 쓰며 돌린 마지막 실행의 출력 그대로이다.
장치: cuda
데이터: 학습 8000장, 검증 1000장, 시험 1000장 × 해상도 64 · 96 · 128 (9.7초)
라벨이 1 인 비율 (원, 사각형, 삼각형): [0.599, 0.597, 0.6] → 늘 많은 쪽으로 찍으면 라벨 정확도 0.599
가장 큰 객체의 중심: 늘 평균 위치 [0.497, 0.497] 라고 답하면 중심 오차 0.2527
MiniViT 매개변수 480,581개 (공식 480,581), 토큰 수 1 + 144
MiniViT 를 지도 학습으로
먼저 라벨을 써서 ViT 가 제대로 학습되는지 본다. 과제는 탐지의 아주 작은 축소판이다. CLS 출력 위의 선형 머리가 숫자 5개를 낸다.
- 무엇이 있는가(로짓 3개): 그림에 원 · 사각형 · 삼각형이 각각 있는지. 한 그림에 여러 종류가 함께 있을 수 있으므로 소프트맥스가 아니라 클래스마다 따로 시그모이드 를 쓰는 다중 라벨 분류이고, 손실은 4장의 BCE 이다. RF-DETR 의 분류 머리도 클래스마다 시그모이드를 쓴다.
- 어디에 있는가(숫자 2개): 가장 큰 객체의 중심 \((c_x, c_y)\). 시그모이드로 0 – 1 에 넣고 정답과의 L1 거리(2장)를 손실로 쓴다.
둘째 과제를 넣은 까닭이 있다. “무엇이 있는가” 는 도형이 어디에 있든 답이 같아서 위치 정보가 거의 필요 없다. “어디에 있는가” 는 위치 임베딩 없이는 풀 수 없다. 위치 임베딩이 하는 일을 보려면 위치를 묻는 과제가 있어야 한다.
def presence_labels(targets) -> torch.Tensor:
    """정답 목록 → (그림 수, 3) 의 0/1 표: 그 그림에 원 · 사각형 · 삼각형이 있는가."""
    labels = torch.zeros(len(targets), NUM_CLASSES)
    for i, target in enumerate(targets):
        labels[i, target["labels"]] = 1.0
    return labels

def largest_centers(targets) -> torch.Tensor:
    """정답 목록 → (그림 수, 2): 박스 넓이가 가장 큰 객체의 중심 (cx, cy), 0 – 1 로 정규화된 좌표."""
    centers = torch.zeros(len(targets), 2)
    for i, target in enumerate(targets):
        boxes = target["boxes"]  # (객체 수, 4) = (cx, cy, w, h)
        centers[i] = boxes[(boxes[:, 2] * boxes[:, 3]).argmax(), :2]
    return centers
def train_supervised(model, train_images, train_labels, train_centers, val_images, val_labels, val_centers, epochs,
                     batch_size=128, lr=1e-3, weight_decay=0.05, center_weight=5.0, seed=0, log=print):
    """MiniViT 를 지도 학습한다. CLS 출력 위의 선형 머리가 숫자 5개를 낸다.

    - 앞의 3개: "원 · 사각형 · 삼각형이 있는가" 의 로짓. 손실은 4장의 BCE (라벨마다 따로, 평균).
    - 뒤의 2개: 가장 큰 객체의 중심 (cx, cy). 시그모이드로 0 – 1 에 넣고 정답과의 L1 거리(2장)를 손실로 쓴다.
    "무엇이 있는가" 와 "어디에 있는가" 를 함께 묻는, 탐지의 아주 작은 축소판이다.
    학습률은 워밍업(처음 5%) 뒤 코사인으로 줄인다. 증강은 좌우 뒤집기뿐이다 (뒤집으면 cx 는 1 − cx 가 된다).
    """
    generator = torch.Generator(device=train_images.device).manual_seed(seed)
    optimizer = torch.optim.AdamW(model.parameters(), lr=lr, weight_decay=weight_decay)
    steps_per_epoch = len(train_images) // batch_size
    total = epochs * steps_per_epoch
    warmup = max(1, total // 20)
    schedule = lambda step: min((step + 1) / warmup, 0.5 * (1 + math.cos(math.pi * step / total)))
    scheduler = torch.optim.lr_scheduler.LambdaLR(optimizer, schedule)
    history = []
    for epoch in range(epochs):
        model.train()
        order = torch.randperm(len(train_images), device=train_images.device, generator=generator)
        running = 0.0
        for i in range(steps_per_epoch):
            index = order[i * batch_size : (i + 1) * batch_size]
            images = to_float(train_images[index])  # (B, 3, 96, 96)
            centers = train_centers[index].clone()  # (B, 2)
            flip = torch.rand(len(index), device=images.device, generator=generator) < 0.5
            images = torch.where(flip[:, None, None, None], images.flip(-1), images)
            centers[:, 0] = torch.where(flip, 1 - centers[:, 0], centers[:, 0])
            outputs = model(images)  # (B, 5)
            loss_class = F.binary_cross_entropy_with_logits(outputs[:, :NUM_CLASSES], train_labels[index])
            loss_center = (outputs[:, NUM_CLASSES:].sigmoid() - centers).abs().mean()
            loss = loss_class + center_weight * loss_center
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            scheduler.step()
            running += loss.item()
        val_acc, val_exact, val_distance = evaluate(predict(model, val_images), val_labels, val_centers)
        history.append((running / steps_per_epoch, val_acc, val_exact, val_distance))
        if (epoch + 1) % max(1, epochs // 10) == 0 or epoch == 0:
            log(f"  에폭 {epoch + 1:3d} | 학습 손실 {history[-1][0]:.4f} | 검증 라벨 정확도 {val_acc:.3f} | 세 라벨 모두 {val_exact:.3f}"
                f" | 중심 오차 {val_distance:.4f}")
    return history
  에폭   1 | 학습 손실 1.4886 | 검증 라벨 정확도 0.653 | 세 라벨 모두 0.157 | 중심 오차 0.2640
  에폭   4 | 학습 손실 0.9990 | 검증 라벨 정확도 0.804 | 세 라벨 모두 0.536 | 중심 오차 0.1632
  에폭   8 | 학습 손실 0.6663 | 검증 라벨 정확도 0.903 | 세 라벨 모두 0.739 | 중심 오차 0.1450
  에폭  12 | 학습 손실 0.5377 | 검증 라벨 정확도 0.952 | 세 라벨 모두 0.862 | 중심 오차 0.1352
  에폭  16 | 학습 손실 0.4643 | 검증 라벨 정확도 0.958 | 세 라벨 모두 0.885 | 중심 오차 0.1185
  에폭  20 | 학습 손실 0.4072 | 검증 라벨 정확도 0.963 | 세 라벨 모두 0.893 | 중심 오차 0.1118
  에폭  24 | 학습 손실 0.3714 | 검증 라벨 정확도 0.975 | 세 라벨 모두 0.925 | 중심 오차 0.1072
  에폭  28 | 학습 손실 0.3281 | 검증 라벨 정확도 0.972 | 세 라벨 모두 0.917 | 중심 오차 0.1032
  에폭  32 | 학습 손실 0.2982 | 검증 라벨 정확도 0.974 | 세 라벨 모두 0.925 | 중심 오차 0.1016
  에폭  36 | 학습 손실 0.2761 | 검증 라벨 정확도 0.973 | 세 라벨 모두 0.923 | 중심 오차 0.0991
  에폭  40 | 학습 손실 0.2672 | 검증 라벨 정확도 0.973 | 세 라벨 모두 0.922 | 중심 오차 0.0994
지도 학습 121.7초
- 그림: 그림 6-5 왼쪽: 에폭에 따른 검증 정확도(파선: 라벨 하나하나, 점선: 세 라벨 모두 맞힘)와 중심 오차(실선, 오른쪽 축). 가운데 · 오른쪽: 96×96 으로 학습한 모델을 세 해상도의 시험 그림에 적용한 결과(다음 소절).
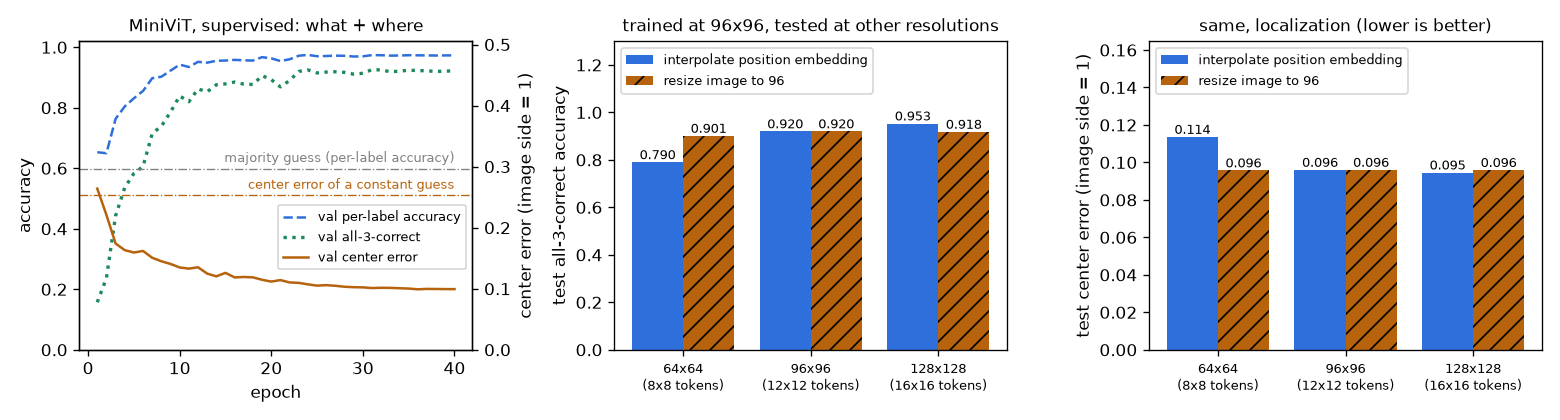
매개변수 480,581개짜리 작은 ViT 가 40 에폭 만에 라벨 정확도 0.973, 세 라벨을 모두 맞힌 비율 0.922 에 이른다(검증 세트). 늘 많은 쪽으로 찍는 기준은 0.599 이다. 가장 큰 객체의 중심은 평균 0.0994(그림 한 변을 1 로 본 거리, 96픽셀 그림에서 약 9.5픽셀) 틀린다. 늘 그림 한가운데라고 답할 때의 오차 0.2527 의 39% 수준이다. 그림 6-5 의 왼쪽에서 정확도는 10 에폭쯤에 대부분 오르지만 중심 오차는 끝까지 천천히 줄어든다. CLS 토큰 하나에 “어디” 를 담는 것이 “무엇” 을 담는 것보다 어렵다는 뜻이고, 탐지기가 CLS 가 아니라 패치 특징과 객체 질의를 쓰는 까닭이기도 한다.
해상도를 바꿔 넣어 보기
96×96(격자 12×12)으로 학습한 이 모델에 같은 장면의 64×64(격자 8×8) · 128×128(격자 16×16) 그림을 넣는다. 세 가지 방법을 비교한다.
- 보간 없이: 위치 임베딩을 그대로 더한다.
- 위치 임베딩 보간: 12×12 격자의 위치 임베딩을 8×8 또는 16×16 으로 쌍삼차 보간한다.
- 그림을 96 으로 바꿔 넣기(비교용): 그림 자체를 96×96 으로 크기를 바꿔 넣는다. 위치 임베딩은 손대지 않는다.
해상도 실험 (시험 세트, 같은 장면을 각 해상도로 그린 것)
   64×64  격자  8×8  토큰  64 | 보간 없이: 오류: The size of tensor a (65) must match the size of tensor b (145) at non
            위치 임베딩 보간:        라벨 정확도 0.921 | 세 라벨 모두 0.790 | 중심 오차 0.1136
            그림을 96 으로 바꿔 넣기: 라벨 정확도 0.966 | 세 라벨 모두 0.901 | 중심 오차 0.0957
   96×96  격자 12×12 토큰 144 | 보간 없이: 동작
            위치 임베딩 보간:        라벨 정확도 0.973 | 세 라벨 모두 0.920 | 중심 오차 0.0960
            그림을 96 으로 바꿔 넣기: 라벨 정확도 0.973 | 세 라벨 모두 0.920 | 중심 오차 0.0960
  128×128 격자 16×16 토큰 256 | 보간 없이: 오류: The size of tensor a (257) must match the size of tensor b (145) at no
            위치 임베딩 보간:        라벨 정확도 0.984 | 세 라벨 모두 0.953 | 중심 오차 0.0946
            그림을 96 으로 바꿔 넣기: 라벨 정확도 0.971 | 세 라벨 모두 0.918 | 중심 오차 0.0959
  위치 임베딩을 0 으로 지우면 (96×96): 라벨 정확도 0.905 | 세 라벨 모두 0.736 | 중심 오차 0.3249
| 시험 해상도 | 토큰 | 보간 없이 | 위치 임베딩 보간 | 그림을 96 으로 |
| 64×64 | 64 | 오류 | 0.790 · 0.1136 | 0.901 · 0.0957 |
| 96×96 (학습한 해상도) | 144 | 동작 | 0.920 · 0.0960 | 0.920 · 0.0960 |
| 128×128 | 256 | 오류 | 0.953 · 0.0946 | 0.918 · 0.0959 |
결과에서 읽을 것은 네 가지이다.
- 보간 없이는 아예 쓸 수 없다. 토큰이 65개(64 + CLS)인데 위치 임베딩은 145개라 더할 수 없다는 오류가 난다. 합성곱 신경망이라면 생기지 않을 문제이다.
- 해상도를 올린 쪽(128)은 그대로 유지된다. 세 라벨을 모두 맞힌 비율이 0.953, 중심 오차가 0.0946 으로, 학습한 해상도일 때(0.920, 0.0960)보다 떨어지지 않고 오히려 조금 좋다. 그림을 96 으로 줄여 넣은 것(0.918)보다도 낫다. 보간한 위치 임베딩이 16×16 격자에서도 위치를 제대로 알려 준다는 뜻이다.
- 해상도를 내린 쪽(64)은 떨어진다. 세 라벨을 모두 맞힌 비율이 0.920 에서 0.790 으로, 중심 오차가 0.0960 에서 0.1136 으로 나빠진다. 다만 같은 64×64 그림을 96 으로 키워 넣으면 0.901, 0.0957 까지 돌아오므로, 그림에 정보가 모자라서가 아니다. 64×64 에서는 패치 하나(8×8)가 도형의 가로세로 1.5배 넓은 부분을 담아, 패치의 내용이 학습 때와 달라진다. 위치 임베딩 보간의 오차와 이 변화가 함께 작용한 결과이고, 이 실험만으로는 둘을 가를 수 없다.
- 위치 임베딩을 지우면 “어디” 를 잃는다. 패치 자리의 위치 임베딩을 0 으로 지우면 중심 오차가 0.0960 에서 0.3249 로, 늘 한가운데라고 답하는 것(0.2527)보다도 나빠진다. 도형의 종류는 그래도 라벨 정확도 0.905(세 라벨 모두 0.736) 는 맞힌다. “무엇” 은 패치의 내용에, “어디” 는 위치 임베딩에 달려 있다.
미세 조정 없이 해상도만 바꿨을 때의 결과라는 점을 기억해 두자. RF-DETR 은 여기서 한 발 더 나아가, 학습하는 동안 해상도를 계속 바꿔 가며(다중 스케일 학습, 그리고 NAS 의 해상도 손잡이) 하나의 가중치가 여러 해상도에서 모두 잘 동작하게 만든다. 11장과 12장에서 다룬다.
학습된 위치 임베딩 들여다보기
위치 임베딩은 무작위 값에서 출발했고, 어느 자리가 어느 자리의 이웃인지 아무도 알려 주지 않았다. 학습이 끝난 뒤 자리끼리의 닮음을 재 본다. 한 자리의 위치 임베딩과 다른 143개 자리의 위치 임베딩 사이의 코사인 유사도(두 벡터가 같은 방향이면 1, 직각이면 0, 반대면 −1)를 12×12 격자에 그렸다.
- 그림: 그림 6-6 지도 학습한 MiniViT 의 위치 임베딩. 별표가 기준 자리이고, 색은 그 자리와 다른 자리의 위치 임베딩이 얼마나 닮았는지이다(밝을수록 닮음).
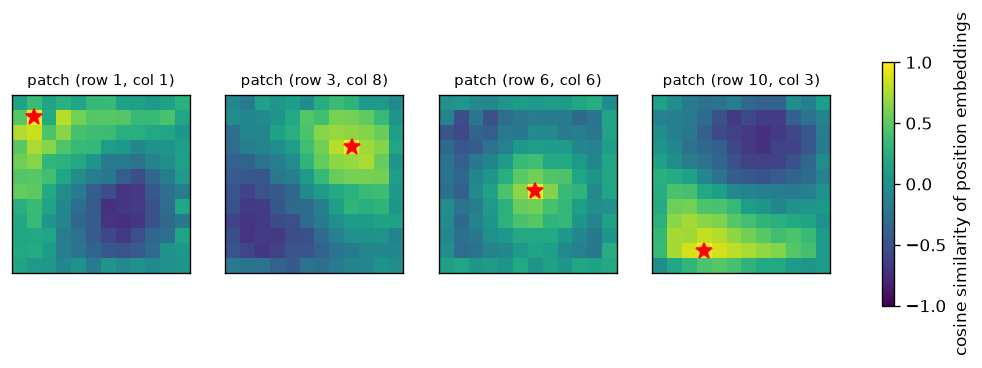
네 지도 모두 별표 둘레가 가장 밝고 멀어질수록 어두워진다. 왼쪽 위 자리는 왼쪽 위 자리들과, 가운데 자리는 가운데 자리들과 닮았다. 모델이 “가까운 자리는 비슷한 벡터” 라는 2차원 구조를 데이터에서 스스로 찾아낸 것이다. ViT 논문(그림 7)이 큰 모델에서 보고한 것과 같은 모습이다. 그리고 이것이 위치 임베딩 보간이 통하는 까닭이다. 격자 위에서 매끄럽게 변하는 것은 사이를 채워 넣어도 크게 어긋나지 않는다.
- 참고 · 위치를 묻지 않으면 위치를 배우지 않는다
- 이 장을 쓰면서 처음에는 “무엇이 있는가” 만으로 학습했다. 그때의 위치 임베딩은 그림 6-6 과 달리 아무 구조가 없는 잡음이었다. 과제가 위치를 요구하지 않으니 배울 까닭이 없었던 것이다. 중심 좌표를 함께 맞히게 하자 비로소 이 구조가 나타났다. 모델은 손실이 요구하는 만큼만 배운다.
미니 DINO
이제 라벨을 치우고 같은 MiniViT 를 DINO 로 학습한다. 앞 절의 부품을 그대로 옮기되 크기만 줄였다.
| 항목 | DINO 논문 | 이 장의 미니 DINO |
| 백본 | ViT-S/16 (2,100만) | MiniViT, 96×96 / 패치 8 (48만) |
| 출력 차원 \(K\) | 65,536 | 256 (\(\log K = 5.545\)) |
| 뷰 | 전역 224 2장 + 지역 96 여러 장 | 전역 96 2장 + 지역 48 2장 |
| 학생 온도 \(\tau_s\) | 0.1 | 0.1 |
| 교사 온도 \(\tau_t\) | 0.04 → 0.07 | 0.02 (아래 설명) |
| 교사 EMA 비율 \(m\) | 0.996 → 1 | 0.99 → 1 |
| 중심 EMA 비율 \(m_c\) | 0.9 (부록 D 의 표에서 가장 좋았던 값) | 0.9 |
| 학습량 | ImageNet(약 130만 장)을 수백 에폭 | 8,000장, 3,000스텝 × 배치 64 (24 에폭 분량) |
뷰를 만드는 증강은 무작위 자르기 · 좌우 뒤집기 · 색 바꾸기이다. 색은 채널 순서를 섞고 밝기를 바꾼다. 도형 세상에서 색은 도형의 종류와 무관하므로 “색이 달라도 같은 그림” 이라고 알려 주는 것이다. 지역 뷰는 48×48 이라 격자가 6×6 이고, 위치 임베딩 보간 을 거쳐 같은 ViT 에 들어간다. 앞에서 만든 것이 여기서 쓰인다.
def random_view(images: torch.Tensor, out_size: int, scale: tuple, generator: torch.Generator) -> torch.Tensor:
    """그림마다 무작위 "뷰" 하나를 만든다: 무작위 자르기 + 좌우 뒤집기 + 색 바꾸기 + 잡음.

    images: (B, 3, H, W) 0 – 1  →  (B, 3, out_size, out_size)
    - 자르기: 넓이가 원래의 scale[0] – scale[1] 배, 가로세로 비가 3/4 – 4/3 인 창을 무작위 위치에서 잘라
      out_size 로 크기를 바꾼다 (F.affine_grid + F.grid_sample 로 배치 전체를 한 번에).
    - 색: 채널 순서를 무작위로 섞고(빨강 도형이 파랑 도형이 된다) 밝기를 0.6 – 1.4 배로 바꾼다.
      도형 세상에서 색은 도형의 종류와 무관하므로, "색이 달라도 같은 그림" 이라고 알려 주는 셈이다.
    """
    B, device = len(images), images.device
    rand = lambda *shape: torch.rand(*shape, device=device, generator=generator)
    area = scale[0] + (scale[1] - scale[0]) * rand(B)
    log_ratio = math.log(4 / 3) * (2 * rand(B) - 1)
    width = (area * log_ratio.exp()).sqrt().clamp(max=1.0)  # 창의 너비 · 높이 (그림 한 변 = 1)
    height = (area / log_ratio.exp()).sqrt().clamp(max=1.0)
    center_x = (2 * rand(B) - 1) * (1 - width)  # affine_grid 의 좌표는 −1 – 1: 창이 그림 밖으로 나가지 않게
    center_y = (2 * rand(B) - 1) * (1 - height)
    flip = 1 - 2 * (rand(B) < 0.5).float()  # −1 이면 좌우 뒤집기
    theta = torch.zeros(B, 2, 3, device=device)
    theta[:, 0, 0], theta[:, 0, 2] = width * flip, center_x
    theta[:, 1, 1], theta[:, 1, 2] = height, center_y
    grid = F.affine_grid(theta, (B, 3, out_size, out_size), align_corners=False)
    views = F.grid_sample(images, grid, mode="bilinear", padding_mode="border", align_corners=False)
    permutation = torch.argsort(rand(B, 3), dim=1)  # 그림마다 채널 순서 섞기
    views = torch.gather(views, 1, permutation[:, :, None, None].expand(-1, -1, out_size, out_size))
    views = views * (0.6 + 0.8 * rand(B, 1, 1, 1))
    views = views + 0.02 * torch.randn(views.shape, device=device, generator=generator)
    return views.clamp(0, 1)
class DINOHead(nn.Module):
    """투영 머리: 백본의 CLS 특징 (B, D) → K 차원 점수 (B, K).

    MLP → 병목 차원으로 줄임 → 길이 1 로 정규화 → 가중치 행의 길이도 1 인 선형 층.
    마지막 두 단계 때문에 점수 하나하나는 "두 단위 벡터의 내적" 이라 −1 – 1 사이에 있다.
    그래서 온도 0.1 로 나누면 −10 – 10, 0.02 로 나누면 −50 – 50 의 로짓이 된다.
    이 머리는 사전 학습 때만 쓰고, 학습이 끝나면 버린다 (쓸모 있는 것은 백본이다).
    """

    def __init__(self, dim: int, out_dim: int = 256, hidden: int = 256, bottleneck: int = 64):
        super().__init__()
        self.mlp = nn.Sequential(nn.Linear(dim, hidden), nn.GELU(), nn.Linear(hidden, hidden), nn.GELU(),
                                 nn.Linear(hidden, bottleneck))
        self.last = nn.Linear(bottleneck, out_dim, bias=False)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = F.normalize(self.mlp(x), dim=-1)
        return F.linear(x, F.normalize(self.last.weight, dim=-1))
손실 함수는 앞의 식 그대로이다. 교사 쪽은 (t - center) / tau_t 로 centering 과 sharpening 을 걸고 .detach() 로 기울기를 끊는다. 학생 쪽은 log_softmax 를 써서 \(\log P_s\) 를 수치적으로 안전하게 구한다. 교차 엔트로피에서 교사의 엔트로피를 빼면 KL 이므로(앞의 분해), 둘을 함께 기록해 붕괴를 감시한다.
def dino_loss(student_out, teacher_out, center, tau_s: float, tau_t: float):
    """DINO 손실: 교사 분포와 학생 분포의 교차 엔트로피를 "서로 다른 뷰" 끼리 계산해 평균한다.

    student_out: 뷰마다의 학생 점수 목록, 각각 (B, K).  teacher_out: 교사 점수 목록(전역 뷰 2개), 각각 (B, K).
    center: (K,) — 교사 점수의 이동 평균. 돌려주는 값: (손실, 교사 분포의 엔트로피 평균, 교사 분포 목록)
    """
    # 교사: 중심을 빼고(centering) 낮은 온도로 나눠(sharpening) 소프트맥스. 기울기는 흘리지 않는다.
    teacher_probs = [((t - center) / tau_t).softmax(dim=-1).detach() for t in teacher_out]
    student_logp = [(s / tau_s).log_softmax(dim=-1) for s in student_out]
    loss, pairs = 0.0, 0
    for i, p_t in enumerate(teacher_probs):
        for j, logp_s in enumerate(student_logp):
            if i == j:  # 같은 뷰끼리는 비교하지 않는다 (그건 그냥 교사를 베끼는 문제가 된다)
                continue
            loss = loss + (-(p_t * logp_s).sum(dim=-1)).mean()  # H(P_t, P_s) = −Σ_k P_t(k) log P_s(k)
            pairs += 1
    entropy = torch.stack([-(p * (p + 1e-12).log()).sum(dim=-1).mean() for p in teacher_probs]).mean()
    return loss / pairs, entropy, teacher_probs
def train_dino(train_images, steps, batch_size=64, dim=96, depth=4, heads=4, out_dim=256, lr=5e-4, weight_decay=0.04,
               tau_s=0.1, tau_t=0.04, momentum=0.99, center_momentum=0.9, use_centering=True, local_views=2,
               seed=0, log=print, name="DINO"):
    """미니 DINO. 라벨은 전혀 쓰지 않는다 (train_images 만 받는다).

    돌려주는 값: (교사 백본, 기록) — 기록은 스텝마다 (손실, 교사 엔트로피, KL, 배치 평균 분포의 엔트로피).
    """
    device = train_images.device
    torch.manual_seed(seed)
    generator = torch.Generator(device=device).manual_seed(seed)
    student = nn.ModuleDict({"backbone": MiniViT(96, 8, dim, depth, heads), "head": DINOHead(dim, out_dim)}).to(device)
    teacher = nn.ModuleDict({"backbone": MiniViT(96, 8, dim, depth, heads), "head": DINOHead(dim, out_dim)}).to(device)
    teacher.load_state_dict(student.state_dict())  # 교사는 학생과 같은 값에서 출발한다
    for p in teacher.parameters():
        p.requires_grad_(False)  # 교사는 기울기로 배우지 않는다. EMA 로만 바뀐다.
    optimizer = torch.optim.AdamW(student.parameters(), lr=lr, weight_decay=weight_decay)
    warmup = max(1, steps // 10)
    center = torch.zeros(out_dim, device=device)
    history = []
    for step in range(steps):
        for group in optimizer.param_groups:  # 학습률: 워밍업 뒤 코사인
            group["lr"] = lr * min((step + 1) / warmup, 0.5 * (1 + math.cos(math.pi * step / steps)))
        index = torch.randint(len(train_images), (batch_size,), device=device, generator=generator)
        images = to_float(train_images[index])
        # 같은 그림에서 뷰를 여러 개: 크게 자른 전역 뷰 2개(96×96) + 작게 자른 지역 뷰 local_views 개(48×48)
        global_views = [random_view(images, 96, (0.5, 1.0), generator) for _ in range(2)]
        local_view_list = [random_view(images, 48, (0.15, 0.5), generator) for _ in range(local_views)]
        with torch.no_grad():  # 교사는 전역 뷰만 본다
            teacher_out = [teacher["head"](teacher["backbone"](v)) for v in global_views]
        # 학생은 모든 뷰를 본다. 48×48 뷰는 격자가 6×6 이라 위치 임베딩이 보간되어 들어간다.
        student_out = [student["head"](student["backbone"](v)) for v in global_views + local_view_list]
        loss, entropy, teacher_probs = dino_loss(student_out, teacher_out, center if use_centering else 0.0, tau_s, tau_t)
        optimizer.zero_grad()
        loss.backward()
        torch.nn.utils.clip_grad_norm_(student.parameters(), 3.0)
        optimizer.step()
        with torch.no_grad():
            # 교사 = 학생의 지수 이동 평균. m 은 코사인을 따라 momentum → 1 로 올라간다.
            m = 1 - (1 - momentum) * 0.5 * (1 + math.cos(math.pi * step / steps))
            for p_t, p_s in zip(teacher.parameters(), student.parameters()):
                p_t.mul_(m).add_(p_s.detach(), alpha=1 - m)
            # 중심 = 교사 점수의 배치 평균을 이동 평균한 것
            center = center_momentum * center + (1 - center_momentum) * torch.cat(teacher_out).mean(dim=0)
            mean_probs = torch.cat(teacher_probs).mean(dim=0)  # 배치 전체가 K 개 차원을 얼마나 고르게 쓰는가
            marginal_entropy = -(mean_probs * (mean_probs + 1e-12).log()).sum().item()
        history.append((loss.item(), entropy.item(), loss.item() - entropy.item(), marginal_entropy))
        if (step + 1) % max(1, steps // 5) == 0 or step == 0:
            log(f"  [{name}] 스텝 {step + 1:5d} | 손실 {loss.item():.3f} | 교사 엔트로피 {entropy.item():.3f}"
                f" | KL {loss.item() - entropy.item():.3f} | 배치 평균 분포의 엔트로피 {marginal_entropy:.3f}")
    return teacher["backbone"].eval(), np.array(history)
학습 고리에서 볼 곳은 세 군데이다.
- 교사는
torch.no_grad()안에서 전역 뷰만 보고, 학생은 모든 뷰를 본다. -
optimizer.step()은 학생만 바꾼다. 그 뒤 교사의 모든 매개변수를p_t.mul_(m).add_(p_s, alpha=1 - m), 곧 \(\theta_t \leftarrow m\theta_t + (1 - m)\theta_s\) 로 갱신한다. - 중심
center도 같은 꼴의 이동 평균으로 갱신한다. 손실로 학습되는 값이 아니다.
라벨 없는 그림은 두 종류를 따로 써서 두 번 사전 학습한다. (가) 장면: 도형이 1 – 4개 있는 보통의 도형 세상 그림 8,000장. (나) 도형 하나: 도형이 하나만 있는 그림 8,000장. 어느 쪽도 라벨은 쓰지 않는다. 왜 둘로 나눴는지는 결과에서 드러난다.
- 참고 · 교사 온도를 0.02 로 낮춘 까닭
- DINO 논문의 0.04 로 먼저 돌렸다. 붕괴하지는 않았지만 교사의 분포가 날카로워지는 속도가 느려, 3,000스텝이 끝난 뒤에도 (나)로 학습한 백본은 도형의 종류를 묻는 선형 분류기에서 무작위 초기화와 구별되지 않았다(객체 수를 묻는 쪽만 조금 올랐다). 0.02 로 낮추자 같은 스텝 수 안에 학습이 진행되었다. 논문의 부록 D 도 0.02 가 동작하는 값임을 보인다(0.06 보다 높게 시작하면 붕괴). 이 장의 수치는 몇 가지 설정을 돌려 본 뒤 고른 하나의 설정에서 나온 것임을 밝혀 둔다.
--tau-t 0.04로 직접 확인할 수 있다.
붕괴를 직접 보기
정상적인 미니 DINO 둘과 함께, 부품을 하나씩 뺀 실험 둘을 짧게(300스텝) 돌린다. centering 끔 은 중심 \(c\) 를 늘 0 으로 두고, sharpening 끔 은 교사 온도를 1.0 으로 올린다. 스텝마다 세 값을 기록한다. 교사 분포의 엔트로피 \(\mathrm{Ent}(P_t)\)(그림 하나의 분포가 얼마나 퍼졌나), KL(교사와 학생이 얼마나 다른가), 그리고 배치 전체에서 평균 낸 분포의 엔트로피(배치가 \(K\) 개 칸을 얼마나 고르게 쓰나)이다.
미니 DINO (라벨 없이): 스텝 3000, 배치 64, 교사 온도 0.02
  [DINO · 장면] 스텝     1 | 손실 3.186 | 교사 엔트로피 1.339 | KL 1.847 | 배치 평균 분포의 엔트로피 1.389
  [DINO · 장면] 스텝   600 | 손실 2.464 | 교사 엔트로피 1.773 | KL 0.691 | 배치 평균 분포의 엔트로피 2.974
  [DINO · 장면] 스텝  1200 | 손실 1.790 | 교사 엔트로피 0.939 | KL 0.851 | 배치 평균 분포의 엔트로피 2.401
  [DINO · 장면] 스텝  1800 | 손실 1.439 | 교사 엔트로피 0.299 | KL 1.140 | 배치 평균 분포의 엔트로피 2.444
  [DINO · 장면] 스텝  2400 | 손실 1.237 | 교사 엔트로피 0.145 | KL 1.092 | 배치 평균 분포의 엔트로피 2.265
  [DINO · 장면] 스텝  3000 | 손실 1.117 | 교사 엔트로피 0.235 | KL 0.883 | 배치 평균 분포의 엔트로피 2.348
  [DINO · 도형 하나] 스텝     1 | 손실 3.105 | 교사 엔트로피 1.273 | KL 1.832 | 배치 평균 분포의 엔트로피 1.291
  [DINO · 도형 하나] 스텝   600 | 손실 3.511 | 교사 엔트로피 2.790 | KL 0.721 | 배치 평균 분포의 엔트로피 3.879
  [DINO · 도형 하나] 스텝  1200 | 손실 2.288 | 교사 엔트로피 1.284 | KL 1.004 | 배치 평균 분포의 엔트로피 3.112
  [DINO · 도형 하나] 스텝  1800 | 손실 1.153 | 교사 엔트로피 0.245 | KL 0.908 | 배치 평균 분포의 엔트로피 2.617
  [DINO · 도형 하나] 스텝  2400 | 손실 1.095 | 교사 엔트로피 0.258 | KL 0.837 | 배치 평균 분포의 엔트로피 2.709
  [DINO · 도형 하나] 스텝  3000 | 손실 1.012 | 교사 엔트로피 0.235 | KL 0.777 | 배치 평균 분포의 엔트로피 2.579
미니 DINO 학습 둘 430.7초
  [centering 끔] 스텝     1 | 손실 3.105 | 교사 엔트로피 1.273 | KL 1.832 | 배치 평균 분포의 엔트로피 1.291
  [centering 끔] 스텝    60 | 손실 0.026 | 교사 엔트로피 0.017 | KL 0.009 | 배치 평균 분포의 엔트로피 0.017
  [centering 끔] 스텝   120 | 손실 0.005 | 교사 엔트로피 0.000 | KL 0.005 | 배치 평균 분포의 엔트로피 0.000
  [centering 끔] 스텝   180 | 손실 0.004 | 교사 엔트로피 0.000 | KL 0.004 | 배치 평균 분포의 엔트로피 0.000
  [centering 끔] 스텝   240 | 손실 0.003 | 교사 엔트로피 0.000 | KL 0.003 | 배치 평균 분포의 엔트로피 0.000
  [centering 끔] 스텝   300 | 손실 0.003 | 교사 엔트로피 0.000 | KL 0.003 | 배치 평균 분포의 엔트로피 0.000
  [sharpening 끔] 스텝     1 | 손실 6.163 | 교사 엔트로피 5.537 | KL 0.627 | 배치 평균 분포의 엔트로피 5.537
  [sharpening 끔] 스텝    60 | 손실 5.547 | 교사 엔트로피 5.545 | KL 0.002 | 배치 평균 분포의 엔트로피 5.545
  [sharpening 끔] 스텝   120 | 손실 5.545 | 교사 엔트로피 5.545 | KL 0.000 | 배치 평균 분포의 엔트로피 5.545
  [sharpening 끔] 스텝   180 | 손실 5.545 | 교사 엔트로피 5.545 | KL 0.000 | 배치 평균 분포의 엔트로피 5.545
  [sharpening 끔] 스텝   240 | 손실 5.545 | 교사 엔트로피 5.545 | KL 0.000 | 배치 평균 분포의 엔트로피 5.545
  [sharpening 끔] 스텝   300 | 손실 5.545 | 교사 엔트로피 5.545 | KL 0.000 | 배치 평균 분포의 엔트로피 5.545
끈 실험 둘 41.3초, log K = log 256 = 5.545
- 그림: 그림 6-7 왼쪽: 교사 엔트로피. 가운데: KL(= 손실 − 엔트로피). 오른쪽: 배치 평균 분포의 엔트로피. 회색 쇄선은 \(\log K = 5.545\). 곡선은 25스텝 이동 평균이다.
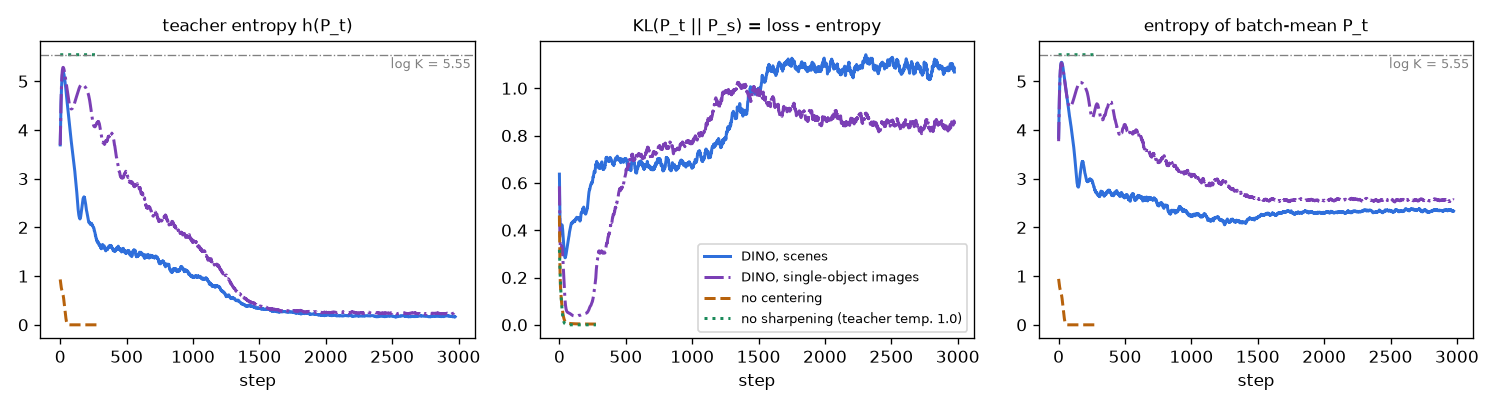
앞에서 표로 정리한 두 붕괴가 그대로 나타난다.
- centering 을 끄면 한 칸으로 쏠린다. 60스텝 만에 교사 엔트로피가 0.017, 120스텝에는 0.000 이 되고 KL 도 0.005 까지 내려간다. 배치 평균 분포의 엔트로피까지 0 이라는 것은 배치의 모든 그림이 같은 한 칸을 골랐다는 뜻이다. 손실이 0 에 가까워 “학습이 잘 된다” 고 착각하기 쉽지만, 모든 그림에 같은 칸을 답하고 있을 뿐이다.
- sharpening 을 끄면 균등해진다. 교사 엔트로피가 처음부터 5.537 이고 60스텝에 \(\log K = 5.545\) 에 닿으며, KL 은 0.002, 이어서 0.000 이 된다. 교사가 모든 그림에 “모르겠다” 고 답하고 학생이 그것을 그대로 따라 한다. 손실은 \(\log K\) 에서 꿈쩍하지 않는다.
- 둘 다 켜면 그 사이에 머문다. 두 실행 모두 3,000스텝 뒤 교사 엔트로피가 0.235, KL 이 0.883(장면) · 0.777(도형 하나)이다. 그림 하나하나는 거의 한 칸을 분명하게 고르지만(교사 엔트로피가 낮음), 배치 전체로는 여러 칸을 나눠 쓴다(배치 평균 분포의 엔트로피가 2.348 · 2.579 로, \(e^{2.35} \approx 10\) – \(e^{2.58} \approx 13\) 개쯤의 칸을 고르게 쓰는 셈). 그리고 KL 이 0 으로 가지 않는다. 교사의 답이 그림마다 달라 학생이 미리 알 수 없기 때문이다.
손실 값만 보아서는 건강한 학습과 붕괴를 가릴 수 없다는 것이 이 실험의 교훈이다. 자기 지도 학습에서는 손실이 내려가는지가 아니라 엔트로피와 KL 이 어디에 머무는지 를 본다.
선형 분류기로 특징 재기
붕괴하지 않았다고 해서 쓸모 있는 것을 배웠다는 보장은 없다. 자기 지도 학습으로 얻은 백본은 선형 분류기 평가(linear probe) 로 잰다. 백본을 얼리고(가중치를 바꾸지 않고), 그 특징 위에 선형 층 하나만 라벨로 학습한다. 선형 층 하나로 풀리는 만큼만 점수가 나오므로, 특징 안에 답이 얼마나 꺼내기 쉬운 꼴로 들어 있는지를 재는 시험이다. 특징은 CLS 출력과 패치 출력의 평균을 이어 붙인 192차원이다. 세 가지를 묻는다.
- ① 장면에 어떤 도형이 있는가(지도 학습 때와 같은 다중 라벨 과제)
- ② 장면에 객체가 몇 개인가(1 – 4개 가운데 하나)
- ③ 도형 하나짜리 그림의 도형은 무엇인가(원 · 사각형 · 삼각형 가운데 하나)
@torch.no_grad()
def extract_features(backbone, images_uint8, batch_size=250) -> torch.Tensor:
    """얼린 백본의 특징: CLS 토큰과 패치 토큰 평균을 이어 붙인다. (그림 수, 2D)"""
    backbone.eval()
    features = []
    for i in range(0, len(images_uint8), batch_size):
        tokens = backbone.forward_tokens(to_float(images_uint8[i : i + batch_size]))  # (B, 1 + N, D)
        features.append(torch.cat([tokens[:, 0], tokens[:, 1:].mean(dim=1)], dim=1))
    return torch.cat(features)

def linear_probe(train_features, train_targets, test_features, epochs=300, lr=1e-2, seed=0) -> torch.Tensor:
    """얼린 특징 위에 선형 층 하나만 학습하고 (라벨은 여기서만 쓴다), 시험 특징에 대한 로짓을 돌려준다.

    train_targets 가 실수 (n, 3) 이면 다중 라벨 문제로 보고 BCE 를,
    정수 (n,) 이면 여러 클래스 중 하나를 고르는 문제로 보고 소프트맥스 교차 엔트로피를 쓴다.
    특징은 학습 세트의 평균 · 표준편차로 정규화한다. 선형 층 하나로 풀리는 만큼만 점수가 나오므로,
    "특징 안에 답이 얼마나 꺼내기 쉬운 꼴로 들어 있는가" 를 재는 시험이 된다.
    """
    torch.manual_seed(seed)
    mean, std = train_features.mean(0, keepdim=True), train_features.std(0, keepdim=True) + 1e-6
    x_train, x_test = (train_features - mean) / std, (test_features - mean) / std
    multi_label = train_targets.is_floating_point()
    n_outputs = train_targets.shape[1] if multi_label else int(train_targets.max()) + 1
    probe = nn.Linear(x_train.shape[1], n_outputs).to(x_train.device)
    optimizer = torch.optim.AdamW(probe.parameters(), lr=lr, weight_decay=1e-2)
    for _ in range(epochs):  # 특징이 작아서 전체를 한 배치로 쓴다
        logits = probe(x_train)
        loss = F.binary_cross_entropy_with_logits(logits, train_targets) if multi_label else F.cross_entropy(logits, train_targets)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    with torch.no_grad():
        return probe(x_test)
선형 분류기 (얼린 특징 192차원, 라벨 달린 학습 그림 4000장, 시험 1000장)
  백본                         | ① 장면의 도형 종류: 라벨 정확도 · 세 라벨 모두 | ② 장면의 객체 수 | ③ 도형 하나의 종류
  무작위 초기화 (시드 1)             | 0.712 · 0.312 | 0.671 | 0.593
  무작위 초기화 (시드 2)             | 0.721 · 0.331 | 0.663 | 0.592
  미니 DINO · 장면               | 0.737 · 0.361 | 0.754 | 0.729
  미니 DINO · 도형 하나            | 0.810 · 0.521 | 0.713 | 0.934
  centering 끈 DINO           | 0.729 · 0.345 | 0.688 | 0.622
  sharpening 끈 DINO          | 0.721 · 0.327 | 0.696 | 0.646
  지도 학습 백본 (참고)              | 0.971 · 0.914 | 0.729 | 0.999
  픽셀 (8×8 평균, 432차원)         | 0.627 · 0.243 | 0.511 | 0.450
  늘 많은 쪽으로 찍기                | 0.599 ·   —   | 0.269 | 0.351
GPU 메모리 최대 사용량 1533 MiB
- 그림: 그림 6-8 얼린 특징 위의 선형 분류기 정확도(시험 세트). 왼쪽부터 과제 ① · ② · ③. 검은 쇄선은 늘 많은 쪽으로 찍을 때의 정확도이다.
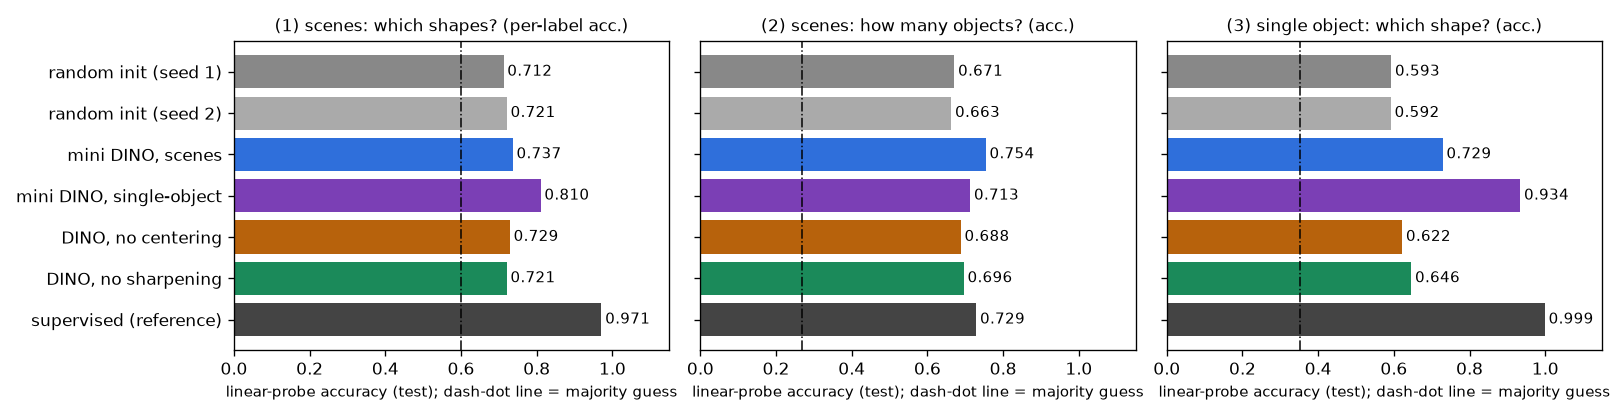
표를 한 줄씩 읽어 보자.
- 무작위 초기화 백본도 0 은 아니다. 세 과제에서 0.71 – 0.72, 0.66 – 0.67, 0.59 로, 늘 많은 쪽으로 찍기(0.599, 0.269, 0.351)는 물론 픽셀을 그대로 넣은 선형 분류기(0.627, 0.511, 0.450)보다도 높다. 학습하지 않은 망도 그림을 이리저리 섞은 특징을 내고, 그 가운데 일부는 우연히 쓸모가 있다. 그래서 비교의 기준은 “찍기” 가 아니라 이 줄이어야 한다. 시드를 바꾼 두 줄의 차이(0.001 – 0.009)가 이 실험에서 우연으로 생기는 흔들림의 크기를 가늠하게 해 준다.
- 붕괴한 DINO 는 무작위 초기화와 다르지 않다. 과제 ① 은 0.729 · 0.721 로 무작위 초기화(0.712 · 0.721)와 같고, ② · ③ 은 0.02 – 0.05 높을 뿐이다(붕괴하기 전 몇십 스텝 동안 가중치가 조금 움직인 흔적으로 보인다). 손실은 가장 낮았지만 배운 것이 없다.
- 장면으로 학습한 미니 DINO 는 “몇 개인가” 를 배웠다. 객체 수(②)가 0.67 에서 0.754 로 올라, 라벨로 학습한 백본(0.729)보다도 높다. 도형 하나의 종류(③)도 0.59 에서 0.729 로 올랐다. 하지만 정작 장면의 도형 종류(①)는 0.737 로, 무작위 초기화(0.712 · 0.721)보다 0.02 높을 뿐이다. 시드에 따른 흔들림을 겨우 넘는 차이이다.
- 도형 하나짜리 그림으로 학습한 미니 DINO 는 “무슨 도형인가” 를 배웠다. 도형 하나의 종류(③)를 0.934 맞힌다. 무작위 초기화는 0.59, 라벨로 학습한 백본은 0.999 이다. 라벨을 한 장도 쓰지 않고 얻은 특징이, 선형 층 하나만 얹으면 도형 셋을 거의 가른다. 이 특징은 한 번도 본 적 없는 장면에도 옮겨 가서 ① 이 0.72 에서 0.810(세 라벨 모두는 0.31 – 0.33 에서 0.521)으로 오른다. 객체 수(②)는 0.713 으로 장면으로 학습한 쪽(0.754)보다 낮다.
- 라벨로 학습한 백본은 자기 과제에서 훨씬 낫다. ① 0.971, ③ 0.999 이다. 라벨이 묻는 바로 그것을 배웠으니 당연하다. 대신 묻지 않은 객체 수(②)는 0.729 로, 라벨 없이 장면으로 배운 미니 DINO(0.754)보다 조금 낮다. 라벨은 그 라벨이 묻는 것에 특화된 특징을 만들고, 자기 지도 학습은 특정 과제에 묶이지 않은 특징을 만든다. 다만 이 작은 실험에서 그 범용성의 폭은 좁다.
같은 방법, 같은 모델, 같은 증강인데 라벨 없는 그림의 종류만으로 배운 것이 달라졌다. 까닭은 DINO 의 목표에 있다. DINO 는 두 뷰 사이에 변하지 않는 것 을 특징에 담는다. 도형이 여럿인 장면을 자르고 색을 바꾸면, 두 뷰에 공통으로 남는 가장 뚜렷한 것은 도형이 몇 개쯤이고 얼마나 큰가이다. 도형의 종류는 그보다 미세한 단서이다. 도형이 하나뿐인 그림에서는 자르고 색을 바꾼 뒤에 남는 것이 사실상 도형의 모양뿐이므로, 그림들을 구별하려면 모양을 봐야 한다. (이것은 이 실험의 결과에 대한 해석이고, 따로 검증한 것은 아니다.)
- 핵심 · 자기 지도 학습이 무엇을 배우는지는 데이터와 증강이 정한다
- DINO 논문은 ImageNet 으로 학습했다. 사진 한 장에 라벨 하나가 붙은 분류용 데이터라, 주된 객체가 하나인 사진이 많다. DINOv2 논문도 데이터를 중요하게 다룬다. 인터넷 그림을 그대로 쓰지 않고 정제한 LVD-142M 을 만들었고, 정제하지 않은 그림으로 학습하면 대부분의 벤치마크에서 결과가 나빠진다고 보고한다(표 2). 그리고 규모가 다르다. 이 장의 미니 DINO 는 그림 8,000장을 24번 본 것이고, DINOv2 는 1억 4,200만 장으로 10억 매개변수 모델을 학습해 증류했다. 작은 실험의 결과를 진짜 DINOv2 의 품질로 착각하면 안 된다. 그 차이는 이 장의 끝에서 직접 본다.
CLS 토큰은 어디를 보는가
마지막 블록의 자기 어텐션에서 CLS 토큰이 각 패치에 준 가중치(머리 4개의 평균)를 12×12 지도로 그렸다. CLS 가 그림 전체를 요약하려고 어느 패치의 정보를 가져오는지를 보여 준다.
- 그림: 그림 6-9 첫 줄: 시험 그림. 둘째 줄: 지도 학습한 MiniViT. 셋째 줄: 장면으로 학습한 미니 DINO(교사). 넷째 줄: 도형 하나짜리 그림으로 학습한 미니 DINO(교사). 밝을수록 CLS 가 그 패치를 많이 본다.
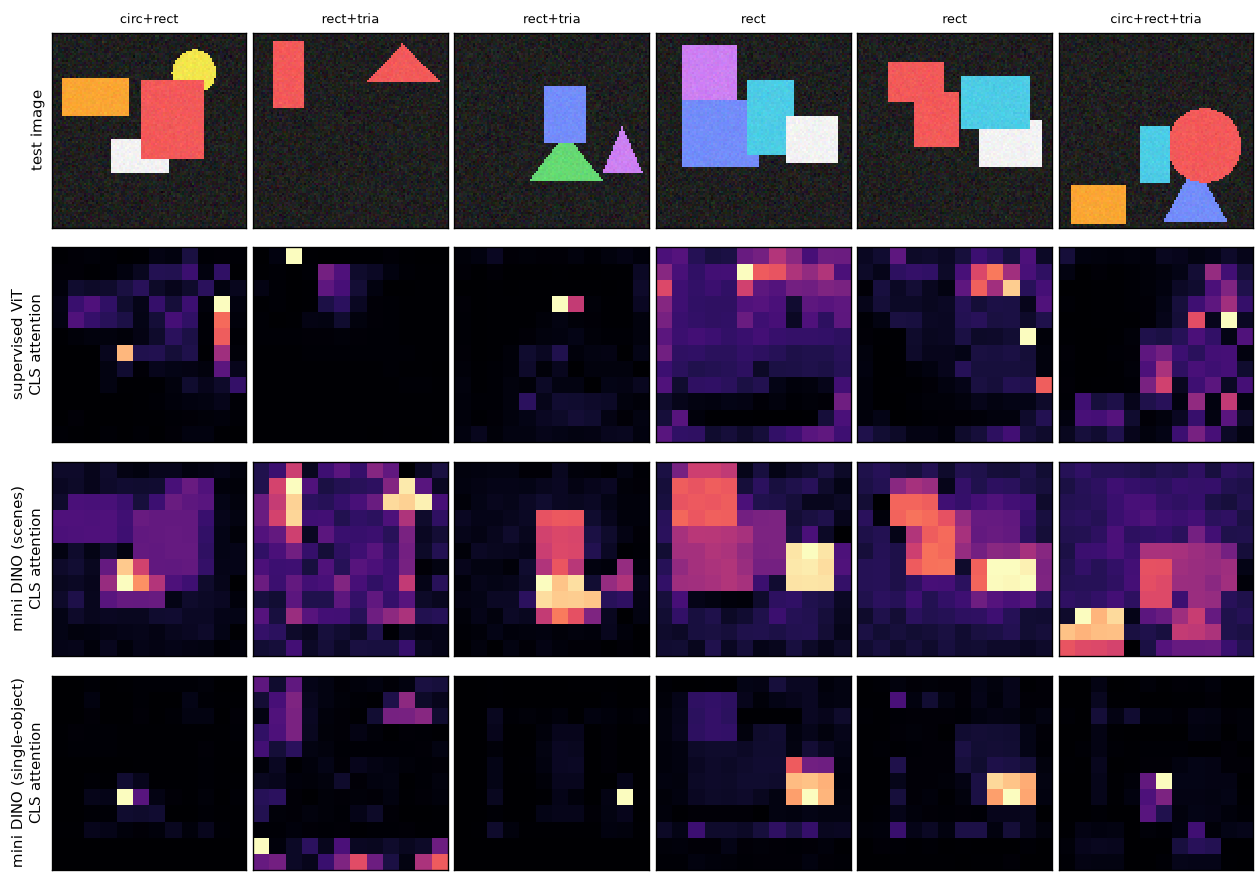
지도 학습한 모델(둘째 줄)의 CLS 는 도형 위를 고르게 보지 않는다. 몇 개의 흩어진 패치에 가중치가 몰려 있고, 그 가운데에는 도형의 가장자리도 있고 배경도 있다. 마지막 블록에 이르면 필요한 정보가 앞의 블록들을 거치며 이미 여러 토큰에 옮겨져 있을 수 있으므로, 마지막 층의 어텐션 지도 한 장으로 “모델이 여기를 보고 판단했다” 고 말하기는 어렵다. 미니 DINO(셋째 · 넷째 줄)는 다르다. 밝은 곳이 대체로 도형 위에 있다. 장면으로 학습한 쪽은 도형 한두 개와 그 둘레를 넓게 보고, 도형 하나짜리 그림으로 학습한 쪽은 한 도형의 좁은 부분에 모인다(둘째 그림처럼 배경 구석으로 빠지는 경우도 있다). 라벨도, “도형을 보라” 는 지시도 없었는데 CLS 가 객체 쪽을 본다. DINO 논문은 자기 지도 학습한 ViT 의 자기 어텐션 지도에 장면의 배치와 객체의 경계가 드러난다고 보고했는데, 그 성질의 작은 판을 본 셈이다. 다만 그림 여섯 장에서 눈으로 본 것이고 수치로 잰 것은 아니다.
진짜 DINOv2 의 패치 특징
마지막으로, 공개된 DINOv2 ViT-S/14 가중치를 내려받아 도형 세상 그림을 넣어 본다. DINOv2 는 사진으로 학습했고 도형 세상 같은 그림은 본 적이 없다. 그런데도 패치 특징이 도형을 구별할까? 이 부분은 본문 실습과 분리된 선택 스크립트 code/ch06_dinov2_features.py 이다. requirements.txt 에 없는 transformers 패키지와 인터넷 연결(가중치 약 88MB 내려받기)이 필요하다.
같은 장면을 224×224 로 그려 넣으면 \(224 / 14 = 16\), 패치 특징이 그림마다 \(16 \times 16 = 256\) 개 나온다(각각 384차원). 이 특징으로 두 가지를 한다.
- 패치 분류. 백본을 얼리고 패치 특징 위에 선형 층 하나만 학습해, 패치마다 “배경 · 원 · 사각형 · 삼각형” 을 맞힌다. 패치의 정답은 그 패치 안에서 가장 넓은 것으로 정한다. 탐지기가 백본에 바라는 능력을 가장 직접 재는 시험이다. 같은 구조를 무작위로 초기화한 것 과 비교한다.
- 주성분 분석(PCA). 패치 특징 384차원에서 가장 크게 퍼진 세 방향을 찾아 빨강 · 초록 · 파랑으로 칠한다. 비슷한 특징을 가진 패치는 비슷한 색이 된다. DINOv2 논문의 그림 1 이 쓴 절차대로, 첫 주성분의 부호로 배경을 가른 뒤 남은 패치만으로 다시 주성분을 구한 것도 그린다.
@torch.no_grad()
def patch_features(model, images_uint8: torch.Tensor, device: str, batch_size: int = 100):
    """DINOv2 의 마지막 층 출력을 꺼낸다.

    images_uint8: (n, 3, 224, 224) → CLS (n, 384), 패치 특징 (n, 256, 384).
    출력 토큰 열은 [CLS, 패치 256개] 순서다 (이 가중치는 레지스터 토큰이 없는 판이다).
    """
    cls_list, patch_list = [], []
    for i in range(0, len(images_uint8), batch_size):
        x = images_uint8[i : i + batch_size].to(device).float() / 255.0
        x = (x - IMAGENET_MEAN.to(device)) / IMAGENET_STD.to(device)
        tokens = model(pixel_values=x).last_hidden_state  # (B, 1 + 256, 384)
        cls_list.append(tokens[:, 0].cpu())
        patch_list.append(tokens[:, 1:].cpu())
    return torch.cat(cls_list), torch.cat(patch_list)
def patch_labels(dataset: ShapesDataset, patch_size: int = 14) -> torch.Tensor:
    """패치마다의 정답: 0 배경, 1 원, 2 사각형, 3 삼각형. (n, 격자²)

    패치 안의 픽셀을 "배경 · 원 · 사각형 · 삼각형" 넷으로 나눠 세어, 가장 많은 것을 그 패치의 라벨로 한다.
    """
    grid = dataset.size // patch_size
    labels = torch.zeros(len(dataset), grid * grid, dtype=torch.int64)
    for i, target in enumerate(dataset.targets):
        pixel_class = torch.zeros(dataset.size, dataset.size, dtype=torch.int64)
        for mask, cls in zip(target["masks"], target["labels"]):
            pixel_class[mask] = int(cls) + 1  # 보이는 부분만 True 인 마스크라 겹쳐도 덮어쓰지 않는다
        one_hot = F.one_hot(pixel_class, NUM_CLASSES + 1).permute(2, 0, 1).float()[None]  # (1, 4, S, S)
        counts = F.avg_pool2d(one_hot, patch_size)[0]  # (4, 격자, 격자): 패치 안에서 각 종류가 차지하는 비율
        labels[i] = counts.argmax(dim=0).flatten()
    return labels
def pca_colors(features: torch.Tensor) -> np.ndarray:
    """(패치 수, D) 특징 → (패치 수, 3) 색. 앞의 세 주성분을 성분별로 0 – 1 로 늘려 RGB 로 쓴다.

    주성분 분석은 특징이 가장 크게 퍼진 방향부터 차례로 찾는다. 비슷한 특징을 가진 패치는 비슷한 색이 된다.
    """
    centered = features - features.mean(dim=0, keepdim=True)
    _, _, vh = torch.linalg.svd(centered, full_matrices=False)  # vh 의 줄이 주성분 방향
    projected = centered @ vh[:3].T  # (패치 수, 3)
    low, high = projected.min(dim=0).values, projected.max(dim=0).values
    return ((projected - low) / (high - low)).numpy()

def first_component_foreground(features: torch.Tensor):
    """첫 주성분 값과, 그 부호로 가른 "도형 패치" 표시. 수가 적은 쪽을 도형으로 본다 (그림의 대부분은 배경이다)."""
    centered = features - features.mean(dim=0, keepdim=True)
    _, _, vh = torch.linalg.svd(centered, full_matrices=False)
    first = centered @ vh[0]
    positive = first > 0
    if positive.float().mean() > 0.5:  # 주성분의 부호는 임의다: 적은 쪽이 True 가 되게 뒤집는다
        positive = ~positive
    return first, positive
장치: cuda

facebook/dinov2-small: 매개변수 22,056,576개, 층 12, 차원 384, 머리 6, 패치 14, 위치 임베딩 (1, 1370, 384)
패치 라벨: 학습 153,600개, 시험 76,800개, 시험 패치 중 배경 0.863
  사전 학습된 DINOv2        패치 분류 정확도 0.968 | 배경이 아닌 패치만 0.907
  무작위 초기화 (같은 구조)      패치 분류 정확도 0.922 | 배경이 아닌 패치만 0.452
  늘 배경이라고 찍기           패치 분류 정확도 0.863 | 배경이 아닌 패치만 0.000
  사전 학습된 DINOv2        첫 주성분의 부호만으로 배경/도형 가르기: 정답과 일치 0.726
  무작위 초기화 (같은 구조)      첫 주성분의 부호만으로 배경/도형 가르기: 정답과 일치 0.952
- 그림: 그림 6-10 첫 줄: 입력(224×224). 둘째 줄: DINOv2 패치 특징의 PCA(모든 패치). 셋째 줄: DINOv2, 첫 주성분으로 가른 뒤 남은 패치만의 PCA(나머지는 검정). 넷째 · 다섯째 줄: 같은 구조를 무작위로 초기화한 ViT 에 같은 절차를 적용한 것. 색 자체에는 뜻이 없고, 같은 색 = 비슷한 특징 이다.
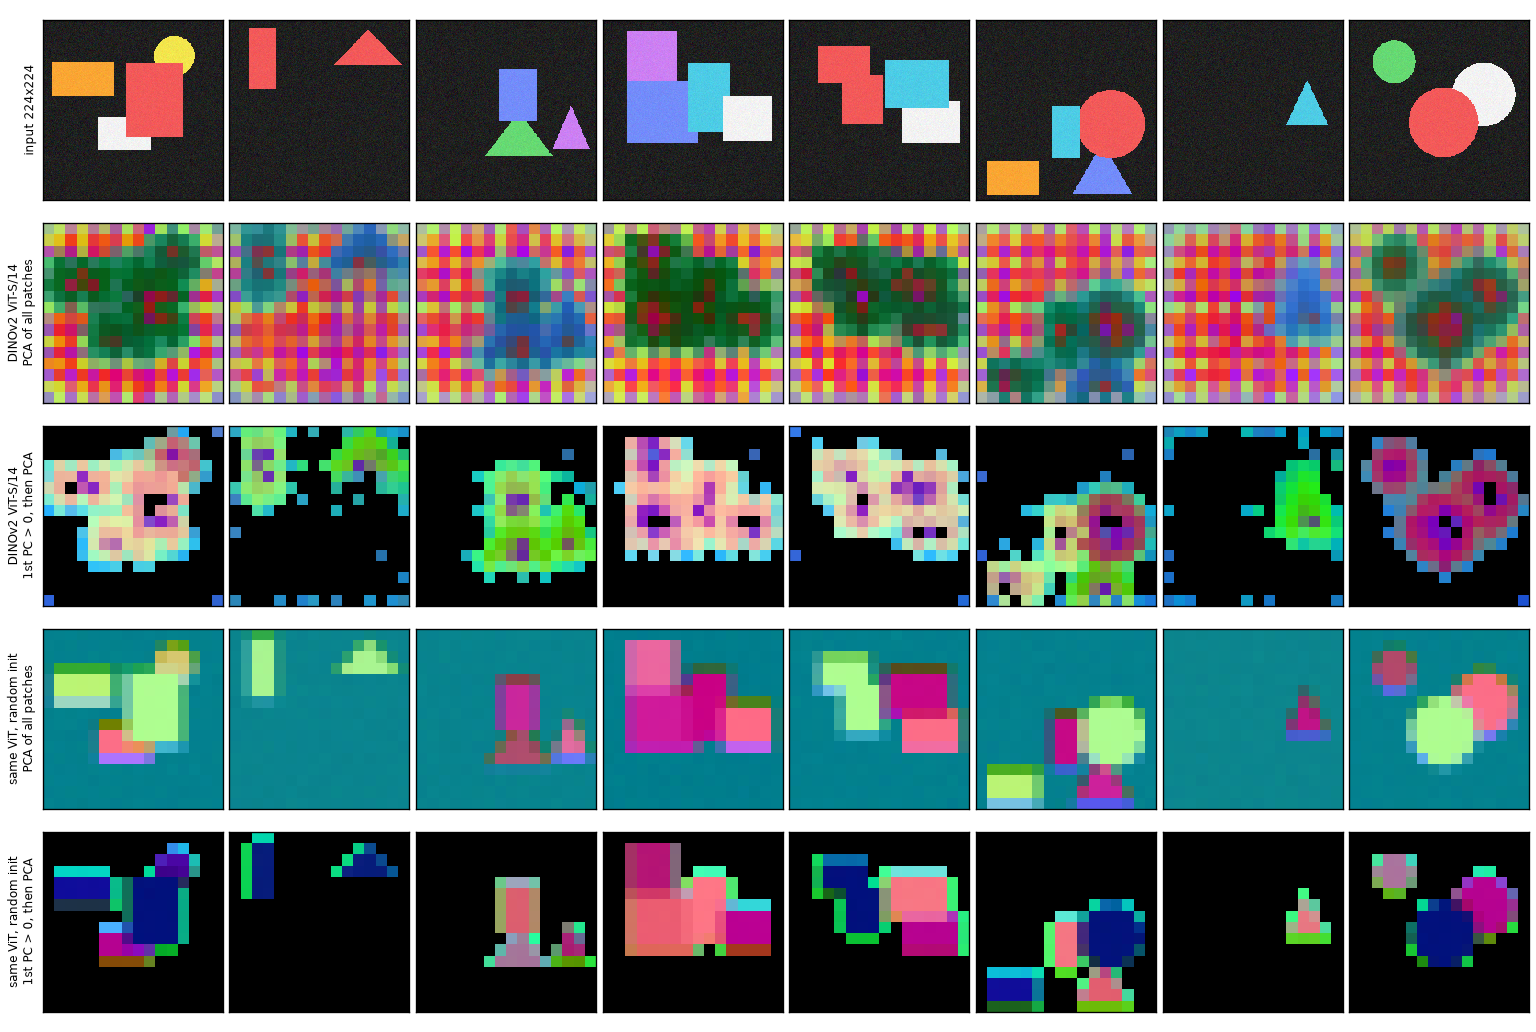
먼저 숫자이다.
- 패치 분류. 시험 패치의 86.3% 가 배경이라 전체 정확도(0.968 대 0.922)는 차이가 작아 보인다. 도형 위의 패치만 보면 사전 학습된 DINOv2 는 0.907, 같은 구조의 무작위 초기화는 0.452 이다. 무작위 초기화의 특징으로는 “여기에 무언가 있다” 까지는 알아도 그것이 원인지 사각형인지 삼각형인지는 절반도 가르지 못한다. DINOv2 는 사진만 보고, 라벨 없이 학습했고, 도형 세상 그림은 처음 본다. 그런데 선형 층 하나만 얹으면 패치마다 도형의 종류를 91% 맞힌다.
- 첫 주성분으로 배경 가르기. 여기서는 반대로 무작위 초기화(0.952)가 DINOv2(0.726)보다 높다. 도형 세상은 배경이 어둡고 도형이 밝아서 밝기만으로 배경이 갈리는데, 무작위 초기화의 특징에서 가장 크게 퍼진 방향이 바로 밝기 · 색인 것으로 보인다(넷째 줄의 색이 입력의 색을 그대로 따라간다). DINOv2 쪽은 도형 둘레의 배경 패치까지 도형 쪽으로 넘어온다(셋째 줄에서 도형이 한두 칸 부풀어 보인다). 패치 특징이 그 패치의 픽셀만이 아니라 주변의 문맥을 담고 있다는 뜻이기도 한다. DINOv2 논문이 사진에서 보인 “첫 주성분 = 주된 객체” 가 이 장난감 그림에서는 그만큼 깔끔하게 재현되지 않았다. 있는 그대로 적어 둔다.
그림 6-10 에서 읽을 것은 색이 무엇을 따라가는가 이다.
- 무작위 초기화(넷째 · 다섯째 줄)의 색은 입력의 색을 따라간다. 빨간 도형은 모양이 무엇이든 같은 색으로, 하늘색 도형은 또 다른 같은 색으로 칠해진다. 특징이 픽셀값을 조금 섞은 것에 지나지 않는다.
- DINOv2(셋째 줄)의 색은 입력의 색과 무관하고, 도형의 종류를 따라가는 경향이 있다. 첫째 그림의 주황 · 빨강 · 흰색 사각형이 모두 옅은 분홍으로, 마지막 그림의 초록 · 흰색 · 빨강 원이 모두 자주색으로, 삼각형들은 초록으로 칠해졌다. 깔끔하지는 않다. 둘째 · 셋째 그림의 사각형은 삼각형과 비슷한 초록빛이다. 눈으로 본 이 경향을 수치로 잰 것이 위의 0.907 이다.
- DINOv2 의 배경(둘째 줄)에는 격자무늬가 있다. 내용이 없는 배경 패치의 특징이 위치에 따라 규칙적으로 달라진다는 뜻이다. 사진에는 이렇게 넓고 균일한 배경이 드물다. 레지스터 논문이 다룬 “정보가 적은 배경 패치” 의 문제와 관련이 있을 수 있지만 이 실험으로 확인한 것은 아니다.
미니 DINO 가 도형 하나짜리 그림 8,000장에서 겨우 얻은 것을, 진짜 DINOv2 는 처음 보는 그림의 패치 하나하나 에서 해낸다. 탐지기가 바라는 것이 바로 이것이다. 패치 특징만 보고 “여기는 삼각형의 일부” 라고 말할 수 있다면, 그 위에 얹는 디코더의 일은 훨씬 쉬워진다. RF-DETR 이 무작위 가중치가 아니라 이 가중치에서 출발하는 까닭이고, 논문의 표 5 · 6 에서 백본을 바꾼 것만으로 2 AP 가 오른 배경이다.
정리
- ViT 는 그림을 \(p \times p\) 패치로 잘라 패치마다 선형 투영한 토큰 \(N = (H/p)(W/p)\) 개를 pre-norm Transformer 인코더에 넣는다. 패치 임베딩은 커널 · 스트라이드가 \(p\) 인 합성곱 하나와 같은 계산이다.
- 출력의 첫 줄(CLS)은 그림 전체의 요약이고, 나머지 \(N\) 줄이 패치 특징이다. 탐지는 패치 특징을 격자로 접은 특징 맵을 쓴다.
- ViT-S(12층, \(D = 384\))의 매개변수는 약 2,200만 개이고 그 대부분이 블록에 있다. 차원을 2배로 하면 약 4배가 된다.
- 블록 하나의 계산은 대략 \(12ND^2 + 2N^2D\) 이다. 토큰 수는 해상도와 패치 크기의 비 \(H/p\) 로 정해지고, 그 비를 2배로 하면 토큰은 4배, 어텐션 쌍은 16배가 된다.
- 그림 크기에 묶인 가중치는 위치 임베딩과 패치 임베딩 둘뿐이다. 위치 임베딩은 2차원 격자로 되돌려 보간하고, 패치 임베딩은 FlexiViT 식으로 크기를 바꾼다(12장).
- ViT 는 귀납 편향이 약해 큰 데이터가 필요하다. 그래서 사전 학습한 가중치에서 출발해 미세 조정한다.
- DINO 는 라벨 없이, 같은 그림의 서로 다른 뷰에 대해 학생의 분포가 EMA 교사의 분포를 따르게 한다. 손실은 교차 엔트로피이고 기울기는 학생으로만 흐른다.
- 붕괴에는 한 칸 쏠림(엔트로피 0)과 균등(엔트로피 \(\log K\))의 두 형태가 있고 둘 다 KL 이 0 이 된다. centering 이 앞의 것을, sharpening 이 뒤의 것을 막는다.
- DINOv2 는 그림 수준(DINO) + 패치 수준(iBOT) 손실을 정제한 1억 4,200만 장에 적용하고, 큰 모델을 작은 모델로 증류했다. 패치 특징이 좋아 RF-DETR 의 백본이 되었고, 논문의 절제 실험에서 백본 교체만으로 +2 AP 였다.
- 이 장의 실험에서 미니 DINO 가 배운 것은 라벨 없는 그림의 종류에 따라 달랐다. 장면으로 학습하면 객체 수를, 도형 하나짜리 그림으로 학습하면 도형의 종류를 얼린 특징에서 읽어 낼 수 있었다. 자기 지도 학습이 무엇을 배우는지는 데이터와 증강이 정하고, 그 품질은 규모에서 나온다.
이제 탐지기의 눈 이 준비되었다. 그림을 넣으면 패치마다 특징 벡터가 하나씩 나오고, 그 특징은 라벨 없이 배운 것인데도 객체와 배경, 객체의 종류를 구별한다. 그런데 특징 맵은 아직 답이 아니다. 우리가 원하는 것은 “여기에 원이 하나, 저기에 삼각형이 하나” 라는 박스와 클래스의 목록 이다. 몇 개가 나올지도 그림마다 다르다. 7장에서는 이 문제를 Transformer 로 정면에서 푼 첫 탐지기 DETR 을 만든다. 탐지를 “집합을 예측하는 문제” 로 보고, 객체 질의와 헝가리안 매칭으로 앵커도 NMS 도 없이 박스를 낸다.
확인 문제
- 1. 토큰 수 — RF-DETR L 은 해상도 704, 패치 크기 16 이다(논문 표 7). 패치 토큰은 몇 개인가? nano(384, 패치 16)에 비해 토큰 수와 자기 어텐션의 쌍의 수는 각각 몇 배인가?
- \(704 / 16 = 44\) 이므로 \(N = 44^2 = 1936\) 개이다. nano 는 \(24^2 = 576\) 개이므로 토큰은 \(1936 / 576 \approx 3.36\) 배, 쌍은 \(3.36^2 \approx 11.3\) 배이다. 해상도는 1.83배 올렸을 뿐이다.
- 2. 매개변수 수 — 이 장의
MiniViT(96×96, 패치 8, \(D = 96\), 4층, MLP 비율 4, 출력 5개)의 매개변수 수를 부품별로 세어 보라. 실행 출력의 480,581 과 맞는가? -
- 패치 임베딩: \(3 \cdot 8 \cdot 8 \cdot 96 + 96 = 18{,}528\)
- CLS 토큰 96, 위치 임베딩 \((144 + 1) \cdot 96 = 13{,}920\)
- 블록 하나: 층 정규화 둘 \(2 \cdot 192 = 384\), qkv \(96 \cdot 288 + 288 = 27{,}936\), 출력 투영 \(96 \cdot 96 + 96 = 9{,}312\), MLP \(96 \cdot 384 + 384 = 37{,}248\) 과 \(384 \cdot 96 + 96 = 36{,}960\) → 합 \(111{,}840\). 4개면 \(447{,}360\)
- 마지막 층 정규화 192, 머리 \(96 \cdot 5 + 5 = 485\)
- 합: \(18{,}528 + 96 + 13{,}920 + 447{,}360 + 192 + 485 = 480{,}581\). 맞다.
- 3. EMA 손계산 — 교사의 가중치 하나가 \(\theta_t = 0.5\), 학생의 것이 \(\theta_s = 1.5\) 이다. \(m = 0.99\) 로 한 번 갱신하면 \(\theta_t\) 는 얼마인가? 학생이 1.5 에 머문 채 100번 갱신하면? (\(0.99^{100} \approx 0.366\))
- 한 번: \(0.99 \cdot 0.5 + 0.01 \cdot 1.5 = 0.51\). 남은 차이는 스텝마다 0.99 배가 되므로 100번 뒤의 차이는 \(1 \cdot 0.99^{100} \approx 0.366\), 곧 \(\theta_t \approx 1.5 - 0.366 = 1.134\) 이다. 100스텝이 지나도 교사는 학생까지의 거리의 63% 만 따라왔다.
- 4. 온도 — 점수가 \(a = (1, 0)\) 일 때 온도 \(\tau = 1\), \(0.5\), \(0.1\) 에서의 소프트맥스를 계산하라. (\(e^1 \approx 2.718\), \(e^2 \approx 7.389\), \(e^{10} \approx 22026\))
- \(\tau = 1\): \((2.718, 1)/3.718 = (0.731, 0.269)\). \(\tau = 0.5\): 점수가 \((2, 0)\) 이 되어 \((7.389, 1)/8.389 = (0.881, 0.119)\). \(\tau = 0.1\): 점수가 \((10, 0)\) 이 되어 \((22026, 1)/22027 \approx (0.99995, 0.00005)\). 온도를 낮출수록 원-핫에 가까워진다.
- 5. 붕괴 알아보기 — 출력 차원이 \(K = 256\) 인 미니 DINO 를 두 번 돌렸더니 학습 끝의 기록이 (가) 교사 엔트로피 5.545, KL 0.000 (나) 교사 엔트로피 0.000, KL 0.001 이었다. 각각 어떤 상태인가? 무엇을 빠뜨렸을 가능성이 큰가? (\(\ln 256 \approx 5.545\))
- 둘 다 KL 이 0 이므로 붕괴이다. (가)는 엔트로피가 \(\log K\) 이므로 모든 그림에 균등 분포를 내는 붕괴이고, 교사의 온도가 너무 높은 것(sharpening 이 없는 것)이 원인일 가능성이 크다. (나)는 엔트로피가 0 이므로 모든 그림이 한 칸으로 쏠린 붕괴이고, centering 이 빠졌을 가능성이 크다. 이 장의 실험에서 본 그대로이다.
- 6. 위치 임베딩 보간 — 값 하나짜리 위치 임베딩이 한 줄에 \([2,\ 4,\ 8]\) 로 세 칸 있다(\(g = 3\)). 이것을 쌍선형 보간으로 두 칸(\(g' = 2\))으로 줄이면 값은 얼마인가? 본문의 식 \(u_i = (i + 0.5)\cdot g/g' - 0.5\) 를 쓰라.
- \(u_0 = 0.5 \cdot 1.5 - 0.5 = 0.25\): 0번 칸(값 2)과 1번 칸(값 4) 사이의 1/4 지점이므로 \(0.75 \cdot 2 + 0.25 \cdot 4 = 2.5\). \(u_1 = 1.5 \cdot 1.5 - 0.5 = 1.75\): 1번 칸(값 4)과 2번 칸(값 8) 사이의 3/4 지점이므로 \(0.25 \cdot 4 + 0.75 \cdot 8 = 7\). 답은 \([2.5,\ 7]\) 이다.
- 7. 같은 토큰 수, 다른 방법 — ViT-S 를 384×384, 패치 16 으로 쓰다가 그림을 768×768 로 키우려 한다. (가) 패치 크기를 16 으로 두는 것과 (나) 패치 크기를 32 로 키우는 것은 토큰 수 · 블록의 계산량 · 바꿔야 하는 가중치의 면에서 어떻게 다른가?
- (가) 격자가 \(768/16 = 48\) 이 되어 토큰이 \(576 \to 2304\)(4배), 어텐션 쌍이 16배가 된다. \(N = 6D = 2304\) 이므로 블록에서 제곱 항과 비례 항이 같아지는 지점이고, 블록의 계산량은 약 6.4배가 된다. 위치 임베딩을 24×24 에서 48×48 로 보간해야 하고 패치 임베딩은 그대로 쓴다. (나) 격자가 \(768/32 = 24\) 로 그대로라 토큰 수와 블록의 계산량이 변하지 않고 위치 임베딩도 그대로 쓴다. 대신 패치 임베딩의 커널을 16×16 에서 32×32 로 바꿔야 하고(FlexiViT 식 변환), 패치 하나가 원래 그림의 4배 넓이를 담는다. RF-DETR 논문 부록 L 의 관찰대로라면 (나)의 정확도는 384/16 일 때와 비슷할 것이라고 예상할 수 있다.
- 8. 왜 교사에는 기울기를 흘리지 않나 — DINO 의 손실 \(\mathrm{CE}(P_t, P_s)\) 를 교사의 가중치로도 미분해 교사까지 함께 경사 하강법으로 학습하면 어떤 일이 생길지 설명해 보라.
- 교사와 학생이 둘 다 손실을 줄이는 쪽으로 움직이면, 손실을 0 으로 만드는 가장 쉬운 길은 둘이 함께 “모든 그림에 같은 한 칸” 을 내는 것이다(엔트로피 0, KL 0). 교사가 목표 노릇을 하려면 손실에 끌려다니지 않아야 한다. 그래서 교사 쪽에는 기울기 차단을 걸고 EMA 로만 천천히 바꾼다. centering · sharpening 도 손실로 학습되는 것이 아니라 교사의 출력에 밖에서 걸어 주는 조작이다.
- 직접 바꿔 보기
-
python ch06_vit.py --dino-steps 6000으로 미니 DINO 를 두 배 길게 돌려 선형 분류기 표가 어떻게 달라지는지,--tau-t 0.04로 교사 온도를 DINO 논문의 값으로 올리면 어떻게 되는지 보라.random_view에서 채널 섞기를 빼면(색을 바꾸지 않으면) 무엇이 달라질지도 예상해 보고 확인해 보라. 증강이 곧 “무엇을 같은 것으로 볼지” 를 정한다는 것을 떠올리면 된다.train_dino의momentum을 0.99 에서 0.9 로 낮춰 교사가 학생을 빨리 따라가게 하면 그림 6-7 의 곡선이 어떻게 되는지도 보라.
See also
Favorite site
- 06. Vision Transformer 와 DINOv2
- code/ch06_vit.py
- code/ch06_dinov2_features.py
- An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (ViT, arXiv:2010.11929)
- Emerging Properties in Self-Supervised Vision Transformers (DINO, arXiv:2104.14294)
- DINOv2: Learning Robust Visual Features without Supervision (arXiv:2304.07193)
- iBOT: Image BERT Pre-Training with Online Tokenizer (arXiv:2111.07832)
- Vision Transformers Need Registers (arXiv:2309.16588)
- RF-DETR: Neural Architecture Search for Real-Time Detection Transformers (arXiv:2511.09554)