RF-DETR:Tutorial:08-DeformableDETR
lastmod 2026-11-18created 2026-11-186 edits
Deformable DETR: 필요한 곳만 보기는 RF-DETR 튜토리얼의 8장이다. 7장의 DETR 은 객체 질의 하나가 특징 맵의 모든 칸 을 보기 때문에 어디를 봐야 하는지 배우는 데 오래 걸리고 특징 맵을 키우기도 어렵다. Deformable DETR(Zhu 외, 2020; ICLR 2021)은 질의가 기준점 주위의 몇 개 점만 보게 바꾼다. 이 장은 그 연산인 변형 어텐션을 쌍선형 보간부터 식 · 손계산 · 구현까지 따라가고, 박스를 층마다 고쳐 나가는 박스 반복 정제와 그림을 보고 질의의 출발점을 고르는 2단계 방식을 만든다. 세 가지 모두 RF-DETR 의 디코더가 물려받은 생각이고, 물려받으며 달라진 곳도 함께 짚는다. 다음 장은 이 계보를 실시간으로 빠르게 만드는 이야기다.
- 원문: 08. Deformable DETR: 필요한 곳만 보기 (원문 기준 읽는 시간 약 110분, 난이도 ★★★★☆)
- 실습 코드:
code/ch08_deformable.py. 7장의ch07_detr.py에서 백본 · 헝가리안 매칭 · 집합 손실 · 학습 고리를 가져다 쓰고, 쌍선형 보간 · 변형 어텐션 · 박스 반복 정제 · 포컬 손실 · 2단계 질의 선택을 새로 만든다. 본 모델(60 에폭)과 절제 모델 다섯(각 15 에폭)을 학습하며, 원문의 실행은 8GB 노트북 GPU 를 다른 작업과 나눠 쓴 상태에서 약 27분(1,645초)이 걸렸다.--quick은 오류만 확인하는 축소판(CPU 약 30초)이다. 7장의ch07_history.json이 같은 폴더에 있으면 7장의 곡선을 겹쳐 그린다. - 이전: 07. DETR: 탐지를 집합 예측으로 / 다음: 09. 실시간 DETR: RT-DETR 과 LW-DETR
이 장에서 배우는 것
- DETR 이 느리게 배우고 큰 특징 맵을 쓰지 못하는 이유를 Deformable DETR 논문이 어떻게 설명하는지
- 쌍선형 보간: 칸과 칸 사이의 값을 네 이웃의 가중 평균으로 읽는 식의 유도, 좌표 규약, 손계산
- 표본 위치에 대한 기울기를 유도해, "어디를 볼지" 를 경사 하강법으로 배울 수 있는 이유
- 변형 어텐션의 단일 스케일 · 다중 스케일 식을 기호 하나씩 읽고, 보통 어텐션과 다른 점 짚기
- 기준이 점일 때와 박스일 때 오프셋의 단위가 어떻게 달라지는지, 오프셋을 어떻게 초기화하는지
- 교차 어텐션 한 번의 연산 수를 손으로 세고, 실제로 잰 시간과 견주기
- 역시그모이드와 박스 반복 정제: 로짓 공간에서 더하는 이유, 기울기 차단
- ∅ 클래스 없는 시그모이드 분류와 포컬 손실, 포컬 꼴의 매칭 비용
- 2단계 질의 선택: 특징 맵의 모든 칸이 제안 박스를 내고 상위 몇 개가 디코더의 기준 박스가 되는 과정
- 도형 세상에서 7장의 MiniDETR 과 같은 조건으로 학습해 보고, 결과에서 말할 수 있는 것과 없는 것 가르기
- 이 장의 표기
-
- \(D\): 토큰 벡터의 차원(5장과 같다). Deformable DETR 논문은 이것을 \(C\) 로 쓰고, 이 장 코드의 독스트링도 변형 어텐션 안에서는
C로 적는다. - \(M\): 어텐션 머리의 수(5장의 \(h\)). \(L\): 특징 레벨의 수. \(K\): 머리 하나가 레벨 하나에서 읽는 표본점의 수. 논문의 글자를 그대로 따랐다. 5장에서 \(K\) 는 열쇠 행렬, \(M\) 은 인코더가 만든 그림 토큰이었지만 이 장의 식에는 그 둘이 나오지 않는다.
- 코드의 텐서 모양 주석에서는 글자
K가 두 가지로 쓰인다.(B, Nq, M, L, K, 2)의K는 표본점 수,(B, N, K)의K는 클래스 수이다. 본문의 식에서 \(K\) 는 언제나 표본점 수이다. - 번호: 머리 \(m = 1, \dots, M\), 표본점 \(k = 1, \dots, K\), 레벨 \(l = 0, \dots, L-1\). 레벨만 0 부터 세는 것은 코드 · 그림 · 로그가 "레벨 0(12×12), 레벨 1(6×6)" 이라고 부르기 때문이다. 논문은 레벨도 1 부터 센다.
- \(X\): 특징 맵(논문은 소문자 \(x\)). 이 장에서 소문자 \(x, y\) 는 점의 가로 · 세로 좌표이다. \(X(p)\) 는 "특징 맵 \(X\) 를 점 \(p\) 에서 읽은 값" 이다.
- 좌표는 모두 2장의 정규화 좌표(0 – 1)이다. 논문은 정규화 좌표에 모자를 씌워 \(\hat{p}_q\) 로 쓰지만, 이 튜토리얼에서 모자는 "모델의 예측" 을 뜻하므로(\(\hat{b}\) 는 예측 박스, \(\hat{p}\) 는 예측 확률) 기준점은 모자 없이 \(p_q\) 로 적는다.
- \(W^V_m\), \(W^O_m\): 값 투영과 출력 투영 행렬(5장의 \(W_V\), \(W^O\)). 논문은 \(W'_m\), \(W_m\) 으로 쓴다. 첨자 없는 \(W\), \(W_l\) 은 특징 맵의 너비이고, 소문자 \(w, h\) 는 박스의 너비 · 높이이다.
- \(D\): 토큰 벡터의 차원(5장과 같다). Deformable DETR 논문은 이것을 \(C\) 로 쓰고, 이 장 코드의 독스트링도 변형 어텐션 안에서는
DETR 의 두 가지 숙제
7장에서 DETR 은 앵커도 NMS 도 없이 탐지를 집합 예측으로 풀었다. 그런데 원 논문이 스스로 밝힌 약점이 둘 있었다. Deformable DETR 논문은 서론에서 이 둘을 숫자로 적는다. COCO 에서 DETR 은 수렴에 500 에폭 이 필요하고(논문의 표현으로 Faster R-CNN 보다 10 – 20배 느리다), 작은 객체 의 성능이 낮다. 그리고 두 약점의 뿌리를 한곳에서 찾는다. Transformer 의 어텐션이 그림의 특징 맵을 다루는 방식이다.
처음에는 모든 곳을 똑같이 본다
5장의 어텐션을 떠올려 보자. 질의와 열쇠의 내적으로 점수를 내고, 소프트맥스로 가중치를 만들었다. 학습을 시작할 때는 질의도 열쇠도 의미 없는 난수에 가까우므로 점수가 서로 비슷하고, 소프트맥스를 거친 가중치도 서로 비슷하다. 논문 3절은 이것을 이렇게 적는다. 적절히 초기화하면 열쇠가 \(N_k\) 개일 때 어텐션 가중치가 대략 \(1/N_k\) 이 되고, 그러면 입력 특징에 대한 기울기가 모호해져, 가중치가 특정 열쇠에 모이기까지 긴 학습이 필요하다. 그림에서는 열쇠가 픽셀(특징 맵의 칸)이라 \(N_k\) 가 아주 크고, 그래서 수렴이 지루하게 길다는 것이다.
도형 세상의 숫자로 옮기면 이렇다. 7장 MiniDETR 의 특징 맵은 12×12 = 144칸이었다. 객체 질의 하나가 144칸을 고르게 보면 칸마다 가중치가 \(1/144 = 0.0069\) 이다. 원 하나가 차지하는 칸이 10칸이라고 해도, 그 원에서 오는 정보는 전체의 7% 뿐이고 나머지 93% 는 배경과 다른 도형이다. 7장의 교차 어텐션 지도에서 본 "자기 객체 근처 몇 칸에 몰린 가중치" 는 학습이 끝난 뒤 의 모습이다. 거기까지 가는 길이 길다. 논문도 같은 말을 한다. 초기화 때 교차 어텐션은 특징 맵 전체에 거의 평균으로 걸려 있고, 학습이 끝나면 어텐션 지도가 객체의 끝부분에만 모인 아주 성긴 모양이 된다고 적는다.
- 누구의 설명인가
- "처음에 고르게 보기 때문에 느리다" 는 Deformable DETR 논문의 진단이다. 이 장의 실험은 이 진단을 따로 떼어 검증하지 않는다. 뒤에서 보겠지만, 이 장의 모델이 7장보다 빨리 배운 까닭을 변형 어텐션 하나로 돌릴 수 없다. 함께 바뀐 것이 여럿이기 때문이다.
큰 특징 맵을 쓸 수 없다
작은 객체를 찾으려면 해상도가 높은 특징 맵이 필요하다. 스트라이드 32 인 특징 맵에서는 32×32 픽셀이 한 칸이라, 그보다 작은 객체는 한 칸의 일부일 뿐이다. 그래서 요즘 탐지기는 해상도가 다른 특징 맵을 여러 장 함께 쓴다. 큰 객체는 거친 맵에서, 작은 객체는 촘촘한 맵에서 찾는 것이다.
DETR 은 그렇게 하지 못한다. 특징 맵의 칸 수를 \(HW\)(높이 × 너비)라고 하면 비용이 다음과 같이 늘기 때문이다.
- 인코더의 자기 어텐션: 모든 칸이 모든 칸을 본다. 쌍의 수가 \(HW \times HW\) 이므로 칸 수의 제곱 으로 는다(논문의 표기로 \(O(H^2W^2C)\)). 5장에서 계산한 대로, 해상도를 두 배로 올리면 칸은 4배, 쌍은 16배이다.
- 디코더의 교차 어텐션: 질의 \(N\) 개가 모든 칸을 본다. 쌍의 수가 \(N \times HW\) 이므로 칸 수에 비례 해 는다. 제곱은 아니지만, 칸이 많아질수록 앞의 "고르게 보는" 문제가 심해진다.
논문은 고해상도 특징 맵이 인코더의 자기 어텐션에 "받아들일 수 없는 복잡도" 를 만든다고 적는다. 결과는 논문 표 1 에 있다. COCO 에서 DETR(500 에폭)의 작은 객체 AP 는 20.5 로, 다중 스케일 특징을 쓰는 Faster R-CNN + FPN 의 26.6 보다 낮다(전체 AP 는 둘 다 42.0).
- 이 장이 다루는 범위
- Deformable DETR 은 인코더의 자기 어텐션과 디코더의 교차 어텐션을 둘 다 변형 어텐션으로 바꾼다. 이 장은 그 가운데 디코더의 교차 어텐션 만 만든다. 9장부터의 LW-DETR · RF-DETR 이 그렇게 하기 때문이다. 이 모델들에서는 ViT 백본이 인코더 노릇을 하고(그 제곱 비용은 9장의 윈도 어텐션으로 줄인다), 변형 어텐션은 디코더에만 있다.
발상: 기준점 주위의 몇 점만
해결책은 한 문장이다. 질의마다 기준이 되는 점을 하나 두고, 그 둘레의 몇 개 점에서만 값을 읽는다. 이것이 변형 어텐션(deformable attention) 이다. 이름은 변형 합성곱(deformable convolution, Dai 외, 2017)에서 왔다. 보통의 합성곱이 3×3 처럼 정해진 격자 자리를 읽는 데 견주어, 읽는 자리를 입력에 따라 "변형" 한다는 뜻이다. 이 방식으로 만든 탐지기가 Deformable DETR 이다.
넓은 주차장에서 내 차를 찾는다고 하자. DETR 의 방식은 주차장 사진 전체를 144조각으로 잘라 모든 조각을 한 번씩 훑어보는 것이다. 처음에는 어느 조각이 중요한지 몰라 전부 똑같이 본다. 변형 어텐션의 방식은 "B 구역 기둥 옆" 처럼 짚이는 자리 하나를 정하고, 그 둘레 몇 군데만 살피는 것이다. 살핀 결과로 짐작을 고치고("조금 더 왼쪽이었네"), 고친 자리 둘레를 다시 살핀다. 짚이는 자리가 기준점, 살피는 몇 군데가 표본점, 짐작을 고치는 일이 박스 반복 정제이다.
용어 셋을 먼저 정해 둔다.
- 기준점(reference point): 질의 하나가 "이 근처를 보겠다" 고 정한 정규화 좌표 \((x, y)\) 하나. 질의 \(q\) 의 기준점을 \(p_q\) 라고 쓴다. 점 대신 박스 \((c_x, c_y, w, h)\) 를 기준으로 쓰면 기준 박스(reference box) 이다.
- 오프셋(sampling offset): 기준점에서 얼마나 떨어진 곳을 볼지를 나타내는 2차원 벡터 \(\Delta p\). 질의의 내용을 보고 신경망이 낸다.
- 표본점(sampling point): 기준점에 오프셋을 더한 자리. 실제로 특징 맵의 값을 읽는 곳이다.
원문 그림 8-1(도식): 왼쪽: 보통 교차 어텐션은 질의 하나가 격자의 모든 칸을 읽는다. 오른쪽: 변형 어텐션은 기준점 둘레의 표본점 네 개만 읽는다. 질의 하나가 교차 어텐션 한 번에 읽는 자리. 왼쪽은 격자 전체(파랑), 오른쪽은 기준점에 오프셋을 더한 표본점 몇 개이다. 읽는 자리의 수가 격자 크기와 상관없어진다.
그림 8-1 의 오른쪽에서 두 가지를 읽어 두라. 첫째, 읽는 자리의 수가 특징 맵의 크기와 무관하다. 격자가 8×8 이든 100×100 이든 표본점은 4개이다. 둘째, 표본점은 칸의 한가운데에 떨어지지 않는다. 오프셋이 실수이므로 표본점은 칸과 칸 사이 어디에나 올 수 있다. 여기서 세 가지 물음이 생기고, 이 장의 앞 절반이 그 답이다.
- 칸과 칸 사이에 떨어진 점의 값은 어떻게 읽는가? → 쌍선형 보간
- 오프셋은 정답이 따로 없는데 어떻게 배우는가? → 쌍선형 보간으로 읽은 값은 표본 위치로 미분할 수 있다
- 오프셋과 가중치는 누가 정하는가? → 질의의 벡터에서 선형 층으로 예측한다(변형 어텐션의 식)
쌍선형 보간
특징 맵은 칸마다 값이 하나씩 있는 표이다. 표본점 \((0.60, 0.45)\) 는 어느 칸의 한가운데도 아니다. 가장 가까운 칸의 값을 그냥 가져오는 방법(최근접 이웃)도 있지만, 그러면 표본점을 조금 옮겨도 값이 그대로이다가 칸의 경계를 넘는 순간 갑자기 바뀐다. "조금 옮기면 값이 어떻게 변하는가" 가 0 아니면 뜀이어서, 기울기로 오프셋을 배울 수 없다. 쌍선형 보간(bilinear interpolation) 은 둘레 네 칸의 값을 거리에 따라 섞어, 표본점이 움직이면 값도 매끄럽게 따라 움직이게 한다.
일차원에서 먼저: 선형 보간
한 줄로 늘어선 칸부터 본다. 이웃한 두 칸의 값이 \(v_0\)(왼쪽), \(v_1\)(오른쪽)이고, 두 칸의 중심 사이 거리를 1 로 둔다. 왼쪽 칸의 중심에서 오른쪽으로 \(t\) 만큼 간 곳(\(0 \le t \le 1\))의 값을 정하고 싶다. 가장 단순한 약속은 두 값을 직선으로 잇는 것이다. 이것이 선형 보간(linear interpolation) 이다.
- 선형 보간: 두 값을 잇는 직선
- \(v(t) = v_0 + (v_1 - v_0)\,t\)
- \(t = 0\) 에서 \(v_0\), \(t = 1\) 에서 \(v_1\) 을 지나는 직선이다. 기울기는 "오른쪽 값 − 왼쪽 값" 이고, 왼쪽에서 \(t\) 만큼 갔으므로 그만큼 올라간다.
- 괄호를 풀었다.
- \(v_0\) 끼리 묶었다. 두 값의 가중 평균 이다. 가중치 \((1 - t)\) 와 \(t\) 는 둘 다 0 이상이고 합이 1 이다. 왼쪽 값의 가중치 \(1 - t\) 는 "오른쪽 칸까지 남은 거리" 이다. 가까운 칸일수록 가중치가 크다.
숫자로 해 본다. \(v_0 = 2\), \(v_1 = 4\), \(t = 0.3\) 이면 \(v = 0.7 \times 2 + 0.3 \times 4 = 1.4 + 1.2 = 2.6\) 이다. 왼쪽 칸에 더 가까우므로 2 쪽으로 치우친 값이 나왔다. \(t = 0\) 이면 정확히 \(v_0\), \(t = 1\) 이면 정확히 \(v_1\) 이다. 칸의 중심에서는 그 칸의 값을 그대로 돌려준다.
이차원으로: 네 이웃의 가중 평균
이차원에서는 표본점을 둘러싼 칸이 넷이다. 네 칸의 값을 다음과 같이 부르겠다. 첫째 첨자는 세로(0 = 위, 1 = 아래), 둘째 첨자는 가로(0 = 왼쪽, 1 = 오른쪽)이다.
- \(v_{00}\): 왼쪽 위, \(v_{01}\): 오른쪽 위
- \(v_{10}\): 왼쪽 아래, \(v_{11}\): 오른쪽 아래
표본점은 왼쪽 위 칸의 중심에서 오른쪽으로 \(t_x\), 아래로 \(t_y\) 만큼 간 곳이다(둘 다 0 – 1). 선형 보간을 가로로 두 번, 세로로 한 번 한다. "쌍(bi)선형" 이라는 이름이 여기서 나온다.
원문 그림 8-2(도식): 네 이웃 칸의 중심이 만드는 사각형 안에 표본점이 있고, 각 이웃의 가중치는 표본점 건너편 사각형의 넓이와 같다. 네 이웃 칸의 중심(색 점)이 만드는 한 변 1 의 사각형과 그 안의 표본점(검은 점). 표본점이 사각형을 네 조각으로 나누고, 각 이웃의 가중치는 대각선 건너편 조각의 넓이 이다. 왼쪽 아래 이웃 \(v_{10}\)(초록)에 가장 가까우므로 건너편의 초록 조각(0.595)이 가장 넓다. 숫자는 뒤의 손계산 예와 같다.
- 쌍선형 보간: 가로로 두 번, 세로로 한 번
- \(v_{\text{위}} = (1 - t_x)\,v_{00} + t_x\,v_{01}\)
- 위쪽 두 칸을 가로 방향으로 선형 보간했다. 표본점 바로 위, 윗변 위의 점의 값이다.
- 아래쪽 두 칸도 같은 \(t_x\) 로 보간했다. 표본점 바로 아래, 아랫변 위의 점의 값이다.
- 방금 구한 두 값을 세로 방향으로 선형 보간했다. 위에서 \(t_y\) 만큼 내려왔다.
- \(v_{\text{위}}\) 와 \(v_{\text{아래}}\) 를 대입했다.
- 괄호를 풀어 값마다 모았다. 네 이웃의 가중 평균이고, 가중치는 가로 가중치와 세로 가중치의 곱 이다. 세로를 먼저, 가로를 나중에 보간해도 같은 식이 나온다.
- 네 가중치의 합은 1
- \((1 - t_x)(1 - t_y) + t_x(1 - t_y) + (1 - t_x)\,t_y + t_x\,t_y\)
- 네 가중치를 더한다.
- 앞 둘은 \((1 - t_y)\) 로, 뒤 둘은 \(t_y\) 로 묶었다.
- 대괄호 안이 1 이다. 가중치가 모두 0 이상이고 합이 1 이므로, 보간한 값은 네 이웃 값의 최솟값과 최댓값 사이에 있다. 네 이웃이 모두 같은 값이면 그 값이 그대로 나온다.
그림 8-2 의 넓이 해석도 이 식에서 바로 나온다. 왼쪽 위 이웃 \(v_{00}\) 의 가중치 \((1 - t_x)(1 - t_y)\) 는 가로 \(1 - t_x\), 세로 \(1 - t_y\) 인 사각형, 곧 표본점의 오른쪽 아래 조각의 넓이이다. 표본점이 어떤 이웃에 가까워질수록 건너편 조각이 넓어지고, 그 이웃의 가중치가 커진다.
좌표 규약: 정규화 좌표에서 칸 눈금으로
식은 끝났지만, 구현에서 틀리기 쉬운 곳은 따로 있다. 정규화 좌표 \((x, y)\) 가 주어졌을 때 네 이웃이 어느 칸이고 \(t_x, t_y\) 가 얼마인가 이다. 2장의 픽셀 중심 규약을 특징 맵에 그대로 쓴다. 높이 \(H\) 칸, 너비 \(W\) 칸인 특징 맵에서
- 특징 맵 전체가 정규화 좌표의 \([0, 1] \times [0, 1]\) 을 덮는다. \((0, 0)\) 은 맨 왼쪽 위 칸의 왼쪽 위 모서리, \((1, 1)\) 은 맨 오른쪽 아래 칸의 오른쪽 아래 모서리이다.
- 열 번호가 \(c\) 인 칸은 가로로 구간 \([c/W,\ (c+1)/W]\) 를 차지하고, 그 칸의 값은 칸의 중심 \((c + 0.5)/W\) 에 놓여 있다고 본다. 행 번호 \(r\) 도 같다.
칸의 중심이 정수가 되는 눈금으로 옮기면 계산이 쉬워진다. 이 눈금에서의 좌표를 \(u_x, u_y\) 라고 하겠다(코드의 px, py).
- 정규화 좌표 → 칸 눈금 → 이웃과 가중치
- \(x = \frac{c + 0.5}{W} \quad\Longleftrightarrow\quad c = x\,W - 0.5\)
- 열 \(c\) 의 중심의 정규화 좌표를 \(c\) 에 대해 풀었다. 정규화 좌표에 \(W\) 를 곱하고 0.5 를 빼면 "열 번호로 잰 위치" 가 된다.
- 같은 식을 칸의 중심이 아닌 점에도 쓴다. \(u_x = 1.3\) 이면 "열 1 의 중심에서 오른쪽으로 0.3칸 간 곳" 이다. 가로는 너비 \(W\), 세로는 높이 \(H\) 를 곱한다.
- \(\lfloor \cdot \rfloor\) 는 내림(그 수를 넘지 않는 가장 큰 정수)이다. 왼쪽 위 이웃의 열 · 행 번호이다. 네 이웃은 (행 \(r_0\), 열 \(c_0\)), (\(r_0\), \(c_0 + 1\)), (\(r_0 + 1\), \(c_0\)), (\(r_0 + 1\), \(c_0 + 1\)) 이다.
- 내림하고 남은 소수 부분이 왼쪽 위 이웃에서 오른쪽 · 아래로 간 거리이다. 언제나 0 이상 1 미만이다.
남은 약속이 둘 있다.
- 맵 밖의 이웃은 0. 표본점이 가장자리 칸의 중심보다 바깥에 있으면(\(u_x \lt 0\) 이거나 \(u_x \gt W - 1\)) 네 이웃 가운데 일부가 맵 밖이다. 그런 이웃의 값은 0 으로 친다. 그래서 맵의 가장자리 반 칸에서는 값이 0 쪽으로 옅어지고, 맵의 테두리에서 반 칸 넘게 벗어난 표본점은 네 이웃이 모두 맵 밖이라 0 을 읽는다.
- PyTorch 의
F.grid_sample은 좌표를 \(-1\) 에서 \(1\) 사이로 받는다. 정규화 좌표 \(x\) 를 \(2x - 1\) 로 바꿔 넘긴다. 그리고 인자align_corners=False가 바로 위의 규약이다. \(-1\) 과 \(1\) 이 가장자리 칸의 바깥쪽 모서리 를 가리킨다는 뜻이다.align_corners=True는 \(-1\) 과 \(1\) 이 가장자리 칸의 중심 을 가리키는 다른 규약이다. 둘을 섞으면 표본점이 반 칸씩 밀린다. Deformable DETR 과 RF-DETR 의 공개 코드는align_corners=False,padding_mode="zeros"를 쓴다.
- 확인: grid_sample 의 좌표로 써도 같은 눈금이 나온다
- \(g = 2x - 1\)
-
grid_sample에 넘기는 좌표 \(g\). 정규화 좌표 0 – 1 을 \(-1\) – \(1\) 로 늘렸다.
-
align_corners=False일 때 PyTorch 가 \(g\) 를 칸 눈금으로 바꾸는 식이다. \(g = -1\) 이면 \(u_x = -0.5\)(열 0 의 왼쪽 모서리), \(g = 1\) 이면 \(u_x = W - 0.5\)(마지막 열의 오른쪽 모서리)가 된다.
- \(g + 1 = 2x\) 를 대입했다. 앞에서 정한 눈금과 같다. 뒤의 코드가 직접 만든 보간과
grid_sample의 결과가 같다는 것을 숫자로 확인한다.
손계산과 코드 대조
3×3 특징 맵(채널 1개)에서 점 \((x, y) = (0.60, 0.45)\) 의 값을 손으로 구한다. 맵은 다음과 같다(행 0 이 맨 위).
| 열 0 | 열 1 | 열 2 | |
| 행 0 | 1 | 2 | 4 |
| 행 1 | 3 | 5 | 7 |
| 행 2 | 6 | 8 | 9 |
- 쌍선형 보간 손계산: 3×3 맵, 점 (0.60, 0.45)
- \(u_x = 0.60 \times 3 - 0.5 = 1.30, \qquad u_y = 0.45 \times 3 - 0.5 = 0.85\)
- 칸 눈금으로 옮겼다. \(W = H = 3\). 가로로는 열 1 과 열 2 사이, 세로로는 행 0 과 행 1 사이이다.
- 왼쪽 위 이웃은 (행 0, 열 1)이다. 거기서 오른쪽으로 0.30칸, 아래로 0.85칸 간 곳이 표본점이다.
- 네 이웃의 값을 표에서 읽었다. (행 0, 열 1), (행 0, 열 2), (행 1, 열 1), (행 1, 열 2) 이다.
- 네 가중치이다. 합은 \(0.1050 + 0.0450 + 0.5950 + 0.2550 = 1\). 표본점이 아래쪽 · 왼쪽에 가까우므로 왼쪽 아래 이웃(\(v_{10} = 5\))의 가중치가 가장 크다.
- 가중 평균이다. 두 단계로 나눠 검산하면, 위 \(0.7 \times 2 + 0.3 \times 4 = 2.6\), 아래 \(0.7 \times 5 + 0.3 \times 7 = 5.6\), 그리고 \(0.15 \times 2.6 + 0.85 \times 5.6 = 0.39 + 4.76 = 5.15\). 네 이웃 값의 범위 2 – 7 안에 있다.
이 계산을 그대로 옮긴 함수가 bilinear_sample 이다. 점 여러 개를 한꺼번에 처리하고, 맵 밖의 이웃을 0 으로 치는 부분만 더 있다.
def bilinear_sample(feature: torch.Tensor, points: torch.Tensor) -> torch.Tensor:
    """특징 맵의 "칸과 칸 사이" 의 값을 쌍선형 보간으로 읽는다.

    feature: (C, H, W) 특징 맵.  points: (P, 2) — 정규화 좌표 (x, y), 0 – 1. 돌려주는 값: (P, C).

    좌표 규약 (F.grid_sample 의 align_corners=False 와 같다):
      - 특징 맵 전체가 [0, 1] × [0, 1] 이고, 칸 (행 r, 열 c) 은 가로 [c/W, (c+1)/W], 세로 [r/H, (r+1)/H] 를 차지한다.
      - 칸의 값은 칸의 중심 ((c + 0.5)/W, (r + 0.5)/H) 에 놓여 있다고 본다.
      - 그러므로 정규화 좌표 x 를 "열 번호 눈금" 으로 바꾸면 px = x·W − 0.5 (중심이 정수가 되게).
    맵 밖의 칸은 값이 0 이라고 본다 (padding_mode="zeros").
    """
    channels, height, width = feature.shape
    px = points[:, 0] * width - 0.5  # (P,) 열 눈금에서의 위치
    py = points[:, 1] * height - 0.5  # (P,) 행 눈금에서의 위치
    x0, y0 = torch.floor(px), torch.floor(py)  # 왼쪽 위 이웃 칸의 번호
    tx, ty = px - x0, py - y0  # 왼쪽 위 이웃에서 오른쪽 · 아래로 얼마나 갔는가 (0 – 1)
    output = feature.new_zeros(len(points), channels)
    # 네 이웃: (dy, dx) = (0,0) 왼쪽 위, (0,1) 오른쪽 위, (1,0) 왼쪽 아래, (1,1) 오른쪽 아래
    for dy, dx in ((0, 0), (0, 1), (1, 0), (1, 1)):
        col, row = x0 + dx, y0 + dy
        weight = (tx if dx else 1 - tx) * (ty if dy else 1 - ty)  # 가까운 이웃일수록 큰 가중치. 넷의 합은 1
        inside = (col >= 0) & (col < width) & (row >= 0) & (row < height)
        value = feature[:, row.clamp(0, height - 1).long(), col.clamp(0, width - 1).long()].T  # (P, C)
        output += (weight * inside)[:, None] * value  # 맵 밖 이웃은 0 으로 친다
    return output
모양을 따라가 본다. feature 는 (C, H, W), points 는 (P, 2) 이다. px, py, tx, ty 는 모두 (P,) 이고, 네 이웃을 도는 고리 안에서 feature[:, 행, 열] 이 (C, P) 를 돌려주므로 .T 로 (P, C) 로 바꾼다. 가중치 (P,) 에 [:, None] 을 붙여 (P, 1) 로 만들면 채널마다 같은 가중치가 곱해진다. 맵 밖의 번호는 clamp 로 맵 안에 끌어다 놓고 값을 읽되, inside 가 거짓이면 가중치에 0 을 곱해 버린다.
손계산 예를 그대로 출력하고, 무작위 맵과 점 1,000개에서 F.grid_sample 과 대조하는 코드이다.
def bilinear_checks():
    """손계산 예와 F.grid_sample 대조."""
    print("[쌍선형 보간] 손계산 예: 3×3 특징 맵 (채널 1개)")
    feature = torch.tensor([[[1.0, 2.0, 4.0], [3.0, 5.0, 7.0], [6.0, 8.0, 9.0]]])  # (1, 3, 3)
    print(feature[0].numpy())
    point = torch.tensor([[0.60, 0.45]])  # (x, y)
    px, py = float(point[0, 0]) * 3 - 0.5, float(point[0, 1]) * 3 - 0.5
    x0, y0 = math.floor(px), math.floor(py)
    tx, ty = px - x0, py - y0
    print(f"점 (x, y) = (0.60, 0.45) → 눈금 좌표 px = 0.60·3 − 0.5 = {px:.2f}, py = 0.45·3 − 0.5 = {py:.2f}")
    print(f"왼쪽 위 이웃 (행 {y0}, 열 {x0}), tx = {tx:.2f}, ty = {ty:.2f}")
    total = 0.0
    for dy, dx, name in ((0, 0, "왼쪽 위"), (0, 1, "오른쪽 위"), (1, 0, "왼쪽 아래"), (1, 1, "오른쪽 아래")):
        weight = (tx if dx else 1 - tx) * (ty if dy else 1 - ty)
        value = float(feature[0, y0 + dy, x0 + dx])
        total += weight * value
        print(f"  {name:6s} (행 {y0 + dy}, 열 {x0 + dx}) 값 {value:.0f} × 가중치 {weight:.4f} = {weight * value:.4f}")
    print(f"  합 = {total:.4f},  bilinear_sample = {float(bilinear_sample(feature, point)):.4f},  "
          f"F.grid_sample = {float(F.grid_sample(feature[None], 2 * point.view(1, 1, 1, 2) - 1, align_corners=False)):.4f}")
    corner = torch.tensor([[0.02, 0.02]])
    print(f"  모서리 근처 (0.02, 0.02): bilinear_sample = {float(bilinear_sample(feature, corner)):.4f} "
          "(맵 밖 이웃 셋은 0 으로 친다)")

    generator = torch.Generator().manual_seed(0)
    feature = torch.randn(8, 12, 9, generator=generator)
    points = torch.rand(1000, 2, generator=generator) * 1.2 - 0.1  # 일부는 맵 밖 (−0.1 – 1.1)
    mine = bilinear_sample(feature, points)
    reference = F.grid_sample(feature[None], 2 * points.view(1, 1, -1, 2) - 1, mode="bilinear",
                              padding_mode="zeros", align_corners=False)[0, :, 0].T
    print(f"check bilinear_sample vs F.grid_sample (8×12×9 맵, 점 1000개, 맵 밖 포함): "
          f"최대 차이 {float((mine - reference).abs().max()):.2e}")
[쌍선형 보간] 손계산 예: 3×3 특징 맵 (채널 1개)
[[1. 2. 4.]
 [3. 5. 7.]
 [6. 8. 9.]]
점 (x, y) = (0.60, 0.45) → 눈금 좌표 px = 0.60·3 − 0.5 = 1.30, py = 0.45·3 − 0.5 = 0.85
왼쪽 위 이웃 (행 0, 열 1), tx = 0.30, ty = 0.85
  왼쪽 위   (행 0, 열 1) 값 2 × 가중치 0.1050 = 0.2100
  오른쪽 위  (행 0, 열 2) 값 4 × 가중치 0.0450 = 0.1800
  왼쪽 아래  (행 1, 열 1) 값 5 × 가중치 0.5950 = 2.9750
  오른쪽 아래 (행 1, 열 2) 값 7 × 가중치 0.2550 = 1.7850
  합 = 5.1500,  bilinear_sample = 5.1500,  F.grid_sample = 5.1500
  모서리 근처 (0.02, 0.02): bilinear_sample = 0.3136 (맵 밖 이웃 셋은 0 으로 친다)
check bilinear_sample vs F.grid_sample (8×12×9 맵, 점 1000개, 맵 밖 포함): 최대 차이 1.73e-06
손계산 5.1500, 직접 만든 함수, PyTorch 내장 함수가 모두 같다. 무작위 대조의 최대 차이 \(1.73 \times 10^{-6}\) 은 32비트 실수의 반올림 오차 크기이다. 모서리 근처의 점 \((0.02, 0.02)\) 도 손으로 확인할 수 있다. \(u_x = u_y = 0.02 \times 3 - 0.5 = -0.44\) 이므로 \(c_0 = r_0 = \lfloor -0.44 \rfloor = -1\), \(t_x = t_y = -0.44 - (-1) = 0.56\) 이다. 네 이웃 가운데 맵 안에 있는 것은 오른쪽 아래 이웃인 (행 0, 열 0)뿐이고, 그 가중치는 \(t_x t_y = 0.56 \times 0.56 = 0.3136\), 값은 1 이므로 결과가 \(0.3136\) 이다. (행 0, 열 0)의 값 1 이 그대로 나오지 않고 0 쪽으로 옅어졌다.
표본 위치로 미분할 수 있다
이제 둘째 물음이다. 오프셋에는 "여기를 봐야 한다" 는 정답이 없다. 학습 신호는 맨 끝의 탐지 손실뿐이다. 손실에서 오프셋까지 기울기가 흘러가려면(역전파, 4장) 그 사이의 모든 연산이 미분 가능해야 하고, 그 가운데 하나가 "표본점에서 값을 읽기" 이다. 물어야 할 것은 이것이다. 표본점을 조금 옮기면 읽은 값이 얼마나 변하는가?
- 읽은 값을 표본 위치로 미분하기
- \(v = (1 - t_x)(1 - t_y)\,v_{00} + t_x(1 - t_y)\,v_{01} + (1 - t_x)\,t_y\,v_{10} + t_x\,t_y\,v_{11}\)
- 쌍선형 보간의 식이다. 표본점이 네 이웃이 만드는 사각형 안에서 움직이는 동안 \(v_{00}, \dots, v_{11}\) 은 바뀌지 않고, \(t_x, t_y\) 만 바뀐다.
- \(t_x\) 로 미분했다. \((1 - t_x)\) 의 미분은 \(-1\), \(t_x\) 의 미분은 \(1\) 이고, \(t_y\) 가 든 인자는 상수로 남는다.
- \((1 - t_y)\) 와 \(t_y\) 로 묶었다. \(v_{01} - v_{00}\) 은 윗줄의 가로 기울기(오른쪽 값 − 왼쪽 값), \(v_{11} - v_{10}\) 은 아랫줄의 가로 기울기이다. 두 줄의 가로 기울기를 세로 위치로 보간한 값이다.
- \(t_y\) 로도 똑같이 미분했다. 왼쪽 줄의 세로 기울기(아래 값 − 위 값)와 오른쪽 줄의 세로 기울기를 가로 위치로 보간한 값이다.
- \(t_x = u_x - c_0 = xW - 0.5 - c_0\) 이다. 내림한 값 \(c_0\) 은 표본점이 같은 사각형 안에 있는 동안 변하지 않는 상수이므로 미분하면 사라진다. 정규화 좌표가 1 변하면 칸 눈금은 \(W\) 칸 변한다.
- 연쇄 법칙으로 두 미분을 곱했다. 읽은 값의 표본 위치에 대한 기울기는 이웃 칸끼리의 값 차이 로 정해진다. 이웃한 칸의 값이 서로 다르기만 하면 0 이 아니다.
손계산 예의 숫자를 넣는다. \(v_{00} = 2,\ v_{01} = 4,\ v_{10} = 5,\ v_{11} = 7\), \(t_x = 0.30\), \(t_y = 0.85\), \(W = H = 3\) 이다.
- 기울기 손계산과 검산
- \(\frac{\partial v}{\partial x} = 3 \times \big[0.15 \times (4 - 2) + 0.85 \times (7 - 5)\big] = 3 \times (0.30 + 1.70) = 6\)
- 윗줄 · 아랫줄 모두 오른쪽 값이 2 만큼 크므로 가로 기울기는 칸당 2, 정규화 좌표로는 그 3배이다.
- 왼쪽 줄 · 오른쪽 줄 모두 아래 값이 3 만큼 크므로 세로 기울기는 칸당 3, 정규화 좌표로는 9 이다.
- 표본점을 실제로 0.01 씩 옮겨 다시 보간한 값이다. 예를 들어 \(x = 0.61\) 이면 \(t_x = 0.33\) 이고 \(0.15 \times (0.67 \times 2 + 0.33 \times 4) + 0.85 \times (0.67 \times 5 + 0.33 \times 7) = 0.15 \times 2.66 + 0.85 \times 5.66 = 5.21\). 기울기가 예고한 만큼 정확히 변했다. PyTorch 의 자동 미분으로
bilinear_sample을 미분해도 \((6, 9)\) 가 나온다.
이 결과가 변형 어텐션의 학습을 떠받친다. 세 가지를 짚어 둔다.
- 오프셋은 정답 없이 배운다. 손실이 "이 표본점에서 읽은 값이 더 커지면 좋겠다" 고 하면, 위의 기울기가 "그러려면 오른쪽 아래로 가라" 고 방향을 알려 준다. 표본점의 위치는 기준점 + 오프셋이고 오프셋은 선형 층의 출력이므로, 기울기는 그 선형 층의 가중치까지 흘러간다.
- 기울기는 네 이웃만 본다. 식에 나오는 값은 \(v_{00}, \dots, v_{11}\) 넷뿐이다. 표본점은 바로 둘레의 비탈만 느끼고, 세 칸 떨어진 곳에 무엇이 있는지는 모른다. 표본점을 하나가 아니라 여러 개, 여러 방향 · 여러 해상도에 뿌려 두는 까닭을 여기서 짐작할 수 있다.
- 값은 이어지지만 기울기는 칸의 중심선에서 꺾인다. 표본점이 이웃 사각형의 경계(\(t_x\) 가 1 에 닿는 곳)를 넘으면 네 이웃이 바뀐다. 경계 위에서는 두 사각형이 같은 값을 주므로 읽은 값은 끊기지 않지만, 기울기는 달라질 수 있다. ReLU 가 0 에서 꺾이는 것과 같은 종류의 꺾임이고, 학습에는 지장이 없다.
읽은 값은 네 이웃의 값 으로도 미분된다. \(\partial v / \partial v_{00} = (1 - t_x)(1 - t_y)\), 곧 그 이웃의 가중치이다. 그래서 기울기는 표본점 쪽(오프셋을 내는 선형 층)과 특징 맵 쪽(백본) 양쪽으로 흐른다.
변형 어텐션의 식
쌍선형 보간으로 "특징 맵 \(X\) 를 아무 점 \(p\) 에서 읽은 값 \(X(p)\)" 를 쓸 수 있게 되었다. \(X\) 의 칸마다 길이 \(D\) 의 벡터가 있으므로 \(X(p)\) 도 길이 \(D\) 의 벡터이다(채널마다 같은 가중치로 보간한다). 이제 셋째 물음, 오프셋과 가중치를 누가 정하는가를 식으로 본다.
단일 스케일 식 읽기
특징 맵이 한 장일 때의 변형 어텐션은 논문의 식 (2)이다. 이 장의 표기로 옮기면 다음과 같다.
\(\operatorname{DeformAttn}(z_q,\ p_q,\ X) = \sum_{m=1}^{M} W^O_m \Big[ \sum_{k=1}^{K} A_{mqk} \cdot W^V_m\, X(p_q + \Delta p_{mqk}) \Big]\)
글자를 하나씩 읽는다.
- \(q\): 질의의 번호. \(z_q \in \mathbb{R}^{D}\) 는 그 질의의 벡터("제트 큐")이다. 디코더에서는 객체 질의의 내용에 위치 임베딩을 더한 것이다.
- \(p_q\): 질의 \(q\) 의 기준점(2차원).
- \(m\): 머리의 번호, \(M\): 머리의 수. \(k\): 표본점의 번호, \(K\): 머리 하나가 읽는 표본점의 수. 논문의 기본값은 \(M = 8\), \(K = 4\) 이다.
- \(\Delta p_{mqk} \in \mathbb{R}^2\): 질의 \(q\) 의 머리 \(m\) 이 쓰는 \(k\) 번째 오프셋("델타 피"). 범위에 제한이 없는 실수 둘이다.
- \(X(p_q + \Delta p_{mqk})\): 기준점에 오프셋을 더한 표본점에서, 쌍선형 보간으로 읽은 특징 벡터.
- \(W^V_m \in \mathbb{R}^{(D/M) \times D}\): 머리 \(m\) 의 값 투영. 읽은 벡터를 길이 \(D/M\) 로 줄인다. 5장의 다중 머리 어텐션에서 값을 만들던 투영과 같은 역할이다.
- \(A_{mqk}\): 어텐션 가중치. 0 과 1 사이의 숫자이고, 머리마다 표본점 \(K\) 개에 걸쳐 합이 1 이다(\(\sum_{k=1}^{K} A_{mqk} = 1\)).
- \(W^O_m \in \mathbb{R}^{D \times (D/M)}\): 머리 \(m\) 의 출력 투영. 머리의 결과를 다시 길이 \(D\) 로 늘려, 머리 \(M\) 개의 것을 모두 더한다. 머리들의 결과를 이어 붙여 선형 층 하나(
output_proj)를 거치는 것과 같은 계산이다.
대괄호 안은 5장에서 본 어텐션의 마지막 단계와 꼴이 같다. 값 벡터들의 가중 평균 이다. 달라진 것은 두 가지이다. 값을 가져오는 자리가 "모든 토큰" 이 아니라 "표본점 \(K\) 개" 이고, 가중치 \(A\) 가 내적에서 나오지 않는다. 그러면 \(\Delta p\) 와 \(A\) 는 어디서 올까? 논문의 답은 간단하다. 둘 다 질의 벡터 \(z_q\) 에 선형 층을 한 번 적용해 얻는다.
\(\Delta p_{mqk} = \big[\operatorname{Linear}_{\Delta}(z_q)\big]_{mk} \in \mathbb{R}^2, \qquad A_{mqk} = \frac{\exp(a_{mqk})}{\sum_{k'=1}^{K} \exp(a_{mqk'})}, \quad a_{mqk} = \big[\operatorname{Linear}_{A}(z_q)\big]_{mk}\)
\(\operatorname{Linear}_{\Delta}\) 는 길이 \(D\) 의 벡터를 숫자 \(2MK\) 개로 바꾸는 선형 층이다(머리 \(M\) × 표본점 \(K\) × 좌표 2). 대괄호 뒤의 첨자 \(mk\) 는 그 출력에서 머리 \(m\), 표본점 \(k\) 의 몫을 꺼낸다는 뜻이다. \(\operatorname{Linear}_{A}\) 는 숫자 \(MK\) 개를 내고, 그 로짓 \(a_{mqk}\) 를 머리마다 소프트맥스에 넣어 가중치를 만든다. 논문은 이 둘을 출력 \(3MK\) 개짜리 선형 층 하나로 적고, 공개 코드는 sampling_offsets 와 attention_weights 두 층으로 나눠 둔다.
- 핵심: 묻고 고르지 않고, 예측한다
- 보통 어텐션은 질의가 모든 열쇠에게 "너는 나와 얼마나 맞느냐" 고 물어서(내적) 가중치를 정한다. 변형 어텐션은 질의가 그림을 보기 전에, 자기 벡터만으로 "어디를(오프셋) 얼마나(가중치) 볼지" 를 정해 버린다. 열쇠가 없다. 그림의 내용은 표본점에서 읽어 온 값을 통해서만 들어온다.
그림을 보기 전에 정한다면 그림에 맞춰 볼 곳을 바꿀 수 없을 것 같지만, 디코더는 층이 여럿이다. 첫 층에서 읽어 온 값이 질의 벡터에 더해지고, 둘째 층은 그 벡터로 오프셋과 가중치를 다시 예측한다. 한 층 안에서는 "보고 나서 고르기" 를 못 하지만, 층을 거듭하며 "본 것에 따라 다음에 볼 곳을 정하기" 를 한다. 이 장의 1단계 모델에서 첫 디코더 층의 질의 벡터는 학습된 상수라서, 첫 층의 표본점과 가중치는 어떤 그림이 들어와도 같다(학습한 모델에서 임시 스크립트로 확인하면 그림 8장 사이의 차이가 정확히 0 이다). 둘째 층부터 그림마다 달라진다.
보통 어텐션과 무엇이 다른가
| 보통 교차 어텐션 (5 · 7장) | 변형 어텐션 | |
| 값을 읽는 자리 | 열쇠 · 값 토큰 전부(\(HW\) 개) | 기준점 둘레의 표본점 \(K\) 개(다중 스케일이면 \(LK\) 개), 머리마다 따로 |
| 자리를 정하는 것 | 정하지 않음(전부 읽음) | 기준점 \(p_q\) + 오프셋 \(\Delta p = \operatorname{Linear}_{\Delta}(z_q)\) |
| 가중치를 정하는 것 | 질의와 열쇠의 내적 → 소프트맥스 | \(\operatorname{Linear}_{A}(z_q)\) → 소프트맥스. 열쇠가 없음 |
| 가중치가 읽은 내용에 따라 달라지는가 | 그렇다(열쇠가 그 자리의 내용에서 나옴) | 아니다(질의만 봄) |
| 값을 읽는 방법 | 토큰을 그대로 | 칸 사이의 점을 쌍선형 보간으로 |
| 위치를 아는 방법 | 열쇠에 위치 인코딩을 더함 | 좌표로 직접 읽으므로 값에 위치 인코딩이 필요 없음 |
| 질의 하나가 읽는 값의 수 | \(HW\) (12×12 맵이면 144) | \(M \cdot L \cdot K\) (이 장의 모델은 8 · 2 · 2 = 32) |
| 학습을 시작할 때 | \(HW\) 칸에 거의 고르게(\(\approx 1/HW\)) | 기준점 바로 둘레의 표본점들에 고르게(\(1/LK\)) |
| 학습되는 층 | 질의 · 열쇠 · 값 · 출력 투영 | 오프셋 · 가중치 예측, 값 · 출력 투영 |
"학습을 시작할 때" 줄이 논문의 첫째 진단과 이어진다. 변형 어텐션도 처음에는 가중치가 고르지만, 그 대상이 그림 전체가 아니라 기준점 가까이의 몇 점 이다. 처음부터 좁은 곳을 보고 시작하는 셈이다. 논문은 모든 가능한 자리를 표본점으로 삼으면 변형 어텐션이 보통 어텐션과 같아진다고 적고, 변형 어텐션을 "표본 위치로 미리 걸러 내는" 효율적인 어텐션으로 볼 수 있다고 설명한다.
- 투영하고 읽기와 읽고 투영하기는 같다
- 식은 "표본점에서 읽은 뒤 \(W^V_m\) 을 곱한다" 고 적혀 있지만, 코드는 먼저 특징 맵 전체에 값 투영을 하고 그 결과를 표본점에서 읽는다. 결과는 같다. 쌍선형 보간은 네 이웃의 가중합이고, 행렬을 곱하는 것은 선형 연산이기 때문이다: \(W(\omega_1 v_1 + \omega_2 v_2) = \omega_1 W v_1 + \omega_2 W v_2\). (\(\omega\) 는 보간 가중치이다.) 먼저 투영해 두면 질의가 몇 개든 값 투영을 한 번만 하면 된다.
손으로 따라가는 질의 하나
가장 작은 예로 식 전체를 한 번 계산한다. 특징 맵은 앞의 3×3 맵(채널 1개), 머리 1개(\(M = 1\)), 표본점 2개(\(K = 2\))이고, 값 투영과 출력 투영은 1 을 곱하는 것으로 둔다. 기준점은 \(p_q = (0.5, 0.5)\), 곧 맵의 한가운데이다. 선형 층이 다음 값을 냈다고 하자.
- 오프셋(단위: 칸): \(\Delta p_1 = (0.30,\ -0.15)\), \(\Delta p_2 = (-0.75,\ 0.75)\)
- 가중치의 로짓: \(a_1 = 0\), \(a_2 = 1.0986\) (\(= \log 3\))
- 변형 어텐션 한 번 (머리 1개, 표본점 2개)
- \(p_q + \frac{\Delta p_1}{3} = (0.5 + 0.10,\ 0.5 - 0.05) = (0.60,\ 0.45), \qquad p_q + \frac{\Delta p_2}{3} = (0.5 - 0.25,\ 0.5 + 0.25) = (0.25,\ 0.75)\)
- 표본점의 정규화 좌표이다. 오프셋의 단위가 "칸" 이므로 맵의 한 변 3 으로 나눠 정규화 좌표로 바꾼 뒤 기준점에 더했다(단위는 바로 뒤에서 자세히 본다).
- 첫 표본점에서 읽은 값. 앞의 손계산 예 그대로이다.
- 둘째 표본점. \(u_x = 0.25 \times 3 - 0.5 = 0.25\), \(u_y = 0.75 \times 3 - 0.5 = 1.75\) 이므로 왼쪽 위 이웃은 (행 1, 열 0), \(t_x = 0.25\), \(t_y = 0.75\) 이고, 네 이웃의 값은 3, 5, 6, 8 이다.
- 로짓을 소프트맥스에 넣었다. \(e^{1.0986} = 3\). 두 가중치의 합은 1 이다.
- 읽은 값 둘의 가중 평균이다. 맵의 9칸 가운데 이 질의가 건드린 것은 표본점 둘의 이웃 여덟 칸(겹치는 칸을 빼면 일곱 칸)뿐이고, 맵이 100×100 이어도 여덟 칸이다.
다중 스케일 식
해상도가 다른 특징 맵 여러 장을 함께 읽도록 넓힌 것이 논문의 식 (3)이다. 해상도가 다른 맵 한 장 한 장을 특징 레벨(feature level) 이라 하고, 레벨 \(l\) 의 맵을 \(X^l\)(크기 \(H_l \times W_l\))이라고 쓴다.
\(\operatorname{MSDeformAttn}\big(z_q,\ p_q,\ \{X^l\}\big) = \sum_{m=1}^{M} W^O_m \Big[ \sum_{l=0}^{L-1} \sum_{k=1}^{K} A_{mlqk} \cdot W^V_m\, X^l(p_{mlqk}) \Big], \qquad \sum_{l=0}^{L-1} \sum_{k=1}^{K} A_{mlqk} = 1\)
단일 스케일 식과 다른 곳은 세 군데이다.
- 오프셋과 가중치에 레벨 첨자 \(l\) 이 붙었다. 머리 하나가 레벨마다 \(K\) 개씩, 모두 \(LK\) 개의 표본점을 갖는다. 선형 층의 출력은 오프셋 \(2MLK\) 개, 가중치 로짓 \(MLK\) 개이다.
- 가중치는 \(L \cdot K\) 개 전체에 걸쳐 소프트맥스한다. 레벨마다 따로 합이 1 인 것이 아니다. 그래서 머리가 "이 질의는 촘촘한 레벨의 값을 더 믿겠다" 처럼 레벨 사이의 비중을 정할 수 있다.
- \(p_{mlqk}\) 는 레벨 \(l\) 에서의 표본점의 정규화 좌표이다. 기준점 \(p_q\) 는 정규화 좌표이므로 모든 레벨에 같은 점 을 쓴다. 정규화 좌표 \((0.3, 0.6)\) 은 12×12 맵에서도 6×6 맵에서도 그림의 같은 자리를 가리킨다. 논문은 정규화 좌표를 레벨 \(l\) 의 눈금으로 옮기는 함수를 \(\phi_l\) 로 적는다. 이 장에서는 그것이 앞에서 본 \(u_x = xW_l - 0.5\) 이다.
정규화 좌표를 쓰는 덕분에 레벨이 몇 개든 식의 꼴이 그대로이다. 논문의 기본값은 \(M = 8\), \(L = 4\), \(K = 4\) 로, 질의 하나가 한 번에 \(8 \times 4 \times 4 = 128\) 개의 값을 읽는다. 이 장의 모델은 \(M = 8\), \(L = 2\), \(K = 2\) 로 32개이다.
오프셋의 단위: 기준이 점일 때와 박스일 때
선형 층이 내는 오프셋 \(\Delta p = (\Delta p_x, \Delta p_y)\) 는 그냥 실수 둘이다. 이것을 정규화 좌표의 거리로 바꾸는 약속이 필요하고, 기준이 점이냐 박스냐에 따라 다르다. (아래 식에서는 첨자 \(mlqk\) 를 오프셋의 성분에서 생략했다.)
기준이 점 \(p_q = (p_x, p_y)\) 일 때: 오프셋의 단위는 "그 레벨의 칸" 이다.
\(p_{mlqk} = \Big( p_x + \frac{\Delta p_x}{W_l},\ \ p_y + \frac{\Delta p_y}{H_l} \Big)\)
오프셋 \((1, 0)\) 은 "오른쪽으로 한 칸" 이다. 12×12 레벨에서는 정규화 거리 \(1/12 = 0.0833\), 6×6 레벨에서는 \(1/6 = 0.1667\) 이다. 같은 숫자의 오프셋이 거친 레벨에서는 두 배 먼 곳을 가리킨다. 거친 레벨일수록 넓게 보는 셈이다.
기준이 박스 \(b_q = (c_x, c_y, w, h)\) 일 때: 오프셋의 단위는 "박스 절반 크기의 \(1/K\)" 이다.
\(p_{mlqk} = \Big( c_x + \frac{\Delta p_x}{K} \cdot \frac{w}{2},\ \ c_y + \frac{\Delta p_y}{K} \cdot \frac{h}{2} \Big)\)
박스의 중심에서 출발하고, 오프셋에 박스의 너비 · 높이가 곱해진다. 큰 박스를 맡은 질의는 넓게, 작은 박스를 맡은 질의는 좁게 본다. 레벨의 크기 \(W_l, H_l\) 은 식에 나오지 않는다. 오프셋이 \((K, K)\) 이면 표본점이 \((c_x + w/2,\ c_y + h/2)\), 곧 박스의 오른쪽 아래 꼭짓점이다.
- 논문의 표기와 공개 코드
- 논문 부록 A.4 는 기준이 박스일 때 오프셋을 \((\Delta p_x \cdot w,\ \Delta p_y \cdot h)\) 로 "박스 크기로 조절한다" 고 적고, 오프셋 예측 층의 편향 초기값 에 \(1/(2K)\) 을 곱해 처음 표본점이 모두 박스 안에 들게 한다고 설명한다. 공개 코드(RF-DETR 의
ms_deform_attn.py도 같다)는 편향은 그대로 두고 순전파 때마다offsets / n_points * 박스의 (w, h) * 0.5를 계산한다. 위의 식이 이 코드이다. 초기화 직후의 표본점은 두 방식이 같다. 이 장의 구현은 공개 코드를 따랐다.
처음에는 어디를 보는가
오프셋을 내는 선형 층을 보통의 난수로 초기화하면 표본점이 처음부터 제멋대로 흩어진다. 논문(부록 A.4)과 공개 코드는 이 층을 특별하게 초기화한다.
- 오프셋 층의 가중치는 0. 처음에는 질의 벡터가 무엇이든 오프셋이 편향 그대로이다. 모든 질의가 같은 무늬로 표본점을 찍는다.
- 오프셋 층의 편향은 "머리마다 다른 방향, \(k\) 번째 점은 \(k\) 칸". 머리 번호를 0 부터 세어 \(m\) 이라 하면, 머리 \(m\) 은 각도 \(2\pi m / M\) 방향을 맡는다. 방향 벡터 \((\cos, \sin)\) 을 두 성분의 절댓값 가운데 큰 쪽으로 나눠, 성분이 \(-1, 0, 1\) 인 여덟 방향으로 만든다. 예를 들어 머리 1 은 45° 방향 \((0.707, 0.707)\) 을 \(0.707\) 로 나눈 \((1, 1)\) 이다. \(k\) 번째 표본점의 편향은 이 방향의 \(k\) 배이다. (\(M\) 이 8 이 아니면 정확히 여덟 방향이 되지는 않는다.)
- 가중치 층은 가중치도 편향도 0. 로짓이 모두 0 이므로 소프트맥스를 거치면 모든 표본점의 가중치가 \(1/(LK)\) 로 같다.
- 값 투영과 출력 투영은 보통의 무작위 초기화(Xavier)이다.
코드가 출력한 편향의 초기값이다(\(M = 8\), \(K = 2\), 단위는 칸).
오프셋 편향의 초기값 (머리 8개 × 표본점 2개, 단위: 칸):
  머리 0: k=1 (+1, +0)   k=2 (+2, +0)
  머리 1: k=1 (+1, +1)   k=2 (+2, +2)
  머리 2: k=1 (-0, +1)   k=2 (-0, +2)
  머리 3: k=1 (-1, +1)   k=2 (-2, +2)
  머리 4: k=1 (-1, -0)   k=2 (-2, -0)
  머리 5: k=1 (-1, -1)   k=2 (-2, -2)
  머리 6: k=1 (+0, -1)   k=2 (+0, -2)
  머리 7: k=1 (+1, -1)   k=2 (+2, -2)
여덟 머리가 오른쪽, 오른쪽 아래, 아래, 왼쪽 아래 … 로 한 바퀴를 돈다(\(y\) 는 아래로 갈수록 커지므로 \((+1, +1)\) 이 오른쪽 아래이다). -0 은 \(\cos 90^\circ\) 같은 값이 부동소수 계산에서 아주 작은 음수로 나온 것으로, 0 과 같다. 논문은 여덟 방향을 \((-k, -k), (-k, 0), \dots, (k, k)\) 순서로 적는데, 코드는 \((k, 0)\) 에서 시작해 도는 순서이다. 여덟 방향의 집합은 같다.
- 그림: 그림 8-3 초기화 직후의 표본점(머리 8개 × 표본점 2개, 12×12 맵 한 레벨, 기준 \((0.5, 0.5)\)). 주황 별이 기준점, 동그라미가 \(k = 1\), 네모가 \(k = 2\) 인 표본점이고 회색 격자는 칸의 경계이다. \(y\) 축은 아래로 증가한다. 왼쪽은 기준이 점, 오른쪽은 기준이 너비 0.5 · 높이 0.3 인 박스(주황 테두리)이다.
- 초기화 직후의 표본점 무늬. 왼쪽은 기준이 점일 때 기준점 둘레 한 칸과 두 칸 거리의 여덟 방향, 오른쪽은 기준이 박스일 때 박스 안쪽과 박스 테두리 위의 여덟 방향.
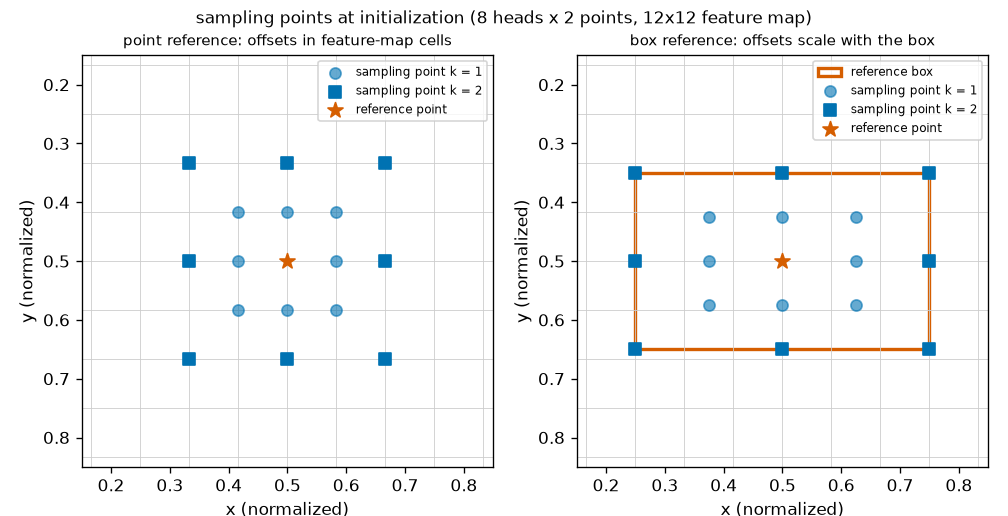
그림 8-3 을 식으로 확인한다.
- 왼쪽(기준이 점). \(k = 1\) 의 표본점은 기준점에서 한 칸, 곧 \(1/12 = 0.0833\) 떨어져 있다. \(0.5 \pm 0.0833\) 이므로 \(0.4167\) 과 \(0.5833\) 에 찍힌다. \(k = 2\) 는 두 칸 \(= 0.1667\) 떨어진 \(0.3333\) 과 \(0.6667\) 이다. 기준점 둘레의 5×5 칸 영역을 여덟 방향으로 고르게 덮는다.
- 오른쪽(기준이 박스). \(k = 1\) 의 오프셋 \((1, 1)\) 은 \(\big(\tfrac{1}{2} \cdot \tfrac{0.5}{2},\ \tfrac{1}{2} \cdot \tfrac{0.3}{2}\big) = (0.125,\ 0.075)\) 이므로 표본점이 \((0.625, 0.575)\) 이다. \(k = 2\) 의 오프셋 \((2, 2)\) 는 \(\big(\tfrac{2}{2} \cdot 0.25,\ \tfrac{2}{2} \cdot 0.15\big) = (0.25,\ 0.15)\) 이므로 표본점이 \((0.75, 0.65)\), 박스의 오른쪽 아래 꼭짓점이다. \(k = K\) 인 표본점은 박스의 테두리 위에, 나머지는 박스 안에 놓인다. 가로로 긴 박스이므로 무늬도 가로로 길어졌다.
이 초기화가 하는 일은 "아직 아무것도 모를 때는 기준 둘레를 골고루 본다" 이다. 학습이 진행되면 오프셋 층의 가중치가 0 에서 벗어나고, 질의마다 · 그림마다 무늬가 달라진다. 학습 뒤의 모습은 이 장 끝의 그림 8-9 에 있다.
계산량: 읽는 자리 수와 실제 시간
"필요한 곳만 본다" 가 얼마나 싼지 세어 본다. 먼저 손으로 세고, 그다음 실제로 잰다. 미리 말해 두면, 둘은 다른 이야기를 한다.
연산 수 세기
가장 단순한 잣대는 교차 어텐션 한 번이 읽는 (질의, 자리) 쌍의 수 이다. 질의가 \(N_q\) 개일 때
- 보통 교차 어텐션: 질의마다 모든 칸 → \(N_q \times HW\)
- 변형 어텐션: 질의마다 표본점 \(M \cdot L \cdot K\) 개 → \(N_q \times MLK\)
뒤의 실측과 같은 설정(질의 100개, \(M = 8\), \(L = 1\), \(K = 2\))에서 특징 맵을 키워 가면 다음과 같다. 변형 어텐션은 \(100 \times 8 \times 1 \times 2 = 1{,}600\) 으로 일정하다.
| 특징 맵 | 칸 수 \(HW\) | 보통: \(N_q \times HW\) | 변형: \(N_q \times MLK\) | 비 |
| 12×12 | 144 | 14,400 | 1,600 | 9배 |
| 24×24 | 576 | 57,600 | 1,600 | 36배 |
| 48×48 | 2,304 | 230,400 | 1,600 | 144배 |
| 96×96 | 9,216 | 921,600 | 1,600 | 576배 |
| 192×192 | 36,864 | 3,686,400 | 1,600 | 2,304배 |
실제 모델의 크기로도 세어 본다. RF-DETR Nano 는 해상도 384 · 패치 16 이므로 특징 맵이 24×24 = 576칸이고, 질의 300개, 디코더 교차 어텐션의 머리 16개 · 표본점 2개 · 레벨 1개이다(공개 코드의 설정). 보통 교차 어텐션이라면 \(300 \times 576 = 172{,}800\) 쌍, 변형 어텐션은 \(300 \times 16 \times 1 \times 2 = 9{,}600\) 쌍으로 18분의 1 이다.
그런데 "읽는 자리 수" 는 비용의 일부일 뿐이다. 곱셈 횟수를 부분별로 어림하면 그림이 달라진다. 편향 · 소프트맥스 같은 작은 항은 빼고 센다.
- 곱셈 횟수 어림: 질의 100개, D = 128, 12×12 맵 (HW = 144)
- \(\text{보통: 질의 · 출력 투영} = 2 \times N_q D^2 = 2 \times 100 \times 128^2 = 3{,}276{,}800\)
- 길이 \(D\) 의 벡터에 \(D \times D\) 행렬을 곱하면 곱셈이 \(D^2 = 16{,}384\) 번이다. 질의 100개에 질의 투영 한 번, 출력 투영 한 번.
- 칸 144개 모두에 열쇠 투영과 값 투영을 한다. 질의 수와 무관하고 칸 수에 비례한다.
- (질의, 칸) 쌍마다 내적 한 번(머리들을 합쳐 곱셈 \(D\) 번), 값의 가중합에 또 \(D\) 번. 앞의 표가 센 14,400쌍에 \(2D\) 를 곱한 값이다.
- 질의마다 길이 \(D\) 의 벡터에서 숫자 \(2MLK + MLK = 3 \times 16 = 48\) 개를 내는 선형 층. 논문 부록 A.1 의 \(O(3N_qCMK)\) 항이다.
- 값 투영은 변형 어텐션에서도 모든 칸 에 한다(코드가 먼저 투영하고 읽기 때문이다). 열쇠가 없으므로 보통 어텐션의 절반이다.
- 표본점 하나를 읽는 데 네 이웃 × 채널 수만큼 곱하고(머리 \(M\) 개가 각각 \(D/M\) 채널을 읽으므로 머리를 합치면 표본점 \(LK\) 개에 \(4D\)), 가중합에 \(D\) 를 더 쓴다. 논문 A.1 의 \(5N_qKC\) 항이고, 표가 센 1,600쌍에 해당하는 부분이다.
- 합계이다. 읽는 쌍의 수는 9배 차이지만 곱셈 횟수는 약 2.5배 차이이다. 투영처럼 두 방식에 다 있는 일이 큰 몫을 차지하기 때문이다.
같은 어림을 192×192 맵(\(HW = 36{,}864\))에 하면 칸 수에 비례하는 항만 256배가 된다.
| 항목 (곱셈 횟수 어림) | 12×12 | 192×192 | 칸 수에 따라 |
| 보통: 질의 · 출력 투영 | 3,276,800 | 3,276,800 | 일정 |
| 보통: 열쇠 · 값 투영 | 4,718,592 | 1,207,959,552 | 비례 |
| 보통: 점수와 가중합 | 3,686,400 | 943,718,400 | 비례 |
| 보통 합계 | 11,681,792 | 2,154,954,752 | |
| 변형: 오프셋 · 가중치 예측 | 614,400 | 614,400 | 일정 |
| 변형: 값 투영 | 2,359,296 | 603,979,776 | 비례 |
| 변형: 출력 투영 | 1,638,400 | 1,638,400 | 일정 |
| 변형: 보간과 가중합 | 128,000 | 128,000 | 일정 |
| 변형 합계 | 4,740,096 | 606,360,576 |
192×192 에서 두 합계의 비는 약 3.6배이다. "2,304배" 가 아니다. 변형 어텐션에서 칸 수와 무관해진 것은 질의가 값을 읽는 부분 이고, 특징 맵 전체에 값 투영을 하는 일은 그대로 남아 있다. 논문도 이것을 식에 담아 둔다. 보통 어텐션의 복잡도를 \(O(N_qC^2 + N_kC^2 + N_qN_kC)\) 로, 변형 어텐션을 \(O(2N_qC^2 + \min(HWC^2,\ N_qKC^2))\) 로 적는다(\(C\) 는 이 장의 \(D\), \(N_k\) 는 열쇠 수 \(HW\)). \(\min\) 의 첫 항이 "먼저 전체를 투영" 하는 방식, 둘째 항이 "읽은 값만 투영" 하는 방식의 비용이다. 둘째 방식을 쓰면 칸 수와 완전히 무관해진다. 논문이 디코더의 변형 교차 어텐션을 두고 "복잡도가 공간 크기 \(HW\) 와 무관한 \(O(NKC^2)\)" 라고 말하는 것은 이 둘째 방식을 가리킨다. 공개 코드와 이 장의 구현은 첫째 방식이다.
재 본 시간
손으로 센 것이 실제 시간과 맞는지 잰다. nn.MultiheadAttention(보통 교차 어텐션)과 이 장의 MSDeformAttn 에 같은 크기의 입력을 주고, 순전파 한 번의 시간을 여러 번 재어(앞의 10번은 버리고 50번) 최솟값을 낸다.
@torch.no_grad()
def complexity_table(device, sizes=(12, 24, 48, 96, 192), num_queries=100, dim=128, heads=8, points=2, batch=2,
                     repeats=50):
    """교차 어텐션 한 번의 "읽는 자리 수" 와 걸린 시간. 특징 맵 한 변을 키워 가며 잰다 (단일 레벨, L = 1)."""
    standard = nn.MultiheadAttention(dim, heads, batch_first=True).to(device).eval()
    deform = MSDeformAttn(dim, n_levels=1, n_heads=heads, n_points=points).to(device).eval()

    def clock(fn):
        times = []
        for _ in range(repeats + 10):
            start = time.perf_counter()
            fn()
            if device == "cuda":
                torch.cuda.synchronize()
            times.append(time.perf_counter() - start)
        return float(np.min(times[10:])) * 1000  # 처음 10번은 준비 운동으로 버리고 최솟값 (ms): 다른 일에 덜 흔들린다

    rows = []
    print(f"[계산량] 질의 {num_queries}개, 머리 M = {heads}, 레벨 L = 1, 표본점 K = {points}, D = {dim}, 배치 {batch}")
    print("특징 맵 | 토큰 HW | 보통: 질의×토큰 | 변형: 질의×M·L·K |  비   | 보통 ms | 변형 ms")
    for side in sizes:
        tokens = side * side
        memory = torch.randn(batch, tokens, dim, device=device)
        query = torch.randn(batch, num_queries, dim, device=device)
        reference = torch.rand(batch, num_queries, 1, 2, device=device)
        ms_standard = clock(lambda: standard(query, memory, memory, need_weights=False))
        ms_deform = clock(lambda: deform(query, reference, memory, [(side, side)]))
        pairs_standard, pairs_deform = num_queries * tokens, num_queries * heads * points
        rows.append((side, tokens, pairs_standard, pairs_deform, ms_standard, ms_deform))
        print(f"{side:3d}×{side:<3d} | {tokens:7d} | {pairs_standard:13,d} | {pairs_deform:14,d} | "
              f"{pairs_standard / pairs_deform:5.1f} | {ms_standard:7.2f} | {ms_deform:7.2f}")
    return rows
[계산량] 질의 100개, 머리 M = 8, 레벨 L = 1, 표본점 K = 2, D = 128, 배치 2
특징 맵 | 토큰 HW | 보통: 질의×토큰 | 변형: 질의×M·L·K |  비   | 보통 ms | 변형 ms
 12×12  |     144 |        14,400 |          1,600 |   9.0 |    2.69 |    7.06
 24×24  |     576 |        57,600 |          1,600 |  36.0 |    3.19 |    7.23
 48×48  |    2304 |       230,400 |          1,600 | 144.0 |    2.96 |    7.19
 96×96  |    9216 |       921,600 |          1,600 | 576.0 |    4.53 |    7.24
192×192 |   36864 |     3,686,400 |          1,600 | 2304.0 |   23.57 |    8.07
- 그림: 그림 8-4 교차 어텐션 한 번이 읽는 (질의, 자리) 쌍의 수(왼쪽)와 잰 시간(오른쪽). 가로축은 특징 맵의 크기, 두 축 모두 로그 눈금이다. 주황 실선이 보통 교차 어텐션, 파랑 점선이 변형 어텐션이다.
- 왼쪽: 특징 맵이 커질수록 보통 교차 어텐션이 읽는 쌍의 수는 비례해 늘고 변형 어텐션은 1,600 으로 일정하다. 오른쪽: 잰 시간. 변형 어텐션은 7에서 8 밀리초로 거의 일정하고, 보통 어텐션은 작은 맵에서 3 밀리초쯤이다가 192×192 에서 24 밀리초로 뛰어 변형 어텐션을 넘는다.
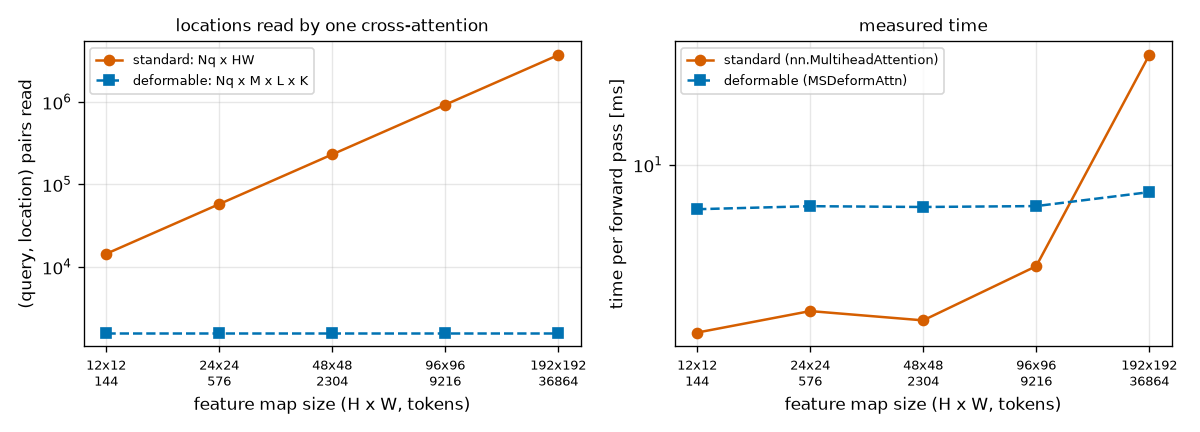
그림 8-4 와 표에서 읽을 것은 세 가지이다.
- 변형 어텐션의 시간은 맵 크기에 거의 무관하다. 칸 수가 256배(144 → 36,864)가 되는 동안 7.06 ms 에서 8.07 ms 로 늘었을 뿐이다. 완전히 일정하지 않은 것은 앞에서 센 대로 값 투영이 칸 수에 비례하기 때문일 것이다.
- 작은 맵에서는 변형 어텐션이 오히려 느리다. 12×12 에서 보통 2.69 ms, 변형 7.06 ms 로 변형 어텐션이 2.6배 느리다. 곱셈 횟수는 변형 쪽이 적은데도 그렇다. 이 튜토리얼의 도형 세상(12×12 맵)에서 변형 어텐션은 속도 이득을 주지 않는다.
- 큰 맵에서 뒤집힌다. 보통 어텐션은 96×96 부터 눈에 띄게 늘어 192×192 에서 23.57 ms 가 되고, 변형 어텐션(8.07 ms)의 2.9배가 된다. 이 측정에서는 96×96 과 192×192 사이에서 순서가 바뀌었다.
작은 맵에서 느린 까닭을 이 실험은 따로 재지 않았다. 가능한 설명은 고정 비용 이다. 이렇게 작은 계산에서는 곱셈 횟수보다 "연산을 몇 번 부르는가" 가 시간을 정한다. nn.MultiheadAttention 은 잘 다듬어진 연산 몇 번으로 끝나지만, MSDeformAttn 은 선형 층 넷, 소프트맥스, 모양 바꾸기 여러 번, 그리고 레벨마다 F.grid_sample 을 거친다. grid_sample 은 표본점마다 메모리의 흩어진 자리를 읽는 연산이기도 하다. 논문도 변형 어텐션이 "순서 없는 메모리 접근" 이라는 값을 치른다고 적는다(5.1절).
- 주의: 이 시간은 참고용이다
- 이 측정은 다른 작업과 GPU 를 나눠 쓰는 노트북에서 잰 최솟값이다. "작은 맵에서는 변형이 느리고 큰 맵에서 뒤집힌다" 는 방향은 여러 번의 실행에서 같았지만, 뒤집히는 지점과 절대값은 실행 조건에 따라 달랐다. 여러분의 장치에서는 숫자가 다를 것이다. 실제 모델의 속도는 14장처럼 모델 전체를 내보낸 뒤에 재야 한다.
그러면 변형 어텐션의 값어치는 어디에 있을까? 논문의 표 1 이 실마리를 준다. Deformable DETR 은 스트라이드 8 부터의 다중 스케일 특징을 쓰면서 초당 19장을 처리하고, 고해상도 특징을 쓰는 DETR-DC5 는 12장이다. 한편 특징 맵 한 장만 쓰는 원래의 DETR 은 28장으로 Deformable DETR 보다 빠르다. 변형 어텐션은 "같은 맵에서 더 빠르게" 가 아니라 "큰 맵 · 여러 맵을 감당할 수 있게" 해 주는 부품이다.
다중 스케일 특징
왜 여러 해상도인가
특징 맵의 해상도에는 맞바꿈이 있다. 촘촘한 맵(스트라이드가 작은 맵)은 작은 객체의 위치를 정확히 담지만 한 칸이 보는 범위가 좁고 칸 수가 많다. 거친 맵은 한 칸이 넓은 범위를 요약해 큰 객체를 한눈에 담지만, 작은 객체는 한 칸 속에 묻힌다. 해상도가 다른 맵을 여러 장 함께 쓰는 것이 다중 스케일 특징(multi-scale features) 이다.
Deformable DETR 은 레벨 넷(\(L = 4\))을 쓴다. ResNet 백본의 세 단계 출력(스트라이드 8, 16, 32)에 1×1 합성곱을 적용한 것 셋과, 마지막 단계 출력에 3×3 스트라이드 2 합성곱을 한 번 더 한 것(스트라이드 64)이다. 모두 256 채널로 맞춘다. 논문의 절제 실험(표 2)에서 단일 스케일 입력을 다중 스케일 입력으로 바꾸자 AP 가 1.7, 작은 객체의 AP 가 2.9 올랐다(COCO, \(K = 1\) 일 때 39.7 → 41.4, 작은 객체 21.2 → 24.1).
변형 어텐션에서 레벨을 늘리는 값은 싸다. 질의 하나가 읽는 값이 \(MK\) 개에서 \(MLK\) 개로 늘 뿐이고, 기준점은 정규화 좌표라 모든 레벨에 그대로 쓴다. 보통 어텐션이었다면 네 레벨의 칸을 모두 이어 붙인 만큼(가장 촘촘한 레벨의 약 1.33배) 열쇠가 늘고, 인코더의 자기 어텐션은 그 제곱으로 늘었을 것이다.
이 장의 두 레벨과 RF-DETR 의 한 레벨
이 장의 미니 모델은 레벨 둘을 쓴다.
- 레벨 0 (12×12, 스트라이드 8): 7장의 백본 출력에 1×1 합성곱.
- 레벨 1 (6×6, 스트라이드 16): 같은 백본 출력에 3×3 스트라이드 2 합성곱. Deformable DETR 이 가장 거친 레벨을 만드는 방식과 같다.
두 맵을 각각 토큰으로 펴서 이어 붙이면 \(144 + 36 = 180\) 개의 토큰이 된다. 텐서 모양은 (B, 180, D) 이고, 어디까지가 어느 레벨인지는 spatial_shapes = [(12, 12), (6, 6)] 로 따로 들고 다닌다. 변형 어텐션은 이 목록을 보고 토큰 묶음을 레벨별 맵 (D, H_l, W_l) 로 되돌린 뒤 표본점을 읽는다.
- RF-DETR 은 레벨이 하나다
- RF-DETR 의 Nano · Small · Medium 은 프로젝터가 스트라이드 16 의 특징 맵 한 장(공개 코드의
projector_scale=["P4"])만 디코더에 준다. 곧 \(L = 1\) 이다. 이름은 "다중 스케일 변형 어텐션" 이지만 실제로는 한 레벨에서 머리 16개가 표본점을 2개씩(ca_nheads=16,dec_n_points=2) 읽는다. ViT 백본의 여러 층 출력을 프로젝터가 한 장으로 합쳐 주는 구조는 9장과 10장에서 본다. 이 장의 실험에서도 레벨을 하나로 줄였을 때의 차이는 작았다(뒤의 절제 실험).
박스를 기준에서 고쳐 나가기
7장의 DETR 에서 박스 머리는 질의 벡터만 보고 박스 네 숫자를 통째로 냈다: \(\hat{b} = \sigma(\operatorname{MLP}(\text{질의}))\). 변형 어텐션을 쓰면 질의에게 이미 "이 근처" 라는 기준점이 있다. 질의가 읽어 온 특징은 기준점 둘레의 것이므로, 박스도 기준점에서 얼마나 벗어나는지 로 내는 편이 자연스럽다. 논문은 이렇게 하면 최적화가 쉬워지고, 디코더의 어텐션과 예측 박스가 강하게 묶여 수렴이 빨라진다고 설명한다(4.1절, 부록 A.3). 문제는 "기준에 더한다" 를 어디서 하느냐이다.
역시그모이드
정규화 좌표는 0 과 1 사이에 있어야 한다. 기준 좌표 \(0.95\) 에 머리가 낸 변화량 \(0.2\) 를 그냥 더하면 \(1.15\) 로 그림 밖이다. 그래서 덧셈을 0 – 1 구간이 아니라 로짓 공간(실수 전체)에서 한다. 좌표를 로짓으로 되돌리고, 거기에 더하고, 시그모이드로 다시 0 – 1 로 가져온다. 좌표를 로짓으로 되돌리는 함수가 역시그모이드(inverse sigmoid) \(\sigma^{-1}\) 이다.
\(\sigma^{-1}(x) = \log\frac{x}{1 - x}\)
4장에서 시그모이드 \(p = 1/(1 + e^{-z})\) 를 \(z\) 에 대해 풀어 얻은 바로 그 식, "로짓은 로그 오즈" 이다. 거기서는 확률을 로짓으로 되돌렸고, 여기서는 좌표를 되돌린다. 정말 역함수인지 한 번 확인해 둔다.
- 확인: 시그모이드에 역시그모이드를 넣으면 제자리
- \(\sigma\big(\sigma^{-1}(x)\big) = \frac{1}{1 + e^{-\log\frac{x}{1 - x}}}\)
- 시그모이드의 정의 \(\sigma(z) = 1/(1 + e^{-z})\) 의 \(z\) 자리에 \(\log\frac{x}{1-x}\) 를 넣었다.
- \(e^{-\log a} = 1/a\) 이므로 \(e^{-\log\frac{x}{1-x}} = \frac{1-x}{x}\).
- 분모를 통분하니 \(x\) 로 돌아왔다. 숫자로: \(\sigma^{-1}(0.3) = \log\frac{0.3}{0.7} = \log 0.4286 = -0.8473\) 이고 \(\sigma(-0.8473) = 0.3\).
몇 개 값을 표로 본다. 가운데 \(0.5\) 가 로짓 0 이고, 0 이나 1 에 다가갈수록 로짓이 한없이 커진다.
| 좌표 \(x\) | 0.05 | 0.1 | 0.25 | 0.3 | 0.5 | 0.95 |
| \(\sigma^{-1}(x)\) | \(-2.9444\) | \(-2.1972\) | \(-1.0986\) | \(-0.8473\) | \(0\) | \(2.9444\) |
def inverse_sigmoid(x: torch.Tensor, eps: float = 1e-5) -> torch.Tensor:
    """시그모이드의 역함수 σ⁻¹(x) = log(x / (1 − x)). 0 – 1 의 좌표를 "로짓 공간" 으로 되돌린다.

    x 가 0 이나 1 에 닿으면 값이 ±∞ 가 되므로 분자 · 분모를 eps 이상으로 자른다.
    """
    x = x.clamp(min=0.0, max=1.0)
    return torch.log(x.clamp(min=eps) / (1 - x).clamp(min=eps))
\(x\) 가 정확히 0 이나 1 이면 \(\log 0\) 이나 0 으로 나누기가 생기므로, 코드는 분자와 분모를 \(10^{-5}\) 이상으로 잘라 둔다. 그러면 로짓이 약 \(\pm 11.5\) 를 넘지 않는다.
로짓 공간에서 더하기
기준 박스를 \(b^{\text{ref}}\), 박스 머리가 낸 네 숫자를 \(\Delta b\)("델타 비")라고 하면 새 박스는 다음과 같다. 박스의 네 성분 \((c_x, c_y, w, h)\) 각각에 따로 적용한다.
\(\hat{b} = \sigma\big(\Delta b + \sigma^{-1}(b^{\text{ref}})\big)\)
- 이 식이 하는 일
- \(\Delta b = 0 \quad\Longrightarrow\quad \hat{b} = \sigma\big(\sigma^{-1}(b^{\text{ref}})\big) = b^{\text{ref}}\)
- 머리가 0 을 내면 박스는 기준 그대로이다. 그래서 박스 머리의 마지막 층을 0 으로 초기화하면, 학습을 시작할 때 모든 예측 박스가 기준 박스와 같다.
- 시그모이드의 값은 언제나 0 과 1 사이이다. \(\Delta b\) 가 아무리 크거나 작아도 \(\hat{b}\) 는 그림 밖으로 나가지 않는다. 따로 자르는 연산이 필요 없다.
- 4장의 성질 \(\sigma'(z) = \sigma(z)(1 - \sigma(z))\). \(\Delta b\) 를 조금 바꿨을 때 좌표가 변하는 비율이다. 가운데(\(\hat{b} = 0.5\))에서 \(0.25\) 로 가장 크고, 가장자리로 갈수록 작아진다.
- 양변의 로짓을 비교하면 \(\log\frac{\hat{b}}{1 - \hat{b}} = \Delta b + \log\frac{b^{\text{ref}}}{1 - b^{\text{ref}}}\) 이고, 지수를 취한 것이다. 로짓에 \(\Delta b\) 를 더하는 것은 오즈 \(\frac{b}{1-b}\) 에 \(e^{\Delta b}\) 를 곱하는 것이다. 너비 · 높이처럼 "몇 배로 키울까" 가 자연스러운 값에 잘 맞는다.
숫자를 넣어 본다.
- 손계산: 기준 0.30 에 Δ = 0.5
- \(\sigma^{-1}(0.30) = \log\frac{0.30}{0.70} = -0.8473\)
- 기준 좌표를 로짓으로 되돌렸다.
- 로짓 공간에서 머리의 출력 \(\Delta b = 0.5\) 를 더했다.
- 시그모이드로 0 – 1 로 돌아왔다. 좌표가 \(0.30\) 에서 \(0.414\) 로 \(0.114\) 움직였다. 어림식 \(\hat{b}(1 - \hat{b})\,\Delta b\) 에 기준값을 넣으면 \(0.3 \times 0.7 \times 0.5 = 0.105\) 로 비슷하다.
| 기준 \(b^{\text{ref}}\) | \(\Delta b\) | \(\sigma^{-1}(b^{\text{ref}})\) | 더한 로짓 | 새 값 \(\hat{b}\) | 그냥 더했다면 |
| 0.30 | \(+0.5\) | \(-0.8473\) | \(-0.3473\) | 0.4140 | 0.80 |
| 0.50 | \(+0.5\) | \(0\) | \(0.5\) | 0.6225 | 1.00 |
| 0.95 | \(+2.0\) | \(2.9444\) | \(4.9444\) | 0.9929 | 2.95 (그림 밖) |
| 0.10 | \(-1.0\) | \(-2.1972\) | \(-3.1972\) | 0.0393 | \(-0.90\) (그림 밖) |
| 0.20 | \(+1.0\) | \(-1.3863\) | \(-0.3863\) | 0.4046 | 1.20 (그림 밖) |
마지막 줄을 너비로 읽어 본다. 기준 너비 \(0.20\) 의 오즈는 \(0.2/0.8 = 0.25\) 이고, \(\Delta b = 1\) 은 여기에 \(e^{1} = 2.718\) 을 곱해 \(0.6796\) 으로 만든다. 오즈 \(0.6796\) 을 값으로 되돌리면 \(0.6796/1.6796 = 0.4046\). 너비가 약 두 배가 되었다. 셋째 줄처럼 가장자리 근처에서는 같은 \(\Delta b\) 로 좌표가 조금만 움직인다. 로짓 공간의 덧셈은 0 과 1 에 다가갈수록 저절로 조심스러워진다.
층마다 반복하기: 박스 반복 정제
디코더는 층이 여럿이다. 7장에서는 층마다 박스를 처음부터 다시 냈지만, 이제는 앞 층이 낸 박스를 다음 층의 기준으로 삼을 수 있다. \(d\) 번째 디코더 층이 낸 박스를 \(\hat{b}^{d}\) 라고 하면(위 첨자는 거듭제곱이 아니라 층 번호이다)
\(\hat{b}^{d} = \sigma\Big(\Delta b^{d} + \sigma^{-1}\big(\operatorname{sg}(\hat{b}^{d-1})\big)\Big), \qquad d = 1, 2, \dots\)
이것이 박스 반복 정제(iterative bounding box refinement) 이다. \(\Delta b^{d}\) 는 \(d\) 번째 층의 박스 머리가 낸 변화량이고, \(\operatorname{sg}(\cdot)\) 은 기울기 차단(stop-gradient) 이다. 괄호 안의 값은 그대로 쓰되, 역전파 때는 그 값을 상수로 보고 기울기를 흘려보내지 않는다는 표시이다. 층 하나가 박스를 한 번에 맞히는 대신, 층마다 앞 층의 답을 조금씩 고친다. 논문은 이 생각을 광학 흐름 추정의 반복 정제(Teed & Deng, 2020)에서 가져왔다고 밝힌다. 덧붙는 약속이 넷 있다.
- 박스 머리는 층마다 따로 둔다(가중치를 공유하지 않는다). 첫 층은 크게 옮기고 뒤 층은 조금 다듬는 식으로 하는 일이 다르기 때문이다. 7장의 DETR 은 머리 하나를 모든 층이 함께 썼다.
- 변형 어텐션의 기준도 함께 바뀐다. \(d\) 번째 층의 교차 어텐션은 \(\hat{b}^{d-1}\) 을 기준 박스로 써서, 중심 \((c_x, c_y)\) 에서 출발하고 오프셋에 \((w, h)\) 를 곱한다(앞의 "기준이 박스일 때" 식). 박스가 객체에 가까워질수록 표본점도 객체 위에 모인다.
- 다음 층으로 넘길 때 기울기를 끊는다. \(\operatorname{sg}(\hat{b}^{d-1})\) 은 값은 그대로 쓰되 역전파 때 상수로 취급한다는 뜻이다(코드의
box.detach()). - 첫 층의 기준은 점이다. 처음에는 박스가 없고 기준점 \(p_q\) 뿐이므로, 첫 층은 중심만 기준점에서 출발하고 너비 · 높이는 머리가 통째로 낸다(논문 부록 A.3 의 식). \(\hat{b}^{1} = \Big(\sigma\big(\Delta b_x + \sigma^{-1}(p_x)\big),\ \ \sigma\big(\Delta b_y + \sigma^{-1}(p_y)\big),\ \ \sigma(\Delta b_w),\ \ \sigma(\Delta b_h)\Big)\)
- 논문 부록과 공개 코드의 차이
- 논문 부록 A.4 는 반복 정제의 처음 박스를 \(\hat{b}^{0} = (p_x,\ p_y,\ 0.1,\ 0.1)\), 곧 기준점에 너비 · 높이 0.1 을 붙인 것으로 적는다(0.05 – 0.5 사이의 다른 값으로도 비슷했다고 한다). 이 장을 준비하며 확인한 공개 구현의 동작은 조금 다르다. 첫 층에서는 2차원 기준점을 쓰고, 너비 · 높이는 위 4번처럼 머리가 직접 내며, 그 머리의 너비 · 높이 편향을 \(-2.0\) 으로 초기화한다(\(\sigma(-2) = 0.1192\) 이므로 처음 박스의 크기는 약 0.12 이다). 이 장의 구현은 뒤쪽을 따랐다. 그래서 1층은 "기준 = 점", 2 · 3층은 "기준 = 박스" 이다. 다만 Deformable DETR 의 공식 저장소를 이 환경에서 직접 열어 보지는 못했고, 같은 코드를 물려받은 RF-DETR 소스로 확인했다.
기울기를 끊는 이유
기울기를 끊지 않으면 어떻게 될까? 3층의 박스 \(\hat{b}^{3}\) 은 \(\hat{b}^{2}\) 를 거쳐 \(\hat{b}^{1}\) 에도 달려 있으므로, 3층의 박스 손실이 1 · 2층의 박스 머리까지 거슬러 흐른다. 1층의 머리는 자기 박스를 정답에 맞추라는 신호(1층의 보조 손실)와, "3층이 맞히기 좋게 박스를 내라" 는 신호를 함께 받는다. 변형 어텐션의 표본 위치도 기준 박스에 달려 있으므로, 그 길로도 기울기가 얽힌다. 논문은 학습을 안정시키려고 기울기가 \(\Delta b^{d}\) 로만 흐르게 하고 \(\sigma^{-1}(\hat{b}^{d-1})\) 에서 막는다고 적는다.
끊은 뒤에는 역할이 깔끔하다. 각 층의 박스 머리는 "주어진 기준을 얼마나 고칠까" 만 배운다. 기준 자체는 앞 층이 자기 손실로 책임진다. 끊는 것은 박스 좌표의 길뿐이다. 질의 벡터는 끊지 않고 층에서 층으로 넘어가므로, 뒤 층의 손실은 여전히 질의 벡터를 통해 앞 층의 어텐션과 FFN 을 가르친다.
- RF-DETR 에서는
- "박스 = 기준 + 머리가 낸 변화량" 이라는 틀은 RF-DETR 까지 그대로 이어진다. 다만 두 가지가 달라진다. 더하는 방식이 로짓 공간의 덧셈이 아니라 박스 재매개변수화(\(c_x = \delta_x w + x\), \(w' = e^{\delta_w} w\) 꼴, 9장)이고, 공개 코드의 기본 설정(
lite_refpoint_refine=True)은 기준 박스를 층마다 갈아 끼우지 않고 처음 기준 박스를 모든 디코더 층이 함께 쓴다(10장). 이 장의 층별 정제는 그 원형인 Deformable DETR 의 방식이다.
분류와 매칭을 시그모이드로
Deformable DETR 은 분류도 바꾼다. 논문의 구현 설명에 한 줄로 적혀 있다. 분류에 포컬 손실(손실 가중치 2)을 쓰고, 객체 질의를 100개에서 300개로 늘린다. 이 변화는 RF-DETR 까지 이어지는 줄기이다(LW-DETR 과 RF-DETR 은 여기서 한 번 더 나아가 IoU 인지 BCE 손실을 쓴다. 9장).
∅ 클래스 없이
7장의 DETR 은 클래스 3개에 "객체 없음" ∅ 을 더한 4칸짜리 소프트맥스로 분류했다. 4장의 말로 "배경 클래스를 두는" 방식이다. Deformable DETR 은 클래스마다 따로 시그모이드 를 쓴다. 분류 머리는 질의마다 로짓 3개를 내고, 각각이 "이 질의가 원인가?", "사각형인가?", "삼각형인가?" 라는 예 / 아니오 질문의 답이다.
- 목표는
(B, N, 클래스 수)모양의 0 / 1 행렬이다. 헝가리안 매칭으로 정답과 짝지어진 질의의 정답 클래스 칸만 1 이고 나머지는 모두 0 이다. - 짝이 없는 질의는 세 칸이 모두 0 이다. "객체 없음" 을 따로 한 칸으로 두지 않고 "어느 클래스도 아니다" 로 나타낸다.
- 칸마다 4장의 포컬 손실 \(\mathrm{FL} = -\alpha_t (1 - p_t)^{\gamma} \log p_t\) (\(\alpha = 0.25\), \(\gamma = 2\))을 계산해 모두 더하고, 배치의 정답 객체 수로 나눈다. 손실 계수는 2 이다.
- 분류 머리의 편향은 4장의 사전 확률 편향 초기화대로 \(-\log 99 = -4.5951\) 이다. 처음에는 모든 칸이 "1% 쯤" 이라고 답한다.
이 장의 모델로 세어 보면, 그림 한 장에 질의 12개 × 클래스 3개 = 36칸이 있고 그 가운데 양성은 객체 수만큼인 1 – 4칸이다. 질의가 300개이고 클래스가 수십 개인 COCO 에서는 칸이 만 개를 훌쩍 넘는데 양성은 그림 속 객체 수만큼뿐이다. 4장에서 본 "음성이 압도적" 인 상황 그대로이고, 포컬 손실이 겨냥한 상황이다. 7장의 DETR 이 같은 불균형을 ∅ 클래스의 가중치를 0.1 로 낮춰 다룬 것과 견줄 수 있다.
학습을 막 시작했을 때 양성 칸 하나의 손실은 \(p = 0.01\) 에서 \(0.25 \times 0.99^2 \times (-\log 0.01) = 0.25 \times 0.9801 \times 4.6052 = 1.1284\), 음성 칸 하나는 \(0.75 \times 0.01^2 \times (-\log 0.99) = 0.75 \times 0.0001 \times 0.01005 = 7.5 \times 10^{-7}\) 이다. 4장에서 계산한 그대로, 손실의 거의 전부가 양성 칸에서 나온다.
추론 때의 후처리도 달라진다. ∅ 가 없으므로 "∅ 를 뺀 최댓값" 대신, (질의, 클래스) 쌍 \(12 \times 3 = 36\) 개의 시그모이드 확률을 한 줄로 펴서 점수가 높은 순으로 12개 를 예측으로 낸다. 쌍 단위로 뽑으므로 한 질의가 두 클래스로 두 번 뽑힐 수도 있다.
매칭 비용도 포컬 꼴로
손실이 바뀌면 매칭 비용도 맞춰 바꾼다. 7장의 분류 비용은 정답 클래스에 준 소프트맥스 확률에 음수를 붙인 \(-\hat{p}_i(c_j)\) 였다. 이제 예측 \(i\) 가 정답 \(j\) 의 클래스 \(c_j\) 칸에 준 시그모이드 확률을 줄여서 \(\hat{p}\) 라고 쓰면, 분류 비용은 다음과 같다.
\(C_{\text{cls}}(i, j) = \underbrace{\alpha\,(1 - \hat{p})^{\gamma}\,(-\log \hat{p})}_{\text{양성으로 볼 때의 손실}} \;-\; \underbrace{(1 - \alpha)\,\hat{p}^{\,\gamma}\,\big(-\log(1 - \hat{p})\big)}_{\text{음성으로 볼 때의 손실}}, \qquad \alpha = 0.25,\ \gamma = 2\)
두 항 모두 4장의 포컬 손실이다. 앞 항은 그 칸의 목표가 1 일 때(\(p_t = \hat{p}\), \(\alpha_t = \alpha\)), 뒤 항은 목표가 0 일 때(\(p_t = 1 - \hat{p}\), \(\alpha_t = 1 - \alpha\))의 값이다. 왜 빼는지는 손실을 따라가 보면 알 수 있다.
- 분류 비용 = 짝지었을 때 손실이 변하는 양
- \(\text{예측 } i \text{ 를 정답 } j \text{ 와 짝지으면}: \quad \text{칸 } (i, c_j) \text{ 의 목표} = 1, \quad \text{손실} = \alpha\,(1 - \hat{p})^{\gamma}\,(-\log \hat{p})\)
- 짝지어진 질의의 정답 클래스 칸은 양성이 된다. 그 칸의 포컬 손실이다.
- 짝이 없으면 같은 칸이 음성으로 남는다. 그때의 포컬 손실이다.
- 두 경우의 차이이다. 이 짝을 고르면 그 칸의 분류 손실이 얼마나 늘어나는지(음수면 줄어드는지)를 비용으로 삼은 것이다. 헝가리안 매칭은 총비용이 가장 작은 배정을 고르므로, 분류 손실을 가장 많이 줄여 주는 짝을 선호하게 된다.
확률 \(\hat{p}\) 에 따른 값을 계산해 본다. 예를 들어 \(\hat{p} = 0.9\) 이면
- 손계산: 예측 확률 0.9 의 분류 비용
- \(\alpha\,(1 - \hat{p})^{\gamma}\,(-\log \hat{p}) = 0.25 \times 0.1^2 \times 0.10536 = 0.00026\)
- 양성으로 볼 때의 손실. 이미 0.9 로 잘 맞히고 있으므로 아주 작다. \(-\log 0.9 = 0.10536\).
- 음성으로 볼 때의 손실. 0 이어야 할 칸에 0.9 를 준 셈이므로 크다. \(-\log 0.1 = 2.30259\).
- 이 예측을 이 정답과 짝지으면 그 칸의 손실이 약 1.4 줄어든다. 비용이 크게 음수이므로 매칭이 이 짝을 반긴다.
| 예측 확률 \(\hat{p}\) | 0.01 | 0.1 | 0.3 | 0.5 | 0.7 | 0.9 | 0.99 |
| 양성으로 볼 때의 손실 | 1.1284 | 0.4663 | 0.1475 | 0.0433 | 0.0080 | 0.0003 | 0.0000 |
| 음성으로 볼 때의 손실 | 0.0000 | 0.0008 | 0.0241 | 0.1300 | 0.4425 | 1.3988 | 3.3851 |
| 포컬 분류 비용 \(C_{\text{cls}}\) | \(+1.1284\) | \(+0.4655\) | \(+0.1234\) | \(-0.0866\) | \(-0.4344\) | \(-1.3986\) | \(-3.3851\) |
| 7장 DETR 의 분류 비용 \(-\hat{p}\) | \(-0.01\) | \(-0.1\) | \(-0.3\) | \(-0.5\) | \(-0.7\) | \(-0.9\) | \(-0.99\) |
두 비용 모두 확률이 높을수록 작아져, 정답 클래스를 높게 본 예측을 선호한다. 차이는 범위이다. 7장의 \(-\hat{p}\) 는 \(-1\) 과 0 사이에 갇혀 있지만, 포컬 비용은 확률이 1 에 다가가면 한없이 내려간다. 또 처음(\(\hat{p} = 0.01\))에는 \(+1.13\) 으로 양수이다. 다만 매칭은 정답마다 예측 하나를 반드시 배정하므로, 비용의 부호보다 예측들 사이의 차이 가 배정을 정한다.
전체 매칭 비용은 7장의 식에서 클래스 항만 바꾼 \(C_{ij} = 2\,C_{\text{cls}}(i, j) + 5\,\lVert \hat{b}_i - b_j \rVert_1 - 2\,\operatorname{GIoU}(\hat{b}_i, b_j)\) 이다. 7장은 분류 계수가 1 이었고, 박스 쪽 두 항(L1 거리와 GIoU, 2장)과 그 계수는 그대로이다. RF-DETR 의 공개 코드도 이 식과 계수를 쓴다. 7장의 HungarianMatcher 에 class_cost="focal" 을 주면 이 비용이 된다.
7장과 달라진 것
이 장의 미니 모델 MiniDeformableDETR 이 7장의 MiniDETR 과 다른 곳을 한 표에 모은다. 뒤의 결과를 읽을 때 이 표를 기억해 두라. 바뀐 것이 하나가 아니다.
| 항목 | 7장 MiniDETR | 8장 MiniDeformableDETR (본 모델) |
| 백본 | 합성곱 6층, 12×12 맵 | 같음 |
| 인코더 | 전역 자기 어텐션 3층 | 없음(백본 특징을 그대로 디코더에) |
| 디코더가 읽는 특징 | 12×12 한 장(144 토큰) | 12×12 와 6×6 두 레벨(180 토큰) |
| 교차 어텐션 | 144칸 전부, 질의 · 열쇠 내적 | 변형 어텐션: 표본점 8 · 2 · 2 = 32개 |
| 질의의 위치 | 학습되는 위치 임베딩뿐 | 위치 임베딩 + 거기서 나온 기준점 |
| 박스 예측 | 머리가 네 숫자를 통째로 | 기준에서의 변화량(로짓 공간), 층마다 정제 |
| 박스 · 분류 머리 | 모든 층이 하나를 공유 | 층마다 따로 |
| 분류 | 소프트맥스 4칸(∅ 포함) | 클래스별 시그모이드 3칸 |
| 분류 손실 | 교차 엔트로피(∅ 가중치 0.1), 계수 1 | 포컬 손실(\(\alpha\) 0.25, \(\gamma\) 2), 계수 2 |
| 분류 머리의 편향 | 보통의 초기화 | \(-4.5951\) (사전 확률 0.01) |
| 매칭 비용 | \(-\hat{p}_i(c_j) + 5\,\lVert \hat{b}_i - b_j \rVert_1 - 2\,\operatorname{GIoU}\) | \(2\,C_{\text{cls}} + 5\,\lVert \hat{b}_i - b_j \rVert_1 - 2\,\operatorname{GIoU}\) (\(C_{\text{cls}}\) 는 포컬 꼴) |
| 후처리 | 질의마다 ∅ 를 뺀 최댓값 | (질의, 클래스) 36쌍 가운데 상위 12개 |
| 학습률 | 모두 2e-4 | 2e-4, 오프셋 · 기준점을 내는 선형 층만 2e-5 |
| 매개변수 수 | 1,333,608 | 1,091,607 |
| 같게 둔 것 | 데이터(학습 4,000장 · 검증 500장), 질의 12개, \(D = 128\), 머리 8개, 디코더 3층, FFN 256, AdamW, 배치 32, 60 에폭(48 에폭 뒤 학습률 1/10), 기울기 자르기 0.1, 시드 0, 보조 손실 | |
2단계 질의 선택
그림을 보고 기준을 정한다
지금까지의 기준점은 그림과 무관 했다. 질의마다 학습되는 임베딩이 있고, 거기에 선형 층과 시그모이드를 적용해 기준점을 얻는다. 어떤 그림이 들어와도 12개의 기준점은 같은 자리에 있다. 객체가 기준점에서 먼 곳에 있으면 첫 디코더 층이 멀리 옮겨야 한다.
2단계 방식(two-stage) 은 기준을 그림을 보고 정한다. 논문의 표현으로는 2단계 탐지기에서 착안한 변형이다. 첫 단계에서 특징 맵의 모든 칸 이 객체 질의 노릇을 해 "여기에 객체가 있다면 이런 박스" 라는 제안 박스(region proposal) 와 점수를 내고, 점수가 높은 몇 개를 골라 둘째 단계(디코더)의 처음 기준 박스로 넘긴다. 논문은 첫 단계에서 고른 제안에 NMS 를 걸지 않는다고 적는다.
이 장의 구현(two_stage=True)이 하는 일을 순서대로 적는다. 특징 토큰은 레벨 0 의 144개와 레벨 1 의 36개, 모두 180개이다.
- 칸마다 고정된 출발 박스 하나를 놓는다: 칸의 중심에, 레벨에 따라 정해진 크기로.
- 칸의 특징 벡터에 선형 층과 층 정규화를 적용한 뒤, 분류 머리로 클래스 로짓 3개 를, 박스 머리(3층 MLP)로 변화량 4개 를 낸다. 텐서 모양은
(B, 180, 3)과(B, 180, 4)이다. - 출발 박스에 변화량을 로짓 공간에서 더해 칸마다의 제안 박스를 만든다. 박스 반복 정제와 같은 식이다.
- 칸마다 클래스 로짓 3개 가운데 최댓값 을 그 칸의 점수로 삼아, 점수가 높은 순으로 \(N = 12\) 칸을 고른다.
- 고른 12개의 제안 박스를 기울기를 끊어 디코더의 처음 기준 박스로 쓴다. 첫 디코더 층부터 "기준 = 박스" 이다.
- 고른 12개의 로짓과 박스에도 디코더 층의 출력과 같은 손실(헝가리안 매칭 + 포컬 · L1 · GIoU)을 건다. 이 손실이 2 – 4번의 머리들을 가르친다.
제안 박스 격자와 변화량
1번의 출발 박스는 레벨 \(l\) 의 (행 \(r\), 열 \(c\)) 칸에서 다음과 같다. \(s = 0.05\) 는 기본 크기이다.
\(b^{\text{격자}}_{l,r,c} = \Big(\frac{c + 0.5}{W_l},\ \ \frac{r + 0.5}{H_l},\ \ s \cdot 2^{l},\ \ s \cdot 2^{l}\Big), \qquad \hat{b}^{\text{제안}} = \sigma\Big(\Delta b + \sigma^{-1}\big(b^{\text{격자}}\big)\Big)\)
중심은 칸의 중심(쌍선형 보간에서 쓴 것과 같은 좌표 규약)이고, 너비 · 높이는 레벨 0 에서 \(0.05\), 레벨 1 에서 \(0.1\) 이다. 거친 레벨의 칸일수록 큰 박스에서 출발한다. 논문 부록 A.4 의 식도 같다(레벨을 1 부터 세어 \(2^{l-1}s\) 로 적고, \(s = 0.05\)).
def gen_proposals(spatial_shapes, base_scale: float = 0.05, device=None) -> torch.Tensor:
    """2단계의 1단계: 특징 맵의 칸마다 "제안 박스" 하나를 놓는다. 돌려주는 값: (ΣHW, 4) 정규화 (cx, cy, w, h).

    중심은 칸의 중심 ((c + 0.5)/W, (r + 0.5)/H), 너비 · 높이는 레벨 l 에서 base_scale · 2^l 로 고정
    (RF-DETR 공식 구현의 gen_encoder_output_proposals 와 같다. 해상도가 낮은 레벨일수록 큰 박스를 맡는다).
    토큰 순서(레벨 0 의 행 우선, 이어서 레벨 1 …)는 memory 와 같다. 모델은 이 박스에 델타를 더해 고친다.
    """
    proposals = []
    for level, (height, width) in enumerate(spatial_shapes):
        ys = (torch.arange(height, dtype=torch.float32, device=device) + 0.5) / height
        xs = (torch.arange(width, dtype=torch.float32, device=device) + 0.5) / width
        grid_y, grid_x = torch.meshgrid(ys, xs, indexing="ij")
        size = torch.full_like(grid_x, base_scale * 2.0**level)
        proposals.append(torch.stack([grid_x, grid_y, size, size], dim=-1).reshape(-1, 4))
    return torch.cat(proposals)
gen_proposals([(12, 12), (6, 6)]): (180, 4), 첫 칸 [0.0417 0.0417 0.05 0.05 ], 레벨 1 의 첫 칸 [0.0833 0.0833 0.1 0.1 ]
첫 칸(레벨 0 의 행 0, 열 0)의 중심은 \(0.5/12 = 0.0417\), 레벨 1 의 첫 칸은 \(0.5/6 = 0.0833\) 이다. 출발 박스가 실제 객체의 박스가 되려면 변화량이 얼마여야 하는지 한 칸으로 계산해 본다.
- 손계산: 출발 박스에서 너비 0.25 인 박스로
- \(b^{\text{격자}}_{0,5,7} = \Big(\frac{7.5}{12},\ \frac{5.5}{12},\ 0.05,\ 0.05\Big) = (0.6250,\ 0.4583,\ 0.05,\ 0.05)\)
- 레벨 0 의 (행 5, 열 7) 칸의 출발 박스. 크기는 \(0.05 \times 2^0 = 0.05\), 96픽셀 그림에서 4.8픽셀이다. 도형 세상의 도형(한 변 0.14 – 0.42)보다 훨씬 작다.
- 너비가 0.25 가 되려면 필요한 변화량을 푼다. 양변에 역시그모이드를 취하고 \(\sigma^{-1}(0.05)\) 를 넘겼다.
- 앞의 표에서 \(\sigma^{-1}(0.25) = -1.0986\), \(\sigma^{-1}(0.05) = -2.9444\). 오즈로는 \(0.05/0.95 = 0.0526\) 을 \(0.25/0.75 = 0.3333\) 으로, 곧 \(e^{1.8458} = 6.33\) 배 키우는 것이다.
- 같은 객체를 레벨 1 의 칸(출발 너비 0.1)이 맡으면 필요한 변화량이 더 작다. 레벨마다 출발 크기를 다르게 둔 것은 큰 객체는 거친 레벨이, 작은 객체는 촘촘한 레벨이 맡기 쉽게 하려는 것이다.
2 – 5번을 담은 코드는 뒤의 "구현 따라 읽기" 에서 모델과 함께 본다(select_queries). 질의의 나머지 부분도 적어 둔다. 디코더에 들어가는 질의의 내용 은 고른 칸의 특징이 아니라 여전히 학습되는 임베딩 query_feat 이고, 질의의 위치 임베딩 은 고른 기준 박스 네 숫자의 사인 임베딩(5장)을 2층 MLP 에 넣어 만든다. 위치는 그림에서, 내용은 학습된 값에서 오는 이 방식을 LW-DETR 논문은 "섞은 질의 선택" 이라고 부른다.
원본 Deformable DETR 과 다른 점
이 장의 2단계 구현은 Deformable DETR 논문 그대로가 아니라, RF-DETR 의 공개 코드가 하는 방식 을 따랐다. 10장에서 그대로 이어 쓰기 위해서이다. 다른 곳을 밝혀 둔다.
| 항목 | Deformable DETR 논문 (부록 A.4) | 이 장의 구현 (RF-DETR 방식) |
| 첫 단계의 분류 | 전경 / 배경의 2진 분류 | 클래스별 로짓(3개)을 내고 그 최댓값으로 고름 |
| 첫 단계의 손실 | 칸마다의 예측에 DETR 의 헝가리안 손실 | 고른 \(N\) 개에만 헝가리안 손실 |
| 디코더 질의의 위치 임베딩 | 제안 좌표의 위치 임베딩 | 같음(기준 박스의 사인 임베딩 → MLP) |
| 디코더 질의의 내용 | 논문 본문은 밝히지 않음. 공개 구현은 제안 좌표의 임베딩에서 함께 만드는 것으로 알고 있으나, 이 환경에서 직접 확인하지는 못함 | 학습되는 임베딩 |
| 출발 박스 | 칸의 좌표, 크기 \(2^{l-1}s\), \(s = 0.05\) | 같음 |
| 디코더 앞의 인코더 | 변형 자기 어텐션 인코더의 출력에서 제안 | 인코더 없이 백본 특징에서 제안(RF-DETR 은 ViT + 프로젝터의 출력) |
RF-DETR 과도 다른 곳이 남아 있다. RF-DETR 은 제안과 기준 박스를 박스 재매개변수화로 다루고, 학습되는 refpoint_embed 를 고른 박스에 더하며, 학습 때 질의 묶음을 13개 두고(Group DETR), 기준 박스를 층마다 갈지 않는다. 이 장에는 넣지 않았다. 9장과 10장에서 하나씩 더한다. 2단계 질의 선택 자체도 10장에서 RF-DETR 의 실제 코드와 함께 다시 자세히 본다.
구현 따라 읽기
code/ch08_deformable.py 는 7장의 ch07_detr.py 에서 백본(SmallBackbone), 헝가리안 매칭(HungarianMatcher), 집합 손실(SetCriterion), 학습 고리(fit)를 가져다 쓰고, 이 장에서 새로 나온 것만 만든다. 앞에서 본 inverse_sigmoid, bilinear_sample, gen_proposals 는 건너뛰고 나머지를 읽는다.
변형 어텐션 모듈
먼저 식의 대괄호 안, "표본점에서 읽어 가중합하기" 이다. 입력은 이미 값 투영을 거쳐 머리별로 나뉜 값 (B, M, C/M, ΣHW), 표본점 좌표 (B, Nq, M, L, K, 2), 가중치 (B, Nq, M, L, K) 이다(여기서 C 는 본문의 \(D\), ΣHW 는 모든 레벨의 칸 수의 합).
def ms_deform_attn_core(value, spatial_shapes, sampling_locations, attention_weights):
    """변형 어텐션의 핵심: 표본점에서 값을 읽어(쌍선형 보간) 어텐션 가중치로 가중합한다.

    value               (B, M, C/M, ΣHW)      머리별로 나눈 값 (모든 레벨을 이어 붙인 토큰)
    spatial_shapes      [(H_0, W_0), …]       레벨마다의 특징 맵 크기
    sampling_locations  (B, Nq, M, L, K, 2)   표본점의 정규화 좌표 (x, y)
    attention_weights   (B, Nq, M, L, K)      머리마다 L·K 개 표본점에 걸친 합이 1
    돌려주는 값          (B, Nq, C)            머리 M 개의 결과를 이어 붙인 것
    """
    batch, heads, head_dim, _ = value.shape
    num_queries = sampling_locations.shape[1]
    levels = value.split([h * w for h, w in spatial_shapes], dim=-1)
    grids = 2 * sampling_locations - 1  # grid_sample 은 좌표를 −1 – 1 로 받는다
    sampled = []
    for level, (height, width) in enumerate(spatial_shapes):
        value_map = levels[level].reshape(batch * heads, head_dim, height, width)  # 머리를 배치 축으로
        grid = grids[:, :, :, level].transpose(1, 2).flatten(0, 1)  # (B·M, Nq, K, 2)
        # (B·M, C/M, Nq, K): 질의 Nq 개 × 표본점 K 개 자리의 값. bilinear_sample 과 같은 계산을 한꺼번에 한다
        sampled.append(F.grid_sample(value_map, grid, mode="bilinear", padding_mode="zeros", align_corners=False))
    sampled = torch.stack(sampled, dim=-2).flatten(-2)  # (B·M, C/M, Nq, L·K)
    weights = attention_weights.transpose(1, 2).reshape(batch * heads, 1, num_queries, -1)  # (B·M, 1, Nq, L·K)
    output = (sampled * weights).sum(-1)  # (B·M, C/M, Nq): 표본점에 걸친 가중합
    return output.view(batch, heads * head_dim, num_queries).transpose(1, 2)  # (B, Nq, C)
모양이 여러 번 바뀌므로 한 줄씩 따라간다.
-
value.split(...): 이어 붙인 토큰을 레벨별로 자른다. 레벨 0 은(B, M, C/M, 144), 레벨 1 은(B, M, C/M, 36). -
reshape(batch * heads, head_dim, height, width): 머리를 배치 축으로 합쳐(B·M, C/M, H, W)의 "그림" 으로 만든다. 머리마다 서로 다른 표본점에서 서로 다른 채널 묶음을 읽기 때문이다. -
grids = 2 * sampling_locations - 1: 정규화 좌표를grid_sample의 \(-1\) – \(1\) 좌표로 바꾼다. 레벨 하나의 격자는(B·M, Nq, K, 2)이다. -
F.grid_sample(...):(B·M, C/M, Nq, K). 질의Nq개 × 표본점K개 자리에서 쌍선형 보간으로 읽은 값이다. 앞의bilinear_sample과 같은 계산을 한꺼번에 한다. -
torch.stack(..., dim=-2).flatten(-2): 레벨들을 합쳐(B·M, C/M, Nq, L·K). - 가중치
(B·M, 1, Nq, L·K)를 곱해 마지막 축으로 더하면(B·M, C/M, Nq), 이것을(B, Nq, C)로 되돌린다. 머리 \(M\) 개의 결과가 채널 방향으로 이어 붙은 꼴이다.
이 함수를 감싸는 모듈이 MSDeformAttn 이다. 선형 층 넷과 초기화, 그리고 기준이 점일 때와 박스일 때의 분기가 들어 있다.
class MSDeformAttn(nn.Module):
    """다중 스케일 변형 어텐션 (Deformable DETR). 매개변수 이름 · 초기화는 공식 구현과 같다.

    질의 하나가 하는 일 (머리 m = 1 … M, 레벨 l = 1 … L, 표본점 k = 1 … K):
      1) 오프셋 Δp_mlk = Linear(질의)            — 기준점에서 얼마나 떨어진 곳을 볼지 (2차원)
      2) 가중치 A_mlk  = softmax(Linear(질의))   — 머리마다 L·K 개에 걸쳐 합이 1
      3) 값     x(p + Δp_mlk)                    — 값 투영을 거친 특징 맵에서 쌍선형 보간으로 읽는다
      4) 출력   = 출력 투영( 머리마다 Σ_l Σ_k A_mlk · x_l(p_l + Δp_mlk) 를 이어 붙인 것 )
    열쇠와의 내적이 없다: "어디를 볼지" 도 "얼마나 볼지" 도 질의만 보고 정한다.
    """

    def __init__(self, d_model: int = 128, n_levels: int = 2, n_heads: int = 8, n_points: int = 2):
        super().__init__()
        assert d_model % n_heads == 0
        self.d_model, self.n_levels, self.n_heads, self.n_points = d_model, n_levels, n_heads, n_points
        self.sampling_offsets = nn.Linear(d_model, n_heads * n_levels * n_points * 2)
        self.attention_weights = nn.Linear(d_model, n_heads * n_levels * n_points)
        self.value_proj = nn.Linear(d_model, d_model)
        self.output_proj = nn.Linear(d_model, d_model)
        self._reset_parameters()

    def _reset_parameters(self):
        # 오프셋: 가중치는 0, 편향만 정해 준다 → 처음에는 어떤 질의든 같은 무늬로 표본점을 찍는다.
        # 머리 m 은 각도 2πm/M 방향을 맡고(최댓값 노름으로 나눠 정사각형 테두리 위의 8방향이 된다),
        # k 번째 표본점은 그 방향으로 k 칸 떨어진 곳 → 기준점 주위를 골고루 본다.
        nn.init.constant_(self.sampling_offsets.weight, 0.0)
        thetas = torch.arange(self.n_heads, dtype=torch.float32) * (2.0 * math.pi / self.n_heads)
        grid = torch.stack([thetas.cos(), thetas.sin()], -1)  # (M, 2)
        grid = grid / grid.abs().max(-1, keepdim=True)[0]
        grid = grid.view(self.n_heads, 1, 1, 2).repeat(1, self.n_levels, self.n_points, 1)  # (M, L, K, 2)
        for k in range(self.n_points):
            grid[:, :, k, :] *= k + 1
        with torch.no_grad():
            self.sampling_offsets.bias = nn.Parameter(grid.view(-1))
        # 어텐션 가중치: 가중치 · 편향 모두 0 → 소프트맥스를 거치면 모든 표본점이 1/(L·K) 로 같다
        nn.init.constant_(self.attention_weights.weight, 0.0)
        nn.init.constant_(self.attention_weights.bias, 0.0)
        nn.init.xavier_uniform_(self.value_proj.weight)
        nn.init.constant_(self.value_proj.bias, 0.0)
        nn.init.xavier_uniform_(self.output_proj.weight)
        nn.init.constant_(self.output_proj.bias, 0.0)

    def forward(self, query, reference_points, value, spatial_shapes, return_details: bool = False):
        """query            (B, Nq, C)
        reference_points (B, Nq, L, 2) 기준점 (x, y)  또는  (B, Nq, L, 4) 기준 박스 (cx, cy, w, h) — 정규화 0 – 1
        value            (B, ΣHW, C)  레벨 0 의 토큰 H_0·W_0 개, 레벨 1 의 토큰 … 을 차례로 이어 붙인 것 (행 우선)
        spatial_shapes   [(H_0, W_0), …, (H_{L−1}, W_{L−1})]
        돌려주는 값: (B, Nq, C).  return_details=True 면 (출력, 표본점 (B, Nq, M, L, K, 2), 가중치 (B, Nq, M, L, K)).
        """
        batch, num_queries, _ = query.shape
        heads, levels, points = self.n_heads, self.n_levels, self.n_points
        assert value.shape[1] == sum(h * w for h, w in spatial_shapes)

        value = self.value_proj(value)  # (B, ΣHW, C)
        value = value.transpose(1, 2).reshape(batch, heads, self.d_model // heads, -1)  # (B, M, C/M, ΣHW)
        offsets = self.sampling_offsets(query).view(batch, num_queries, heads, levels, points, 2)
        weights = self.attention_weights(query).view(batch, num_queries, heads, levels * points)
        weights = weights.softmax(-1).view(batch, num_queries, heads, levels, points)

        if reference_points.shape[-1] == 2:
            # 기준이 점: 오프셋의 단위는 "그 레벨 특징 맵의 칸". (W_l, H_l) 로 나눠 정규화 좌표로 바꾼다
            normalizer = torch.tensor([[w, h] for h, w in spatial_shapes], dtype=query.dtype, device=query.device)
            locations = reference_points[:, :, None, :, None, :] + offsets / normalizer[None, None, None, :, None, :]
        elif reference_points.shape[-1] == 4:
            # 기준이 박스: 오프셋의 단위는 "박스 절반 크기의 1/K". 박스가 크면 넓게, 작으면 좁게 본다.
            # 초기 편향(k 번째 점이 k 칸)에서는 k/K · (w/2, h/2) → 처음 표본점은 모두 박스 안에 있다.
            locations = (reference_points[:, :, None, :, None, :2]
                         + offsets / points * reference_points[:, :, None, :, None, 2:] * 0.5)
        else:
            raise ValueError("reference_points 의 마지막 차원은 2 또는 4 여야 한다")

        output = self.output_proj(ms_deform_attn_core(value, spatial_shapes, locations, weights))
        return (output, locations, weights) if return_details else output
본문의 식과 맞대어 읽는다.
-
sampling_offsets가 \(\operatorname{Linear}_{\Delta}\)(출력 \(2MLK\) 개),attention_weights가 \(\operatorname{Linear}_{A}\)(출력 \(MLK\) 개),value_proj가 \(W^V_m\) 들,output_proj가 \(W^O_m\) 들이다. -
weights.softmax(-1)을 하기 전에 모양을(B, Nq, M, L·K)로 만들어 둔다. 소프트맥스가 머리마다 \(L \cdot K\) 개에 걸쳐 계산되게 하려는 것이다. - 기준이 점일 때의
normalizer는 레벨마다의 \((W_l, H_l)\) 이다.spatial_shapes는 (높이, 너비) 순서이고 좌표는 \((x, y)\) 순서라서[w, h]로 뒤집어 넣는다. - 기준이 박스일 때의
offsets / points * reference_points[..., 2:] * 0.5가 본문의 \(\frac{\Delta p}{K} \cdot \frac{(w, h)}{2}\) 이다. -
_reset_parameters가 앞에서 본 초기화이다.grid / grid.abs().max(...)가 방향 벡터를 큰 성분으로 나누는 줄,grid[:, :, k, :] *= k + 1이 \(k\) 번째 점을 \(k\) 배 멀리 놓는 줄이다.
이 모듈의 매개변수는 \(D = 128\), \(M = 8\), \(L = 2\), \(K = 2\) 일 때 45,408개이다. 오프셋 층 \(128 \times 64 + 64 = 8{,}256\), 가중치 층 \(128 \times 32 + 32 = 4{,}128\), 값 · 출력 투영이 각각 \(128 \times 128 + 128 = 16{,}512\) 이다. 같은 \(D\) 의 보통 다중 머리 어텐션은 5장에서 센 대로 \(4(D^2 + D) = 66{,}048\) 개이다. 질의 · 열쇠 투영이 없어진 대신 작은 선형 층 둘이 생겼다.
직접 만든 모듈이 식대로 계산하는지, 질의 하나의 출력을 bilinear_sample 로 다시 계산해 대조한다.
def msda_checks():
    """MSDeformAttn 의 출력을, 질의 하나에 대해 bilinear_sample 로 식 그대로 다시 계산해 대조한다."""
    torch.manual_seed(0)
    dim, heads, points = 32, 4, 2
    shapes = [(6, 6), (3, 3)]
    attn = MSDeformAttn(dim, n_levels=2, n_heads=heads, n_points=points)
    with torch.no_grad():  # 초기값(가중치 0)이면 질의와 무관해지므로, 대조를 위해 무작위 값으로 흔든다
        attn.sampling_offsets.weight.normal_(0, 0.5)
        attn.attention_weights.weight.normal_(0, 0.5)
    value = torch.randn(1, 6 * 6 + 3 * 3, dim)
    query = torch.randn(1, 5, dim)
    for name, reference in (("기준점 (2차원)", torch.rand(1, 5, 1, 2).expand(-1, -1, 2, -1)),
                            ("기준 박스 (4차원)", torch.cat([torch.rand(1, 5, 1, 2), torch.rand(1, 5, 1, 2) * 0.4 + 0.1],
                                                       -1).expand(-1, -1, 2, -1))):
        with torch.no_grad():
            output, locations, weights = attn(query, reference, value, shapes, return_details=True)
            projected = attn.value_proj(value)[0]  # (ΣHW, C)
            head_dim = dim // heads
            manual = torch.zeros(dim)
            q, start = 3, 0  # 질의 3번
            for level, (height, width) in enumerate(shapes):
                level_map = projected[start:start + height * width].T.reshape(dim, height, width)  # (C, H, W)
                start += height * width
                for m in range(heads):
                    sampled = bilinear_sample(level_map[m * head_dim:(m + 1) * head_dim], locations[0, q, m, level])
                    manual[m * head_dim:(m + 1) * head_dim] += (weights[0, q, m, level][:, None] * sampled).sum(0)
            manual = attn.output_proj(manual)
        print(f"check MSDeformAttn vs 손으로 다시 계산 [{name}]: 최대 차이 {float((output[0, q] - manual).abs().max()):.2e}, "
              f"가중치 합(머리마다) {weights[0, q].sum((-1, -2)).numpy().round(4)}")

    fresh = MSDeformAttn(dim, n_levels=1, n_heads=8, n_points=2)
    bias = fresh.sampling_offsets.bias.detach().view(8, 1, 2, 2)
    print("오프셋 편향의 초기값 (머리 8개 × 표본점 2개, 단위: 칸):")
    for m in range(8):
        print(f"  머리 {m}: k=1 ({bias[m, 0, 0, 0]:+.0f}, {bias[m, 0, 0, 1]:+.0f})   "
              f"k=2 ({bias[m, 0, 1, 0]:+.0f}, {bias[m, 0, 1, 1]:+.0f})")
check MSDeformAttn vs 손으로 다시 계산 [기준점 (2차원)]: 최대 차이 1.01e-07, 가중치 합(머리마다) [1. 1. 1. 1.]
check MSDeformAttn vs 손으로 다시 계산 [기준 박스 (4차원)]: 최대 차이 2.38e-07, 가중치 합(머리마다) [1. 1. 1. 1.]
두 경우 모두 차이가 \(10^{-7}\) 수준(반올림 오차)이고, 머리마다 가중치의 합이 1 이다. 이 장을 준비하면서는 더 나아가 RF-DETR 공식 패키지의 MSDeformAttn 과도 대조했다(튜토리얼 코드에는 넣지 않은 임시 스크립트). 매개변수 이름을 공식 구현과 같게 지었으므로 이 장 모듈의 가중치를 공식 모듈에 그대로 넣을 수 있다. 같은 입력을 주었을 때 기준이 점일 때와 박스일 때, 레벨 1 · 2 · 3개에서 출력의 최대 차이가 0 이었고, 오프셋 편향의 초기값도 완전히 같았다. gen_proposals 도 공식 구현의 제안 격자와 차이가 0 이었다.
디코더 층과 모델
class DeformableDecoderLayer(nn.Module):
    """Deformable DETR 디코더 한 층: 질의끼리 자기 어텐션 → 변형 교차 어텐션 → FFN (각각 뒤에 더하고 층 정규화).

    7장의 디코더 층과 다른 곳은 ② 하나뿐이다: nn.MultiheadAttention 대신 MSDeformAttn.
    """

    def __init__(self, dim: int, heads: int, ffn_dim: int, n_levels: int, n_points: int, dropout: float = 0.0):
        super().__init__()
        self.self_attn = nn.MultiheadAttention(dim, heads, dropout=dropout, batch_first=True)
        self.norm1 = nn.LayerNorm(dim)
        self.cross_attn = MSDeformAttn(dim, n_levels, heads, n_points)
        self.norm2 = nn.LayerNorm(dim)
        self.ffn = nn.Sequential(nn.Linear(dim, ffn_dim), nn.ReLU(), nn.Dropout(dropout), nn.Linear(ffn_dim, dim))
        self.norm3 = nn.LayerNorm(dim)
        self.dropout = nn.Dropout(dropout)

    def forward(self, tgt, query_pos, reference_points, memory, spatial_shapes):
        """tgt (B, N, D), query_pos (B, N, D) 또는 (N, D), reference_points (B, N, L, 2 또는 4), memory (B, ΣHW, D).

        돌려주는 값: 새 tgt (B, N, D), 표본점 (B, N, M, L, K, 2), 어텐션 가중치 (B, N, M, L, K).
        """
        q = tgt + query_pos
        attended, _ = self.self_attn(q, q, tgt, need_weights=False)  # ① 자기 어텐션 (7장과 같다)
        tgt = self.norm1(tgt + self.dropout(attended))
        attended, locations, weights = self.cross_attn(tgt + query_pos, reference_points, memory, spatial_shapes,
                                                       return_details=True)  # ② 기준점 주위 M·L·K 곳만 읽는다
        tgt = self.norm2(tgt + self.dropout(attended))
        tgt = self.norm3(tgt + self.dropout(self.ffn(tgt)))  # ③ FFN
        return tgt, locations, weights
7장의 디코더 층과 다른 곳은 ② 한 줄이다. 교차 어텐션이 nn.MultiheadAttention 에서 MSDeformAttn 으로 바뀌었고, 열쇠에 더하던 위치 인코딩 대신 reference_points 를 받는다. 질의끼리의 자기 어텐션(①)은 그대로이다. 질의는 12개뿐이라 제곱 비용이 문제 되지 않고, 7장에서 본 "같은 객체를 두 질의가 맡지 않게 조율하는" 일을 여기서 한다.
class MiniDeformableDETR(nn.Module):
    """미니 Deformable DETR. 그림 (B, 3, 96, 96) → 질의 N 개마다 (클래스 로짓 K 개, 박스 4개). ∅ 칸이 없다.

    특징: 7장의 백본(12×12) → 레벨 0 = 1×1 합성곱(12×12), 레벨 1 = 3×3 스트라이드 2 합성곱(6×6). 각각 GroupNorm.
    인코더: 기본은 없음(enc_layers=0) — 백본 특징을 그대로 디코더에 준다. enc_layers > 0 이면 7장의 전역 자기
           어텐션 인코더 층을 그만큼 쌓는다 (LW-DETR · RF-DETR 에서 ViT 가 하는 역할).
    디코더: DeformableDecoderLayer × dec_layers.
    box_refine=True  : 층마다 박스 머리가 따로 있고, 층 d 의 박스 = σ(Δ_d + σ⁻¹(기준_{d−1})). 그 박스를 기울기를
                       끊어(detach) 다음 층의 기준 박스로 넘긴다 → 박스 반복 정제.
    box_refine=False : 모든 층이 처음 기준을 그대로 쓰고, 머리도 함께 쓴다.
    two_stage=False  : 기준점 = σ(Linear(학습되는 질의 위치 임베딩)) — 그림과 무관한 N 개의 점 (2차원).
    two_stage=True   : 모든 칸에서 제안 박스와 클래스 점수를 내고, 점수 상위 N 개의 박스를 기준 박스(4차원)로 쓴다.
    """

    def __init__(self, num_classes: int = NUM_CLASSES, num_queries: int = 12, dim: int = 128, heads: int = 8,
                 dec_layers: int = 3, ffn_dim: int = 256, n_levels: int = 2, n_points: int = 2,
                 box_refine: bool = True, two_stage: bool = False, enc_layers: int = 0, backbone_width: int = 32):
        super().__init__()
        assert n_levels in (1, 2)
        self.num_classes, self.num_queries, self.dim, self.n_levels = num_classes, num_queries, dim, n_levels
        self.box_refine, self.two_stage = box_refine, two_stage
        self.backbone = SmallBackbone(backbone_width)
        channels = self.backbone.out_channels
        self.input_proj = nn.ModuleList([nn.Sequential(nn.Conv2d(channels, dim, 1), nn.GroupNorm(32, dim))])
        if n_levels == 2:  # 더 거친 레벨은 백본 출력에 스트라이드 2 합성곱을 한 번 더 해서 만든다
            self.input_proj.append(nn.Sequential(nn.Conv2d(channels, dim, 3, 2, 1), nn.GroupNorm(32, dim)))
        self.encoder = nn.ModuleList(TransformerEncoderLayer(dim, heads, ffn_dim) for _ in range(enc_layers))
        self.level_embed = nn.Parameter(torch.randn(n_levels, dim) * 0.02) if enc_layers else None
        self.decoder = nn.ModuleList(DeformableDecoderLayer(dim, heads, ffn_dim, n_levels, n_points)
                                     for _ in range(dec_layers))

        self.query_feat = nn.Embedding(num_queries, dim)  # 질의의 내용: 디코더의 첫 입력 (학습됨)
        if two_stage:
            self.enc_output = nn.Sequential(nn.Linear(dim, dim), nn.LayerNorm(dim))
            self.enc_class_embed = nn.Linear(dim, num_classes)  # 칸마다의 클래스 로짓
            self.enc_bbox_embed = MLP(dim, dim, 4, num_layers=3)  # 칸마다의 박스 델타
            self.ref_point_head = MLP(2 * dim, dim, dim, num_layers=2)  # 기준 박스의 사인 임베딩 → 질의 위치 임베딩
        else:
            self.query_pos = nn.Embedding(num_queries, dim)  # 질의 위치 임베딩 (학습됨)
            self.reference_points = nn.Linear(dim, 2)  # → 시그모이드 → 기준점
            nn.init.xavier_uniform_(self.reference_points.weight)
            nn.init.constant_(self.reference_points.bias, 0.0)

        # 머리. box_refine 이면 층마다 따로, 아니면 하나를 함께 쓴다 (같은 모듈을 여러 번 넣으면 가중치를 함께 쓴다)
        num_heads = dec_layers if box_refine else 1
        class_heads = [nn.Linear(dim, num_classes) for _ in range(num_heads)]
        bbox_heads = [MLP(dim, dim, 4, num_layers=3) for _ in range(num_heads)]
        self.class_embed = nn.ModuleList(class_heads[i % num_heads] for i in range(dec_layers))
        self.bbox_embed = nn.ModuleList(bbox_heads[i % num_heads] for i in range(dec_layers))
        prior_bias = -math.log((1 - 0.01) / 0.01)  # σ(편향) = 0.01: 처음에는 모든 칸이 "객체일 확률 1%" 라고 답한다
        for head in class_heads + ([self.enc_class_embed] if two_stage else []):
            nn.init.constant_(head.bias, prior_bias)
        for head in bbox_heads + ([self.enc_bbox_embed] if two_stage else []):
            nn.init.constant_(head.layers[-1].weight, 0.0)  # 처음의 Δ 는 0 → 박스 = 기준 그대로
            nn.init.constant_(head.layers[-1].bias, 0.0)
        if not two_stage:  # 기준이 점이면 w, h 는 머리가 통째로 예측한다: σ(−2) ≈ 0.12 에서 출발
            nn.init.constant_(bbox_heads[0].layers[-1].bias[2:], -2.0)

    def encode(self, images: torch.Tensor):
        """그림 → memory (B, ΣHW, D) 와 spatial_shapes [(12, 12), (6, 6)]."""
        feature = self.backbone(images)
        maps = [proj(feature) for proj in self.input_proj]  # [(B, D, 12, 12), (B, D, 6, 6)]
        spatial_shapes = [tuple(m.shape[-2:]) for m in maps]
        memory = torch.cat([m.flatten(2).transpose(1, 2) for m in maps], dim=1)  # (B, ΣHW, D)
        if len(self.encoder):
            pos = torch.cat([sine_position_2d(h, w, self.dim, device=images.device) + self.level_embed[level]
                             for level, (h, w) in enumerate(spatial_shapes)])  # (ΣHW, D)
            for layer in self.encoder:
                memory = layer(memory, pos)
        return memory, spatial_shapes

    def select_queries(self, memory, spatial_shapes):
        """2단계 질의 선택. 돌려주는 값: 기준 박스 (B, N, 4) — 기울기 차단, 그리고 손실에 넣을 제안 예측."""
        proposals = gen_proposals(spatial_shapes, device=memory.device)  # (ΣHW, 4)
        feature = self.enc_output(memory)  # (B, ΣHW, D)
        logits = self.enc_class_embed(feature)  # (B, ΣHW, K)
        boxes = (self.enc_bbox_embed(feature) + inverse_sigmoid(proposals)).sigmoid()  # 제안 + 델타 (로짓 공간에서)
        top = logits.max(-1).values.topk(self.num_queries, dim=1).indices  # (B, N): 클래스 로짓의 최댓값 상위 N 칸
        top_logits = torch.gather(logits, 1, top[..., None].expand(-1, -1, logits.shape[-1]))
        top_boxes = torch.gather(boxes, 1, top[..., None].expand(-1, -1, 4))
        return top_boxes.detach(), {"pred_logits": top_logits, "pred_boxes": top_boxes}, top

    def forward(self, images: torch.Tensor, return_details: bool = False):
        """돌려주는 값: {"pred_logits": (B, N, K), "pred_boxes": (B, N, 4), "aux_outputs": [...],
                       "enc_outputs": {…} (two_stage 일 때만 — 선택된 제안 N 개의 로짓 · 박스)}
        return_details=True 면 "references": [층마다 그 층이 쓴 기준 (B, N, 2 또는 4)],
        "sampling": [층마다 (표본점 (B, N, M, L, K, 2), 가중치 (B, N, M, L, K))] 도 넣는다.
        """
        memory, spatial_shapes = self.encode(images)
        batch = images.shape[0]
        outputs = {}
        if self.two_stage:
            reference, outputs["enc_outputs"], _ = self.select_queries(memory, spatial_shapes)  # (B, N, 4)
            query_pos = self.ref_point_head(sine_embed(reference, self.dim // 2))  # (B, N, 4·D/2) → (B, N, D)
        else:
            query_pos = self.query_pos.weight  # (N, D)
            reference = self.reference_points(query_pos).sigmoid()[None].expand(batch, -1, -1)  # (B, N, 2)
        tgt = self.query_feat.weight[None].expand(batch, -1, -1)  # (B, N, D)

        layer_outputs, references, sampling = [], [], []
        for i, layer in enumerate(self.decoder):
            references.append(reference)
            reference_input = reference[:, :, None].expand(-1, -1, self.n_levels, -1)  # 모든 레벨에 같은 기준
            tgt, locations, weights = layer(tgt, query_pos, reference_input, memory, spatial_shapes)
            sampling.append((locations, weights))
            delta = self.bbox_embed[i](tgt)  # (B, N, 4)
            if reference.shape[-1] == 4:
                box = (delta + inverse_sigmoid(reference)).sigmoid()  # 기준 박스를 조금 고친다
            else:  # 기준이 점이면 중심만 기준점에서 출발하고, 너비 · 높이는 머리가 직접 낸다
                box = torch.cat([delta[..., :2] + inverse_sigmoid(reference), delta[..., 2:]], -1).sigmoid()
            layer_outputs.append({"pred_logits": self.class_embed[i](tgt), "pred_boxes": box})
            if self.box_refine:
                reference = box.detach()  # 다음 층의 기준 박스. 기울기는 Δ 로만 흐르게 여기서 끊는다
        outputs.update(layer_outputs[-1])
        outputs["aux_outputs"] = layer_outputs[:-1]
        if return_details:
            outputs["references"], outputs["sampling"] = references, sampling
        return outputs
forward 의 디코더 고리를 본문의 식과 맞대어 본다.
-
reference[:, :, None].expand(-1, -1, self.n_levels, -1): 기준(B, N, 2 또는 4)를(B, N, L, 2 또는 4)로 늘린다. 모든 레벨에 같은 기준을 준다는 뜻이다. -
delta = self.bbox_embed[i](tgt): \(i\) 번째 층의 박스 머리가 낸 \(\Delta b\), 모양(B, N, 4). - 기준이 박스면
(delta + inverse_sigmoid(reference)).sigmoid(), 기준이 점이면 앞의 두 성분에만 기준점의 로짓을 더한다. 본문의 두 식 그대로이다. -
reference = box.detach(): 기울기를 끊어 다음 층의 기준 박스로 넘긴다.box_refine=False이면 이 줄을 건너뛰어 모든 층이 처음 기준을 쓰고, 머리도 하나를 함께 쓴다. -
select_queries가 2단계 질의 선택이다.logits.max(-1).values.topk(...)가 "클래스 로짓의 최댓값 상위 \(N\) 칸",top_boxes.detach()가 기울기를 끊은 기준 박스이다. - 초기화: 분류 머리의 편향은 \(-\log 99\), 박스 머리의 마지막 층은 0(처음의 \(\Delta b\) 가 0), 1단계 모델의 첫 층 머리만 너비 · 높이 편향이 \(-2.0\) 이다.
손실 · 후처리 · 학습 설정
def sigmoid_focal_loss(logits: torch.Tensor, targets: torch.Tensor, alpha: float = 0.25, gamma: float = 2.0):
    """포컬 손실 (4장). logits · targets 는 같은 모양이고 targets 는 0 또는 1. 칸마다의 손실을 돌려준다.

    FL = −α_t (1 − p_t)^γ log p_t,   p_t = p (목표 1) 또는 1 − p (목표 0),   α_t = α 또는 1 − α.
    """
    prob = logits.sigmoid()
    ce = F.binary_cross_entropy_with_logits(logits, targets, reduction="none")  # −log p_t
    p_t = prob * targets + (1 - prob) * (1 - targets)
    alpha_t = alpha * targets + (1 - alpha) * (1 - targets)
    return alpha_t * (1 - p_t) ** gamma * ce

class FocalSetCriterion(SetCriterion):
    """Deformable DETR 의 집합 손실. 7장의 SetCriterion 에서 분류 손실만 바꾼다.

    클래스마다 따로 시그모이드: 목표는 (B, N, K) 의 0/1 행렬이고, 짝이 있는 질의의 정답 클래스 칸만 1 이다.
    ∅ 클래스가 없다 — 짝이 없는 질의는 "모든 칸이 0" 이 목표다. 합을 객체 수로 나눈다. 계수는 (2, 5, 2).
    """

    def __init__(self, num_classes: int, matcher: HungarianMatcher, focal_alpha: float = 0.25,
                 focal_gamma: float = 2.0, loss_ce: float = 2.0, loss_bbox: float = 5.0, loss_giou: float = 2.0):
        super().__init__(num_classes, matcher, loss_ce=loss_ce, loss_bbox=loss_bbox, loss_giou=loss_giou)
        self.focal_alpha, self.focal_gamma = focal_alpha, focal_gamma

    def loss_labels(self, outputs, tgt_labels, matched, num_boxes):
        logits = outputs["pred_logits"]  # (B, N, K)
        batch_idx, query_idx, tgt_idx = matched
        target = torch.zeros_like(logits)
        target[batch_idx, query_idx, tgt_labels[tgt_idx]] = 1.0
        return sigmoid_focal_loss(logits, target, self.focal_alpha, self.focal_gamma).sum() / num_boxes
FocalSetCriterion 은 7장 SetCriterion 의 분류 손실 한 곳만 갈아 끼운다. 박스 손실(L1, GIoU), 보조 손실, 매칭을 부르는 흐름은 물려받는다. target[batch_idx, query_idx, tgt_labels[tgt_idx]] = 1.0 한 줄이 "짝지어진 질의의 정답 클래스 칸만 1" 이다. 로그의 두 줄이 포컬 손실 구현을 확인해 준다. \(\gamma = 0\), \(\alpha = 0.5\) 로 두고 2배 하면 BCE 와 같고, 기본값에서는 식을 그대로 적은 계산과 같다.
check 포컬 손실(γ = 0, α = 0.5) × 2 vs BCE: 최대 차이 0.00e+00
check 포컬 손실(γ = 2, α = 0.25) vs 식 그대로: 최대 차이 2.98e-08
@torch.no_grad()
def postprocess_sigmoid(outputs, num_select: int | None = None):
    """Deformable DETR 방식 후처리. outputs: {"pred_logits": (B, N, K), "pred_boxes": (B, N, 4)}.

    (질의, 클래스) N·K 쌍의 시그모이드 확률을 한 줄로 펴서 점수 상위 num_select 개를 예측으로 낸다
    (기본값 N). 한 질의가 두 클래스로 두 번 뽑힐 수도 있다. NMS 는 없다.
    돌려주는 값: 길이 B 의 목록, 각각 {"boxes": (num_select, 4), "scores": (num_select,), "labels": (num_select,)}.
    """
    prob = outputs["pred_logits"].sigmoid()  # (B, N, K)
    batch, num_queries, num_classes = prob.shape
    scores, index = prob.flatten(1).topk(num_select or num_queries, dim=1)  # (B, num_select)
    query, labels = index // num_classes, index % num_classes
    boxes = torch.gather(outputs["pred_boxes"], 1, query[..., None].expand(-1, -1, 4))
    return [{"boxes": b, "scores": s, "labels": c} for b, s, c in zip(boxes, scores, labels)]
def build_optimizer(model, lr: float, weight_decay: float = 1e-4):
    """AdamW. Deformable DETR 처럼 오프셋 · 기준점을 내는 Linear 는 학습률을 1/10 로 한다 (표본점이 날뛰지 않게)."""
    slow = [p for n, p in model.named_parameters() if "sampling_offsets" in n or "reference_points" in n]
    slow_ids = {id(p) for p in slow}
    fast = [p for p in model.parameters() if id(p) not in slow_ids]
    return torch.optim.AdamW([{"params": fast}, {"params": slow, "lr": lr * 0.1}], lr=lr, weight_decay=weight_decay)

def build_criterion(device):
    """매칭 비용도 포컬 방식으로: C = 2·C_cls(포컬) + 5·C_L1 + 2·C_GIoU."""
    matcher = HungarianMatcher(cost_class=2.0, cost_bbox=5.0, cost_giou=2.0, class_cost="focal")
    return FocalSetCriterion(NUM_CLASSES, matcher).to(device)
build_optimizer 는 오프셋과 기준점을 내는 선형 층의 학습률만 1/10 로 낮춘다. 논문의 설정을 따른 것으로, 논문은 기준점과 오프셋을 예측하는 선형 투영의 학습률에 0.1 을 곱한다고 적는다. 나머지 설정(학습률 2e-4, 가중치 감쇠 1e-4, 기울기 자르기 0.1, 배치 32, 60 에폭)은 7장과 같게 두었다. 논문도 기본 학습률 2e-4 를 쓴다.
def run_experiment(name, train_set, val_set, epochs, lr, batch_size, device, seed, **model_kwargs):
    """모델 하나를 처음부터 학습한다. 시드 · 데이터 순서는 실행마다 같다. 돌려주는 값: (모델, 학습 기록)."""
    torch.manual_seed(seed)
    model = MiniDeformableDETR(**model_kwargs).to(device)
    criterion = build_criterion(device)
    optimizer = build_optimizer(model, lr)
    scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=max(int(epochs * 0.8), 1), gamma=0.1)
    loader = make_loader(train_set, batch_size, shuffle=True, seed=seed)
    print(f"\n── {name}: 매개변수 {sum(p.numel() for p in model.parameters()):,}개, {model_kwargs}")
    history = fit(model, criterion, optimizer, scheduler, loader, val_set, epochs, device,
                  postprocess_fn=postprocess_sigmoid)
    return model, history
(원문에서 접혀 있는 main 영역의 코드는 ch08_deformable.py 에 있다.)
$ python ch07_detr.py         # 먼저: 7장의 학습 기록 ch07_history.json 을 만든다
$ python ch08_deformable.py   # 본문 결과
$ python ch08_deformable.py --quick   # 오류만 확인하는 축소판 (CPU 약 30초)
본 실행은 본 모델 하나(60 에폭)와 절제 모델 다섯(각 15 에폭)을 학습한다. 이 장의 수치를 낸 실행은 8GB 노트북 GPU 를 다른 작업과 나눠 쓰는 상태에서 전체 1,645초(약 27분), 그 가운데 본 모델의 학습이 632초였다. GPU 를 혼자 쓸 때의 시간은 재지 못했다. 같은 폴더에 7장의 ch07_history.json 이 있으면 7장의 곡선을 겹쳐 그린다. 체크포인트 ch08_deformable.pt(본 모델)와 ch08_two_stage.pt(2단계 모델)는 뒤 장에서 다시 쓴다.
결과 읽기
이제 학습 결과를 본다. 모든 수치는 도형 세상의 검증 500장(정답 객체 1,265개)에서, 한 번의 실행(시드 0)으로 얻은 것이다. 7장의 수치는 7장의 본 실행 기록에서 가져왔다.
수렴 곡선
── Deformable DETR (본 모델): 매개변수 1,091,607개, {'num_queries': 12}
에폭   1 | 손실 10.2228 (ce 0.2648 bbox 0.2980 giou 0.6514) | 검증 AP 0.2173 AP50 0.5744 AP75 0.1341 |    21초
에폭   2 | 손실  4.6739 (ce 0.1507 bbox 0.1027 giou 0.2864) | 검증 AP 0.5061 AP50 0.8324 AP75 0.5808 |    40초
에폭   3 | 손실  3.3744 (ce 0.1123 bbox 0.0637 giou 0.1826) | 검증 AP 0.6698 AP50 0.8917 AP75 0.7863 |    55초
에폭   4 | 손실  2.8084 (ce 0.0835 bbox 0.0495 giou 0.1434) | 검증 AP 0.6431 AP50 0.9156 AP75 0.8034 |    68초
에폭   5 | 손실  2.4559 (ce 0.0637 bbox 0.0433 giou 0.1270) | 검증 AP 0.7659 AP50 0.9462 AP75 0.8737 |    80초
에폭   6 | 손실  2.0996 (ce 0.0544 bbox 0.0411 giou 0.1209) | 검증 AP 0.7857 AP50 0.9539 AP75 0.8931 |    91초
에폭   7 | 손실  1.8349 (ce 0.0438 bbox 0.0369 giou 0.1090) | 검증 AP 0.8109 AP50 0.9561 AP75 0.9049 |   104초
에폭   8 | 손실  1.7051 (ce 0.0381 bbox 0.0343 giou 0.1022) | 검증 AP 0.7676 AP50 0.9610 AP75 0.9066 |   118초
에폭   9 | 손실  1.5883 (ce 0.0332 bbox 0.0318 giou 0.0948) | 검증 AP 0.7871 AP50 0.9662 AP75 0.9145 |   132초
에폭  10 | 손실  1.4985 (ce 0.0281 bbox 0.0306 giou 0.0924) | 검증 AP 0.8380 AP50 0.9654 AP75 0.9184 |   145초
에폭  15 | 손실  1.1674 (ce 0.0118 bbox 0.0237 giou 0.0728) | 검증 AP 0.8419 AP50 0.9784 AP75 0.9441 |   201초
에폭  20 | 손실  0.9538 (ce 0.0049 bbox 0.0196 giou 0.0616) | 검증 AP 0.8654 AP50 0.9804 AP75 0.9545 |   251초
에폭  25 | 손실  0.8137 (ce 0.0030 bbox 0.0165 giou 0.0526) | 검증 AP 0.8862 AP50 0.9801 AP75 0.9523 |   298초
에폭  30 | 손실  0.7276 (ce 0.0022 bbox 0.0150 giou 0.0484) | 검증 AP 0.8732 AP50 0.9780 AP75 0.9539 |   345초
에폭  35 | 손실  0.6515 (ce 0.0009 bbox 0.0137 giou 0.0447) | 검증 AP 0.8652 AP50 0.9796 AP75 0.9564 |   392초
에폭  40 | 손실  0.6024 (ce 0.0011 bbox 0.0126 giou 0.0416) | 검증 AP 0.8959 AP50 0.9802 AP75 0.9613 |   437초
에폭  45 | 손실  0.5403 (ce 0.0006 bbox 0.0113 giou 0.0378) | 검증 AP 0.8928 AP50 0.9809 AP75 0.9609 |   486초
에폭  50 | 손실  0.3603 (ce 0.0001 bbox 0.0078 giou 0.0266) | 검증 AP 0.9020 AP50 0.9806 AP75 0.9601 |   534초
에폭  55 | 손실  0.3258 (ce 0.0001 bbox 0.0072 giou 0.0245) | 검증 AP 0.8994 AP50 0.9807 AP75 0.9597 |   585초
에폭  60 | 손실  0.3035 (ce 0.0001 bbox 0.0068 giou 0.0231) | 검증 AP 0.8982 AP50 0.9795 AP75 0.9594 |   632초
학습 끝: 632초
줄의 "손실" 은 디코더 세 층의 손실을 모두 더한 값이고, 괄호 안은 마지막 층의 세 항(계수를 곱하기 전)이다. 채점은 처음 10 에폭은 매번, 그 뒤로는 5 에폭마다 했다. 7장의 기록과 같은 에폭끼리 나란히 놓으면 다음과 같다.
[수렴 비교] 같은 에폭에서의 검증 AP (7장 기록 ch07_history.json)
에폭 | MiniDETR AP  AP75 | Deformable AP  AP75
   1 |   0.0048  0.0002 |     0.2173  0.1341
   2 |   0.0140  0.0019 |     0.5061  0.5808
   3 |   0.0405  0.0075 |     0.6698  0.7863
   4 |   0.1456  0.0639 |     0.6431  0.8034
   5 |   0.1915  0.0706 |     0.7659  0.8737
   6 |   0.3426  0.2352 |     0.7857  0.8931
   7 |   0.4193  0.3580 |     0.8109  0.9049
   8 |   0.4669  0.4399 |     0.7676  0.9066
   9 |   0.5264  0.5359 |     0.7871  0.9145
  10 |   0.5788  0.6682 |     0.8380  0.9184
  20 |   0.7039  0.8523 |     0.8654  0.9545
  30 |   0.7576  0.9104 |     0.8732  0.9539
  40 |   0.7358  0.9080 |     0.8959  0.9613
  50 |   0.8386  0.9549 |     0.9020  0.9601
  60 |   0.8375  0.9500 |     0.8982  0.9594
검증 AP 0.5 에 처음 닿은 에폭(채점한 에폭 가운데): MiniDETR 9, Deformable 2
검증 AP 0.8 에 처음 닿은 에폭(채점한 에폭 가운데): MiniDETR 50, Deformable 7
검증 AP 0.9 에 처음 닿은 에폭(채점한 에폭 가운데): MiniDETR None, Deformable 50
학습 시간: MiniDETR 841초 / 60 에폭, Deformable 631초 / 60 에폭

[최종] 검증 AP 0.8982, AP50 0.9795, AP75 0.9594, 클래스별 AP circle 0.9388, rectangle 0.8723, triangle 0.8834
- 그림: 그림 8-5 같은 데이터 · 에폭 · 배치 · 학습률로 학습한 7장의 MiniDETR(주황 실선)과 이 장의 MiniDeformableDETR(파랑 점선). 왼쪽은 검증 AP, 오른쪽은 AP75 이고, 점은 채점한 에폭이다.
- 7장 MiniDETR 과 8장 MiniDeformableDETR 의 검증 AP 와 AP75 곡선. Deformable 은 첫 몇 에폭에 가파르게 올라 10 에폭에 AP 0.84 에 이르고, DETR 은 천천히 올라 50 에폭에 0.84 에 이른다. AP75 는 끝에서 두 곡선이 거의 만난다.
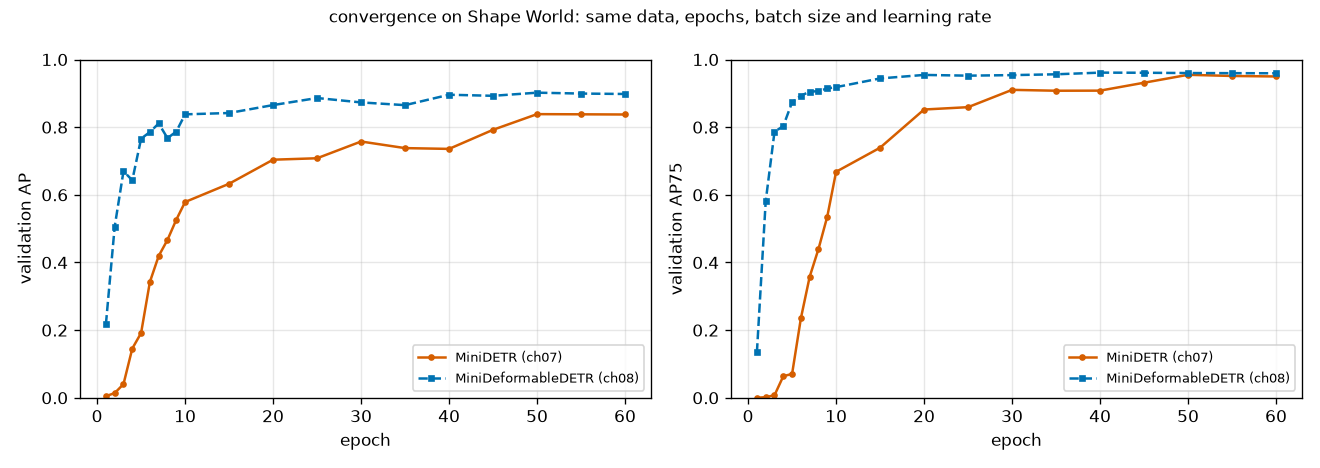
그림 8-5 와 표에서 읽을 것이다.
- 처음부터 다르다. MiniDETR 은 3 에폭까지 AP 가 0.04 이하로 바닥에 붙어 있다. 이 장의 모델은 1 에폭 만에 0.2173, 2 에폭에 0.5061 이다.
- 같은 높이에 닿는 에폭이 크게 다르다. AP 0.5 에 MiniDETR 은 9 에폭, 이 장의 모델은 2 에폭에 닿았다. AP 0.8 은 50 에폭과 7 에폭이다. MiniDETR 은 학습률을 낮춘 뒤(48 에폭)에야 0.8 을 넘었다.
- 끝에서도 AP 는 높다. 최종 AP 가 0.8982 로 7장의 0.8375 보다 0.06 높다. AP75 는 0.9594 와 0.9500 으로 거의 만난다. 오른쪽 그림에서 두 곡선이 끝에서 붙는 것이 그것이다. AP 는 IoU 문턱값 0.5 – 0.95 의 평균이므로(3장), AP50 은 오히려 낮고 AP75 는 비슷한데 AP 가 높으므로, 차이의 대부분은 0.75 보다 더 엄격한 문턱값 들에서 날 것이다(문턱값별 AP 를 따로 출력하지는 않았다). 박스가 더 정확히 맞는다는 뜻이다.
- 곡선이 매끄럽지 않다. AP 가 3 → 4 에폭에 0.6698 → 0.6431, 7 → 8 에폭에 0.8109 → 0.7676, 25 → 35 에폭에 0.8862 → 0.8652 로 내려갔다가 다시 오른다. 시드 하나의 곡선이라 이 출렁임이 우연인지 가릴 수 없다.
- 7장이 남긴 물음의 답. 7장은 "미니 DETR 의 곡선이 느린 쪽이었는지는 8장에서 견주어 보고 판단하자" 고 했다. 같은 데이터와 같은 학습 고리에서, 7장의 곡선은 느린 쪽이었다.
- 학습 시간은 비교하지 말라. 841초와 631초는 서로 다른 시각에, 다른 작업과 GPU 를 나눠 쓰며 잰 값이다. "Deformable 이 더 빨리 돈다" 는 근거가 되지 못한다.
무엇이 빠르게 했나
여기서 "변형 어텐션 덕분에 수렴이 빨라졌다" 고 쓰고 싶어진다. 그렇게 쓸 수 없다. 앞의 "7장과 달라진 것" 표를 다시 보라. 두 모델 사이에는 차이가 여럿이다.
- 교차 어텐션이 변형 어텐션으로 바뀌었고, 질의에게 기준점이 생겼다.
- 박스를 기준에서의 변화량으로 내고, 층마다 정제한다. 머리도 층마다 따로이다.
- 분류가 포컬 손실 · 사전 확률 편향 초기화 · ∅ 없는 시그모이드로 바뀌었고, 매칭 비용도 바뀌었다.
- 인코더가 없어졌고 특징 레벨이 둘이 되었다.
이 실험이 말해 주는 것은 "Deformable DETR 방식 전체가 이 데이터에서 7장의 DETR 보다 빨리 배웠다" 까지이다. 어느 부분의 몫이 얼마인지는 부분을 하나씩 빼 봐야 알 수 있고, 뒤의 절제 실험이 그 일부를 한다. 미리 말하면 박스 반복 정제의 몫이 컸고, 변형 어텐션과 포컬 손실 각각을 따로 떼어 보는 실험은 하지 않았다.
논문은 이 구별에 쓸 만한 숫자를 하나 준다. 표 1 의 DETR-DC5+ 는 DETR-DC5 에 포컬 손실과 질의 300개 를 넣은 모델인데, 50 에폭 학습에서 AP 36.2 로 DETR-DC5 의 35.3 과 큰 차이가 없다. 같은 50 에폭의 Deformable DETR 은 43.8 이다. COCO 에서는 포컬 손실과 질의 수만으로 그 차이가 설명되지 않는다는 뜻이다. 다만 이것은 논문의 COCO 실험이고, 이 장의 도형 세상 실험이 같은 것을 보였다는 뜻이 아니다.
층마다 정제되는 박스
학습한 본 모델에서 디코더 1 · 2 · 3층의 출력을 따로 채점한다(7장과 같은 표이다).
[디코더 층별 예측과 중복]
디코더 층 | AP     AP50   AP75  | NMS 뒤 AP  AP50  | 점수≥0.5 예측 수 | 그중 IoU>0.5 로 겹치는 쌍
    1     | 0.7752 0.9536 0.8827 | 0.7734  0.9631 |     1196         |     47
    2     | 0.8820 0.9740 0.9433 | 0.8817  0.9798 |     1208         |     39
    3     | 0.8982 0.9795 0.9594 | 0.8955  0.9803 |     1206         |      9
[박스 반복 정제] 층마다 매칭된 예측 박스와 정답의 평균 IoU: 1층 0.8820, 2층 0.9293, 3층 0.9353
- 그림: 그림 8-6 본 모델의 디코더 층별 AP(왼쪽)와 AP50(오른쪽). 파랑 실선은 NMS 없이, 주황 점선은 NMS(IoU 0.5)를 건 뒤이다. 세로축의 범위가 좁다는 점(AP50 은 0.95 – 0.98)에 주의하라.
- 디코더 층별 검증 AP 와 AP50. AP 는 1층 0.775 에서 2층 0.882, 3층 0.898 로 오르고 NMS 전후가 거의 겹친다. AP50 은 NMS 를 걸면 1층에서 0.954 가 0.963 으로 오르고 3층에서는 거의 같다.
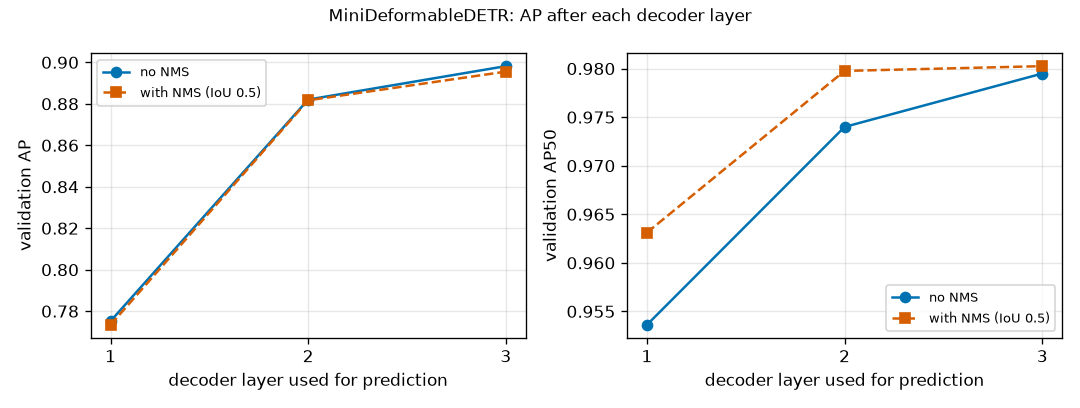
- 층을 거치며 AP 가 크게 오른다. 0.7752 → 0.8820 → 0.8982. 7장의 MiniDETR 은 0.8067 → 0.8365 → 0.8375 였다. 1층에서 2층으로의 상승이 7장은 0.03, 이 장은 0.11 이다. 정답과 짝지어진 예측 박스의 평균 IoU 도 0.8820 → 0.9293 → 0.9353 으로 층마다 오른다. 앞 층의 박스를 다음 층이 고쳐 쓰는 구조가 숫자에 보인다.
- 1층만 보면 7장보다 낮다(0.7752 대 0.8067). 이 장의 1층은 그림과 무관한 기준점과 표본점으로 한 번 읽고 박스를 내야 하므로 불리하다. 이 모델의 좋은 성능은 뒤 층들의 정제에서 나온다.
- 중복은 더 적다. 마지막 층에서 점수 0.5 이상인 예측 가운데 IoU 0.5 넘게 겹치는 쌍이 9개이다(7장은 45개). NMS 를 걸어도 AP 는 0.8982 → 0.8955 로 조금 내려가고 AP50 은 0.9795 → 0.9803 으로 거의 그대로이다. NMS 가 주는 이득이 없다는 7장의 관찰이 여기서도 유지된다. 1층에서는 NMS 가 AP50 을 0.9536 → 0.9631 로 올린다.
- 그림: 그림 8-7 검증 그림 #1(위)과 #2(아래)에서 박스가 정제되는 모습. 맨 왼쪽: 처음 기준점 12개(주황 별 = 끝에 점수 0.5 이상이 되는 질의, 회색 점 = 나머지)와 정답(흰 점선). 오른쪽 세 열: 그 질의들이 각 디코더 층 뒤에 낸 박스(초록).
- 검증 그림 두 장. 맨 왼쪽 열은 학습된 기준점 12개와 정답 박스, 나머지 세 열은 디코더 1, 2, 3층 뒤의 예측 박스. 기준점은 두 그림에서 같은 자리에 있고, 1층 박스부터 객체를 감싸며 층을 거칠수록 정답 점선에 붙는다.
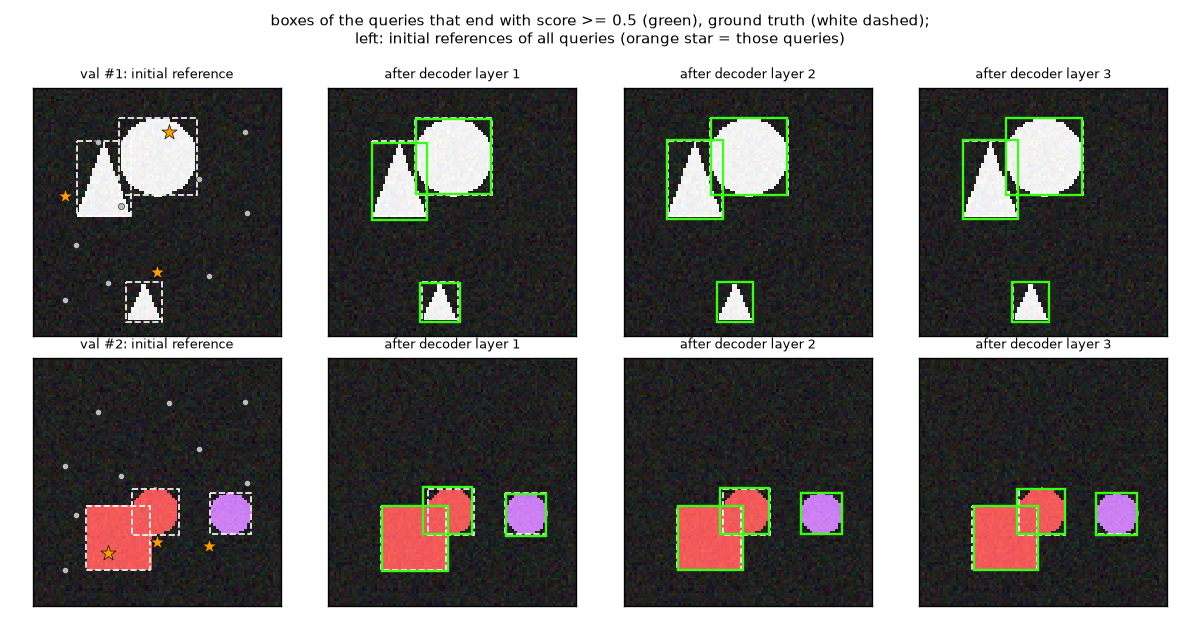
그림 8-7 에서 볼 것은 두 가지이다.
- 기준점은 그림과 무관하다. 맨 왼쪽 열의 점 12개는 위 그림과 아래 그림에서 같은 자리에 있다. 로그에 찍힌 학습된 기준점은 \(x\) 가 0.13 – 0.86, \(y\) 가 0.18 – 0.85 로 그림 전체에 흩어져 있다. 객체를 맡게 된 질의(주황 별)의 기준점은 대체로 객체 근처이지만 객체의 중심이 아니고, 정답 박스 밖에 있는 별도 있다. 그래도 1층이 곧바로 박스를 객체 위로 옮긴다.
- 1층의 박스는 조금 어긋나 있고, 2 · 3층에서 정답에 붙는다. 눈으로 보이는 차이는 작다. 평균 IoU 로 0.88 에서 0.93 – 0.94 가 되는 정도의 차이이고, 이것이 높은 IoU 문턱값의 AP 를 가른다.
- 그림: 그림 8-8 검증 그림 0 – 7 의 예측(초록 실선, 점수 0.5 이상)과 정답(흰 점선). 제목의 "k pred / m gt" 는 예측 수와 정답 수이다. 7장의 예측 그림과 같은 그림 여덟 장이다.
- 검증 그림 여덟 장의 예측 박스와 정답. 대부분 개수가 맞고 점수는 0.94 에서 0.99 사이. 넷째 그림은 정답이 둘인데 예측이 하나로, 삼각형을 놓쳤다.
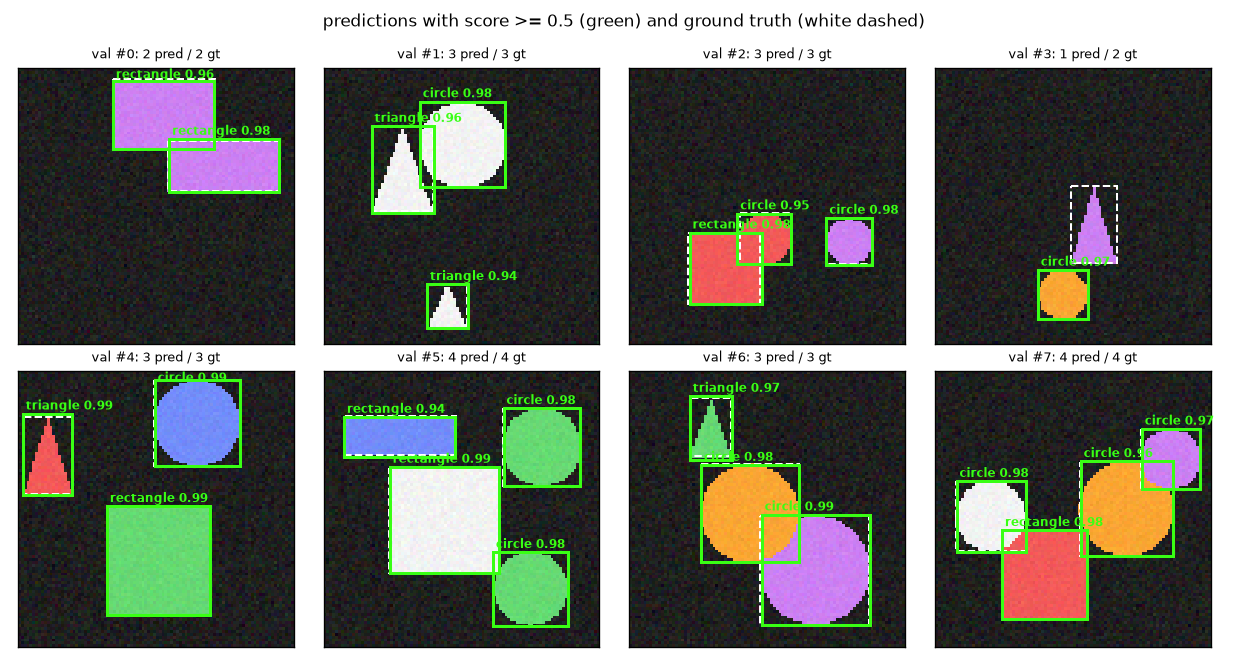
그림 8-8 의 여덟 장 가운데 일곱 장은 개수가 맞다. #3 에서는 삼각형을 놓쳤다("1 pred / 2 gt"). 그 삼각형의 점수가 0.5 에 못 미친 것이다. 7장의 모델은 같은 그림에서 둘 다 찾았다. 점수도 눈여겨보라. 0.94 – 0.99 로, 거의 1.00 이던 7장보다 낮게 나온다. 이 차이는 뒤의 "기대와 달랐던 것들" 에서 다시 본다.
표본점이 찍히는 곳
학습한 모델이 실제로 어디를 읽는지 본다. 검증 그림 #1 에서 점수가 가장 높은 질의 하나(원을 맡은 질의 5)의 표본점 32개를 층마다 그렸다.
[표본점] 검증 그림 #1, 질의 5: 층마다 표본점 8×2×2개
  1층 (기준 = 점): 기준에서 가장 먼 표본점까지 0.389 (그림 한 변 = 1), 그림 안에 있는 표본점 비율 0.91, 가장 큰 가중치 0.932 (고르면 0.250), 레벨별 가중치 몫 [0.831 0.169]
  2층 (기준 = 박스): 기준에서 가장 먼 표본점까지 0.161 (그림 한 변 = 1), 그림 안에 있는 표본점 비율 1.00, 가장 큰 가중치 0.892 (고르면 0.250), 레벨별 가중치 몫 [0.867 0.133]
  3층 (기준 = 박스): 기준에서 가장 먼 표본점까지 0.176 (그림 한 변 = 1), 그림 안에 있는 표본점 비율 1.00, 가장 큰 가중치 0.942 (고르면 0.250), 레벨별 가중치 몫 [0.892 0.108]
학습된 기준점 (질의 12개의 x, y): (0.30,0.79) (0.71,0.76) (0.26,0.22) (0.13,0.85) (0.13,0.44) (0.55,0.18) (0.86,0.50) (0.17,0.63) (0.86,0.18) (0.36,0.47) (0.50,0.74) (0.67,0.37)
- 그림: 그림 8-9 검증 그림 #1 의 질의 5(원, 점수 0.98)가 디코더 층마다 읽는 표본점 32개. 흰 별 = 기준점(2 · 3층은 기준 박스의 중심), 흰 점선 = 기준 박스, 노랑 = 레벨 0(12×12), 하늘색 = 레벨 1(6×6). 원의 넓이가 어텐션 가중치 이다.
- 원을 맡은 질의의 표본점을 디코더 세 층에 대해 그린 그림. 1층은 기준점 둘레로 넓게 퍼지고 일부는 그림 위쪽 밖에 있다. 2층과 3층은 기준 박스 안과 테두리에 모여 원을 덮는다.
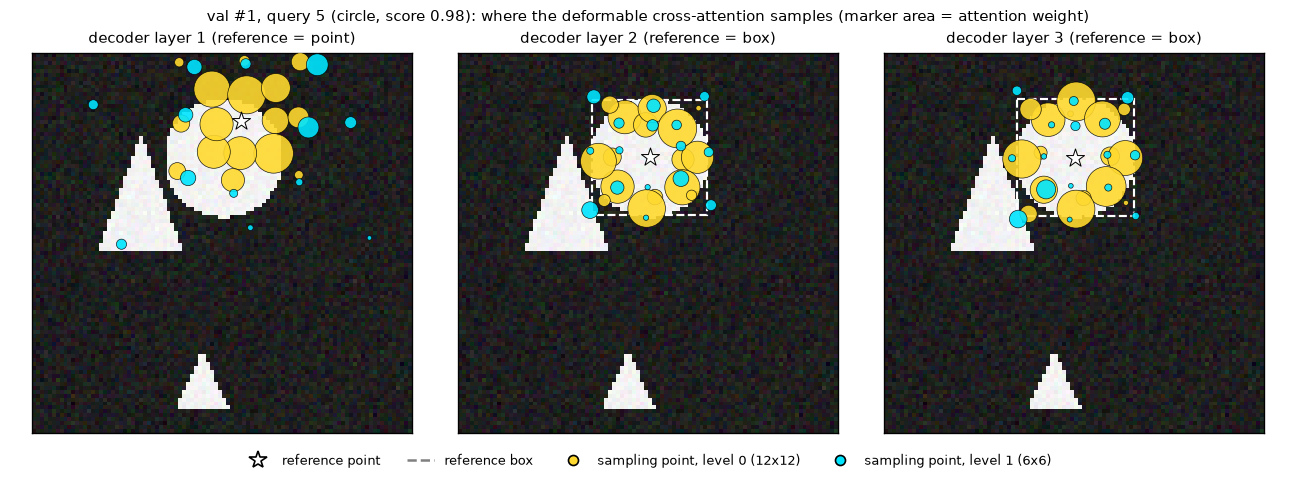
- 1층은 넓게 본다. 기준이 점이라 오프셋이 칸 단위이고, 표본점이 기준점에서 최대 0.389(그림 한 변의 39%)까지 퍼져 있다. 9% 는 그림 밖에 찍혀 0 을 읽는다. 앞에서 말했듯 1단계 모델의 1층 표본점은 그림에 따라 달라지지 않는다. 이 무늬는 "이 질의가 어떤 그림에서든 먼저 살펴보는 자리" 이다.
- 2 · 3층은 박스에 맞춰 본다. 기준이 앞 층이 낸 박스로 바뀌자 표본점이 그 박스 안과 테두리에 모인다. 가장 먼 표본점까지의 거리가 0.161, 0.176 으로 줄었고 모두 그림 안이다. 오프셋에 박스의 크기가 곱해지는 식 그대로이다.
- 가중치는 고르지 않다. 머리 하나가 가진 표본점 4개(레벨 2 × 표본점 2)에 고르게 나누면 0.25 씩인데, 한 점이 0.93 – 0.94 를 가져가는 머리가 있다. 초기화 때의 "모두 같게" 에서 많이 벗어났다.
- 촘촘한 레벨에 가중치가 실린다. 레벨 0 이 83 – 89%, 레벨 1 이 11 – 17% 이다.
이 그림은 그림 한 장, 질의 하나 의 예이다. "변형 어텐션은 언제나 이렇게 본다" 로 넓혀 읽지 말라. 논문은 COCO 에서 학습한 모델의 표본점을 그려 보이고(부록 A.6), 디코더가 객체의 끝부분만이 아니라 전경 객체 전체에 주목하며 표본점과 가중치가 객체의 크기와 모양에 맞춰진다고 설명한다.
절제 실험
부품 하나를 빼거나 바꿔 처음부터 다시 학습해 본다. 시간을 아끼려고 15 에폭의 짧은 일정(12 에폭 뒤 학습률 1/10)으로 했다. 본 모델(60 에폭)의 수치와 직접 견주면 안 된다. 기준은 같은 15 에폭으로 다시 학습한 첫 줄(base)이다.
[절제 요약] 에폭 15 뒤의 검증 성능 (시드 1개)
설정                      | AP     AP50   AP75  | 1층만의 AP  AP75 | AP≥0.8 첫 에폭 | 학습 시간
refine, 2 levels (base)   | 0.8763 0.9768 0.9395 | 0.7202   0.8297 |        7       |   131초
no box refinement         | 0.7500 0.9461 0.8599 | 0.7040   0.8048 |     None       |   181초
two-stage                 | 0.9100 0.9921 0.9747 | 0.8864   0.9665 |        6       |   205초
single level (12x12)      | 0.8563 0.9639 0.9288 | 0.7061   0.8130 |        8       |   156초
+ 3 encoder layers        | 0.8720 0.9776 0.9395 | 0.7364   0.8403 |        7       |   213초
[2단계] 디코더를 거치기 전, 선택된 제안 12개만으로 채점한 AP (검증 앞 250장): AP 0.8330, AP50 0.9898, AP75 0.9664
| 줄 | 바꾼 것 |
| refine, 2 levels (base) | 본 모델과 같은 설정(박스 반복 정제, 2레벨, 1단계, 인코더 없음) |
| no box refinement | 박스 반복 정제를 끔: 모든 층이 처음 기준점을 쓰고, 머리 하나를 함께 씀 |
| two-stage | 2단계 질의 선택을 켬: 처음 기준이 그림에서 고른 제안 박스 |
| single level (12x12) | 레벨 1(6×6)을 빼고 레벨 0 만 씀. 질의당 표본점 16개 |
| + 3 encoder layers | 디코더 앞에 7장의 전역 자기 어텐션 인코더 3층을 더함 |
- 그림: 그림 8-10 절제 다섯 설정의 검증 AP(왼쪽)와 AP75(오른쪽), 각 15 에폭 · 시드 하나.
- 절제 다섯 설정의 검증 AP 와 AP75 곡선. 박스 정제가 없는 설정만 뚜렷이 아래에 있고, 2단계가 처음부터 가장 위이며, 나머지 셋은 서로 붙어 있다.
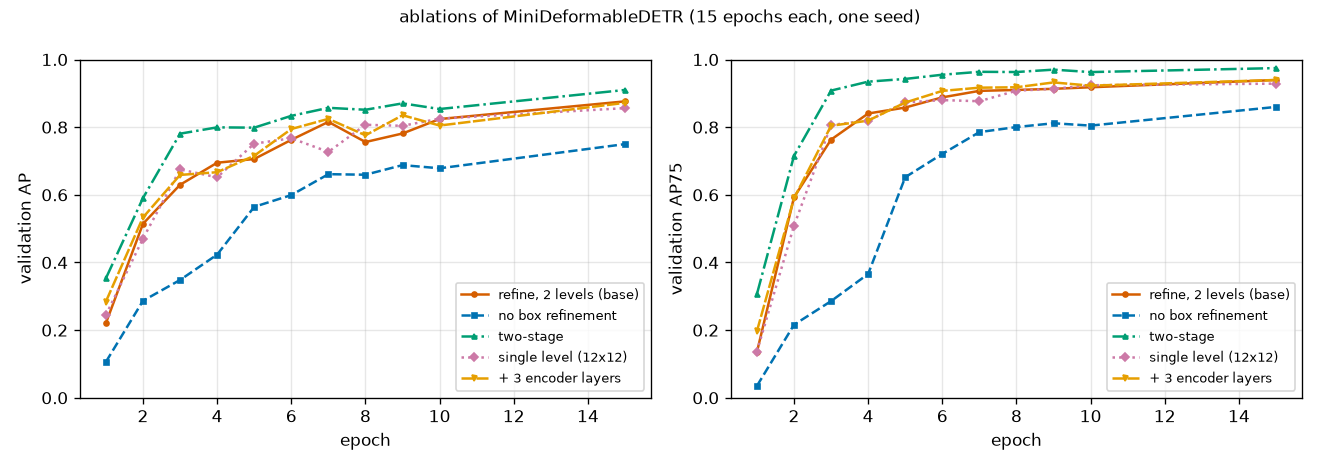
- 주의: 시드가 하나다
- 설정마다 한 번씩만 학습했다. 같은 설정인 본 모델과 base 조차 초반 곡선이 조금 다르다(1 에폭의 AP 가 0.2173 과 0.2206, 3 에폭은 0.6698 과 0.6297). GPU 연산의 비결정성 때문이다. 그러므로 ±0.02 쯤의 차이는 우연일 수 있다. 아래에서 "차이가 있다" 고 말하는 것은 곡선 전체에서 뚜렷이 갈리는 두 줄뿐이다. 표의 "학습 시간" 도 GPU 를 나눠 쓴 상태의 값이라 설정 사이의 속도 비교에 쓸 수 없다.
- 박스 반복 정제를 빼면 뚜렷이 나빠진다. AP 0.8763 → 0.7500. 그림 8-10 에서 이 설정(파랑 점선)만 처음부터 끝까지 아래에 있고, 15 에폭 안에 AP 0.8 에 닿지 못했다. 1층만의 AP 는 0.7202 와 0.7040 으로 비슷하다. 차이는 뒤 층에서 벌어진다. 정제가 있으면 1층 0.72 에서 마지막 층 0.88 로 오르지만, 없으면 0.70 에서 0.75 로 오르는 데 그친다. 다만 이 줄은 정제만 뺀 것이 아니다. 머리를 층마다 따로 두는 것과 뒤 층의 변형 어텐션이 박스를 기준으로 삼는 것도 함께 빠졌다.
- 2단계가 가장 좋았다. AP 0.9100 으로, 60 에폭을 학습한 본 모델(0.8982)보다도 높다. 곡선이 1 에폭부터 가장 위에 있다. 1층만의 AP 가 0.8864 로, 기준을 그림에서 고르면 첫 층부터 박스가 좋다.
- 레벨을 하나로 줄이면 조금 낮다(0.8563). 차이 0.02 는 우연 범위일 수 있다. 도형의 크기가 그림 한 변의 0.14 – 0.42 로 범위가 좁고 12×12 맵의 한 칸보다 훨씬 커서, 이 데이터에서는 다중 스케일이 할 일이 적었을 수 있다. 논문이 COCO 에서 본 다중 스케일의 이득(작은 객체)을 이 실험이 재현했다고 말할 수 없다.
- 인코더 3층을 더해도 달라지지 않았다(0.8720). 7장의 MiniDETR 에는 인코더가 있고 이 장의 모델에는 없다는 차이가, 적어도 이 장의 모델 쪽에서는 성능을 좌우하지 않았다는 뜻이다.
7장의 MiniDETR 은 15 에폭에 AP 0.6327 이었다. 정제를 뺀 설정(0.7500)도 그보다 높다. 하지만 두 실행은 학습률 일정이 달라(절제는 12 에폭 뒤에 낮추고, 7장은 48 에폭 뒤) 엄밀한 비교가 아니다. "정제 없이도 DETR 보다 빠르다" 는 암시 정도로만 읽어야 한다.
제안만으로 채점하면
절제 출력의 마지막 줄을 본다. 2단계 모델에서 디코더를 거치기 전, 고른 제안 12개의 박스와 점수만으로 채점한 값이다(검증 앞 250장). AP 0.8330, AP50 0.9898, AP75 0.9664. 디코더 없이, 칸마다 박스 하나를 내는 머리만으로 이미 쓸 만한 탐지기이다(디코더를 거친 뒤의 0.9100 은 500장 전체의 값이라 둘을 그대로 빼면 안 된다).
- 그림: 그림 8-11 2단계 모델판 그림 8-7. 맨 왼쪽: 고른 제안 12개 가운데 끝에 점수 0.5 이상이 되는 것의 박스(주황)와 중심(주황 별), 나머지 제안의 중심(회색 점), 정답(흰 점선). 오른쪽 세 열: 디코더 각 층 뒤의 박스(초록).
- 2단계 모델의 검증 그림 두 장. 맨 왼쪽 열에서 고른 제안 박스가 처음부터 객체를 감싸고 있고, 디코더 층을 거친 박스는 그것과 거의 같다.
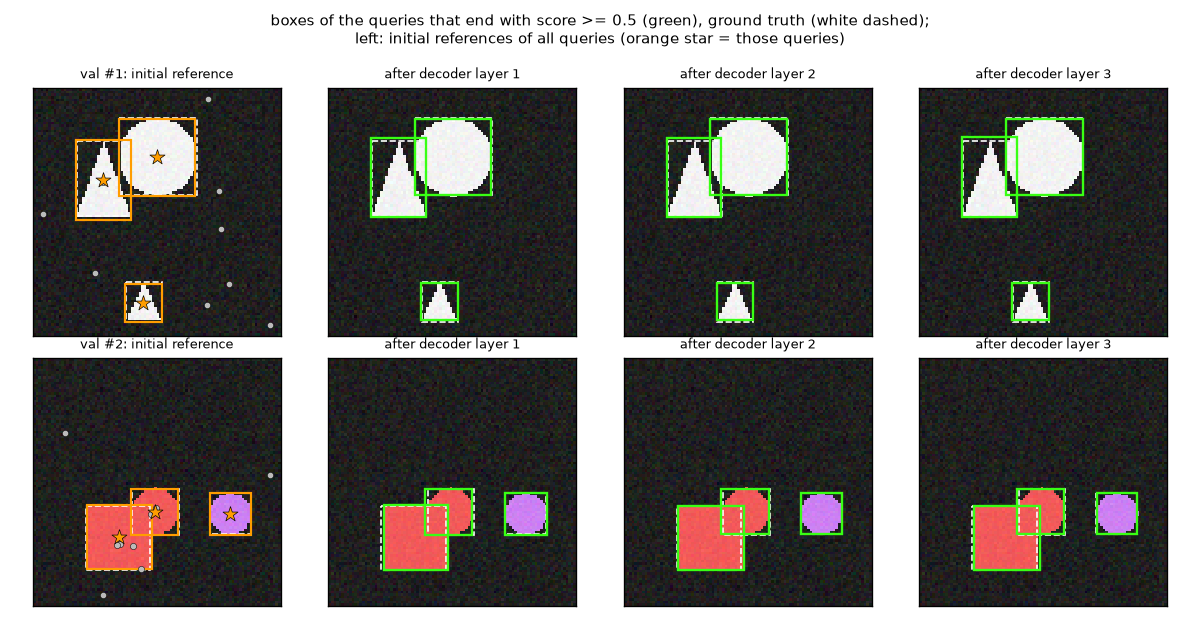
그림 8-11 을 그림 8-7 과 나란히 보라. 1단계 모델의 처음 기준은 그림과 무관한 점 이었다. 2단계 모델의 처음 기준은 이미 객체를 감싼 박스 이고, 그림마다 다르다. 디코더가 할 일은 그것을 조금 다듬고, 같은 객체에 몰린 제안들 가운데 하나만 남기는 것이다(회색 점 몇 개가 객체 안에 있다. 끝에 점수가 0.5 아래로 남은 제안들이고, 아마 같은 객체를 가리킨 제안일 것이다).
이 결과가 좋은 데에는 이 데이터의 사정이 있다. 7장에서 만든 백본은 수용 영역(출력 한 칸이 내려다보는 입력의 범위)이 43픽셀로 가장 큰 도형을 덮으므로, 칸 하나의 특징에 객체 전체의 정보가 이미 들어 있다. COCO 에서도 제안만으로 이만큼 된다는 뜻이 아니다. 그래도 방향은 논문과 같다. 논문 표 1 에서 2단계 변형은 반복 정제만 쓴 모델보다 AP 가 0.8 높다(45.4 → 46.2). RF-DETR 은 이 2단계 질의 선택을 기본으로 쓴다.
기대와 달랐던 것들
좋은 숫자만 골라 읽지 않도록, 이 실험에서 기대와 달랐거나 설명하지 못한 것을 모아 둔다.
- AP50 은 7장의 DETR 이 더 높다. 최종 AP50 이 7장 0.9863, 이 장 0.9795 이다. AP 와 AP75 는 이 장이 높다. 곧 "박스를 정확히 맞히기" 는 이 장의 모델이, "객체를 빠짐없이 찾아 알맞은 클래스와 순위로 내기" 는 이 실험에서 7장의 모델이 조금 앞섰다. 점수 0.5 이상인 예측의 수도 같은 방향이다. 정답 객체는 1,265개인데 이 장의 모델은 1,206개, 7장의 모델은 1,290개를 냈다. 놓쳤거나 점수를 낮게 준 객체가 더 있다는 뜻이고, 그림 8-8 의 #3 에서 놓친 삼각형이 그 한 예이다. 원인은 분석하지 않았다. 짐작할 수 있는 후보는 포컬 손실로 학습한 점수가 낮게 나오는 경향, 질의 12개의 고정된 기준점, 한 질의가 두 클래스로 뽑힐 수 있는 후처리이다. 2단계 모델은 AP50 이 0.9921 로 이 차이가 없다.
- 빠른 수렴을 변형 어텐션만의 효과로 볼 수 없다. 앞에서 말한 대로 함께 바뀐 것이 여럿이고, 절제에서 가장 큰 몫을 보인 것은 박스 반복 정제였다.
- 12×12 맵에서 변형 어텐션은 빠르지 않았다. 교차 어텐션 한 번의 시간이 보통 어텐션보다 2.6배 길었다. 이득은 맵이 클 때 나타난다.
- 다중 스케일과 인코더의 효과는 보이지 않았다. 차이가 우연 범위(±0.02) 안이다.
- 4장의 실험과 맞닿는 점. 4장의 불균형 분류 실험에서도 포컬 손실이 언제나 이기지는 않았다. 손실 하나를 바꾼 효과는 과제와 설정에 따라 다르고, 이 장은 그 효과를 따로 재지 않았다.
논문이 보고한 것
미니 실험과 섞이지 않게, 논문이 COCO 에서 보고한 숫자를 따로 적어 둔다(Deformable DETR 논문 표 1, ResNet-50 백본, COCO 2017 검증 세트).
| 모델 | 에폭 | AP | AP50 | AP75 | APS (작은 객체) | 학습 GPU 시간 | 추론 FPS |
| Faster R-CNN + FPN | 109 | 42.0 | 62.1 | 45.5 | 26.6 | 380 | 26 |
| DETR | 500 | 42.0 | 62.4 | 44.2 | 20.5 | 2000 | 28 |
| DETR-DC5 | 500 | 43.3 | 63.1 | 45.9 | 22.5 | 7000 | 12 |
| DETR-DC5 | 50 | 35.3 | 55.7 | 36.8 | 15.2 | 700 | 12 |
| DETR-DC5+ (포컬 손실, 질의 300개) | 50 | 36.2 | 57.0 | 37.4 | 16.3 | 700 | 12 |
| Deformable DETR | 50 | 43.8 | 62.6 | 47.7 | 26.4 | 325 | 19 |
| + 박스 반복 정제 | 50 | 45.4 | 64.7 | 49.0 | 26.8 | 325 | 19 |
| ++ 2단계 | 50 | 46.2 | 65.2 | 50.0 | 28.8 | 340 | 19 |
- 에폭 수. Deformable DETR 은 50 에폭으로 AP 43.8 을 내, 500 에폭을 학습한 DETR(42.0)과 DETR-DC5(43.3)를 넘는다. 논문의 표현은 "10분의 1 의 학습 에폭으로 더 나은 성능" 이다. 같은 50 에폭만 학습한 DETR-DC5 는 35.3 이다.
- 작은 객체. 작은 객체의 AP 가 DETR 20.5 에서 26.4 로 올라, 다중 스케일 특징을 쓰는 Faster R-CNN + FPN(26.6)과 비슷해진다.
- 정제와 2단계. 박스 반복 정제가 AP 를 1.6(43.8 → 45.4), 2단계가 다시 0.8(→ 46.2) 올린다.
- 속도. 추론은 초당 19장으로 DETR-DC5(12장)보다 빠르고, 특징 맵 한 장만 쓰는 DETR(28장)과 Faster R-CNN + FPN(26장)보다 느리다.
이 장의 미니 실험과 견주면, "적은 에폭에 높은 AP", "정제의 이득", "2단계의 이득" 은 방향이 같았다. "작은 객체에 강하다" 와 "다중 스케일의 이득" 은 도형 세상에서 확인하지 못했다. 그리고 논문의 500 에폭 대 50 에폭이라는 열 배의 차이는 COCO 의 것이다. 도형 세상에서는 7장의 DETR 도 60 에폭이면 AP 0.84 에 이르렀다.
정리
- Deformable DETR 논문은 DETR 의 느린 수렴과 작은 객체에서의 약함을 어텐션이 특징 맵을 다루는 방식에서 찾는다. 처음에는 모든 칸을 거의 고르게 보고(\(\approx 1/N_k\)), 인코더의 자기 어텐션 비용이 칸 수의 제곱이라 큰 맵을 쓸 수 없다.
- 변형 어텐션은 질의마다 기준점 \(p_q\) 둘레의 표본점 \(M \cdot L \cdot K\) 개만 읽는다. 오프셋 \(\Delta p\) 와 가중치 \(A\) 는 열쇠와의 내적 없이 질의 벡터 \(z_q\) 에서 선형 층으로 예측한다.
- 쌍선형 보간은 네 이웃의 가중 평균이다: 가중치는 \((1 - t_x)(1 - t_y)\), \(t_x(1 - t_y)\), \((1 - t_x)t_y\), \(t_x t_y\) 이고 합이 1. 칸 눈금은 \(u_x = xW - 0.5\)(
align_corners=False), 맵 밖은 0. - 읽은 값은 표본 위치로 미분된다: \(\partial v / \partial x = W[(1 - t_y)(v_{01} - v_{00}) + t_y(v_{11} - v_{10})]\). 그래서 오프셋을 정답 없이 경사 하강법으로 배운다. 기울기는 네 이웃만 본다.
- 기준이 점이면 오프셋의 단위는 그 레벨의 칸(\(\Delta p / (W_l, H_l)\)), 기준이 박스면 박스 절반 크기의 \(1/K\)(\(\Delta p / K \cdot (w, h)/2\))이다. 가중치는 머리마다 \(L \cdot K\) 개에 걸쳐 소프트맥스한다. 처음에는 여덟 방향으로 \(k\) 칸씩, 가중치는 \(1/(LK)\).
- 읽는 (질의, 자리) 쌍은 \(N_q \cdot HW\) 에서 \(N_q \cdot MLK\) 로 줄지만, 값 투영은 여전히 모든 칸에 한다. 이 장의 측정에서 변형 어텐션은 작은 맵에서 오히려 느렸고 큰 맵에서 뒤집혔다.
- 박스는 기준에서 고친다: \(\hat{b}^{d} = \sigma(\Delta b^{d} + \sigma^{-1}(\operatorname{sg}(\hat{b}^{d-1})))\), \(\sigma^{-1}(x) = \log\frac{x}{1-x}\). 로짓 공간에서 더하므로 0 – 1 을 벗어나지 않고, 다음 층으로 넘길 때 기울기를 끊는다.
- 분류는 ∅ 없는 클래스별 시그모이드와 포컬 손실, 매칭의 분류 비용은 "양성으로 볼 때의 손실 − 음성으로 볼 때의 손실", 전체 비용은 \(2\,C_{\text{cls}} + 5\,\lVert \hat{b}_i - b_j \rVert_1 - 2\,\operatorname{GIoU}\).
- 2단계 질의 선택은 모든 칸이 제안 박스(칸 중심, 크기 \(0.05 \cdot 2^{l}\) 에서 출발)와 점수를 내고 상위 \(N\) 개를 디코더의 기준 박스로 쓴다.
- 도형 세상에서 이 장의 모델은 7장보다 훨씬 빨리 배웠고(AP 0.8 까지 7 에폭 대 50 에폭) 최종 AP 도 높았다(0.898 대 0.838). 그러나 그 까닭을 변형 어텐션 하나로 돌릴 수 없고, AP50 은 7장이 더 높았다. 절제에서는 박스 반복 정제와 2단계의 차이가 뚜렷했다(시드 하나).
DETR 은 탐지를 집합 예측으로 만들었고, Deformable DETR 은 그것을 빨리 배우고 큰 특징 맵을 감당하는 모델로 바꿨다. 기준점 둘레만 읽는 변형 어텐션, 기준에서 고쳐 나가는 박스, 그림을 보고 고르는 질의는 모두 RF-DETR 의 디코더가 형태를 조금씩 바꿔 물려받았다. 남은 숙제는 속도이다. 논문의 Deformable DETR 은 초당 19장으로, 실시간과는 거리가 있다. 9장에서는 이 계보를 빠르게 만드는 이야기를 한다. RT-DETR 이 DETR 계열을 실시간 탐지기로 만든 방법과, LW-DETR 이 ViT 백본 · 윈도 어텐션 · 얕은 변형 디코더로 RF-DETR 의 직접적인 뼈대를 세운 과정을 본다.
확인 문제
- 1. 쌍선형 보간 손계산 — 2×2 특징 맵의 값이 행 0 이 \((0,\ 10)\), 행 1 이 \((20,\ 40)\) 이다. 점 \((x, y) = (0.4,\ 0.7)\) 에서 읽은 값을 구하라. 네 가중치의 합이 1 인지도 확인하라.
- \(u_x = 0.4 \times 2 - 0.5 = 0.3\), \(u_y = 0.7 \times 2 - 0.5 = 0.9\) 이므로 왼쪽 위 이웃은 (행 0, 열 0), \(t_x = 0.3\), \(t_y = 0.9\) 이다.
- 가중치는 \(0.7 \times 0.1 = 0.07\), \(0.3 \times 0.1 = 0.03\), \(0.7 \times 0.9 = 0.63\), \(0.3 \times 0.9 = 0.27\) 이고 합은 1 이다.
- 값은 \(0.07 \times 0 + 0.03 \times 10 + 0.63 \times 20 + 0.27 \times 40 = 0 + 0.3 + 12.6 + 10.8 = 23.7\) 이다.
- 2. 표본 위치에 대한 기울기 — 문제 1 의 상황에서 \(\partial v / \partial x\) 와 \(\partial v / \partial y\) 를 구하라. 표본점을 \(x\) 방향으로 \(0.01\) 옮기면 읽은 값이 얼마가 될지 기울기로 어림하라.
- \(\partial v / \partial x = W\,[(1 - t_y)(v_{01} - v_{00}) + t_y(v_{11} - v_{10})] = 2 \times [0.1 \times 10 + 0.9 \times 20] = 2 \times 19 = 38\).
- \(\partial v / \partial y = H\,[(1 - t_x)(v_{10} - v_{00}) + t_x(v_{11} - v_{01})] = 2 \times [0.7 \times 20 + 0.3 \times 30] = 2 \times 23 = 46\).
- \(x\) 를 \(0.01\) 옮기면 \(23.7 + 38 \times 0.01 = 24.08\) 이다. 보간식이 \(t_x\) 에 대해 직선이므로, 같은 네 이웃 안에서는 이 어림이 정확한 값이다.
- 3. 좌표 규약 — 정규화 좌표 \((0.5,\ 0.5)\) 를 (가) 3×3 특징 맵과 (나) 12×12 특징 맵에서 읽으면 각각 어느 칸들이 어떤 가중치로 쓰이는가?
- (가) \(u_x = u_y = 0.5 \times 3 - 0.5 = 1.0\). 정확히 (행 1, 열 1) 칸의 중심이므로 \(t_x = t_y = 0\) 이고, 그 칸의 값이 가중치 1 로 그대로 나온다. 본문의 맵이라면 5 이다.
- (나) \(u_x = u_y = 0.5 \times 12 - 0.5 = 5.5\). 열 5 와 열 6, 행 5 와 행 6 의 한가운데이므로 \(t_x = t_y = 0.5\) 이고, 네 칸 (5, 5), (5, 6), (6, 5), (6, 6) 이 가중치 \(0.25\) 씩으로 쓰인다.
- 칸 수가 홀수면 그림의 중심이 칸의 중심이고, 짝수면 네 칸이 만나는 모서리이다. "정규화 좌표에 \(W\) 를 곱하면 열 번호" 라고 여기고 0.5 를 빼지 않으면 반 칸 어긋난다.
- 4. 표본점의 자리 — 오프셋이 \(\Delta p = (2,\ -1)\) 이다. (가) 기준이 점 \((0.30,\ 0.60)\) 일 때 12×12 레벨과 6×6 레벨에서의 표본점을 구하라. (나) 기준이 박스 \((c_x, c_y, w, h) = (0.30,\ 0.60,\ 0.20,\ 0.40)\) 이고 \(K = 4\) 일 때의 표본점을 구하라.
- (가) 12×12: \((0.30 + 2/12,\ 0.60 - 1/12) = (0.4667,\ 0.5167)\). 6×6: \((0.30 + 2/6,\ 0.60 - 1/6) = (0.6333,\ 0.4333)\). 같은 오프셋이 거친 레벨에서 두 배 멀리 간다.
- (나) \(\big(0.30 + \tfrac{2}{4} \times \tfrac{0.20}{2},\ \ 0.60 - \tfrac{1}{4} \times \tfrac{0.40}{2}\big) = (0.30 + 0.05,\ 0.60 - 0.05) = (0.35,\ 0.55)\). 레벨의 크기와 무관하고, 박스가 두 배로 커지면 표본점도 중심에서 두 배 멀어진다.
- 5. 연산 수 세기 — RF-DETR Medium 은 해상도 576, 패치 16, 질의 300개이고, 디코더 교차 어텐션은 머리 16개 · 레벨 1개 · 표본점 2개이다. (가) 특징 맵의 칸 수, (나) 보통 교차 어텐션이었다면 한 번에 읽을 (질의, 자리) 쌍의 수, (다) 변형 어텐션이 읽는 쌍의 수와 그 비를 구하라. (라) 논문의 기본값 \(M = 8\), \(L = 4\), \(K = 4\) 에서 오프셋을 내는 선형 층의 출력은 몇 개인가?
- (가) \(576 / 16 = 36\) 이므로 \(36 \times 36 = 1{,}296\) 칸.
- (나) \(300 \times 1{,}296 = 388{,}800\) 쌍.
- (다) \(300 \times 16 \times 1 \times 2 = 9{,}600\) 쌍. 비는 \(388{,}800 / 9{,}600 = 40.5\) 배이다. 다만 본문에서 보았듯 이것은 "읽는 자리" 의 비이고, 전체 곱셈 횟수나 실제 시간의 비가 아니다.
- (라) \(2MLK = 2 \times 8 \times 4 \times 4 = 256\) 개(가중치 층은 \(MLK = 128\) 개).
- 6. 역시그모이드와 박스 정제 — 기준 박스의 중심 \(x\) 좌표가 \(0.25\) 이고 박스 머리가 \(\Delta b_x = 0.4\) 를 냈다. (가) 새 좌표를 구하라(\(\log 3 = 1.0986\), \(e^{0.6986} = 2.0110\)). (나) 좌표를 정확히 \(0.5\) 로 옮기려면 \(\Delta b_x\) 가 얼마여야 하는가?
- (가) \(\sigma^{-1}(0.25) = \log\frac{0.25}{0.75} = -\log 3 = -1.0986\). 더하면 \(-1.0986 + 0.4 = -0.6986\). \(\sigma(-0.6986) = \frac{1}{1 + e^{0.6986}} = \frac{1}{3.0110} = 0.3321\).
- (나) \(\sigma^{-1}(0.5) = 0\) 이어야 하므로 \(\Delta b_x = 0 - (-1.0986) = 1.0986\). 오즈로 보면 \(1/3\) 을 \(1\) 로, 곧 3배(\(= e^{1.0986}\))로 만드는 것이다.
- 7. 포컬 매칭 비용 — 어떤 예측이 정답의 클래스 칸에 준 확률이 \(\hat{p} = 0.5\) 이다. \(\alpha = 0.25\), \(\gamma = 2\) 로 분류 비용 \(C_{\text{cls}}\) 를 구하라(\(-\log 0.5 = 0.6931\)). \(\hat{p} = 0.9\) 인 다른 예측(본문에서 \(-1.3986\))과 견주어, 박스 비용이 같다면 매칭은 어느 쪽을 고르는가?
- 양성으로 볼 때의 손실: \(0.25 \times 0.5^2 \times 0.6931 = 0.0433\). 음성으로 볼 때의 손실: \(0.75 \times 0.5^2 \times 0.6931 = 0.1300\).
- \(C_{\text{cls}} = 0.0433 - 0.1300 = -0.0866\) (반올림 전의 값 \(0.04332 - 0.12997\) 로 계산).
- 비용이 더 작은 \(\hat{p} = 0.9\) 인 예측(\(-1.3986\))을 고른다. 전체 비용에서는 이 차이에 계수 2 가 곱해진다.
- 8. 실험에서 말할 수 있는 것 — 이 장의 모델은 AP 0.8 에 7 에폭 만에 닿았고 7장의 MiniDETR 은 50 에폭이 걸렸다. 이 결과만으로 "변형 어텐션이 수렴을 빠르게 한다" 고 결론 내릴 수 없는 까닭을 설명하고, 그 주장을 직접 확인하려면 어떤 실험을 하면 될지 하나 제안하라.
- 두 모델 사이에 바뀐 것이 여럿이기 때문이다. 교차 어텐션의 종류뿐 아니라 기준점에 대한 박스 예측과 층별 정제, 층마다 따로 둔 머리, 포컬 손실과 사전 확률 편향 초기화, ∅ 없는 시그모이드 분류와 매칭 비용, 인코더의 유무, 특징 레벨 수가 함께 달라졌다. 절제 실험에서 박스 반복 정제를 빼는 것만으로 15 에폭 AP 가 0.8763 에서 0.7500 으로 내려갔으므로, 빠른 수렴의 큰 몫이 변형 어텐션이 아닌 다른 곳에 있을 수 있다. 게다가 시드가 하나이다.
- 확인하려면 한 가지만 다른 두 모델을 견주어야 한다. 예를 들어 7장의 MiniDETR 에서 분류만 포컬 손실 · 시그모이드로 바꾼 모델을 학습해 손실의 몫을 재거나(논문 표 1 의 DETR-DC5+ 가 이런 실험이다), 이 장의 모델에서 교차 어텐션만 보통 어텐션으로 되돌리고 나머지(기준에서의 박스 예측, 포컬 손실)는 그대로 둔 모델을 학습해 견주면 된다. 어느 쪽이든 시드를 여러 개 써야 한다.
See also
Favorite site
- 08. Deformable DETR: 필요한 곳만 보기
- ch08_deformable.py - 이 장의 실습 코드
- Deformable DETR: Deformable Transformers for End-to-End Object Detection (Zhu 외, ICLR 2021)
- Deformable Convolutional Networks (Dai 외, 2017)