RF-DETR:Tutorial:11-Training
lastmod 2026-11-18created 2026-11-1813 edits
RF-DETR 의 학습은 RF-DETR 튜토리얼의 11장이다. 10장에서 조립한 구조는 “어떤 함수를 쓸 것인가” 까지만 정하고, 그 함수의 가중치를 무엇을 줄이는 방향으로, 어떤 규칙으로 고쳐 나갈지는 따로 정해야 한다. 이 장은 RF-DETR 의 전체 손실을 한 식으로 쓰고 손으로 끝까지 계산한 다음, 논문과 공개 코드가 쓰는 학습 설정(일정한 학습률, 기울기 자르기, 지수 이동 평균, 층별 학습률 감쇠, 단순한 증강)을 하나씩 식 · 손계산 · 구현으로 풀어 본다. 그리고 미니 RF-DETR 을 실제로 학습해 결과와 절제 실험을 읽는다. 기대대로 나온 것도, 기대와 달랐던 것도 그대로 적는다. 여기서 학습한 체크포인트는 12장의 가중치 공유 NAS 와 13장의 출발점이 된다.
- 원문: 11. RF-DETR 의 학습
- 실습 코드:
code/ch11_train.py. 손실(RFDETRCriterion), EMA(ModelEMA), 매개변수 그룹과 옵티마이저, 학습 고리를 담는다. 본 실험(60 에폭 학습 + 분석)은 약 17분이고, 절제 실험과 백본 사전 학습 실험은 따로 돈다. 원문 기준 읽는 시간 약 110분, 난이도 ★★★★☆. - 이전: 10. RF-DETR 의 구조 / 다음: 12. 가중치 공유 NAS
- 이 장에서 배우는 것
- RF-DETR 의 전체 손실: 질의 묶음마다 · 층마다 따로 매칭하고, 분류(IA-BCE) · L1 · GIoU 세 손실을 계수 1 · 5 · 2 로 더하는 식
- 손실 항이 몇 개인지 세고, 질의 세 개짜리 예를 손으로 끝까지 계산해 코드와 맞추기
- 인코더 제안과 모든 디코더 층에 손실을 거는 이유
- 옵티마이저 설정과 기울기 누적, 그리고 워밍업 · 스케줄러 없는 학습: 코사인 스케줄이 학습 길이를 미리 알아야 하는 이유를 식으로
- 기울기 자르기의 식과 손계산, Adam 계열과 함께 쓸 때의 뜻
- 지수 이동 평균(EMA): “최근 약 \(1/(1 - d)\) 스텝의 평균” 이라는 말의 유도, 공식 구현의 감쇠 워밍업
- 층별 학습률 감쇠: 공식 코드의 실제 식으로 열두 블록의 배율 표를 손으로 만들기
- 증강 · 다중 해상도 학습 · 사전 학습의 사다리(DINOv2 → Objects365 → 목표 데이터)
- 미니 RF-DETR 의 학습 결과와 절제 실험 다섯 가지를 읽고, 말할 수 있는 것과 없는 것 가르기
구조 다음은 학습이다
지금까지 만든 것을 한 줄로 줄이면 이렇다. 그림 (B, 3, H, W) 가 백본(윈도 어텐션을 섞은 ViT)과 프로젝터를 거쳐 특징 맵이 되고, 특징 맵의 모든 칸이 제안 박스를 내고, 그 가운데 점수가 높은 \(N\) 칸이 디코더의 기준 박스가 되고, 디코더 층들이 질의를 다듬어 층마다 (B, N, K) 의 클래스 로짓과 (B, N, 4) 의 박스를 낸다(\(K\) 는 클래스 수). 이 장의 미니 모델은 가중치가 1,832,707개이다(학습 때. 추론 때는 첫 질의 묶음만 써서 1,675,870개). 지금 이 가중치들은 난수이다.
학습이란 이 가중치를 고치는 일이고, 고치려면 세 가지를 정해야 한다.
- 무엇을 줄일 것인가. 손실 함수이다. 예측과 정답이 얼마나 다른지를 숫자 하나로 만든다.
- 어떻게 고칠 것인가. 옵티마이저와 그 설정이다. 학습률, 배치 크기, 기울기를 다듬는 규칙이 여기 들어간다.
- 무엇에서 출발하고 무엇을 보여 줄 것인가. 가중치의 초기값(사전 학습)과 데이터 증강이다.
RF-DETR 논문은 이 가운데 둘째와 셋째를 일부러 단순하게 잡는다. 1장에서 본 대로, 논문의 문제의식은 “COCO 한 곳에 맞춰 공들여 조정한 학습 절차는 다른 데이터에서 잘 통하지 않는다” 는 것이다. 그래서 논문 부록 A 가 적는 설정은 짧다.
| 항목 | RF-DETR (논문 부록 A · 3절) | 이 장의 어디에서 |
| 학습률 | 1e-4 (논문은 “LW-DETR 은 4e-4” 라고 견준다) | 옵티마이저와 학습률 |
| 배치 크기 | 128 (LW-DETR 과 같음) | 배치 크기와 기울기 누적 |
| 학습률 워밍업 | 없음 | 워밍업도 없다 |
| 학습률 스케줄 | 코사인 스케줄을 쓰지 않는 “스케줄러 없는(scheduler-free)” 학습 | 코사인 스케줄은 끝을 알아야 한다 |
| 기울기 자르기 | 0.1 | 기울기 자르기 |
| EMA | 사용(EMA 스케줄러와 함께) | 지수 이동 평균 |
| 층별 학습률 감쇠 | DINOv2 백본에 층마다 0.8배 | 층별 학습률 감쇠 |
| 증강 | 수평 뒤집기와 무작위 자르기만 | 증강과 다중 해상도 |
| 다중 해상도 | 0.5 – 1.5배, 배치 단위(LW-DETR 은 0.7 – 1.4배, 그림 단위) | 증강과 다중 해상도 |
| 사전 학습 | DINOv2 백본 + Objects365 탐지 사전 학습 | 사전 학습의 사다리 |
손실 함수의 식은 논문이 따로 적지 않다(LW-DETR 을 확장했다고 밝히고, 모든 디코더 층에 손실을 건다는 것만 적는다). 그래서 손실은 공개 코드(rfdetr 의 models/criterion.py, models/matcher.py)에서 읽은 대로 적는다. 이 장에서 “공식 구현” 이라고 하면 이 공개 코드를 가리키고, “논문” 이라고 하면 RF-DETR 논문(Robinson 외, ICLR 2026)을 가리킨다. 둘이 다른 곳은 그때마다 구별한다.
무엇을 최소화하는가
손실의 부품은 앞 장들에서 모두 만들었다. 이 절은 새 부품을 만들지 않고, 부품들이 어떤 순서로 몇 번씩 쓰이는지를 한 식으로 모은다.
- 7장: 헝가리안 매칭으로 예측과 정답을 일대일로 짝짓고, 짝에 대해 손실을 계산하는 집합 손실. 디코더 층마다 거는 보조 손실.
- 8장: ∅ 클래스 없는 시그모이드 분류, 포컬 꼴의 매칭 비용, 2단계 질의 선택(인코더 제안).
- 9장: IoU 인지 BCE 손실(IA-BCE)과 Group DETR(질의 묶음).
- 10장: 이 부품들이 붙는 모델의 출력 구조.
손실을 거는 네 자리
미니 RF-DETR 이 학습 때 내는 출력에는 (클래스 로짓, 박스) 쌍이 네 벌 들어 있다. 디코더 3층 각각의 출력과, 디코더에 들어가기 전의 인코더 제안이다. 이 넷을 자리 라고 부르겠다. 손실은 네 자리 모두에 같은 방법으로 걸린다.
원문 그림 11-1. 미니 RF-DETR(디코더 3층)의 손실이 걸리는 네 자리. 자리마다 예측이 다르므로 매칭도 자리마다 새로 한다. 그림의 흐름은 다음과 같다.
- 백본 + 프로젝터가 특징 맵을 내고, 상위 \(N\) 칸 선택으로 인코더 제안이 나온다. 이어서 디코더 1층 → 2층 → 3층이 차례로 예측을 내며, 3층의 것이 추론 때의 출력이다.
- 네 자리(인코더 제안, 디코더 1층, 2층, 3층)가 각각 로짓 · 박스를 내고, 자리마다 묶음별 매칭을 한 뒤 분류 · L1 · GIoU 세 손실을 건다.
- “이름 끝” 은 손실 사전에서 그 자리의 손실 이름에 붙는 접미사다. 인코더 제안은
_enc, 디코더 1층은_0, 2층은_1, 마지막 층은 접미사가 없다(예:loss_ce_enc,loss_ce_0,loss_ce). - 정답 박스 · 클래스는 네 자리가 똑같이 쓴다.
- 전체 손실 = 네 자리의 (1 · 분류 + 5 · L1 + 2 · GIoU) 를 모두 더한 값.
그림에서 읽을 것은 두 가지이다. 첫째, 네 자리의 아래쪽 상자가 모두 같은 내용 이다. 자리마다 다른 손실을 쓰지 않는다. 둘째, 접미사가 없는 것이 마지막 디코더 층이고, _0, _1 은 앞 층들(보조 손실), _enc 는 인코더 제안이다. 이 이름은 공식 구현의 학습 로그에 그대로 나오므로(14장) 기억해 둘 만하다.
한 자리의 손실
자리 하나를 골라 그 안에서 일어나는 일을 차례로 적는다. 기호부터 정한다.
- \(B\): 배치의 그림 수. \(T\): 배치에 든 정답 객체의 수(모든 그림의 합). 그림 한 장의 정답을 \(j\) 로 세고, 정답 \(j\) 의 클래스를 \(c_j\), 박스를 \(b_j\) 라 쓴다.
- \(N\): 질의 묶음 하나의 질의 수(미니 모델 12, 공식 300). \(G\): 묶음 수(미니 모델 4, 공식 13). 학습 때 질의는 모두 \(G \cdot N\) 개이다. 묶음을 \(g = 1, \dots, G\) 로 센다.
- \(\hat{p}_i(c)\): 질의 \(i\) 가 클래스 \(c\) 에 준 확률(로짓의 시그모이드). \(\hat{b}_i\): 질의 \(i\) 의 예측 박스. 박스는 모두 정규화한 \((c_x, c_y, w, h)\) 이다.
① 묶음마다 따로 매칭한다. 묶음 \(g\) 의 질의 \(N\) 개와 그 그림의 정답들 사이에 비용 행렬을 만든다. 칸 \((i, j)\) 의 비용은
\(C_{ij} \;=\; 2\,C_{\text{cls}}(i, j) \;+\; 5\,\lVert \hat{b}_i - b_j \rVert_1 \;+\; 2\,\big(-\operatorname{GIoU}(\hat{b}_i, b_j)\big)\)
이고, 분류 비용 \(C_{\text{cls}}\) 는 8장의 포컬 꼴이다. \(\hat{p} = \hat{p}_i(c_j)\) 로 줄여 쓰면
\(C_{\text{cls}}(i, j) = \alpha\,(1 - \hat{p})^{\gamma}\,(-\log \hat{p}) \;-\; (1 - \alpha)\,\hat{p}^{\,\gamma}\,\big(-\log(1 - \hat{p})\big), \qquad \alpha = 0.25,\ \gamma = 2\)
이다. 헝가리안 알고리즘이 비용의 합이 가장 작은 일대일 배정을 찾고, 그 결과를 \(\hat{\sigma}_g\)(시그마 햇)라 쓴다. \(\hat{\sigma}_g(j)\) 는 “묶음 \(g\) 에서 정답 \(j\) 의 짝이 된 질의의 번호” 이다. 묶음이 \(G\) 개이므로 정답 하나가 짝을 \(G\) 개 얻는다(묶음마다 하나씩). 7장에서 본 대로 매칭에는 기울기가 흐르지 않는다. 짝을 정하는 데만 쓰인다.
- 참고 · 매칭 비용의 계수와 손실의 계수는 다르다
- 매칭 비용의 계수는 (분류 2, L1 5, GIoU 2)이고, 바로 아래에 나올 손실의 계수는 (분류 1, L1 5, GIoU 2)이다. 분류 쪽만 다르다. 매칭 비용의 분류 항은 포컬 꼴이고 손실의 분류 항은 IA-BCE 여서 식도 다르다. 둘 다 공식 구현의 기본값에서 읽은 것이다(
set_cost_class=2,cls_loss_coef=1.0). 짝을 고르는 기준과, 고른 짝으로 가중치를 고치는 기준이 꼭 같을 필요는 없다.
② 분류 손실: IA-BCE. 9장에서 유도한 손실이다. 짝이 된 질의 \(i = \hat{\sigma}_g(j)\) 의 “정답 클래스 칸” \((i, c_j)\) 에는 0 과 1 사이의 부드러운 목표 \(t\) 를 준다.
\(t = \hat{p}^{\,\alpha}\, u^{\,1 - \alpha}, \qquad u = \operatorname{IoU}(\hat{b}_i, b_j), \qquad \alpha = 0.25\)
\(u\) 는 지금 이 예측 박스가 정답 박스와 얼마나 겹치는지이다. 목표는 상수로 취급한다(기울기 차단). 공식 구현은 \(t\) 가 0.01 보다 작으면 0.01 로 올린다. 칸마다의 손실은 다음과 같다.
\(f_{\text{cls}}(i, c) = \begin{cases} -\,t \log \hat{p} \;-\; (1 - t)\log(1 - \hat{p}) & \text{짝이 된 칸 } (i, c) = (\hat{\sigma}_g(j),\, c_j) \\ -\,\hat{p}^{\,\gamma} \log(1 - \hat{p}) & \text{그 밖의 모든 칸}, \quad \gamma = 2 \end{cases}\)
윗줄은 목표가 \(t\) 인 BCE(4장의 “부드러운 목표”)이고, 아랫줄은 목표가 0 인 BCE 에 \(\hat{p}^2\) 을 곱한 것이다. “그 밖의 모든 칸” 에는 짝이 없는 질의의 모든 클래스 칸과, 짝이 된 질의의 다른 클래스 칸이 들어간다. 9장의 요점만 다시 적으면, 윗줄을 로짓으로 미분한 값은 \(\hat{p} - t\) 이고 이것이 0 이 되는 곳은 \(\hat{p} = t = \hat{p}^{\alpha} u^{1 - \alpha}\), 곧 \(\hat{p} = u\) 이다. 점수가 박스의 IoU 를 향해 끌려간다. 이 성질이 실제로 나타나는지는 이 장 뒤쪽의 실험에서 확인한다.
③ 박스 손실: L1 과 GIoU. 짝이 된 (예측 박스, 정답 박스)에 대해 2장의 L1 거리와 \(1 - \operatorname{GIoU}\) 를 계산한다. 짝이 없는 질의의 박스에는 손실이 없다.
④ 모두 더해 한 수로 나눈다. 자리 \(\ell\)(엘)의 세 손실은
\(\begin{aligned} \mathcal{L}^{(\ell)}_{\text{cls}} &= \frac{1}{G \cdot T} \sum_{g=1}^{G} \;\sum_{i,\,c} f_{\text{cls}}(i, c) \\ \mathcal{L}^{(\ell)}_{\text{L1}} &= \frac{1}{G \cdot T} \sum_{g=1}^{G} \sum_{j} \big\lVert b_j - \hat{b}_{\hat{\sigma}_g(j)} \big\rVert_1 \\ \mathcal{L}^{(\ell)}_{\operatorname{GIoU}} &= \frac{1}{G \cdot T} \sum_{g=1}^{G} \sum_{j} \Big( 1 - \operatorname{GIoU}\big(b_j,\, \hat{b}_{\hat{\sigma}_g(j)}\big) \Big) \end{aligned}\)
이다. 첫 줄의 안쪽 합은 묶음 \(g\) 의 모든 질의 \(i\) 와 모든 클래스 \(c\) 에 걸친 합이고(배치의 모든 그림을 포함), 둘째 · 셋째 줄의 \(\sum_j\) 는 배치의 모든 정답에 걸친 합이다. 위첨자 \((\ell)\) 은 “자리 \(\ell\) 의 예측으로, 그 자리의 매칭으로 계산한” 이라는 뜻이다. 나누는 수 \(G \cdot T\) 를 공식 구현은 num_boxes 라 부른다.
전체 손실의 식
자리의 모임을 \(\mathcal{S}\) 라 하면(인코더 제안 + 디코더 각 층) 전체 손실은 다음 한 줄이다.
\(\mathcal{L} \;=\; \sum_{\ell \,\in\, \mathcal{S}} \Big( 1 \cdot \mathcal{L}^{(\ell)}_{\text{cls}} \;+\; 5 \cdot \mathcal{L}^{(\ell)}_{\text{L1}} \;+\; 2 \cdot \mathcal{L}^{(\ell)}_{\operatorname{GIoU}} \Big), \qquad \mathcal{S} = \{\text{enc},\ 1,\ 2,\ \dots,\ L_{\text{dec}}\}\)
\(L_{\text{dec}}\) 는 디코더 층의 수이다(미니 모델 3, Nano 2, Small 3, Medium 4). 역전파되는 것은 이 숫자 \(\mathcal{L}\) 하나이다. 7장의 보조 손실 식과 견주면 달라진 것이 세 가지이다. 합에 인코더 제안(\(\text{enc}\))이 들어왔고, 분류 손실이 소프트맥스 교차 엔트로피에서 IA-BCE 로 바뀌었고, 매칭과 합이 묶음마다 되풀이된다.
항의 수 세어 보기
식이 길어 보여도 세어 보면 단순하다. 손실 값의 수는 (자리의 수) × (손실의 종류 3) 이다.
| 모델 | 디코더 층 \(L_{\text{dec}}\) | 자리의 수 \(L_{\text{dec}} + 1\) | 손실 값의 수 | 학습 때 질의 수 \(G \cdot N\) |
| 미니 RF-DETR(이 튜토리얼) | 3 | 4 | \(4 \times 3 = 12\) | \(4 \times 12 = 48\) |
| RF-DETR Nano | 2 | 3 | \(3 \times 3 = 9\) | \(13 \times 300 = 3{,}900\) |
| RF-DETR Small | 3 | 4 | \(4 \times 3 = 12\) | \(3{,}900\) |
| RF-DETR Medium | 4 | 5 | \(5 \times 3 = 15\) | \(3{,}900\) |
Nano 의 9개는 14장에서 실제 rfdetr 패키지의 학습 기록에 나오는 열 이름 아홉 개와 같다: loss_ce, loss_bbox, loss_giou(마지막 층), loss_ce_0, loss_bbox_0, loss_giou_0(디코더 첫 층), loss_ce_enc, loss_bbox_enc, loss_giou_enc(인코더 제안). 이름의 ce 는 교차 엔트로피(cross-entropy)에서 온 옛 이름이고 실제 내용은 IA-BCE 이다.
묶음 수 \(G\) 는 이 표의 “손실 값의 수” 를 바꾸지 않는다. 묶음을 13개로 늘려도 손실 이름이 13배로 늘지 않는다. 묶음은 한 자리 안에서 질의의 수와 짝의 수를 늘릴 뿐이고, 그 결과는 자리마다 세 숫자로 합쳐진다. 대신 매칭 문제의 수는 늘어난다. 미니 모델에서 배치 32장을 한 스텝 학습하면 헝가리안 풀이가 (자리 4) × (그림 32) × (묶음 4) = 512번 돈다.
묶음 수로 나누는 정규화
나누는 수가 \(T\) 가 아니라 \(G \cdot T\) 인 데에는 뜻이 있다. 짝의 수가 묶음 수만큼 늘어나므로, 그만큼 나누어 주어야 손실의 크기가 묶음 수와 무관해진다.
- 묶음이 여럿일 때의 손실은 묶음별 손실의 평균이다
- \(\mathcal{L}_{g} \;=\; \frac{1}{T} \sum_{i,\,c \,\in\, \text{묶음 } g} f_{\text{cls}}(i, c)\)
- 묶음 \(g\) 하나만 있는 모델이었다면 계산했을 분류 손실이다. 묶음이 하나이므로 나누는 수는 \(1 \cdot T = T\) 이다.
- 묶음이 \(G\) 개일 때의 정의를 다시 적었다. 매칭이 묶음 안에서만 이루어지므로 칸마다의 손실은 묶음을 따로 계산했을 때와 같다.
- \(\frac{1}{G \cdot T}\) 를 \(\frac{1}{G} \cdot \frac{1}{T}\) 로 나누어 \(\frac{1}{T}\) 을 안쪽 합에 붙였다.
- 괄호 안이 첫 줄의 \(\mathcal{L}_g\) 이다. 전체 손실은 묶음별 손실의 평균 이다. L1 · GIoU 손실도 같은 이유로 그렇다.
실습 코드는 학습 전에 이것을 숫자로 확인한다. 무작위 초기화 모델에 그림 4장(정답 14개)을 넣었을 때의 출력이다.
[손실] 그림 4장 (정답 14개), 학습 모드: 질의 48개 = 12 × 묶음 4
  층 4개 (마지막 층, 앞 층 2개, 인코더 제안) 마다 짝 [56, 56, 56, 56]개 = 정답 14 × 묶음 4,  num_boxes = 56
  loss_ce 0.1228, loss_bbox 0.5585, loss_giou 0.9958, loss_ce_0 0.1229, loss_bbox_0 0.5673, loss_giou_0 1.0030, loss_ce_1 0.1209, loss_bbox_1 0.5568, loss_giou_1 0.9992, loss_ce_enc 0.1258, loss_bbox_enc 0.5604, loss_giou_enc 0.9976
  check 전체 손실 19.6987 = Σ_층 (1·ce + 5·bbox + 2·giou) = 19.6987
  check 마지막 층 loss_ce 0.122831 = 묶음별 loss_ce [0.1168, 0.1269, 0.1295, 0.1181] 의 평균 0.122831
- 짝이 자리마다 56개이다. 정답 14개가 묶음 4개에서 하나씩 짝을 얻어 \(14 \times 4 = 56\), 이것이 곧
num_boxes이다. - 넷째 줄: 열두 값에 계수 1 · 5 · 2 를 곱해 더한 값이 전체 손실 19.6987 과 같다.
- 다섯째 줄: 묶음을 하나씩 떼어 따로 계산한 분류 손실이 0.1168, 0.1269, 0.1295, 0.1181 이고 그 평균이 \((0.1168 + 0.1269 + 0.1295 + 0.1181)/4 = 0.4913/4 = 0.1228\) 로, 한꺼번에 계산한
loss_ce와 같다. 위 유도의 마지막 줄이다. - 갓 만든 모델이라 박스 손실이 크다.
loss_giou가 1.00 근처인 것은 \(\operatorname{GIoU} \approx 0\), 곧 예측 박스가 정답과 거의 겹치지 않는다는 뜻이다. 네 자리의 값이 서로 비슷한 것도 아직 디코더가 아무것도 다듬지 못하기 때문이다.
손으로 끝까지 계산하기
작은 예 하나를 매칭부터 전체 손실까지 손으로 계산해 본다. 그림 한 장, 자리 하나, 묶음 하나(\(G = 1\)), 질의 세 개, 정답 두 개이다. 클래스는 도형 세상의 셋(0 원, 1 사각형, 2 삼각형)이다.
| 원 | 사각형 | 삼각형 | 박스 \((c_x, c_y, w, h)\) | |
| 질의 0 의 확률 \(\hat{p}_0\) | 0.80 | 0.10 | 0.10 | (0.32, 0.30, 0.20, 0.20) |
| 질의 1 의 확률 \(\hat{p}_1\) | 0.10 | 0.10 | 0.60 | (0.70, 0.62, 0.20, 0.30) |
| 질의 2 의 확률 \(\hat{p}_2\) | 0.30 | 0.05 | 0.05 | (0.50, 0.50, 0.10, 0.10) |
| 정답 0 | 클래스 = 원 | (0.30, 0.30, 0.20, 0.20) | ||
| 정답 1 | 클래스 = 삼각형 | (0.70, 0.60, 0.20, 0.30) | ||
시그모이드 분류이므로 한 질의의 세 확률은 합이 1 일 필요가 없다. 질의 0 은 정답 0 에서 오른쪽으로 0.02, 질의 1 은 정답 1 에서 아래로 0.02 벗어나 있고, 질의 2 는 어느 정답과도 겹치지 않는 작은 박스이다.
- 1단계 · 매칭 비용 — 칸 (질의 0, 정답 0)
- \(\alpha\,(1 - \hat{p})^{\gamma}\,(-\log \hat{p}) = 0.25 \times 0.2^2 \times 0.22314 = 0.00223\)
- 정답 0 의 클래스는 원이고 질의 0 이 원에 준 확률은 \(\hat{p} = 0.8\) 이다. \(-\log 0.8 = 0.22314\). “짝지었을 때 이 칸이 받을 포컬 손실” 이다.
- \(-\log 0.2 = 1.60944\). “짝짓지 않았을 때 이 칸이 받을 포컬 손실” 이다.
- 둘의 차이다. 확률이 높은 칸일수록 짝짓는 쪽이 이득이므로 비용이 크게 음수가 된다.
- 네 좌표의 차의 절댓값을 더한다. 중심의 가로 좌표만 0.02 다르다.
- IoU 를 구하려고 모서리 표현 \((x_1, y_1, x_2, y_2)\) 로 바꾼다. 중심에서 너비 · 높이의 절반을 빼고 더한다.
- 두 박스의 넓이가 각각 \(0.2 \times 0.2 = 0.04\) 이다. 합집합은 포함 배제의 원리로 구한다.
- 둘러싸는 박스는 \((0.20, 0.20, 0.42, 0.40)\), 넓이 \(0.22 \times 0.20 = 0.044\) 로 합집합과 같다. 옆으로만 밀린 두 박스 사이에는 빈 곳이 없어 GIoU 가 IoU 와 같다.
- 계수 2 · 5 · 2 로 더한다. 클래스도 맞고 박스도 가까워 비용이 크게 음수이다.
- 1단계(계속) · 칸 (질의 2, 정답 0) 과 비용 행렬
- \(C_{\text{cls}} = 0.25 \times 0.7^2 \times 1.20397 - 0.75 \times 0.3^2 \times 0.35667 = 0.14749 - 0.02408 = 0.12341\)
- 질의 2 가 원에 준 확률은 \(\hat{p} = 0.3\) 이다. 앞 항의 로그는 \(-\log \hat{p} = -\log 0.3 = 1.20397\), 뒤 항의 로그는 \(-\log(1 - \hat{p}) = -\log 0.7 = 0.35667\) 로 서로 다른 수이다(헷갈리기 쉬운 곳). 확률이 낮아 비용이 양수이다. 짝지으면 손해라는 뜻이다.
- \((0.50, 0.50, 0.10, 0.10)\) 과 \((0.30, 0.30, 0.20, 0.20)\) 의 좌표별 차이다.
- 질의 2 의 모서리는 \((0.45, 0.45, 0.55, 0.55)\) 로 정답 0 과 겹치지 않아 \(\operatorname{IoU} = 0\), 합집합은 \(0.01 + 0.04 = 0.05\), 둘러싸는 박스는 \((0.20, 0.20, 0.55, 0.55)\) 로 넓이 \(0.35^2 = 0.1225\) 이다.
- 세 항이 모두 양수이다. 이 칸은 짝이 되기 어렵다.
- 나머지 네 칸도 같은 방법으로 계산한 결과이다(행 = 질의 0 · 1 · 2, 열 = 정답 0 · 1). 정답 둘에 서로 다른 질의를 하나씩 배정하는 방법은 \(3 \times 2 = 6\) 가지이고, 그 가운데 합이 가장 작은 것은 (질의 0 ↔ 정답 0, 질의 1 ↔ 정답 1)의 \(-3.0770 - 2.1039 = -5.1809\) 이다. 음수인 칸이 이 둘뿐이므로 다른 배정은 모두 이보다 크다. 질의 2 는 짝이 없다.
- 2단계 · 분류 손실(IA-BCE)
- \(t_0 = 0.8^{0.25} \times 0.81818^{0.75} = 0.94574 \times 0.86028 = 0.81360\)
- 짝 (질의 0, 원)의 목표이다. 점수 0.8 과 IoU 0.818 을 지수 0.25 · 0.75 로 섞는다. IoU 쪽 지수가 커서 목표는 IoU 에 가깝다.
- 목표가 \(t_0\) 인 BCE 이다. 점수 0.80 이 목표 0.81 과 거의 같은데도 손실이 0 이 아니다. 목표가 0 과 1 사이의 값이면 BCE 의 최솟값이 0 이 아니기 때문이다(아래 상자).
- 짝 (질의 1, 삼각형)의 목표이다. IoU 는 같은 방법으로 \(0.056 / 0.064 = 0.875\) 이다(교집합 \(0.20 \times 0.28\), 합집합 \(0.06 + 0.06 - 0.056\)).
- 점수 0.6 이 목표 0.80 보다 낮다. 이 칸의 기울기 \(\hat{p} - t = 0.6 - 0.796 \lt 0\) 은 점수를 올리라는 방향이다.
- 그 밖의 일곱 칸이다. 확률 0.1 인 칸이 넷(질의 0 의 사각형 · 삼각형, 질의 1 의 원 · 사각형), 짝 없는 질의 2 의 세 칸(0.3, 0.05, 0.05). \(\hat{p}^2 \cdot (-\log(1 - \hat{p}))\) 이므로 확률이 낮은 칸은 거의 0 이고, 0.3 인 칸 하나가 대부분을 차지한다.
- 아홉 칸의 손실을 모두 더해
num_boxes\(= 1 \times 2\) 로 나눈다.
- 3단계 · 박스 손실과 전체 손실
- \(\mathcal{L}_{\text{L1}} = \frac{0.02 + 0.02}{2} = 0.02\)
- 두 짝의 L1 거리이다. 질의 1 은 중심의 세로 좌표만 0.02 다르다. 짝이 없는 질의 2 의 박스는 들어가지 않는다.
- 두 짝 모두 GIoU 가 IoU 와 같다(한 방향으로만 밀린 같은 크기의 박스).
- 이 자리 하나의 손실이다. 실제 모델에서는 같은 계산을 자리마다(미니 모델 넷) 하고 모두 더한다.
이 숫자는 이 장의 손실 클래스로 그대로 확인할 수 있다. code/ 폴더에서 아래를 실행한다.
손계산 예를 RFDETRCriterion 으로 검산
import torch
from ch11_train import RFDETRCriterion

p = torch.tensor([[0.8, 0.1, 0.1], [0.1, 0.1, 0.6], [0.3, 0.05, 0.05]])  # 질의 3개 × 클래스 3개의 확률
outputs = {"pred_logits": torch.log(p / (1 - p))[None],  # (1, 3, 3): 확률을 로짓으로
           "pred_boxes": torch.tensor([[[0.32, 0.30, 0.20, 0.20], [0.70, 0.62, 0.20, 0.30], [0.50, 0.50, 0.10, 0.10]]])}
targets = [{"labels": torch.tensor([0, 2]),  # 원, 삼각형
            "boxes": torch.tensor([[0.30, 0.30, 0.20, 0.20], [0.70, 0.60, 0.20, 0.30]])}]
criterion = RFDETRCriterion(group_detr=1).eval()  # 평가 모드 = 묶음 1개
cost = criterion.matcher.cost_matrix(outputs["pred_logits"][0], outputs["pred_boxes"][0],
                                     targets[0]["labels"], targets[0]["boxes"])
losses, matches = criterion(outputs, targets, return_matches=True)
print("비용 행렬 (질의 3 × 정답 2)\n", cost.numpy().round(4))
print("짝: 질의", matches[0][1].tolist(), "↔ 정답", matches[0][2].tolist())
print({k: round(float(v), 4) for k, v in losses.items()})
비용 행렬 (질의 3 × 정답 2)
 [[-3.077   6.204 ]
 [ 6.4462 -2.1039]
 [ 4.4305  5.0183]]
짝: 질의 [0, 1] ↔ 정답 [0, 1]
{'loss_ce': 0.5558, 'loss_bbox': 0.02, 'loss_giou': 0.1534, 'loss': 0.9626}
비용 행렬, 짝, 세 손실, 전체 손실이 손계산과 같다.
- 참고 · IA-BCE 손실은 0 까지 내려가지 않는다
- 목표가 \(t\) 인 BCE \(-t\log\hat{p} - (1 - t)\log(1 - \hat{p})\) 는 \(\hat{p} = t\) 일 때 가장 작고, 그 최솟값은 \(-t \log t - (1 - t)\log(1 - t)\) 이다. \(t\) 가 0 이나 1 이 아니면 이 값은 0 보다 크다. 예를 들어 \(t = 0.95\) 이면 \(0.95 \times 0.05129 + 0.05 \times 2.99573 = 0.04873 + 0.14979 = 0.1985\) 이다. 그래서 이 장의 학습 로그에서 분류 손실(
ce)은 박스 손실처럼 0 을 향해 가지 않고 어느 높이에서 천천히 내려간다. 박스가 좋아져 \(t\) 가 1 에 가까워질수록 이 바닥도 낮아진다. 손실 값이 크다고 분류가 틀렸다는 뜻이 아니다.
왜 모든 자리에 손실을 거는가
추론 때 쓰는 것은 마지막 디코더 층의 출력뿐이다. 그런데도 나머지 자리에 손실을 거는 데에는 자리마다 다른 이유가 있다.
인코더 제안에 거는 이유
10장의 질의 선택을 떠올려 본다. 특징 맵의 칸마다 2단계 머리가 클래스 로짓과 박스를 내고, 클래스 로짓의 최댓값이 큰 상위 \(N\) 칸이 뽑혀 그 박스가 디코더의 기준 박스가 된다. 이때 두 곳에서 기울기가 끊긴다.
- “상위 \(N\) 개를 고른다” 는 연산은 번호를 내놓을 뿐이라 미분할 수 없다. 어떤 칸을 골랐는지에 대한 기울기는 없다.
- 뽑힌 박스는 기울기 차단을 거쳐 디코더에 들어간다(8장). 디코더 쪽 손실의 기울기가 제안 박스로 되돌아가지 않는다.
디코더의 내용 질의는 뽑힌 칸의 특징이 아니라 따로 학습되는 임베딩이므로, 2단계 머리(제안의 분류 머리 · 박스 머리와 그 앞의 선형 층)로 가는 길은 이 둘뿐이다. 따라서 디코더 쪽 손실만으로는 2단계 머리가 전혀 학습되지 않는다. 미니 모델에서 인코더 제안의 손실 세 항을 빼고 역전파해 보면 2단계 머리의 기울기가 정확히 0 으로 나온다(이 장의 코드에 든 출력이 아니라 따로 확인한 값이다. 백본 · 프로젝터 · 디코더 · 머리에는 기울기가 생긴다).
그러면 제안의 점수가 난수로 남아 “상위 \(N\) 칸” 이 아무 칸이나 되고, 디코더는 객체와 무관한 자리에서 출발하게 된다. 인코더 제안에 거는 손실은 덤이 아니라 질의 선택이 뜻을 갖게 하는 유일한 학습 신호 이다. 그 손실이 디코더 층과 같은 것(매칭 → IA-BCE · L1 · GIoU)이므로, 제안은 그 자체로 “거친 탐지 결과” 가 되도록 학습된다. 뒤의 실험에서 제안만으로 채점해도 꽤 높은 AP 가 나오는 까닭이다.
모든 디코더 층에 거는 이유
디코더의 앞 층들에 거는 손실은 7장의 보조 손실 그대로이다. 이유도 같다. 모든 층이 정답에서 직접 신호를 받고, 모든 층의 출력이 같은 머리로 읽히므로 어느 층에서 멈추어도 (클래스, 박스)가 나온다.
RF-DETR 은 이 성질을 설계의 재료로 쓴다. 논문 3절은 모든 디코더 층의 출력에 손실을 걸기 때문에 추론 때 디코더 층의 일부 또는 전부를 떼어 낼 수 있다고 적고, 디코더 층의 수를 가중치 공유 NAS 의 손잡이 하나로 삼는다. 층을 전부 떼면 인코더 제안이 곧 예측이 되어, 논문의 표현으로 NMS 없는 1단계 탐지기처럼 된다. 여기서 두 손실이 만난다. 인코더 제안에 건 손실 덕분에 “디코더 0층” 도 쓸 수 있는 예측을 내고, 층마다 건 손실 덕분에 “디코더 1층”, “2층” 도 그렇다. 이 장의 실험에서 층 수별 AP 를 재어 보고, 본격적인 이야기는 12장에서 한다.
- 핵심 · 손실의 구조
- 자리(인코더 제안 + 디코더 각 층)마다, 묶음마다 따로 헝가리안 매칭을 한다. 비용은 \(2 \cdot\) 포컬 꼴 분류 \(+\ 5 \cdot\) L1 \(+\ 2 \cdot (-\operatorname{GIoU})\).
- 자리마다 세 손실(IA-BCE, L1, \(1 - \operatorname{GIoU}\))을 정답 수 × 묶음 수로 나누고, 계수 1 · 5 · 2 로 더한다. 전체 손실은 모든 자리의 합이다.
- 인코더 제안의 손실은 질의 선택을 학습시키는 유일한 신호이고, 층마다의 손실은 디코더 층을 떼어 낼 수 있게 한다.
옵티마이저와 학습률
손실이 정해졌으니 이제 “어떻게 고칠 것인가” 이다. RF-DETR 의 답은 짧다. AdamW 로, 처음부터 끝까지 같은 학습률로.
AdamW 와 기본 설정
옵티마이저는 4장의 AdamW 이다. 기울기의 지수 이동 평균으로 방향을, 기울기 제곱의 지수 이동 평균으로 매개변수마다의 보폭을 정하고, 가중치 감쇠를 기울기와 따로 적용하는 방법이었다. 세 곳의 값을 나란히 놓는다.
| 설정 | 논문(부록 A) | 공식 구현의 기본값( | 이 장의 미니 실험 |
| 옵티마이저 | (LW-DETR 을 따름) | AdamW | AdamW |
| 학습률 | 1e-4 | | 2e-4 |
| 백본의 기준 학습률 | 적지 않음 | | 3e-4(같은 비율 1.5배) |
| 가중치 감쇠 | 적지 않음 | | 1e-4 |
| 배치 크기 | 128 | | 32 |
| 에폭 수 | 데이터셋마다 다름 | | 60 |
| 학습률 스케줄 · 워밍업 | 없음 | 학습 내내 일정, | 없음 |
- 학습률이 낮다. 논문은 “LW-DETR 은 4e-4” 라고 견주고, 낮은 학습률이 DINOv2 의 사전 학습 지식을 지키는 데 도움이 된다고 설명한다(4절). LW-DETR 논문을 직접 보면 4e-4 는 Objects365 사전 학습 때의 값이고(백본은 6e-4), COCO 미세 조정 때는 프로젝터 · 디코더 1e-4, 백본 1.5e-4 를 쓴다. 공식 구현의 기본값
lr=1e-4,lr_encoder=1.5e-4가 이 숫자와 같다. - 미니 실험의 학습률 2e-4 는 7장 · 8장의 실험과 맞춘 값이다. 작은 모델을 처음부터 학습하므로 공식 기본값보다 조금 크다. 다른 값과 견주어 고른 것은 아니다.
- 논문의 배치 128 은 논문 저자들의 큰 실험 설정이고, 공식 구현의 기본값은 GPU 한 장에 맞춘 작은 값이다. 그 틈을 메우는 장치가 다음 소절의 기울기 누적이다.
배치 크기와 기울기 누적
배치가 크면 기울기가 덜 흔들리지만 GPU 메모리를 많이 쓴다. 기울기 누적(gradient accumulation)은 큰 배치의 기울기를 작은 배치 여러 번으로 나누어 계산하는 방법이다. 작은 배치로 순전파 · 역전파를 \(A\) 번 하면서 기울기를 지우지 않고 더해 두었다가, \(A\) 번째에 한 번만 가중치를 고친다. PyTorch 에서는 backward() 가 기울기를 덮어쓰지 않고 더하기 때문에, zero_grad() 를 \(A\) 번에 한 번만 부르면 된다.
- 작은 배치 A 번의 기울기 평균 = 큰 배치 한 번의 기울기
- \(\mathcal{L}_{\text{큰}} = \frac{1}{A \cdot B} \sum_{k=1}^{A \cdot B} f_k \quad \Rightarrow \quad \nabla \mathcal{L}_{\text{큰}} = \frac{1}{A \cdot B} \sum_{k=1}^{A \cdot B} \nabla f_k\)
- 그림 \(A \cdot B\) 장짜리 큰 배치의 손실은 그림마다의 손실 \(f_k\) 의 평균이다. \(\nabla\)(나블라)는 가중치에 대한 기울기이다. 합의 기울기는 기울기의 합이다.
- 같은 그림들을 \(B\) 장씩 \(A\) 묶음으로 나누어, 묶음마다 따로 역전파해 얻는 기울기이다. 그 사이에 가중치를 고치지 않으므로 모든 \(\nabla f_k\) 는 같은 가중치에서 계산된다.
- 작은 배치들의 기울기를 평균한다(실제로는 손실을 \(A\) 로 나누어 역전파하고 기울기를 더한다). 두 겹의 합이 모든 그림에 걸친 합 하나가 된다.
- 첫 줄과 같다. 가중치를 한 번 고칠 때 본 그림 수 \(A \cdot B\) 가 실효 배치 크기이다(14장).
숫자로 보면 이렇다. 가중치 하나에 대한 그림 네 장의 기울기가 0.2, 0.6, 0.5, 1.1 이라 하자. 네 장을 한 배치로 계산하면 \((0.2 + 0.6 + 0.5 + 1.1)/4 = 0.6\) 이다. 두 장씩 나누면 첫 배치 \((0.2 + 0.6)/2 = 0.4\), 둘째 배치 \((0.5 + 1.1)/2 = 0.8\) 이고, 둘의 평균 \((0.4 + 0.8)/2 = 0.6\) 으로 같다.
- 주의 · 이 등식이 성립하려면
- 그림 한 장의 손실이 같은 배치의 다른 그림에 따라 달라지면 안 된다. 배치 정규화는 배치의 평균 · 분산을 쓰므로 이 조건을 깬다(4장). RF-DETR 논문이 프로젝터의 배치 정규화를 층 정규화로 바꾼 이유가 이것이다. 논문은 그 덕분에 기울기 누적으로 소비자용 GPU 에서 학습할 수 있다고 적는다(3절).
- RF-DETR 의 손실은 그림 수가 아니라 배치의 정답 수(
num_boxes)로 나눈다. 작은 배치마다 정답 수가 다르면, 작은 배치 여럿의 평균과 큰 배치 한 번의 값이 조금 다르다. 거의 같지만 정확히 같지는 않다.
이 장의 미니 실험은 기울기 누적을 쓰지 않는다. 모델이 작아 배치 32 가 한 번에 올라가기 때문이다.
학습률 스케줄러와 코사인 스케줄
학습 도중에 학습률을 정해진 규칙에 따라 바꾸는 장치를 학습률 스케줄러(learning rate scheduler)라고 한다. 보통의 생각은 이렇다. 처음에는 큰 학습률로 빠르게 가고, 끝으로 갈수록 학습률을 낮춰 미세하게 자리를 잡는다. 7장과 8장의 실험도 60 에폭 가운데 48 에폭 뒤에 학습률을 1/10 로 낮췄다.
가장 널리 쓰이는 것이 코사인 스케줄(cosine schedule)이다. 지금까지의 스텝 수를 \(n\), 학습 전체의 스텝 수를 \(n_{\text{end}}\), 시작 학습률을 \(\eta_0\)(에타), 마지막 학습률을 \(\eta_{\min}\) 이라 하면
\(\eta_n = \eta_{\min} + \tfrac{1}{2}\,(\eta_0 - \eta_{\min})\left(1 + \cos\frac{\pi\, n}{n_{\text{end}}}\right)\)
이다(논문들은 보통 \(n\) 을 \(t\), \(n_{\text{end}}\) 를 \(T\) 로 쓴다. 이 장에서는 \(t\) 와 \(T\) 를 손실의 목표값과 정답 수에 썼으므로 피했다). 스텝 대신 에폭으로 세어도 식은 같다.
- 코사인 스케줄의 세 지점
- \(n = 0: \quad \cos 0 = 1 \;\Rightarrow\; \eta_0 = \eta_{\min} + \tfrac{1}{2}(\eta_0 - \eta_{\min}) \cdot 2 = \eta_0\)
- 시작할 때는 괄호가 2 가 되어 시작 학습률 그대로이다.
- 정확히 절반에서 두 학습률의 평균이다.
- 끝에서 괄호가 0 이 되어 마지막 학습률에 닿는다.
- \(\cos(\pi/4) = 0.70711\) 이므로 \(\tfrac{1}{2}(1 + 0.70711) = 0.85355\), \(\cos(3\pi/4) = -0.70711\) 이므로 \(\tfrac{1}{2}(1 - 0.70711) = 0.14645\) 이다. 처음과 끝에서는 천천히, 가운데에서는 빠르게 내려가는 곡선이다.
코사인 스케줄은 끝을 알아야 한다
식을 다시 보면 \(n\) 은 혼자 나오지 않고 늘 \(n / n_{\text{end}}\) 로만 나온다. 학습률은 “지금 몇 스텝째인가” 가 아니라 “전체의 몇 분의 몇을 지났는가” 로 정해진다. 그러니 학습을 시작하기 전에 \(n_{\text{end}}\) 를 정해야 하고, 한번 정하면 그 값이 학습 내내 모든 스텝의 학습률을 좌우한다.
원문 그림 11-2. 같은 시작 학습률 \(\eta_0\) 에서 출발하는 세 가지 일정표(\(\eta_{\min} = 0\)). 가로축은 에폭(0 – 100), 세로축은 학습률(0 – \(\eta_0\))이다.
- 일정한 학습률(RF-DETR): \(\eta_0\) 의 수평선.
- 코사인, 끝 = 100 에폭: \(\eta_0\) 에서 출발해 100 에폭에 0 이 된다.
- 코사인, 끝 = 50 에폭: \(\eta_0\) 에서 출발해 50 에폭에 0 이 된다.
- 30 에폭째(세로 점선)의 학습률은 일정한 학습률에서 \(1.00\,\eta_0\), 끝을 100 에폭으로 잡은 코사인 스케줄에서 \(0.79\,\eta_0\), 50 에폭으로 잡은 것에서 \(0.35\,\eta_0\) 다. 같은 30 에폭째의 학습률이 “끝” 을 어디로 잡았느냐에 따라 달라진다.
그림의 세로 점선이 요점이다. 30 에폭을 학습한 같은 시점인데, 계획한 길이에 따라 모델이 받고 있는 학습률이 다르다. 숫자는 식에서 바로 나온다. \(n_{\text{end}} = 100\) 이면 \(\tfrac{1}{2}(1 + \cos 0.3\pi) = \tfrac{1}{2}(1 + 0.58779) = 0.794\), \(n_{\text{end}} = 50\) 이면 \(\tfrac{1}{2}(1 + \cos 0.6\pi) = \tfrac{1}{2}(1 - 0.30902) = 0.345\) 이다. 여기서 두 가지 곤란이 생긴다.
- 길게 잡았는데 일찍 끝내고 싶을 때. 100 에폭을 계획했는데 데이터가 작아 30 에폭이면 충분했다고 하자. 30 에폭에서 멈추면 학습률이 아직 \(0.79\,\eta_0\) 이다. 학습률을 낮춰 다듬는 뒤쪽 구간을 한 번도 거치지 못한 모델을 얻는다.
- 짧게 잡았는데 더 학습하고 싶을 때. 50 에폭을 계획해 끝까지 갔더니 아직 성능이 오르는 중이었다고 하자. 학습률이 이미 0 이라 이어서 학습할 수 없다. 길이를 새로 정해 일정표를 다시 짜야 한다.
COCO 한 곳만 본다면 문제가 아니다. 여러 번 돌려 보고 알맞은 길이를 찾으면 된다. 하지만 RF-DETR 이 겨냥하는 것은 크기와 난이도가 제각각인 현장 데이터셋이다. 논문 3절은 이렇게 적는다. 코사인 스케줄은 최적화의 길이를 미리 안다고(고정되어 있다고) 가정하는데, RF100-VL 의 데이터셋들처럼 다양한 목표 데이터에는 그 가정이 맞지 않는다. 논문은 이 관찰이 DINOv3 와 같은 때에 나온 것이라고 덧붙인다.
그래서 RF-DETR 은 학습률을 바꾸지 않는다. 일정한 학습률에서는 30 에폭째의 모델이 “100 에폭 계획의 30 에폭째” 든 “50 에폭 계획의 30 에폭째” 든 똑같다. 언제 멈춰도 되고, 더 돌려도 된다. 이것을 논문은 스케줄러 없는 학습(scheduler-free training)이라고 부른다(학습률뿐 아니라 증강의 일정표도 없앤다는 뜻을 함께 담는다. 증강은 뒤에서 다룬다).
- 참고 · 공개 코드에서는
- 공식 구현의 기본 스케줄은 이름이
lr_scheduler="step"이고 정해진 에폭(lr_drop, 기본 100) 뒤에 학습률을 낮추게 되어 있다. 그런데 기본 에폭 수도 100 이어서, 기본 설정에서는 학습 내내 학습률이 일정하다. 14장의 실제 학습 기록에서도 학습률이 변하지 않았다.
그런데 학습률을 낮추는 데에는 까닭이 있었다. 학습률이 크면 가중치가 좋은 자리 근처에서 계속 흔들린다. 학습률을 끝까지 그대로 두면 그 흔들림은 누가 줄일까? RF-DETR 에서 그 일을 맡는다고 볼 수 있는 것이 뒤에 나올 EMA 이다. 가중치를 직접 덜 움직이게 하는 대신, 움직이는 가중치의 평균 을 따로 들고 있다가 그것을 쓴다. (논문이 이렇게 설명하는 것은 아니다. 두 장치의 역할을 견준 해석이다.)
워밍업도 없다
워밍업(warm-up)은 학습의 맨 처음 얼마 동안 학습률을 0 근처에서 목표값까지 서서히 올리는 장치이다. 갓 초기화한 모델의 기울기는 크고 방향도 믿기 어려워서, 처음부터 큰 학습률로 가면 가중치가 엉뚱한 곳으로 튈 수 있다는 걱정에서 나왔다. Transformer 를 학습할 때 흔히 쓴다.
RF-DETR 논문 부록 A 는 학습률 워밍업을 뺐다 고 적는다(DINOv3 는 쓰지만 RF-DETR 은 쓰지 않는다고 견준다). 공식 구현의 기본값도 warmup_epochs=0 이다. 논문은 이유를 따로 설명하지 않는다. 다만 워밍업이 없어도 되게 하는 조건 몇 가지는 이 장에서 볼 수 있다. 학습률 자체가 낮고, 대부분의 가중치가 무작위가 아니라 사전 학습된 값에서 출발하고, 바로 다음 절의 기울기 자르기가 한 스텝의 크기를 묶어 둔다. 워밍업을 없애면 미리 정해야 하는 숫자(워밍업의 길이)도 하나 줄어든다.
기울기 자르기
7장부터 학습 고리에 한 줄이 들어 있었다. clip_grad_norm_(model.parameters(), 0.1). 설명을 이 장으로 미뤄 두었던 기울기 자르기(gradient clipping)이다.
노름으로 자르는 식
모델의 모든 가중치에 대한 기울기를 한 줄로 이어 붙인 벡터를 \(\mathbf{g}\) 라 하자(미니 모델이면 성분이 1,832,707개). 그 길이, 곧 노름은 \(\lVert \mathbf{g} \rVert = \sqrt{\sum_k g_k^2}\) 이다. 기울기 자르기는 이 길이가 정해 둔 한계 \(c_{\max}\) 를 넘으면 방향은 그대로 두고 길이만 \(c_{\max}\) 로 줄인다.
줄에 묶인 강아지를 떠올리면 된다. 줄 길이(\(c_{\max}\)) 안에서는 가고 싶은 만큼 간다. 줄보다 멀리 가려 하면 가려던 방향으로 줄 길이까지만 간다. 방향은 강아지가 정하고, 거리의 상한만 줄이 정한다.
- 자르기 식의 유도
- \(\mathbf{g}' = s\,\mathbf{g}, \qquad s \gt 0\)
- 방향을 지키려면 모든 성분에 같은 양수 \(s\) 를 곱해야 한다. 성분마다 다른 수를 곱하면 방향이 바뀐다.
- 새 길이가 한계 \(c_{\max}\) 를 넘지 않아야 한다. 벡터에 \(s\) 를 곱하면 길이도 \(s\) 배가 된다.
- 기울기를 키우지는 않는다. 이미 한계 안에 있는 기울기는 그대로 두어야 한다.
- 두 조건을 모두 지키는 가장 큰 \(s\) 이다. \(\lVert \mathbf{g} \rVert \le c_{\max}\) 이면 \(s = 1\)(그대로), 넘으면 \(s = c_{\max} / \lVert \mathbf{g} \rVert\) 이고 새 길이는 정확히 \(c_{\max}\) 이다.
- 손계산 — 성분 두 개짜리 기울기, 한계 0.1
- \(\mathbf{g} = (3,\ 4): \quad \lVert \mathbf{g} \rVert = \sqrt{9 + 16} = 5, \qquad s = \min\!\left(1,\ \frac{0.1}{5}\right) = 0.02\)
- 길이 5 가 한계 0.1 을 넘으므로 줄인다.
- 두 성분의 비 3 : 4 는 그대로이고 길이가 정확히 0.1 이 되었다.
- 한계 안의 기울기는 건드리지 않는다. PyTorch 의
clip_grad_norm_으로 같은 두 벡터를 넣으면 \((0.06, 0.08)\) 과 \((0.03, 0.04)\) 가 나온다(분모에 아주 작은 수 \(10^{-6}\) 을 더하는 것만 다르다).
두 가지를 짚어 둔다. 첫째, 노름은 모델 전체 에 대해 하나이다. 층마다 따로 재지 않는다. 그래서 어느 한 층의 기울기가 튀면 다른 층의 기울기도 함께 줄어든다. 둘째, 논문 부록 A 의 문장은 “0.1 보다 큰 기울기를 모두 자른다” 이고, 공식 구현에서 이 값은 clip_max_norm=0.1 이라는 이름으로 전체 노름의 한계로 쓰인다. DETR 논문부터 이어져 온 값이다(7장).
왜 필요한가, Adam 과 함께일 때의 뜻
기울기 자르기의 본래 목적은 한 번의 나쁜 배치가 학습을 망치지 못하게 하는 것이다. DETR 계열에서는 그럴 일이 자주 생긴다. 매칭이 스텝마다 새로 정해지므로 짝이 바뀌는 순간 손실이 뛰고, 손실이 여러 자리의 합이라 그 뜀이 자리 수만큼 겹친다. 그런 스텝의 기울기는 평소의 몇 배가 될 수 있다.
SGD 라면 효과가 곧바로 읽힌다. 갱신량이 \(\eta\,\mathbf{g}\) 이므로 자른 뒤에는 한 스텝에 가중치가 움직이는 거리가 \(\eta \cdot c_{\max}\) 를 넘지 못한다. Adam 계열에서는 조금 다르게 읽어야 한다. 4장에서 본 대로 Adam 의 갱신량은 대략 (기울기의 이동 평균) ÷ (기울기 크기의 이동 평균) 이어서, 기울기 전체에 늘 같은 수를 곱하면 분자와 분모가 함께 변해 갱신량이 그대로이다. 그러니 Adam 에서 기울기 자르기는 보폭을 줄이는 장치가 아니다. 스텝들 사이의 크기 차이를 없애는 장치이다.
미니 모델에서 자르기 전의 기울기 노름을 재어 보면 이 점이 분명해진다(이 장의 코드에는 없는, 따로 재어 본 값이다. 배치 32, 스무 스텝). 무작위 초기화 모델에서 2.2 – 2.4, 60 에폭 학습한 모델에서 13 – 18 이었다. 한계 0.1 의 스무 배에서 백팔십 배이다. 자르기가 가끔 일어나는 것이 아니라 매 스텝 일어난다. 모든 스텝의 기울기가 길이 0.1 로 맞춰진 채 Adam 에 들어가므로, 유난히 큰 기울기를 낸 배치도 다른 배치와 같은 무게로만 이동 평균에 섞인다. 튀는 배치 하나가 Adam 의 이동 평균을 여러 스텝 동안 흐려 놓는 일이 없어진다.
- 팁 · 한계 0.1 은 작은 값이다
- 다른 분야의 코드에서는 기울기 자르기의 한계를 1.0 이나 그보다 크게 두고 “가끔 튀는 것만 막는” 용도로 쓰는 일이 많다. DETR 계열의 0.1 은 그와 달리 사실상 모든 스텝에 걸리는 값이다. 이 값을 바꾸거나 자르기를 끄면 Adam 이 보는 기울기의 분포가 달라지므로, 학습률을 그대로 두어도 학습의 모습이 달라질 수 있다.
지수 이동 평균
6장에서 DINO 의 교사를 만들 때 쓴 연산이 다시 나온다. 이번에는 교사가 아니라 평가하고 저장할 모델 을 만드는 데 쓴다.
가중치를 평균한다는 생각
미니배치로 학습하는 가중치는 매 스텝 조금씩 흔들린다. 스텝마다 다른 그림 몇 장만 보고 방향을 정하기 때문이다. 학습률이 일정하면 이 흔들림은 끝까지 줄지 않는다. 어느 스텝에서 학습을 멈추든, 그 순간의 가중치는 “좋은 자리 + 그 스텝의 우연한 흔들림” 이다.
움직이는 배 위에서 저울 눈금을 읽는 일과 비슷하다. 한 순간의 눈금은 파도에 따라 오르내린다. 몇 초 동안의 눈금을 평균하면 파도는 서로 지워지고 진짜 무게에 가까운 값이 남는다.
그래서 학습 중인 모델(앞으로 일반 모델, 가중치 \(\theta\))과 별도로 사본을 하나 더 두고, 그 사본의 가중치 \(\theta_{\text{ema}}\) 를 일반 모델 가중치의 최근 평균 으로 유지한다. 지난 가중치를 전부 저장해 두고 평균할 수는 없으므로(모델 수백 개 분량의 메모리가 든다) 숫자 하나로 갱신할 수 있는 평균을 쓴다. 그것이 지수 이동 평균(exponential moving average, EMA)이다.
갱신식과 손계산
옵티마이저가 가중치를 한 번 고칠 때마다 다음을 한 번 한다.
\(\theta_{\text{ema}} \;\leftarrow\; d\,\theta_{\text{ema}} + (1 - d)\,\theta\)
\(d\) 는 0 과 1 사이의 수로 감쇠(decay)라고 부르고, 1 에 가깝게 둔다. 새 평균은 옛 평균을 \(d\) 만큼, 지금의 가중치를 \((1 - d)\) 만큼 섞은 것이다. 모든 가중치에 성분별로 똑같이 적용한다. 6장에서 본 DINO 교사의 갱신식과 글자만 다르다. 교사가 EMA 모델, 학생이 일반 모델이고, 6장에서 \(m\) 이라 쓴 수가 여기의 \(d\) 이다.
- 손계산 — 흔들리는 가중치 하나
- \(\theta_{\text{ema}} = 1.0, \quad \theta = 1.4, \quad d = 0.5: \qquad \theta_{\text{ema}} \leftarrow 0.5 \times 1.0 + 0.5 \times 1.4 = 1.2\)
- 보기 쉽게 \(d = 0.5\) 로 둔다. 일반 가중치가 1.4 로 뛰었고 평균은 절반만 따라간다.
- 다음 스텝에서 일반 가중치가 0.8 로 내려갔다.
- 일반 가중치가 \(1.4 \to 0.8 \to 1.2\) 로 0.6 폭을 오르내리는 동안 평균은 \(1.2 \to 1.0 \to 1.1\) 로 0.2 폭만 움직였다.
- RF-DETR 의 값이다. 한 스텝에 차이의 0.7% 만 따라간다. 훨씬 굼뜨고, 그만큼 흔들림을 많이 지운다.
최근 몇 스텝의 평균인가
“감쇠 \(d\) 의 EMA 는 최근 약 \(1/(1 - d)\) 스텝의 평균” 이라는 말을 자주 본다. 이 말이 어디서 나오는지 따져 본다. 위첨자 \((n)\) 은 \(n\) 번째 스텝 뒤의 값이다.
- EMA 가 과거 가중치에 주는 무게
- \(\theta_{\text{ema}}^{(n)} = d\,\theta_{\text{ema}}^{(n-1)} + (1 - d)\,\theta^{(n)}\)
- 갱신식을 스텝 번호와 함께 적은 것이다.
- 오른쪽의 \(\theta_{\text{ema}}^{(n-1)}\) 자리에 같은 식을 한 번 더 넣고 펼쳤다. 한 스텝 전의 가중치에는 \(d\) 가 한 번 더 곱해진다.
- 같은 일을 맨 처음까지 되풀이한 꼴이다(6장의 유도와 같다). \(k\) 스텝 전의 가중치가 받는 무게는 \(w_k = (1 - d)\,d^{\,k}\) 이다. 지금(\(k = 0\))이 \(1 - d\) 로 가장 크고, 한 스텝 과거로 갈 때마다 \(d\) 배로 줄어든다.
- 가장 최근 \(M\) 스텝이 받는 무게의 합이다. 등비급수의 합 \(\sum_{k=0}^{M-1} d^k = \frac{1 - d^M}{1 - d}\) 을 썼다.
- \(M\) 을 \(1/(1 - d)\) 로 잡는다. \((1 - 1/M)^M\) 은 \(M\) 이 클수록 \(1/e\) 에 가까워지는 수이다(\(e = 2.718\ldots\) 는 자연로그의 밑).
- 최근 \(1/(1 - d)\) 스텝이 전체 무게의 약 63% 를 차지한다. 그리고 가장 큰 무게 \(w_0 = 1 - d = 1/M\) 은 “\(M\) 스텝의 단순 평균” 이 한 스텝에 주는 무게와 같다. 이 두 가지 뜻에서 EMA 를 “최근 약 \(1/(1 - d)\) 스텝의 평균” 이라고 부른다. 딱 \(M\) 스텝에서 끊기는 평균은 아니고, 그보다 오래된 스텝도 37% 의 무게를 나누어 갖는다.
- 숫자로 — 감쇠 0.993
- \(\frac{1}{1 - d} = \frac{1}{0.007} = 142.9 \text{ 스텝}\)
- RF-DETR 의 EMA 는 최근 약 143 스텝의 평균이다. 이 장의 실험은 에폭당 125 스텝이므로 약 1.1 에폭이다.
- 최근 143 스텝이 무게의 63.4% 를 차지한다. 위의 어림 0.632 와 맞다.
- 어떤 시점의 가중치가 받는 무게가 절반으로 줄기까지 약 99 스텝이다. LW-DETR 의 감쇠 0.9997(LW-DETR 논문)이면 \(1/(1 - d) = 3{,}333\) 스텝으로 훨씬 긴 평균이다.
감쇠 워밍업
유도의 셋째 줄에 걸리는 항이 하나 있다. \(d^{\,n}\,\theta_{\text{ema}}^{(0)}\), 곧 EMA 의 처음 값 이 받는 무게이다. EMA 모델은 학습을 시작할 때 일반 모델의 사본으로 만들어지므로 \(\theta_{\text{ema}}^{(0)}\) 는 학습 전의 가중치이다. 감쇠가 처음부터 0.993 이면 이 무게가 쉽게 사라지지 않는다. 125 스텝(이 장의 한 에폭) 뒤에도 \(0.993^{125} = 0.416\), 두 에폭 뒤에도 \(0.416^2 = 0.173\) 이 남는다. 한 에폭을 학습한 EMA 모델의 42% 가 아직 학습 전의 가중치인 셈이다. 학습 초반에 EMA 모델이 쓸모없어진다.
공식 구현은 감쇠를 0 근처에서 시작해 서서히 올린다. \(n\) 번째 갱신에 쓰는 감쇠는
\(d_n = d \cdot \left(1 - e^{-n/\tau}\right), \qquad d = 0.993, \quad \tau = 100\)
이다. \(\tau\)(타우)는 감쇠가 올라가는 빠르기를 정하는 스텝 수이고, \(n\) 은 1 부터 센다. 공식 구현의 ema_decay=0.993, ema_tau=100 이 이 두 수이다.
- 손계산 — 감쇠가 올라가는 모습
- \(d_1 = 0.993 \times (1 - e^{-0.01}) = 0.993 \times 0.00995 = 0.0099\)
- 첫 갱신. \(e^{-0.01} = 0.99005\) 이다. 감쇠가 거의 0 이므로 \(\theta_{\text{ema}} \leftarrow 0.0099\,\theta_{\text{ema}} + 0.9901\,\theta\), 곧 EMA 가 일반 모델을 거의 그대로 복사한다. 학습 전 가중치의 무게는 첫 스텝에 1% 아래로 떨어진다.
- \(n = \tau\) 일 때 목표값의 63% 까지 올라온다. 이때의 평균 길이는 \(1/(1 - 0.6277) = 2.7\) 스텝이다.
- \(e^{-3} = 0.04979\). 평균 길이 \(1/(1 - 0.9436) = 17.7\) 스텝.
- \(e^{-10} = 0.0000454\). 1,000 스텝이면 목표값에 닿고, 평균 길이도 \(1/(1 - 0.99295) = 141.9\) 스텝으로 다 자란다.
실습 코드가 같은 값을 출력하고, EMA 를 한 번 갱신했을 때의 변화를 식과 대조한다.
[EMA] 실효 감쇠 d = 0.993·(1 − exp(−스텝/100)):  스텝 1: 0.0099, 스텝 10: 0.0945, 스텝 50: 0.3907, 스텝 100: 0.6277, 스텝 300: 0.9436, 스텝 1000: 0.9930
  check 모델의 모든 가중치를 +0.1 한 뒤 EMA 를 한 번 갱신: EMA 의 변화 0.09901 = (1 − d)·0.1 = 0.09901
둘째 줄의 check 는 이렇게 읽는다. 일반 모델의 모든 가중치에 0.1 을 더한 뒤 EMA 를 한 번(첫 번째로) 갱신하면, EMA 의 가중치는 \((1 - d_1) \times 0.1 = 0.9901 \times 0.1 = 0.09901\) 만큼 따라 움직여야 한다. 실제 변화가 그 값이다.
- 그림: 그림 11-3 왼쪽: 스텝 1 – 1,000 의 실효 감쇠 \(d_n\)(파랑 실선, 왼쪽 눈금)과 평균 길이 \(1/(1 - d_n)\)(주황 점선, 오른쪽 눈금). 가운데 · 오른쪽은 이 장의 본 실험 결과로, 뒤의 “EMA 모델과 일반 모델” 에서 읽는다.
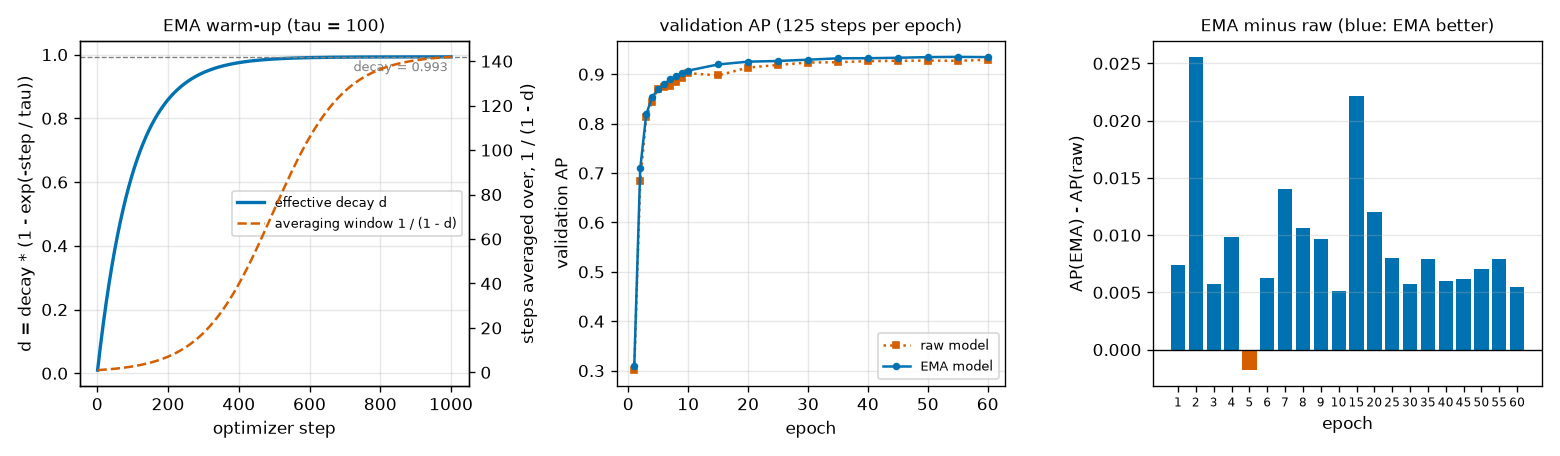
그림 11-3 의 왼쪽 그림에서 읽을 것은 두 곡선의 시간차 이다. 파란 선(감쇠)은 200 스텝이면 0.86, 500 스텝이면 0.986 으로 일찍 올라오는데, 주황 점선(평균 길이)은 그때 각각 7 스텝, 73 스텝으로 한참 뒤에야 따라온다. 평균 길이가 \(1/(1 - d_n)\) 이라 \(d_n\) 이 1 에 아주 가까워져야 길어지기 때문이다. 뜻은 이렇다. 학습 초반에는 짧게 평균하고, 학습이 진행될수록 길게 평균한다. 초반은 모델이 스텝마다 크게 좋아지는 때라 오래된 가중치를 섞으면 손해이고, 후반은 모델이 한자리에서 흔들리는 때라 길게 평균할수록 이득이다.
논문 부록 A 는 “DINOv3 처럼 EMA 스케줄러를 쓴다. EMA 가 제대로 동작하려면 필요하기 때문이다” 라고만 적는다. 공개 코드에서 EMA 의 감쇠를 시간에 따라 바꾸는 장치는 이 워밍업 식 하나이다.
평가와 저장에 쓰는 가중치
EMA 모델은 학습에 전혀 끼어들지 않는다. 순전파 · 손실 · 역전파는 모두 일반 모델로 하고, EMA 모델은 옆에서 평균만 낸다. 6장의 DINO 와 다른 점이다. DINO 에서는 EMA 로 만든 교사의 출력이 학생의 목표가 되어 학습 자체를 바꾸었다. RF-DETR 의 EMA 는 구경꾼이다. 그래서 EMA 를 켜고 끄는 것이 일반 모델의 학습 결과에 아무 영향을 주지 않고, 한 번의 학습에서 “EMA 를 쓴 결과” 와 “쓰지 않은 결과” 를 둘 다 얻을 수 있다. 뒤의 절제 실험이 이 성질을 쓴다.
쓰이는 곳은 학습이 끝난 뒤, 그리고 학습 도중의 채점이다.
- 평가. 공식 구현은 기본 설정에서 검증 AP 를 EMA 가중치로 잰다.
eval_base_model=True를 주면 일반 가중치도 함께 채점해 따로 기록한다. - 저장 · 배포. 공식 구현은 EMA 가중치의 검증 AP 가 가장 좋았던 에폭의 가중치를
checkpoint_best_ema.pth로 남긴다. 일반 가중치도 채점했다면 그쪽의 가장 좋았던 것(checkpoint_best_regular.pth)도 남기고, 둘 가운데 나은 쪽이 최종 모델checkpoint_best_total.pth가 된다(14장).
왜 평균한 가중치가 더 나을 수 있을까? 일반 가중치는 마지막 몇 배치의 사정에 맞춰 흔들린 값이고, EMA 가중치는 그 흔들림이 지워진 값이라는 것이 한 가지 설명이다. 6장에서 본 대로 DINO 논문도 EMA 교사가 학습 내내 학생보다 성능이 좋았다고 보고한다. 다만 평균이 늘 이득인 것은 아니다. 모델이 빠르게 좋아지는 구간에서는 과거를 섞은 평균이 지금의 모델보다 뒤처진다. 실제로 어느 쪽이 높은지는 이 장의 실험에서 스무 번 재어 본다.
층별 학습률 감쇠
지금까지 “학습률 1e-4” 라고 했지만, 모든 가중치가 그 값으로 배우는 것은 아니다. RF-DETR 은 부품마다, 백본에서는 블록마다 다른 학습률을 쓴다.
얕은 층은 조금, 깊은 층은 많이
미세 조정의 출발점은 사전 학습한 백본이다(6장). 그 백본의 모든 층이 같은 정도로 “새 과제에 맞게 고쳐야 할” 것은 아니다.
- 입력에 가까운 얕은 블록 은 모서리 · 질감 · 색처럼 어떤 그림에나 통하는 것을 본다. 새 데이터에서도 그대로 쓸모가 있고, 섣불리 고치면 수억 장에서 배운 것을 몇천 장으로 덮어쓰게 된다.
- 출력에 가까운 깊은 블록 은 사전 학습의 목표(DINOv2 라면 자기 증류)에 맞춰진 특징을 낸다. 탐지라는 새 목표에 맞게 더 많이 고쳐야 한다.
- 새로 붙인 부품(프로젝터, 디코더, 머리)은 백본만큼 오래 학습되지 않았거나 처음부터 배워야 한다. 가장 크게 고친다.
이 생각을 숫자로 옮긴 것이 층별 학습률 감쇠(layer-wise learning rate decay)이다. 백본의 맨 위 블록에서 시작해 입력 쪽으로 한 블록 내려갈 때마다 학습률에 1 보다 작은 수(RF-DETR 은 0.8)를 곱한다. 논문 부록 A 의 문장은 “DINOv2 백본의 정보를(특히 앞쪽 층의 정보를) 보존하려고 층마다 0.8 의 곱셈 감쇠를 적용한다” 이다.
- 주의 · “감쇠” 가 세 가지 나온다
- 이 장에는 이름이 비슷한 것이 셋 있다. 가중치 감쇠(4장: 가중치를 스텝마다 조금씩 0 쪽으로 당기는 것), EMA 의 감쇠 \(d\)(옛 평균을 얼마나 남기는가), 층별 학습률 감쇠(층마다 학습률을 얼마나 줄이는가)이다. 서로 관계없는 세 개의 수이다. 또 여기서 “깊은 블록” 은 출력에 가까운 블록, “얕은 블록” 은 입력에 가까운 블록이다.
공식 코드의 식
논문은 “0.8” 이라는 수만 적으므로 정확한 식은 공개 코드에서 읽는다(models/backbone/backbone.py 의 get_dinov2_lr_decay_rate 와 get_named_param_lr_pairs). 줄이면 다음 두 단계이다.
공식 구현이 백본 매개변수의 학습률을 정하는 규칙 (줄여서 옮김)
num_layers = out_feature_indexes[-1] + 1            # Nano: [3, 6, 9, 12] → 13
layer_id = num_layers + 1                           # 기본: 맨 위 (감쇠 없음)
if "embeddings" in name:                            # 패치 임베딩 · 위치 임베딩 · CLS 토큰
    layer_id = 0
elif ".layer." in name:                             # 블록 j 의 매개변수
    layer_id = j + 1
lr = lr_encoder * lr_vit_layer_decay ** (num_layers + 1 - layer_id) * lr_component_decay ** 2
기호로 옮긴다(14장과 같은 글자를 쓴다).
- \(\eta\): 기본 학습률
lr. \(\eta_{\text{enc}}\): 백본의 기준 학습률lr_encoder. - \(\lambda\)(람다): 층별 감쇠율
lr_vit_layer_decay= 0.8. \(\rho\)(로): 구성 요소별 감쇠율lr_component_decay= 0.7. - \(L\): 코드의
num_layers. \(i\): 매개변수의 층 번호layer_id. \(j\): 백본 블록의 번호(0 부터). 손실을 다룰 때 \(i\), \(j\) 는 질의와 정답의 번호였지만 이 절에서는 층과 블록의 번호이다.
\(\text{백본 매개변수의 학습률} \;=\; \eta_{\text{enc}} \cdot \lambda^{\,L + 1 - i} \cdot \rho^{2}, \qquad i = \begin{cases} 0 & \text{임베딩} \\ j + 1 & \text{블록 } j \ (j = 0, 1, \dots) \\ L + 1 & \text{그 밖(마지막 층 정규화)} \end{cases}\)
\(\lambda\) 의 지수 \(L + 1 - i\) 는 “맨 위에서 몇 계단 아래인가” 이다. 블록 \(j\) 는 \(i = j + 1\) 이므로 지수가 \(L - j\) 이다.
- 참고 · 층 수 L 을 세는 법
- 공개 코드는 \(L\) 을 블록 수로 넣지 않고 특징을 꺼내는 마지막 자리의 번호 + 1 로 넣는다. Nano · Small · Medium 은 그 번호가 12 여서(블록 12개를 모두 지난 출력) \(L = 13\), 블록 수보다 1 크다. 그래서 맨 위 블록(블록 11)의 배율이 \(0.8^1\) 이 아니라 \(0.8^{13 - 11} = 0.8^2 = 0.64\) 이다. 논문의 “층마다 0.8” 이라는 말만으로는 알 수 없는, 코드의 실제 동작이다. 이 튜토리얼은 공개 코드의 동작을 따른다. 미니 모델은 블록 6개에 꺼내는 자리가 (2, 4, 6) 이라 \(L = 7\) 이다.
열두 블록의 배율 표
RF-DETR Nano(백본 블록 12개, \(L = 13\))의 표를 손으로 만든다. \(0.8\) 의 거듭제곱은 앞의 값에 0.8 을 곱해 가면 된다.
- 손계산 — 0.8 의 거듭제곱과 공통 인수
- \(0.8^2 = 0.64, \quad 0.8^3 = 0.512, \quad 0.8^4 = 0.4096, \quad 0.8^5 = 0.32768, \quad 0.8^6 = 0.26214, \quad 0.8^7 = 0.20972\)
- 차례로 0.8 을 곱한다. \(0.64 \times 0.8 = 0.512\), \(0.512 \times 0.8 = 0.4096\) …
- 계속 곱한다. 열네 번 곱하면 처음의 4.4% 가 된다.
- 백본의 모든 매개변수에 공통으로 곱해지는 부분이다. 층별 감쇠가 하나도 걸리지 않은 “맨 위” 의 학습률이기도 하다.
- 맨 위 블록이다. 지수는 \(L - j = 13 - 11 = 2\).
- 맨 아래 블록이다. 맨 위 블록의 \(0.8^{11} = 0.0859\) 배, 곧 약 1/11.6 이다.
| 부분 | 층 번호 \(i\) | 지수 \(L + 1 - i\) | 배율 \(0.8^{\,L + 1 - i}\) | 학습률 (\(7.35 \times 10^{-5}\) × 배율) | 기본 학습률 \(10^{-4}\) 의 몇 배 |
| 임베딩(패치 · 위치 · CLS) | 0 | 14 | 0.04398 | \(3.23 \times 10^{-6}\) | 0.032 |
| 블록 0 | 1 | 13 | 0.05498 | \(4.04 \times 10^{-6}\) | 0.040 |
| 블록 1 | 2 | 12 | 0.06872 | \(5.05 \times 10^{-6}\) | 0.051 |
| 블록 2 | 3 | 11 | 0.08590 | \(6.31 \times 10^{-6}\) | 0.063 |
| 블록 3 | 4 | 10 | 0.10737 | \(7.89 \times 10^{-6}\) | 0.079 |
| 블록 4 | 5 | 9 | 0.13422 | \(9.87 \times 10^{-6}\) | 0.099 |
| 블록 5 | 6 | 8 | 0.16777 | \(1.23 \times 10^{-5}\) | 0.123 |
| 블록 6 | 7 | 7 | 0.20972 | \(1.54 \times 10^{-5}\) | 0.154 |
| 블록 7 | 8 | 6 | 0.26214 | \(1.93 \times 10^{-5}\) | 0.193 |
| 블록 8 | 9 | 5 | 0.32768 | \(2.41 \times 10^{-5}\) | 0.241 |
| 블록 9 | 10 | 4 | 0.40960 | \(3.01 \times 10^{-5}\) | 0.301 |
| 블록 10 | 11 | 3 | 0.51200 | \(3.76 \times 10^{-5}\) | 0.376 |
| 블록 11 | 12 | 2 | 0.64000 | \(4.70 \times 10^{-5}\) | 0.470 |
| 마지막 층 정규화 | 14 | 0 | 1 | \(7.35 \times 10^{-5}\) | 0.735 |
표에서 읽을 것: 이웃한 두 블록의 학습률은 언제나 0.8배 차이이고, 그것이 열두 번 쌓여 맨 아래 블록은 맨 위 블록의 1/11.6 로 배운다. 임베딩은 머리(기본 학습률 \(10^{-4}\))의 3.2%, 약 1/31 이다. 이 표의 맨 윗줄 \(3.23 \times 10^{-6}\) 은 14장의 실제 학습 기록에 찍힌 가장 작은 학습률(lr_min 3.233e-06)과 같다.
구성 요소별 감쇠와 백본 학습률
위 식의 \(\rho^2\) 은 백본만의 것이 아니라 더 큰 규칙의 일부이다. 공식 구현은 모델을 세 덩어리로 나누고 덩어리마다 학습률에 \(\rho = 0.7\) 을 0번 · 1번 · 2번 곱한다.
| 덩어리 | 학습률 | 공식 기본값에서 | 미니 실험에서(\(\eta = 2 \times 10^{-4}\)) |
| 그 밖 전부: 프로젝터, 2단계 머리, 분류 · 박스 머리, 질의 임베딩 | \(\eta\) | \(1.0 \times 10^{-4}\) | \(2.0 \times 10^{-4}\) |
| 디코더 | \(\eta \cdot \rho\) | \(7.0 \times 10^{-5}\) | \(1.4 \times 10^{-4}\) |
| 백본(맨 위 기준) | \(\eta_{\text{enc}} \cdot \rho^2\) | \(7.35 \times 10^{-5}\) | \(1.47 \times 10^{-4}\) |
| 백본의 블록 \(j\) | \(\eta_{\text{enc}} \cdot \rho^2 \cdot \lambda^{\,L - j}\) | \(4.04 \times 10^{-6}\) – \(4.70 \times 10^{-5}\) | \(3.08 \times 10^{-5}\) – \(9.41 \times 10^{-5}\) |
- 백본의 기준 학습률 \(\eta_{\text{enc}} = 1.5\,\eta\) 는 기본 학습률보다 크다. 하지만 \(\rho^2 = 0.49\) 가 곱해지므로 실제로는 \(1.5 \times 0.49 = 0.735\) 배, 거기에 층별 감쇠가 더 곱해진다. 세 수의 곱으로 읽어야 한다.
- 프로젝터는 구조로는 백본과 디코더 사이에 있지만, 이 규칙에서는 “그 밖” 에 들어 기본 학습률 그대로 배운다. 공식 코드의 실제 동작이다.
- 백본의 가중치 감쇠에도 예외가 있다. 편향, 층 정규화, 임베딩에는 가중치 감쇠를 걸지 않는다(0). 나머지는 \(10^{-4}\) 이다.
미니 모델에 이 규칙을 적용한 결과이다. 실습 코드가 학습 전에 출력한다.
[매개변수 그룹] 기본 학습률 2e-4, lr_encoder 3e-4, 층별 감쇠 0.8, 구성 요소별 감쇠 0.7
    그룹                    | 학습률     | 기본 학습률의 몇 배 | 매개변수 수
    backbone: embeddings    | 2.466e-05 |    0.123          |    32,640
    backbone: block 0       | 3.083e-05 |    0.154          |   112,032
    backbone: block 1       | 3.854e-05 |    0.193          |   112,032
    backbone: block 2       | 4.817e-05 |    0.241          |   112,032
    backbone: block 3       | 6.021e-05 |    0.301          |   112,032
    backbone: block 4       | 7.526e-05 |    0.376          |   112,032
    backbone: block 5       | 9.408e-05 |    0.470          |   112,032
    backbone: final norm    | 1.470e-04 |    0.735          |       192
    projector               | 2.000e-04 |    1.000          |   300,544
    two-stage heads         | 2.000e-04 |    1.000          |   202,780
    decoder                 | 1.400e-04 |    0.700          |   584,096
    class + box heads       | 2.000e-04 |    1.000          |    33,927
    query embeddings        | 2.000e-04 |    1.000          |     6,336
- 그림: 그림 11-4 미니 RF-DETR 의 매개변수 그룹별 학습률(단위 \(10^{-4}\)). 파랑: 공식 규칙(층별 감쇠 0.8, 구성 요소별 감쇠 0.7, 백본 기준 학습률 1.5배). 주황 빗금: 모든 그룹에 같은 학습률을 준 경우(뒤의 절제 실험에서 “일정한 학습률” 로 쓴다). 가로축 이름 아래 괄호는 그 그룹의 매개변수 수이다.
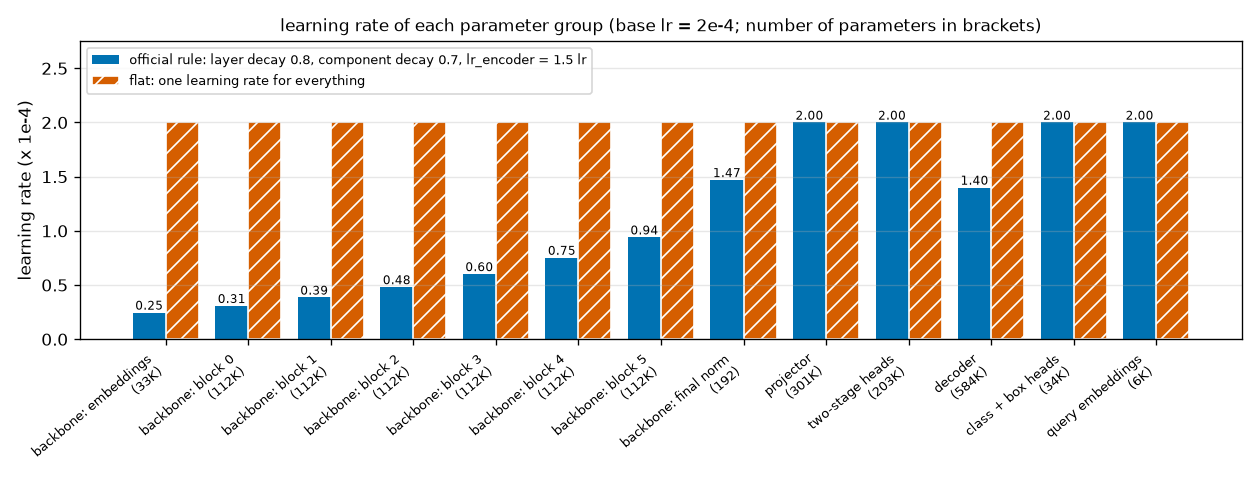
그림 11-4 의 파란 막대는 왼쪽에서 오른쪽으로 0.25, 0.31, 0.39, 0.48, 0.60, 0.75, 0.94 로 이어지는 계단 이다. 이웃한 막대의 비가 모두 0.8 이다. 손으로 확인해 보면 블록 5 는 \(3 \times 10^{-4} \times 0.8^{7 - 5} \times 0.49 = 3 \times 10^{-4} \times 0.64 \times 0.49 = 9.408 \times 10^{-5}\), 임베딩은 \(3 \times 10^{-4} \times 0.8^{8} \times 0.49 = 3 \times 10^{-4} \times 0.16777 \times 0.49 = 2.466 \times 10^{-5}\) 로 출력과 같다. 계단 뒤로 마지막 층 정규화 1.47, 프로젝터와 머리들 2.00, 디코더 1.40 이다. 백본의 첫 블록은 프로젝터의 0.154배, 약 1/6.5 의 빠르기로 배운다. 이 그림은 학습과 무관하게 규칙만으로 정해진다.
- 주의 · 이 장의 본 실험은 무작위 백본에 이 규칙을 쓴다
- 층별 학습률 감쇠는 사전 학습한 백본을 지키려는 장치이다. 그런데 이 장의 본 실험은 백본을 무작위로 초기화한다(도형 세상용 DINOv2 가 없으므로). 지킬 것이 없는 백본에 “조금만 고쳐라” 는 규칙을 거는 셈이라, 이 조합이 최선이라는 보장이 없다. 공식 설정을 그대로 줄여 옮긴다는 원칙 때문에 이렇게 했고, 그 대가가 얼마인지는 뒤의 절제 실험 (e)에서 잰다.
증강과 다중 해상도
셋째 물음, “모델에게 무엇을 보여 줄 것인가” 이다. 학습 그림을 그대로만 쓰지 않고 뒤집거나 잘라 변형해서 보여 주는 것을 데이터 증강(data augmentation)이라고 한다. 그림 한 장으로 여러 장의 효과를 내어 데이터가 적을 때 과적합을 줄인다. 박스가 있는 탐지에서는 그림을 변형하면 박스도 같은 방식으로 바꿔 주어야 한다. 예를 들어 수평 뒤집기는 정규화한 박스의 중심 가로 좌표만 \(c_x \to 1 - c_x\) 로 바꾼다. \((0.30, 0.40, 0.20, 0.10)\) 은 \((0.70, 0.40, 0.20, 0.10)\) 이 된다.
뒤집기와 자르기만
실시간 탐지기들은 증강을 아주 공격적으로 쓴다. 논문 3절이 드는 예만 해도 수직 뒤집기, 무작위 크기 조절, 무작위 자르기, 색 흔들기(YOLOX 식 HSV 증강), 여러 그림 섞기(MixUp) 등이다. 논문의 지적은 두 가지이다.
- 증강은 데이터에 대한 가정이다. “이렇게 변형해도 여전히 그럴듯한 그림이다” 라는 가정이 맞을 때만 도움이 된다. 논문은 증강이 데이터셋의 성질을 미리 안다고 전제한다는 점에서 학습률 스케줄과 같은 종류의 편향을 넣는다고 적는다.
- 틀린 가정은 해롭다. 논문의 예는 수직 뒤집기이다. 자율주행차의 사람 탐지기를 위아래로 뒤집은 그림으로 학습하면 안 된다. 물웅덩이에 비친(거꾸로 선) 사람을 사람으로 탐지하게 될 수 있기 때문이다.
도형 세상에도 같은 예가 있다. 이 세상의 삼각형은 언제나 꼭짓점이 위에 있다. 수평으로 뒤집은 그림은 여전히 도형 세상의 그림이지만, 수직으로 뒤집으면 꼭짓점이 아래에 있는, 이 세상에 없는 삼각형이 생긴다. 그런 그림으로 학습한 탐지기는 있지도 않은 것을 배우는 데 용량을 쓴다.
그래서 RF-DETR 은 증강을 수평 뒤집기와 무작위 자르기 두 가지로 제한한다(논문 3절). 어느 데이터에서나 대체로 안전한 것만 남긴 것이다. 증강을 학습 도중에 켜고 끄는 일정표도 두지 않는다. “스케줄러 없는” 이라는 말이 증강까지 가리키는 까닭이다.
배치 단위로 크기 바꾸기
또 하나의 증강이 다중 해상도 학습(multi-scale training)이다(다중 스케일 학습이라고도 한다). 학습 중에 입력 그림의 해상도를 무작위로 바꿔, 크게 보이는 객체와 작게 보이는 객체에 모두 익숙해지게 한다. 8장의 “다중 스케일 특징”(한 그림에서 여러 해상도의 특징 맵을 뽑는 것)과는 다른 이야기이다. 여기서는 입력 그림 자체의 크기를 바꾼다.
RF-DETR 은 LW-DETR 의 방식을 두 군데 고쳤다(논문 3절 · 부록 A).
| LW-DETR | RF-DETR | |
| 크기를 정하는 단위 | 그림마다 따로 무작위 크기. 배치 안에서 가장 큰 그림에 맞춰 나머지에 여백(패딩)을 붙임 | 배치 단위: 배치마다 크기 하나를 골라 배치 전체를 그 크기로 |
| 크기의 범위 | 기본 해상도의 0.7 – 1.4배 | 0.5 – 1.5배(기본 해상도를 가운데에 두고 대칭) |
| 해상도의 역할 | 데이터 증강 | 증강이면서 NAS 의 손잡이(12장) |
그림마다 크기를 따로 정하면 왜 나쁜지는 숫자로 보면 분명하다. 배치의 네 그림이 한 변 448, 512, 640, 704 로 정해졌다고 하자(설명을 위한 예이다). 넷을 한 텐서로 묶으려면 모두 704 × 704 로 맞춰야 한다.
\(\frac{448^2 + 512^2 + 640^2 + 704^2}{4 \times 704^2} = \frac{200{,}704 + 262{,}144 + 409{,}600 + 495{,}616}{1{,}982{,}464} = \frac{1{,}368{,}064}{1{,}982{,}464} = 0.69\)
텐서의 69% 만 진짜 그림이고 31% 는 여백이다. 논문은 이 방식에서 대부분의 그림에 큰 여백이 붙고, 그 여백이 윈도 어텐션에 흠(한 윈도가 통째로 여백인 경우 등)을 만들며 여백 영역의 계산이 낭비된다고 적는다. 배치 전체를 같은 크기로 바꾸면 크기 차이 때문에 생기는 여백이 없다. 논문은 이렇게 하면 모든 위치 인코딩 해상도가 학습 때 고르게 나타난다는 점도 이유로 든다. 위치 임베딩을 해상도에 맞춰 보간해 쓰는 모델이므로(6장), 어떤 해상도는 자주 보고 어떤 해상도는 거의 못 보는 일을 피하려는 것이다.
- 참고 · 공개 코드의 해상도 목록
- 공식 구현의 기본값은
multi_scale="per-batch",expanded_scales=True이다. 해상도 목록은 “윈도 하나의 한 변에 패치가 몇 개인가” 를 기본값에서 −5 부터 +5 까지 바꿔 만든다. Nano(해상도 384, 패치 16, 한 변의 윈도 2)는 기본이 \(384 / (16 \times 2) = 12\) 개이므로 \(7 \times 32 = 224\) 부터 \(17 \times 32 = 544\) 까지 32 간격의 11가지, 기본 해상도의 0.58 – 1.42배이다. 해상도 560 · 패치 14 · 윈도 4 인 설정에서는 \(5 \times 56 = 280\) 부터 \(15 \times 56 = 840\) 까지로 논문의 0.5 – 1.5배와 정확히 같다. 해상도가 언제나 패치 크기 × 윈도 수의 배수가 되게 하는 규칙이다.
이 장의 미니 실험은 증강도, 다중 해상도 학습도 쓰지 않는다. 도형 세상의 그림은 생성기가 무작위로 만든 합성 데이터라 4,000장이 이미 서로 다른 장면이고, 해상도를 바꾸는 학습은 12장의 주제이기 때문이다. 실습 코드의 train_one_epoch 에 배치 단위로 해상도를 바꾸는 선택 사항(resolutions)이 들어 있지만 이 장에서는 꺼 둔다.
사전 학습의 사다리
마지막은 “무엇에서 출발하는가” 이다. 지금까지의 설정들 — 낮은 학습률, 층별 감쇠 — 이 지키려던 것이 바로 이 출발점이다. RF-DETR 의 가중치는 목표 데이터를 만나기 전에 두 번의 학습을 거친다.
원문 그림 11-5. RF-DETR 가중치가 거치는 세 단계. 앞 단계의 결과(가중치)가 다음 단계의 초기값이 된다. 오른쪽으로 갈수록 데이터는 작아지고 과제는 목표에 가까워진다.
- ① 자기 지도 사전 학습: DINOv2. 라벨 없는 그림 1억 4,200만 장. 학습되는 것은 백본(6장).
- ② 지도 탐지 사전 학습: Objects365. 박스 라벨이 있는 큰 탐지 데이터. 학습되는 것은 모델 전체. 분할은 SAM2 의 의사 라벨로 학습한다.
- ③ 미세 조정: 목표 데이터(COCO, RF100-VL, 내 데이터). 학습되는 것은 모델 전체이고, 이 장의 학습 설정이 여기에 해당한다.
- DINOv2: 자기 지도 사전 학습. 백본은 라벨 없는 그림 1억 4,200만 장으로 학습한 DINOv2 의 가중치에서 출발한다(6장). 논문은 백본을 DINOv2 의 사전 학습 가중치로 초기화하면 작은 데이터셋에서 탐지 정확도가 크게 오른다고 적는다(3절).
- Objects365: 지도 탐지 사전 학습. 백본만으로는 탐지기가 아니다. 프로젝터 · 디코더 · 머리는 박스 라벨이 있어야 배울 수 있다. 그래서 모델 전체를 큰 탐지 데이터셋 Objects365(1장)에서 먼저 학습한다. LW-DETR 에서 물려받은 단계이다. 분할 모델은 마스크 라벨이 필요한데 Objects365 에는 박스만 있으므로, 논문은 SAM2 로 마스크를 만들어 붙인 의사 라벨(pseudo-label)로 탐지 머리와 분할 머리를 같은 데이터에서 사전 학습한다(부록 A, 13장).
- 목표 데이터: 미세 조정. 이렇게 만든 가중치에서 출발해 목표 데이터로 학습한다.
rfdetr패키지가 내려받는 가중치가 ②까지 마친 것이고, 사용자가 하는 일이 ③이다(14장).
각 단계가 얼마나 기여하는지는 두 논문의 표에 있다. 모두 COCO 에서 잰 값이다.
| 출처 | 비교 | COCO AP |
| RF-DETR 논문 표 5 | LW-DETR (M) | 52.6 |
| + 순한 하이퍼파라미터(낮은 학습률, 배치 정규화 → 층 정규화 등) | 51.6 | |
| + DINOv2 백본 | 53.6 | |
| + Objects365 사전 학습 추가 | 54.3 | |
| RF-DETR 논문 표 6 | CAEv2 ViT-S/16 백본(LW-DETR 의 백본) | 52.3 |
| DINOv2 ViT-S/14 백본 | 54.3 | |
| SigLIPv2 ViT-B/32 백본 | 50.4 | |
| SAM2 Hiera-S 백본 | 53.6 | |
| LW-DETR 논문 표 5 | LW-DETR small: Objects365 사전 학습 없음 → 있음 | 43.6 → 48.0 |
| LW-DETR medium: 없음 → 있음 | 47.2 → 52.5 |
- 표 5 의 둘째 줄은 눈여겨볼 만하다. 학습 설정을 순하게 바꾸는 것 자체는 COCO 점수를 1.0 내린다. 논문은 이 손해를 숨기지 않고, 배치 정규화를 층 정규화로 바꾼 것이 성능을 깎지만 소비자용 장비에서 학습하려면 필요하다고 적는다. 그 손해를 DINOv2 백본(+2.0)이 메우고, 낮은 학습률이 DINOv2 의 지식을 지키는 데 도움이 된다는 것이 논문의 설명이다. 설정과 백본은 따로 떼어 볼 수 없는 한 묶음이다.
- 표 6 은 같은 설정에서 백본만 바꾼 비교이다(표의 모든 모델이 Objects365 에서 60 에폭 사전 학습). DINOv2 가 CAEv2 보다 2.0 높다.
- LW-DETR 논문의 표 5 는 Objects365 사전 학습의 유무를 견준다. small 에서 +4.4, medium 에서 +5.3 이다. 같은 논문의 표 2(12 에폭 설정)에서는 +8.7 이었다.
이 수치들은 모두 사진 데이터(COCO)와 진짜 사전 학습 가중치에서 나온 것이다. 도형 세상의 미니 실험이 같은 효과를 보여 주는지는 따로 확인해야 하고, 결론부터 말하면 이 장의 미니 실험에서는 보이지 않았다. 뒤의 절제 실험 (e)에서 자세히 본다.
구현 따라 읽기
이제 code/ch11_train.py 를 읽는다. 모델은 10장의 MiniRFDETR 를 그대로 가져오고, 이 파일은 그것을 학습시키는 데 필요한 것 만 담는다. 손실(RFDETRCriterion), EMA(ModelEMA), 매개변수 그룹과 옵티마이저(build_optimizer), 학습 고리이다. IA-BCE 와 묶음별 매칭은 9장의 ch09_lwdetr_parts.py, 박스 연산은 2장, 채점은 3장의 파일에서 가져온다.
실행
실행 모드가 셋이고, 한 번에 하나씩 돌린다.
터미널
$ python ch11_train.py                # 본 실험: 60 에폭 학습 + 분석 (약 17분)
$ python ch11_train.py --ablations    # 절제 (a) – (d): 15 에폭짜리 학습 네 번 (약 16분). --seed 1 처럼 시드를 바꿀 수 있다
$ python ch11_train.py --pretrain     # 절제 (e): 백본 사전 학습과 비교 (약 25분)
$ python ch11_train.py --quick        # 연기 시험 (CPU 약 20초). --quick --ablations, --quick --pretrain 도 된다
시간은 8GB 노트북 GPU 한 장에서 잰 값인데, 여러 실행을 동시에 돌리며 잰 것이라 혼자 돌리면 더 빠르다. 이 모델은 작아서 스텝 하나에 약 0.1초가 걸리고, 그 대부분은 GPU 계산이 아니라 파이썬과 헝가리안 풀이의 왕복이다. 본 실험은 ch11_rfdetr.pt(일반 가중치 · EMA 가중치 · 모델 설정)와 ch11_history.json 을 실행 폴더에 저장한다. 12장과 13장이 이 체크포인트에서 출발한다. 7장 · 8장의 실험을 먼저 돌려 두었다면(ch07_history.json, ch08_history.json, ch08_deformable.pt) 그 곡선과 겹쳐 그린다.
손실: RFDETRCriterion
ch11_train.py · criterion
class RFDETRCriterion(nn.Module):
    """RF-DETR 의 집합 손실 (공식 criterion.py 의 SetCriterion 과 같은 식).

    층 하나(마지막 디코더 층, 앞 디코더 층들, 인코더 제안)마다
      1) 질의 묶음마다 따로 헝가리안 매칭.  비용 = 2·C_cls(포컬 꼴) + 5·C_L1 + 2·C_GIoU
      2) 분류: IA-BCE (cls_loss="ia_bce", 9장) 또는 포컬 손실 (cls_loss="focal", 8장 — 절제 실험용)
      3) 박스: 매칭된 쌍의 L1 합, (1 − GIoU) 합
      세 손실 모두 num_boxes = (배치의 정답 수) × (묶음 수) 로 나눈다.
    전체 = Σ_층 (1·loss_ce + 5·loss_bbox + 2·loss_giou).
    학습 모드(self.training)에서는 묶음 group_detr 개, 평가 모드에서는 1개로 본다 (모델의 출력과 맞춘다).
    """

    def __init__(self, num_classes: int = NUM_CLASSES, group_detr: int = 4, cls_loss: str = "ia_bce",
                 loss_ce: float = 1.0, loss_bbox: float = 5.0, loss_giou: float = 2.0,
                 alpha: float = 0.25, gamma: float = 2.0):
        super().__init__()
        assert cls_loss in ("ia_bce", "focal")
        self.num_classes, self.group_detr, self.cls_loss = num_classes, group_detr, cls_loss
        self.alpha, self.gamma = alpha, gamma
        self.matcher = GroupHungarianMatcher(cost_class=2.0, cost_bbox=5.0, cost_giou=2.0)
        self.weights = {"loss_ce": loss_ce, "loss_bbox": loss_bbox, "loss_giou": loss_giou}

    @torch.no_grad()
    def match_layers(self, layers, targets, groups: int):
        """여러 층의 매칭을 한꺼번에 한다 (비용 행렬을 GPU 에서 한 번에 만들고 CPU 로 한 번만 옮긴다).

        layers: [{"pred_logits": (B, Q, K), "pred_boxes": (B, Q, 4)}, …]  (Q = 묶음 수 × N)
        돌려주는 값: 층마다 (batch_idx, query_idx, tgt_idx) — 각각 (M,) LongTensor (M = 정답 수 × 묶음 수).
          k 번째 짝: 예측 pred[batch_idx[k], query_idx[k]] ↔ 배치의 정답을 한 줄로 이어 붙인 것의 tgt_idx[k] 번째.
        """
        logits = torch.stack([layer["pred_logits"] for layer in layers])  # (S, B, Q, K)
        boxes = torch.stack([layer["pred_boxes"] for layer in layers])  # (S, B, Q, 4)
        num_layers, batch, total = logits.shape[:3]
        sizes = [len(t["labels"]) for t in targets]
        offsets = np.cumsum([0] + sizes)
        cost = self.matcher.cost_matrix(logits.flatten(0, 2), boxes.flatten(0, 2),
                                        torch.cat([t["labels"] for t in targets]),
                                        torch.cat([t["boxes"] for t in targets]))
        cost = cost.view(num_layers, batch, total, -1).cpu().numpy()  # (S, B, Q, ΣT)
        layer_ids, batch_ids, query_ids, target_ids = [], [], [], []
        for s in range(num_layers):
            for b in range(batch):
                if sizes[b] == 0:
                    continue
                rows, cols = self.matcher.assign_groups(cost[s, b, :, offsets[b]:offsets[b + 1]], groups)
                layer_ids.append(np.full(len(rows), s))
                batch_ids.append(np.full(len(rows), b))
                query_ids.append(rows)
                target_ids.append(cols + offsets[b])
        index = np.stack([np.concatenate(ids) for ids in (layer_ids, batch_ids, query_ids, target_ids)])
        index = torch.as_tensor(index, dtype=torch.long, device=logits.device)  # (4, 전체 짝 수): 한 번에 장치로
        return [tuple(index[1:, index[0] == s]) for s in range(num_layers)]

    def layer_loss(self, layer, matched, tgt_labels, tgt_boxes, num_boxes):
        """층 하나의 세 손실. tgt_labels (ΣT,), tgt_boxes (ΣT, 4): 배치의 정답을 이어 붙인 것."""
        batch_idx, query_idx, tgt_idx = matched
        pred = layer["pred_boxes"][batch_idx, query_idx]  # (M, 4)
        target = tgt_boxes[tgt_idx]  # (M, 4)
        pred_xyxy, target_xyxy = box_cxcywh_to_xyxy(pred), box_cxcywh_to_xyxy(target)
        loss_bbox = F.l1_loss(pred, target, reduction="sum") / num_boxes
        loss_giou = (1 - paired_generalized_box_iou(pred_xyxy, target_xyxy)).sum() / num_boxes
        logits = layer["pred_logits"]
        if self.cls_loss == "ia_bce":
            ious = paired_box_iou(pred_xyxy.detach(), target_xyxy)  # 지금 이 예측 박스가 정답과 얼마나 겹치는가
            loss_ce = ia_bce_loss(logits, (batch_idx, query_idx), tgt_labels[tgt_idx], ious, num_boxes,
                                  self.alpha, self.gamma)
        else:
            onehot = torch.zeros_like(logits)
            onehot[batch_idx, query_idx, tgt_labels[tgt_idx]] = 1.0
            loss_ce = sigmoid_focal_loss(logits, onehot, self.alpha, self.gamma).sum() / num_boxes
        return {"loss_ce": loss_ce, "loss_bbox": loss_bbox, "loss_giou": loss_giou}

    def forward(self, outputs, targets, return_matches: bool = False):
        """outputs: MiniRFDETR 의 출력 사전, targets: 길이 B 의 목록 ({"labels": (T_b,), "boxes": (T_b, 4)}).

        돌려주는 값: 손실 사전. "loss" 가 역전파할 전체 손실. "loss_ce" · "loss_bbox" · "loss_giou" 는 마지막 디코더 층,
        "loss_ce_0" … 은 앞 층들, "loss_ce_enc" … 은 인코더 제안의 값 (계수를 곱하기 전).
        return_matches=True 면 (손실 사전, 매칭 목록) — 매칭 목록의 순서는 [마지막 층, 앞 층 0, 앞 층 1, …, 인코더 제안].
        """
        groups = self.group_detr if self.training else 1
        layers = [outputs] + list(outputs.get("aux_outputs", []))
        suffixes = [""] + [f"_{i}" for i in range(len(layers) - 1)]
        if "enc_outputs" in outputs:
            layers.append(outputs["enc_outputs"])
            suffixes.append("_enc")
        tgt_labels = torch.cat([t["labels"] for t in targets])
        tgt_boxes = torch.cat([t["boxes"] for t in targets])
        num_boxes = max(len(tgt_labels) * groups, 1)
        matches = self.match_layers(layers, targets, groups)
        losses = {}
        for layer, suffix, matched in zip(layers, suffixes, matches):
            for name, value in self.layer_loss(layer, matched, tgt_labels, tgt_boxes, num_boxes).items():
                losses[name + suffix] = value
        losses["loss"] = sum(self.weights["_".join(k.split("_")[:2])] * v for k, v in losses.items())
        return (losses, matches) if return_matches else losses
-
forward가 앞에서 본 식 그대로이다. 자리의 목록layers를 [마지막 층, 앞 층들, 인코더 제안] 순서로 만들고(접미사"","_0","_1","_enc"),num_boxes = 정답 수 × 묶음 수를 구하고, 자리마다layer_loss를 불러 세 손실을 사전에 담는다. 마지막 줄이 계수 1 · 5 · 2 의 가중합이다. 이름의 앞 두 토막(loss_ce등)으로 계수를 찾으므로 접미사가 붙어도 같은 계수가 쓰인다. -
groups = self.group_detr if self.training else 1: 묶음은 학습 때만 여럿이다. 모델이 평가 모드에서 첫 묶음의 질의만 내므로 손실도 같은 모드로 맞춰야 한다. 그래서 학습 고리가model.train()과criterion.train()을 함께 부른다. -
match_layers는 속도를 위한 묶음 처리이다. 네 자리의 로짓(S, B, Q, K)와 박스(S, B, Q, 4)를 쌓아(\(S\) 는 자리 수, \(Q = G \cdot N\)) 비용 행렬(S, B, Q, ΣT)를 GPU 에서 한 번에 만들고 CPU 로 한 번만 옮긴다. 그다음 자리마다 · 그림마다 9장의assign_groups가 묶음별로 헝가리안 풀이를 한다. 돌려주는 것은 자리마다 세 개의 번호 벡터 (그림 번호, 질의 번호, 정답 번호)이고 길이는 모두 짝의 수(정답 수 × 묶음 수, 코드 주석의M)이다. 함수 전체가@torch.no_grad()아래에 있다. 매칭에는 기울기가 없다. -
layer_loss에서pred = layer["pred_boxes"][batch_idx, query_idx]가 짝이 된 예측 박스(M, 4)를,tgt_boxes[tgt_idx]가 그 짝의 정답 박스(M, 4)를 뽑는다. L1 은 합을, GIoU 는 \(1 - \operatorname{GIoU}\) 의 합을num_boxes로 나눈다. - IA-BCE 에 넘기는 IoU 는
pred_xyxy.detach()로 계산한다. 목표를 만드는 데 쓰는 IoU 로는 기울기가 박스 쪽으로 흐르지 않는다. 박스는 박스 손실로만 배운다. -
cls_loss="focal"은 절제 실험용이다. IA-BCE 자리에 8장의 포컬 손실을 넣되 계수는 그대로 1 이다. 공식 구현에서ia_bce_loss설정만 끈 것에 해당한다(8장의 Deformable DETR 실험은 계수 2 를 썼으므로 그것과는 다르다).
EMA: ModelEMA
ch11_train.py · ema
class ModelEMA:
    """가중치의 지수 이동 평균. 공식 구현(RFDETREMACallback)과 같은 식이다.

    옵티마이저가 한 스텝 갈 때마다:   θ_ema ← d·θ_ema + (1 − d)·θ
    감쇠 d 는 처음에 0 에서 출발해 decay 로 올라간다:   d = decay · (1 − exp(−스텝 수 / τ))   (decay 0.993, τ 100)
    처음 몇 스텝은 d ≈ 0 이라 EMA 가 모델을 그대로 따라가므로, 무작위 초기값이 평균에 오래 남지 않는다.
    평가 · 배포에는 self.module (EMA 가중치를 가진 모델 사본) 을 쓴다.
    """

    def __init__(self, model: nn.Module, decay: float = 0.993, tau: float = 100.0):
        self.module = copy.deepcopy(model).eval()
        for p in self.module.parameters():
            p.requires_grad_(False)
        self.decay, self.tau, self.updates = decay, tau, 0

    def effective_decay(self, updates: int) -> float:
        return self.decay * (1 - math.exp(-updates / self.tau)) if self.tau > 0 else self.decay

    @torch.no_grad()
    def update(self, model: nn.Module):
        self.updates += 1
        d = self.effective_decay(self.updates)
        for ema_p, p in zip(self.module.parameters(), model.parameters()):
            ema_p.lerp_(p, 1 - d)  # ema + (1 − d)·(θ − ema) = d·ema + (1 − d)·θ
-
copy.deepcopy(model)로 사본을 만들고 기울기 계산을 꺼 둔다. 사본은 늘 평가 모드이다. 메모리에 모델이 하나 더 올라간다. -
effective_decay가 워밍업 식 \(d_n = d\,(1 - e^{-n/\tau})\) 이다.update가 불릴 때마다self.updates를 먼저 1 올리므로 \(n\) 은 1 부터 센다. 공식 구현과 같은 세는 법이다. -
ema_p.lerp_(p, 1 - d)는 “ema_p에서p쪽으로 \((1 - d)\) 만큼 간다” 는 제자리 연산이다. 풀어 쓰면 \(\theta_{\text{ema}} + (1 - d)(\theta - \theta_{\text{ema}}) = d\,\theta_{\text{ema}} + (1 - d)\,\theta\) 로 갱신식과 같다. - 공식 구현은 가중치뿐 아니라 버퍼(배치 정규화의 통계 같은, 학습되지 않는 상태)도 평균하는데, 이 미니 모델에는 버퍼가 없어 가중치만 평균한다.
매개변수 그룹과 옵티마이저
ch11_train.py · param-groups
def vit_layer_id(name: str, num_layers: int) -> int:
    """백본 매개변수의 "층 번호": 임베딩(패치 · CLS · 위치) 0, 블록 i 는 i + 1, 그 밖(마지막 층 정규화)은 num_layers + 1.

    공식 get_dinov2_lr_decay_rate 와 같은 규칙. 학습률 배율은 decay ** (num_layers + 1 − 층 번호) 이다.
    """
    if name.startswith("backbone.blocks."):
        return int(name.split(".")[2]) + 1
    if name.startswith(("backbone.patch_embed", "backbone.cls_token", "backbone.mask_token", "backbone.pos_embed")):
        return 0
    return num_layers + 1


def build_param_groups(model: MiniRFDETR, lr: float = 2e-4, lr_encoder: float | None = None,
                       vit_layer_decay: float = 0.8, component_decay: float = 0.7, weight_decay: float = 1e-4):
    """공식 param_groups.py 의 규칙으로 매개변수마다 학습률 · 가중치 감쇠를 정한다.

      백본(ViT)        lr_encoder · vit_layer_decay^(num_layers + 1 − 층 번호) · component_decay²
                       num_layers = out_feature_indexes[-1] + 1 (공식 구현이 이렇게 센다 — 블록 수보다 1 크다).
                       편향 · 층 정규화 · 임베딩(패치 임베딩의 가중치 포함)은 가중치 감쇠 0
      디코더           lr · component_decay        (디코더 층, decoder_norm, ref_point_head)
      그 밖            lr                          (프로젝터, 2단계 머리, 분류 · 박스 머리, 질의 임베딩)
    lr_encoder 를 주지 않으면 공식 기본값의 비율(1.5e-4 / 1e-4)대로 1.5 · lr.
    돌려주는 값: (옵티마이저에 넘길 그룹 목록, 사람이 읽을 표 [(이름, 학습률, 가중치 감쇠, 매개변수 수)]).
    """
    lr_encoder = 1.5 * lr if lr_encoder is None else lr_encoder
    num_layers = model.config["out_feature_indexes"][-1] + 1
    buckets, table = {}, {}
    for name, p in model.named_parameters():
        if name.startswith("backbone."):
            layer_id = vit_layer_id(name, num_layers)
            p_lr = lr_encoder * vit_layer_decay ** (num_layers + 1 - layer_id) * component_decay**2
            no_decay = layer_id == 0 or name.endswith(".bias") or "norm" in name
            p_wd = 0.0 if no_decay else weight_decay
            label = ("backbone: embeddings" if layer_id == 0 else
                     f"backbone: block {layer_id - 1}" if layer_id <= num_layers else "backbone: final norm")
        elif name.startswith(("decoder.", "decoder_norm.", "ref_point_head.")):
            p_lr, p_wd, label = lr * component_decay, weight_decay, "decoder"
        else:
            p_lr, p_wd = lr, weight_decay
            label = ("projector" if name.startswith("projector.") else
                     "two-stage heads" if name.startswith("enc_") else
                     "query embeddings" if name.startswith(("query_feat", "refpoint_embed")) else "class + box heads")
        buckets.setdefault((p_lr, p_wd), []).append(p)  # 설정이 같은 매개변수는 한 그룹으로
        row = table.setdefault(label, [p_lr, 0])
        row[1] += p.numel()
    groups = [{"params": params, "lr": g_lr, "weight_decay": g_wd} for (g_lr, g_wd), params in buckets.items()]
    return groups, [(label, row[0], row[1]) for label, row in table.items()]


def build_optimizer(model: MiniRFDETR, lr: float = 2e-4, **kwargs):
    """AdamW. 스케줄러는 없다 — RF-DETR 은 학습 내내 같은 학습률을 쓴다 (워밍업도 없다)."""
    groups, table = build_param_groups(model, lr, **kwargs)
    return torch.optim.AdamW(groups, lr=lr, weight_decay=kwargs.get("weight_decay", 1e-4)), table
-
vit_layer_id가 층 번호 \(i\) 를 정한다. 이름이backbone.blocks.j.로 시작하면 \(j + 1\), 임베딩류(패치 임베딩 · CLS 토큰 · 마스크 토큰 · 위치 임베딩)면 0, 그 밖(마지막 층 정규화)이면 \(L + 1\) 이다. -
build_param_groups는 모든 매개변수를 이름으로 훑으며 학습률과 가중치 감쇠를 정한다. 백본이면 \(\eta_{\text{enc}} \cdot \lambda^{L + 1 - i} \cdot \rho^2\), 디코더(디코더 층 · 디코더의 층 정규화 · 기준점 머리)면 \(\eta \cdot \rho\), 나머지는 \(\eta\) 이다.num_layers = out_feature_indexes[-1] + 1이 앞에서 본 “\(L\) 을 세는 법” 이다. - PyTorch 의 옵티마이저는 매개변수를 그룹 으로 받고 그룹마다 학습률 · 가중치 감쇠를 따로 둘 수 있다.
buckets가 (학습률, 가중치 감쇠)가 같은 매개변수끼리 한 그룹으로 묶는다. 이 모델에서는 열 몇 개의 그룹이 생긴다. -
build_optimizer는 그 그룹들로AdamW를 만들 뿐이다. 스케줄러를 만드는 줄이 없다. 이것이 “스케줄러 없는 학습” 의 구현이다. - “일정한 학습률” 설정은
lr_encoder=lr, vit_layer_decay=1.0, component_decay=1.0을 주면 된다. 모든 매개변수가 같은 학습률을 받는다.
학습 고리
ch11_train.py · train-loop — 원문에서 접어 둔 긴 코드라 옮기지 않는다. code/ch11_train.py 의 train-loop 영역에 있다.
train_one_epoch 의 한 스텝은 여섯 줄이다.
-
criterion(model(images, **kwargs), targets): 순전파와 손실. -
optimizer.zero_grad(): 지난 스텝의 기울기 지우기. 스텝마다 지우므로 기울기 누적은 없다. -
losses["loss"].backward(): 전체 손실 하나를 역전파. -
clip_grad_norm_(model.parameters(), max_norm): 전체 노름을 0.1 로 자르기. 역전파와 갱신 사이 에 있어야 한다. -
optimizer.step(): AdamW 갱신. -
ema.update(model): 갱신된 가중치로 EMA 를 한 번 갱신. 갱신 뒤 에 있어야 방금 고친 가중치가 평균에 들어간다.
7장의 학습 고리와 견주면 여섯째 줄 하나가 늘었다. resolutions 와 forward_kwargs_fn 은 12장을 위한 자리이다(배치마다 해상도를, 스텝마다 구조를 바꾸는 가중치 공유 NAS). 이 장에서는 쓰지 않는다.
fit 은 에폭마다 손실을 기록하고, 채점하는 에폭(처음 10 에폭은 매번, 그 뒤 5 에폭마다)에 일반 모델과 EMA 모델을 둘 다 검증 세트로 채점한다. 기록의 "AP" 는 EMA 모델, "AP_raw" 는 일반 모델의 값이다. predict 와 evaluate_model 은 디코더 층 수 · 질의 수 · 윈도 수 같은 순전파 인자를 받을 수 있게 만든 추론 · 채점 함수이다.
실험 한 번을 묶은 함수
ch11_train.py · run — 원문에서 접어 둔 긴 코드라 옮기지 않는다. code/ch11_train.py 의 run 영역에 있다.
run_experiment 는 시드를 고정하고 모델 · 손실 · 옵티마이저 · EMA · 데이터 로더를 만들어 fit 을 부른다. 본 실험과 모든 절제 실험이 이 함수 하나를 인자만 바꿔 부른다. cls_loss(분류 손실), vit_layer_decay · component_decay · lr_encoder(학습률 규칙), backbone_state(사전 학습한 백본), 그리고 **model_config(묶음 수 · 윈도 수 같은 모델 설정)가 절제의 손잡이이다.
ch11_train.py · main — 원문에서 접어 둔 긴 코드라 옮기지 않는다. code/ch11_train.py 의 main 영역에 있다.
공식 구현과 같은 점, 다른 점
| 항목 | 이 장의 실습 | 공식 구현(기본값) |
| 매칭 | 같음: 자리마다 · 묶음마다 헝가리안, 비용 2 · 포컬 꼴 + 5 · L1 + 2 · (−GIoU) | |
| 손실과 계수 | 같음: IA-BCE 1, L1 5, GIoU 2. 모든 디코더 층과 인코더 제안. 정답 수 × 묶음 수로 나눔 | |
| 옵티마이저 | 같음: AdamW, 가중치 감쇠 1e-4, 기울기 자르기 0.1, 스케줄러 · 워밍업 없음 | |
| 학습률 규칙 | 같음: 백본 기준 학습률 1.5배, 층별 감쇠 0.8, 구성 요소별 감쇠 0.7, 백본의 편향 · 층 정규화 · 임베딩은 가중치 감쇠 0 | |
| EMA | 같음: 감쇠 0.993, \(\tau\) = 100, 스텝마다 갱신 | |
| 기본 학습률 | 2e-4 | 1e-4 |
| 묶음 수 · 질의 수 | 4 × 12 | 13 × 300 |
| 배치 · 에폭 | 32, 60 에폭 | 4(기울기 누적은 선택), 100 에폭 |
| 증강 · 다중 해상도 | 없음 | 수평 뒤집기 · 무작위 자르기, 배치 단위 다중 해상도 |
| 백본의 초기값 | 무작위(절제 (e)에서만 사전 학습) | DINOv2 → Objects365 사전 학습 가중치 |
| 저장하는 가중치 | 마지막 에폭의 일반 · EMA 가중치 | 검증 AP 가 가장 좋았던 에폭의 가중치 |
| 혼합 정밀도(AMP) | 쓰지 않음 | 사용 |
가장 큰 차이는 백본의 초기값 이다. 공식 설정의 낮은 학습률과 층별 감쇠는 사전 학습 백본을 전제로 한 것인데, 이 장의 본 실험은 그 설정을 무작위 백본에 쓴다. 실습 코드를 만들면서 묶음별 매칭의 배정 결과와 EMA 의 실효 감쇠를 공식 구현의 함수와 따로 대조해 같음을 확인했다(이 장의 출력에는 들어 있지 않다).
결과 읽기: 본 실험
도형 세상의 학습 그림 4,000장으로 60 에폭(7,500 스텝) 학습하고 검증 그림 500장(정답 객체 1,265개)으로 채점했다. 데이터 · 에폭 수 · 배치 크기가 7장 · 8장의 실험과 같다. 시드는 하나(0)이다. 학습 전 점검의 출력(손실의 대조, EMA 의 감쇠, 매개변수 그룹)은 앞에서 이미 보았다.
학습 기록
[미니 RF-DETR (본 실험)] 매개변수 1,832,707개, 에폭 60, 에폭당 125 스텝, 학습 그림 4000장
에폭   1 | 손실 12.6887 (ce 0.7255 bbox 0.2475 giou 0.5632) | EMA AP 0.3085 AP50 0.6125 AP75 0.2667 | 일반 AP 0.3011 AP50 0.6071 AP75 0.2574 |    20초
에폭   2 | 손실  6.5819 (ce 0.7249 bbox 0.0720 giou 0.2068) | EMA AP 0.7094 AP50 0.9182 AP75 0.8495 | 일반 AP 0.6839 AP50 0.9100 AP75 0.8218 |    40초
에폭   3 | 손실  4.2412 (ce 0.5508 bbox 0.0378 giou 0.1139) | EMA AP 0.8190 AP50 0.9545 AP75 0.9201 | 일반 AP 0.8133 AP50 0.9530 AP75 0.9191 |    60초
에폭   4 | 손실  3.5206 (ce 0.4545 bbox 0.0306 giou 0.0936) | EMA AP 0.8541 AP50 0.9684 AP75 0.9407 | 일반 AP 0.8443 AP50 0.9717 AP75 0.9458 |    80초
에폭   5 | 손실  3.0661 (ce 0.3808 bbox 0.0269 giou 0.0829) | EMA AP 0.8692 AP50 0.9751 AP75 0.9520 | 일반 AP 0.8710 AP50 0.9777 AP75 0.9585 |   101초
에폭   6 | 손실  2.7935 (ce 0.3425 bbox 0.0243 giou 0.0759) | EMA AP 0.8795 AP50 0.9798 AP75 0.9567 | 일반 AP 0.8732 AP50 0.9794 AP75 0.9577 |   122초
에폭   7 | 손실  2.5498 (ce 0.3062 bbox 0.0224 giou 0.0703) | EMA AP 0.8907 AP50 0.9813 AP75 0.9620 | 일반 AP 0.8766 AP50 0.9828 AP75 0.9609 |   139초
에폭   8 | 손실  2.3972 (ce 0.2829 bbox 0.0212 giou 0.0669) | EMA AP 0.8957 AP50 0.9821 AP75 0.9646 | 일반 AP 0.8850 AP50 0.9827 AP75 0.9642 |   159초
에폭   9 | 손실  2.2488 (ce 0.2618 bbox 0.0198 giou 0.0630) | EMA AP 0.9025 AP50 0.9842 AP75 0.9680 | 일반 AP 0.8929 AP50 0.9870 AP75 0.9641 |   179초
에폭  10 | 손실  2.1134 (ce 0.2428 bbox 0.0186 giou 0.0595) | EMA AP 0.9074 AP50 0.9870 AP75 0.9664 | 일반 AP 0.9023 AP50 0.9867 AP75 0.9684 |   198초
에폭  15 | 손실  1.7616 (ce 0.2025 bbox 0.0152 giou 0.0498) | EMA AP 0.9198 AP50 0.9887 AP75 0.9677 | 일반 AP 0.8976 AP50 0.9859 AP75 0.9637 |   278초
에폭  20 | 손실  1.5361 (ce 0.1800 bbox 0.0132 giou 0.0442) | EMA AP 0.9255 AP50 0.9892 AP75 0.9683 | 일반 AP 0.9135 AP50 0.9881 AP75 0.9700 |   356초
에폭  25 | 손실  1.3999 (ce 0.1683 bbox 0.0117 giou 0.0395) | EMA AP 0.9268 AP50 0.9886 AP75 0.9690 | 일반 AP 0.9188 AP50 0.9888 AP75 0.9707 |   427초
에폭  30 | 손실  1.3104 (ce 0.1601 bbox 0.0108 giou 0.0369) | EMA AP 0.9294 AP50 0.9892 AP75 0.9735 | 일반 AP 0.9237 AP50 0.9882 AP75 0.9689 |   506초
에폭  35 | 손실  1.2336 (ce 0.1487 bbox 0.0101 giou 0.0346) | EMA AP 0.9322 AP50 0.9895 AP75 0.9758 | 일반 AP 0.9243 AP50 0.9878 AP75 0.9741 |   577초
에폭  40 | 손실  1.1636 (ce 0.1425 bbox 0.0094 giou 0.0324) | EMA AP 0.9325 AP50 0.9893 AP75 0.9721 | 일반 AP 0.9265 AP50 0.9891 AP75 0.9734 |   654초
에폭  45 | 손실  1.1055 (ce 0.1366 bbox 0.0090 giou 0.0311) | EMA AP 0.9333 AP50 0.9896 AP75 0.9745 | 일반 AP 0.9272 AP50 0.9894 AP75 0.9734 |   730초
에폭  50 | 손실  1.0826 (ce 0.1327 bbox 0.0086 giou 0.0298) | EMA AP 0.9347 AP50 0.9913 AP75 0.9757 | 일반 AP 0.9277 AP50 0.9893 AP75 0.9790 |   806초
에폭  55 | 손실  1.0303 (ce 0.1287 bbox 0.0082 giou 0.0285) | EMA AP 0.9352 AP50 0.9912 AP75 0.9752 | 일반 AP 0.9272 AP50 0.9898 AP75 0.9791 |   888초
에폭  60 | 손실  0.9761 (ce 0.1206 bbox 0.0076 giou 0.0265) | EMA AP 0.9347 AP50 0.9897 AP75 0.9762 | 일반 AP 0.9292 AP50 0.9869 AP75 0.9783 |   964초
학습 끝: 964초
[본 실험] 학습 958초 (7500 스텝), EMA 모델 AP 0.9347 AP50 0.9897 AP75 0.9762 | 일반 모델 AP 0.9292 AP50 0.9869 AP75 0.9783
- 줄마다 왼쪽부터 전체 손실, 괄호 안은 마지막 디코더 층의 세 손실(계수를 곱하기 전), EMA 모델의 검증 AP, 일반 모델의 검증 AP, 누적 시간이다.
- “손실” 은 네 자리의 합이다. 마지막 에폭에서 마지막 층만 계산하면 \(0.1206 + 5 \times 0.0076 + 2 \times 0.0265 = 0.2116\) 이고, 전체 0.9761 은 그 4.6배이다. 인코더 제안과 앞 층들의 손실이 마지막 층보다 조금씩 크기 때문에 4배보다 크다.
- 분류 손실은 처음 두 에폭 동안 거의 줄지 않는다(0.7255 → 0.7249). 그사이 박스 손실은 1/3 로 줄고(L1 0.2475 → 0.0720) AP 는 0.31 에서 0.71 로 오른다. 학습이 멈춘 것이 아니다. IA-BCE 의 목표 \(t\) 가 예측 박스의 IoU 에 묶여 있어, 박스가 좋아질수록 목표가 올라가고 “점수를 더 올려라” 는 손실이 함께 커지기 때문으로 읽을 수 있다. 학습 전 점검에서 이 손실이 0.12 로 오히려 작았던 것도 같은 이유이다. 그때는 박스가 정답과 거의 겹치지 않아 목표가 0 근처였다. 14장의 실제 RF-DETR 학습 기록에서도 같은 모습이 나온다.
- 3 에폭 만에 AP 0.82, 10 에폭에 0.91 이고, 그 뒤로는 천천히 올라 0.935 근처에서 멈춘다.
학습 곡선
- 그림: 그림 11-6 미니 RF-DETR 의 학습 곡선. 왼쪽: 마지막 디코더 층의 학습 손실 세 항(계수를 곱한 값, 세로축 로그 눈금). 파랑 실선 분류(IA-BCE), 주황 점선 5 × L1, 초록 쇄선 2 × (1 − GIoU). 오른쪽: 검증 AP50(파랑), AP(주황, 굵은 선), AP75(초록). 실선이 EMA 모델, 점선이 일반 모델.
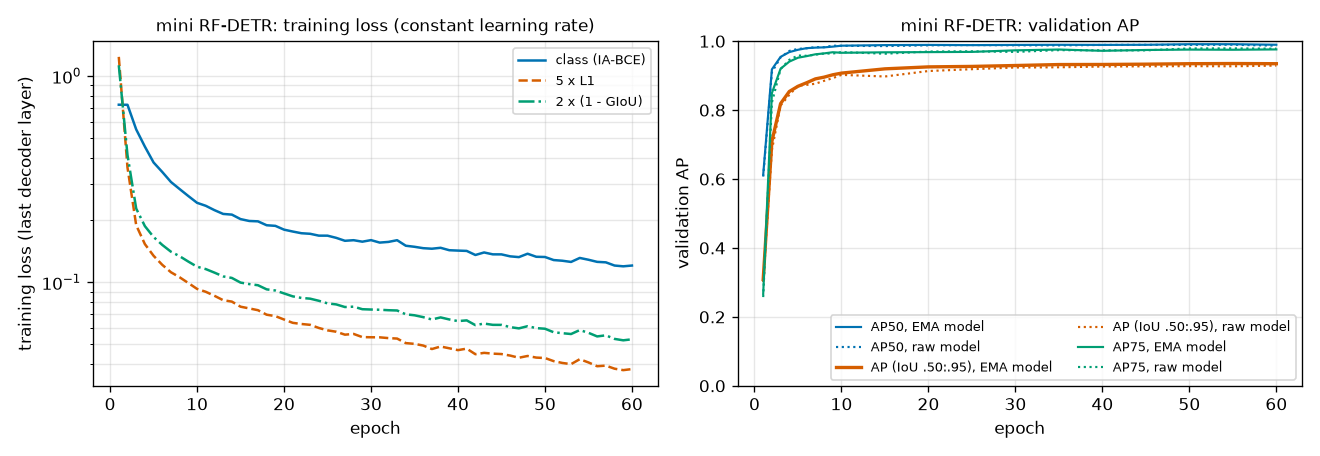
- 왼쪽: 계단이 없다. 7장 · 8장의 손실 곡선에는 48 에폭에서 학습률을 낮출 때 생기는 꺾임이 있었다. 여기서는 학습률이 끝까지 같아 세 곡선이 매끄럽게 내려간다. 60 에폭에도 아직 내려가는 중이다.
- 세 손실의 높이가 다르다. 박스의 두 손실은 열 배 넘게 줄었는데 분류 손실(파랑)은 0.12 근처에서 느리게 내려간다. 앞의 참고 상자에서 본 대로 IA-BCE 에는 0 보다 큰 바닥이 있다. \(t = 0.975\) 이면 그 바닥이 \(0.975 \times 0.02532 + 0.025 \times 3.68888 = 0.0247 + 0.0922 = 0.117\) 이므로, 0.12 는 학습 그림에서 짝들의 목표가 대략 그쯤이라는 것과 어긋나지 않는다.
- 오른쪽: 손실은 계속 줄지만 검증 AP 는 40 에폭쯤부터 멈춘다(EMA 모델 0.9325 – 0.9352). 검증 AP 가 내려가지는 않으므로 과적합이라고 할 징후는 없다. 이 모델과 데이터에서 얻을 수 있는 만큼을 얻었다고 보는 편이 맞다.
- 점선(일반 모델)이 실선(EMA 모델)의 바로 아래를 따라간다. 굵은 주황 선에서 15 에폭 근처가 가장 벌어져 있다. 뒤에서 따로 본다.
7장 · 8장과 겹쳐 보기
- 그림: 그림 11-7 같은 데이터 · 같은 에폭 수 · 같은 배치 크기로 학습한 세 모델의 검증 AP(왼쪽)와 AP75(오른쪽). 파랑 실선: 7장 MiniDETR. 주황 점선: 8장 Deformable DETR. 초록 쇄선: 이 장의 미니 RF-DETR(EMA 모델). 분홍 점선: 같은 모델의 일반 가중치. 점은 채점한 에폭.
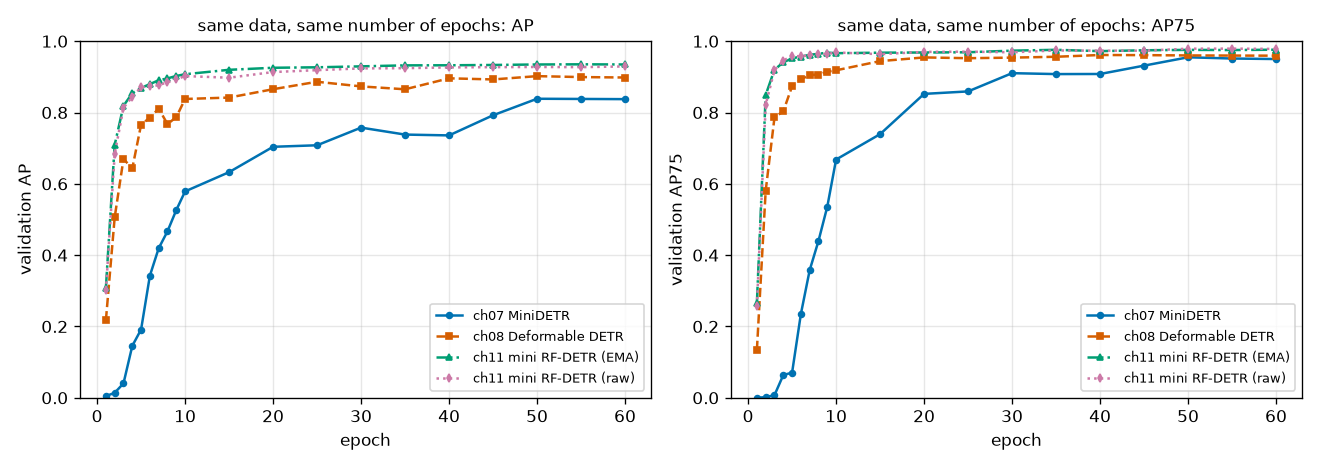
| 에폭 | 7장 MiniDETR | 8장 Deformable DETR | 11장 미니 RF-DETR(EMA) | 11장 미니 RF-DETR(일반) |
| 1 | 0.0048 | 0.2173 | 0.3085 | 0.3011 |
| 3 | 0.0405 | 0.6698 | 0.8190 | 0.8133 |
| 7 | 0.4193 | 0.8109 | 0.8907 | 0.8766 |
| 10 | 0.5788 | 0.8380 | 0.9074 | 0.9023 |
| 20 | 0.7039 | 0.8654 | 0.9255 | 0.9135 |
| 40 | 0.7358 | 0.8959 | 0.9325 | 0.9265 |
| 50 | 0.8386 | 0.9020 | 0.9347 | 0.9277 |
| 60 | 0.8375 | 0.8982 | 0.9347 | 0.9292 |
  ch07 MiniDETR: AP 0.5 / 0.8 / 0.9 에 처음 닿은 에폭 = 9 / 50 / None, 마지막 AP 0.8375
  ch08 Deformable DETR: AP 0.5 / 0.8 / 0.9 에 처음 닿은 에폭 = 2 / 7 / 50, 마지막 AP 0.8982
  ch11 mini RF-DETR (EMA): AP 0.5 / 0.8 / 0.9 에 처음 닿은 에폭 = 2 / 3 / 9, 마지막 AP 0.9347
  ch11 mini RF-DETR (raw): AP 0.5 / 0.8 / 0.9 에 처음 닿은 에폭 = 2 / 3 / 10, 마지막 AP 0.9292
그림 11-7 에서 읽을 것은 두 가지이다. 빨리 오른다. AP 0.8 에 처음 닿는 에폭이 7장 50, 8장 7, 이 장 3 이다. 높이 간다. 마지막 AP 가 0.8375, 0.8982, 0.9347 이다. 또 7장의 파란 선은 48 에폭에서 학습률을 낮추자 한 번 뛰어오르는데(0.79 → 0.84), 초록 선에는 그런 조작이 없고 필요해 보이지도 않는다.
- 주의 · 이 차이를 어느 부품의 공으로 돌릴 수 없다
“RF-DETR 의 구조가 좋아서 0.90 이 0.93 이 되었다” 고 쓰고 싶어지지만, 이 비교는 그렇게 말해 주지 않는다. 8장의 본 모델과 이 장의 모델 사이에는 달라진 것이 너무 많다.
- 백본: 작은 CNN 대신 ViT(윈도 + 전역 어텐션)와 C2f 프로젝터. 특징 레벨도 둘에서 하나로
- 2단계 질의 선택(8장의 본 모델은 쓰지 않았다)
- 박스: 층마다 기준을 고쳐 가는 박스 반복 정제 대신, 박스 재매개변수화와 lite 기준점 정제(모든 층이 같은 기준 박스를 쓴다)
- 분류 손실: 포컬 → IA-BCE
- 질의 묶음 4개
- EMA
- 학습률: 48 에폭 뒤 낮추기 → 끝까지 일정, 층별 감쇠
한꺼번에 일곱 가지를 바꾼 비교에서 한 가지의 효과를 읽을 수는 없다. 오히려 다음 두 가지가 눈에 띈다. 8장의 절제 실험에서 2단계만 더한 Deformable DETR 은 15 에폭에 AP 0.9100 이었다. 이 장 모델의 15 에폭은 EMA 모델 0.9198, 일반 모델 0.8976 이다(8장 쪽은 12 에폭 뒤에 학습률을 낮춘 값이라 엄밀히 같은 조건은 아니다). 일반 가중치끼리 보면 8장의 2단계 모델과 같은 수준이다. 그리고 아래 절제 실험에서 IA-BCE · 질의 묶음 · 윈도의 효과는 작게 나온다. 그러니 이 실험이 뒷받침하는 말은 여기까지이다: 8장의 본 모델보다 나아진 것의 큰 부분은 2단계 질의 선택과 EMA 로 설명될 수 있다. 그 이상은 이 실험으로 주장할 수 없다.
EMA 모델과 일반 모델
[EMA vs 일반] 채점한 20개 에폭 가운데 EMA 가 높은 에폭 19개, 차이의 평균 +0.0091, 범위 -0.0018 – +0.0256, 마지막 에폭 +0.0055
  후반(에폭 30 뒤)의 AP 표준편차: 일반 0.0015, EMA 0.0011
앞의 그림 11-3 으로 돌아가 가운데와 오른쪽 그림을 본다. 가운데는 두 모델의 검증 AP 곡선(파랑 실선 EMA, 주황 점선 일반), 오른쪽은 채점한 스무 에폭마다의 차이 AP(EMA) − AP(일반) 이다. 파란 막대는 EMA 가 높은 에폭, 주황 막대는 낮은 에폭이다.
- 스무 번 가운데 열아홉 번 EMA 모델이 높았다. 차이의 평균은 +0.0091, 마지막 에폭에서 +0.0055(0.9347 대 0.9292)이다. 추가 학습 없이, 같은 학습에서 가중치를 평균해 두기만 한 대가로 얻은 것이다.
- 차이가 큰 곳은 두 종류이다. 하나는 초반이다(2 에폭 +0.026). 감쇠 워밍업 덕분에 EMA 가 뒤처지지 않으면서 흔들림만 지운다. 다른 하나는 일반 모델이 주춤한 에폭이다(15 에폭 +0.022). 기록을 보면 일반 모델의 AP 가 10 에폭 0.9023 에서 15 에폭 0.8976 으로 내려갔는데 EMA 모델은 0.9074 에서 0.9198 로 올랐다. 일반 가중치가 하필 나쁜 순간에 채점된 것이고, 평균은 그런 순간을 지운다.
- 한 번은 졌다. 5 에폭에서 일반 모델이 0.0018 높다. 모델이 아직 빠르게 좋아지는 구간이라 과거를 섞은 평균이 조금 뒤처진 것으로 읽을 수 있다. 14장의 실제 RF-DETR 실험에서도 첫 에폭에 같은 일이 있었다.
- 모든 지표에서 이긴 것도 아니다. 마지막 에폭의 AP75 는 일반 모델이 조금 높다(0.9783 대 0.9762). 후반(30 에폭 뒤)의 AP 표준편차는 일반 0.0015, EMA 0.0011 로 둘 다 작다. 이 데이터에서는 일반 모델도 그리 출렁이지 않는다.
같은 코드를 한 번 더 돌리면 숫자는 조금씩 달라진다(GPU 연산의 비결정성). 그래서 “+0.0091” 이라는 값보다 방향이 스무 번 가운데 열아홉 번 같았다 는 쪽을 믿는 편이 좋다. 뒤의 절제 실험에서 시드 셋으로 다시 확인한다.
디코더 층 수별 AP
모든 자리에 손실을 걸었으므로 어느 자리의 출력이든 채점할 수 있다. 학습이 끝난 EMA 모델에서 인코더 제안만(디코더 0층), 디코더 1층까지, 2층까지, 3층까지의 출력을 따로 채점했다. 다시 학습하지 않는다.
[디코더 층 수별 AP] EMA 모델, 검증 500 장
디코더 층 수 | AP     AP50   AP75  | NMS 뒤 AP  AP50  | 점수≥0.5 예측 수 | 그중 IoU>0.5 로 겹치는 쌍
   0 (제안)    | 0.8928 0.9898 0.9657 | 0.8906  0.9888 |     1278         |     41
   1         | 0.9289 0.9896 0.9747 | 0.9286  0.9914 |     1272         |     26
   2         | 0.9332 0.9895 0.9759 | 0.9318  0.9899 |     1260         |      8
   3         | 0.9347 0.9897 0.9762 | 0.9333  0.9900 |     1261         |      9
  클래스별 AP: circle 0.9729, rectangle 0.9071, triangle 0.9241
  점수 ≥ 0.5 예측 수가 정답 객체 수와 같은 그림: 484 / 500장
- 그림: 그림 11-8 쓰는 디코더 층 수별 검증 AP(왼쪽)와 AP50(오른쪽). 파랑 실선: 예측 그대로. 주황 점선: NMS 를 건 뒤. 가로축의 0 은 인코더 제안만 쓴 경우이다. 점 아래 숫자가 파란 점의 값이다.
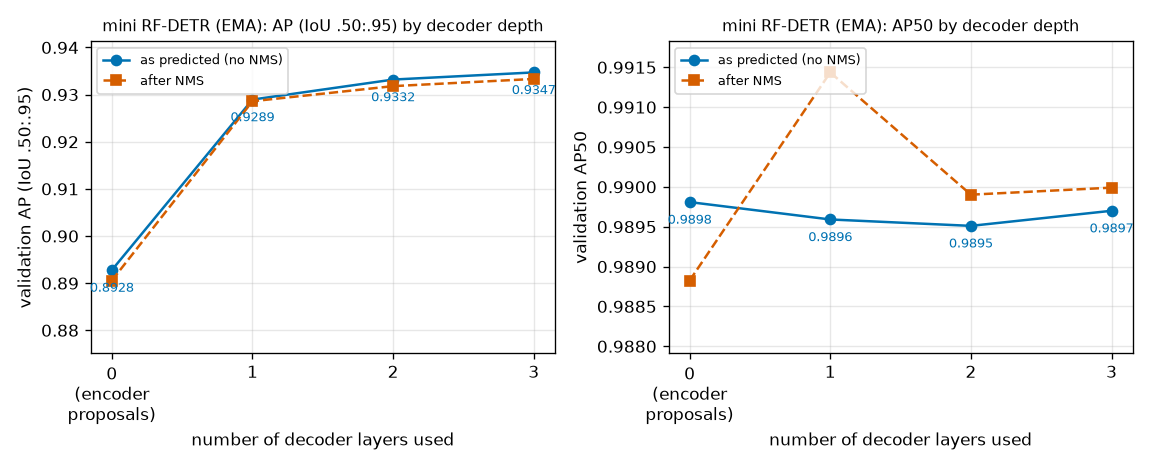
- 디코더 없이도 AP 0.8928 이다. 특징 맵의 칸이 직접 낸 제안 12개만으로 8장의 본 모델(0.8982)과 비슷하다. 인코더 제안에 건 손실이 제안을 “거친 탐지 결과” 로 만든다는 앞의 설명이 숫자로 나타난 것이다.
- 디코더는 찾는 일이 아니라 다듬는 일을 한다. 0층에서 3층으로 가며 AP 는 0.8928 → 0.9347 로 0.042 오르는데 AP50 은 0.9898 → 0.9897 로 그대로이다. AP50 은 “대충 맞는 박스가 있는가” 를 보는 지표이니, 객체를 찾는 일은 제안 단계에서 이미 끝나 있다. 오르는 것은 AP75(0.9657 → 0.9762)를 비롯한 엄격한 IoU 문턱값 쪽, 곧 박스의 정밀함이다.
- 첫 층이 대부분을 한다. 층별 증가가 +0.036, +0.004, +0.0015 이다. 마지막 층 하나를 떼어도 AP 는 0.0015 만 내려간다.
- 오른쪽 그림은 세로축을 꼭 확인하자. 주황 점선이 크게 꺾여 보이지만 세로축의 범위가 0.988 – 0.992 이다. 네 점의 차이는 모두 0.003 안쪽이고, 읽을 만한 차이가 아니다.
- NMS 는 어느 깊이에서도 이득이 없다. NMS 뒤의 AP 가 그대로이거나 조금 낮다(−0.002 – 0.000). 점수 0.5 이상인 예측끼리 IoU 0.5 넘게 겹치는 쌍은 41 → 26 → 8 → 9 로, 제안 단계에 조금 있던 중복을 디코더가 줄인다. 디코더의 자기 어텐션이 질의끼리 정보를 주고받아 중복을 없앤다는 7장의 설명과 맞는 방향이다.
- 참고 · 논문의 숫자와 섞지 말자
- RF-DETR 논문은 COCO 에서 마지막 디코더 층 하나를 빼면 지연 시간이 10% 줄고 2 mAP 가 내려간다고 적는다. 이 장의 “0.0015 내려간다” 는 객체가 1 – 4개뿐인 도형 세상에서 잰 값이다. 방향(층을 덜 쓰면 조금 덜 정확하다)은 같지만 크기는 데이터에 따라 크게 다르다. 디코더 층 수를 손잡이로 쓰는 이야기는 12장에서 이어진다.
그 밖에 클래스별 AP 는 원 0.9729, 사각형 0.9071, 삼각형 0.9241 로 사각형이 가장 낮다. 7장 · 8장에서도 같은 순서였다(원인은 따로 분석하지 않았다). 점수 0.5 이상인 예측의 수가 정답 객체 수와 정확히 같은 그림은 500장 가운데 484장이다.
예측 그림과 선택된 제안
- 그림: 그림 11-9 검증 그림 0 – 7 의 예측(초록 실선, 점수 0.5 이상)과 정답(흰 점선). 7장 · 8장의 예측 그림과 같은 그림들이다. 제목은 “예측 수 / 정답 수”.
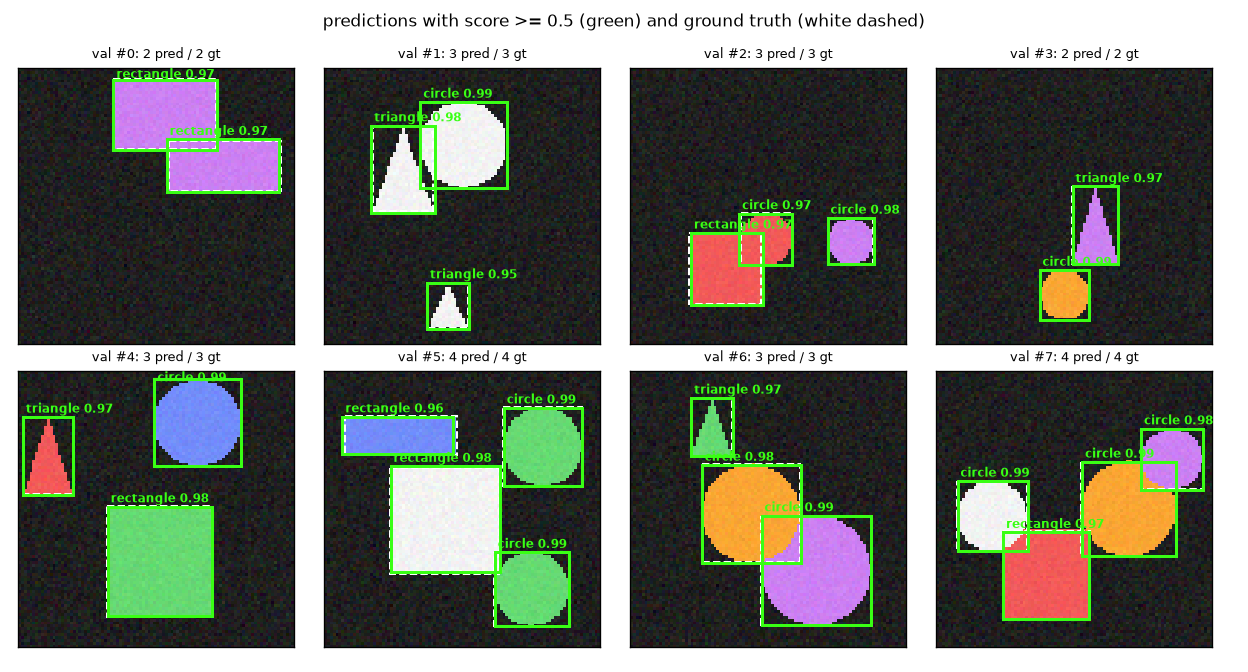
여덟 장 모두 예측 수와 정답 수가 맞고, 초록 박스가 흰 점선에 거의 붙어 있다. 점수는 0.95 – 0.99 이다. 서로 겹친 도형(2번의 사각형과 원, 6번의 두 원, 7번의 세 도형)도 따로따로 잡았다. 다만 이 여덟 장은 잘된 쪽이다. 전체 500장 가운데 개수가 맞는 것은 484장이므로 열여섯 장에서는 놓치거나 더 낸 예측이 있다.
- 그림: 그림 11-10 2단계 질의 선택의 실제 모습(위: 검증 1번, 아래: 검증 2번). 맨 왼쪽: 선택된 12칸의 제안 박스(한 변 0.05). 노랑은 마지막에 점수 0.5 이상이 되는 질의의 칸, 회색은 나머지, 가는 선은 12 × 12 칸의 경계, 흰 점선은 정답. 오른쪽 넷: 노란 질의들의 예측이 인코더 제안(디코더 0층) → 디코더 1층 → 2층 → 3층에서 어떻게 나오는지(초록, 클래스와 점수).
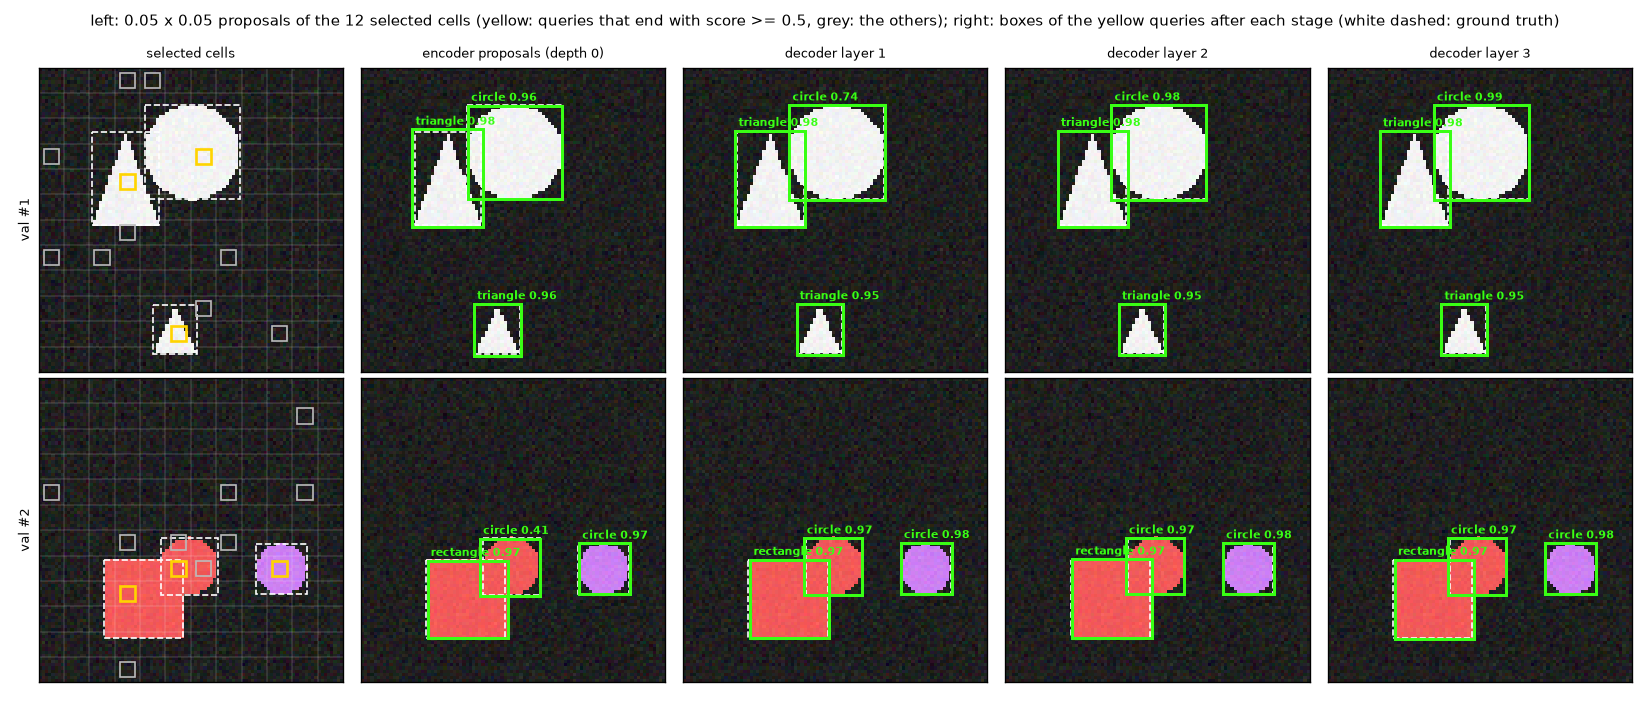
- 맨 왼쪽: 노란 칸은 모두 객체의 안쪽, 중심 근처에 있다. 회색 칸은 배경에 흩어져 있다. 객체가 셋인 그림에서 12칸을 뽑으므로 아홉은 남는 자리이고, 그 질의들은 낮은 점수로 끝난다. 어느 칸을 뽑을지 가르친 것은 인코더 제안의 분류 손실 하나뿐이다.
- 둘째 열: 인코더 제안만으로 박스가 이미 정답에 가깝다. 한 변 0.05 짜리 작은 제안에서 출발해(맨 왼쪽의 작은 네모) 2단계 박스 머리가 한 번에 객체 크기로 키운 결과이다.
- 디코더는 박스를 조금 다듬고 점수를 고친다. 아래 줄의 가려진 원을 보자. 사각형에 반쯤 가려져 인코더 제안에서는 점수가 0.41 이었는데 디코더 1층에서 0.97 이 된다. 제안 단계는 칸 하나의 특징만 보고 점수를 매기지만, 디코더는 교차 어텐션으로 주변을 다시 읽고 자기 어텐션으로 다른 질의와 견줄 수 있다.
- 층을 지날수록 언제나 좋아지기만 하는 것은 아니다. 위 줄의 원은 점수가 0.96 → 0.74 → 0.98 → 0.99 로 1층에서 잠깐 내려갔다가 올라온다.
점수는 박스 품질을 따라가는가
3장의 실험에서 “박스가 같아도 점수의 순서가 나쁘면 AP 가 내려간다” 는 것을 보았고, 좋은 점수란 박스가 정확할수록 높은 점수 라고 정리했다. 그때 미뤄 둔 물음을 이제 확인한다. IA-BCE 로 학습한 모델의 점수는 정말 박스의 IoU 를 따라갈까?
재는 방법은 이렇다. 검증 세트의 정답 객체마다 “그 객체를 찾은 예측” 을 하나 고른다. 클래스가 같고 IoU 가 0.5 이상인 예측 가운데 점수가 가장 높은 것이다(3장의 채점에서 그 객체의 참 양성이 되는 예측). 그 예측의 (점수, IoU) 쌍을 모아 둘이 함께 움직이는 정도를 본다.
“함께 움직이는 정도” 를 재는 수로 스피어만 상관(Spearman's rank correlation)을 쓴다. 값 자체가 아니라 순위 로 계산하는 상관 계수이다. 점수가 큰 순서로 1등, 2등, … 을 매기고 IoU 로도 순위를 매긴 다음, 두 순위가 얼마나 일치하는지를 −1 과 +1 사이의 수로 낸다. 두 순위가 완전히 같으면 +1, 정반대면 −1, 무관하면 0 근처이다. 순위가 겹치지 않을 때는 순위의 차 \(\delta_k\) 로 간단히 계산된다(\(P\) 는 쌍의 수, \(\delta_k\) 는 \(k\) 번째 쌍의 두 순위의 차).
\(r_s = 1 - \frac{6 \sum_{k=1}^{P} \delta_k^{\,2}}{P\,(P^2 - 1)}\)
예측 다섯 개의 점수 순위가 (1, 2, 3, 4, 5)이고 IoU 순위가 (2, 1, 3, 5, 4)라면 순위의 차는 (−1, 1, 0, −1, 1), 제곱의 합은 4 이고 \(r_s = 1 - \frac{6 \times 4}{5 \times 24} = 1 - 0.2 = 0.8\) 이다. 보통의 상관 계수(피어슨)는 값들이 직선 관계인지를 보는데, 여기서는 점수와 IoU 가 대부분 0.9 – 1.0 에 몰려 있고 몇 개만 멀리 떨어져 있어서 그 몇 개에 값이 크게 흔들린다. AP 에 중요한 것도 점수의 값이 아니라 순서이므로 순위 상관이 더 알맞다.
[점수와 IoU] 정답 객체마다 그 객체를 찾은 예측 (같은 클래스 · IoU ≥ 0.5 가운데 점수가 가장 높은 것) 의 점수와 IoU
  ch11 mini RF-DETR (IA-BCE)   | 찾은 객체 1261 / 1265 | 피어슨 +0.545 | 스피어만 +0.760 | 평균 점수 0.959 | 평균 IoU 0.953 | 평균 |점수 − IoU| 0.028
  ch08 Deformable DETR (focal) | 찾은 객체 1254 / 1265 | 피어슨 +0.509 | 스피어만 +0.358 | 평균 점수 0.915 | 평균 IoU 0.939 | 평균 |점수 − IoU| 0.071
- 그림: 그림 11-11 정답 객체마다 그 객체를 찾은 예측의 IoU(가로)와 점수(세로). 왼쪽: 이 장의 모델(IA-BCE). 오른쪽: 8장의 모델(포컬 손실). 주황 선은 IoU 구간별 평균 점수, 회색 점선은 점수 = IoU 인 대각선이다.
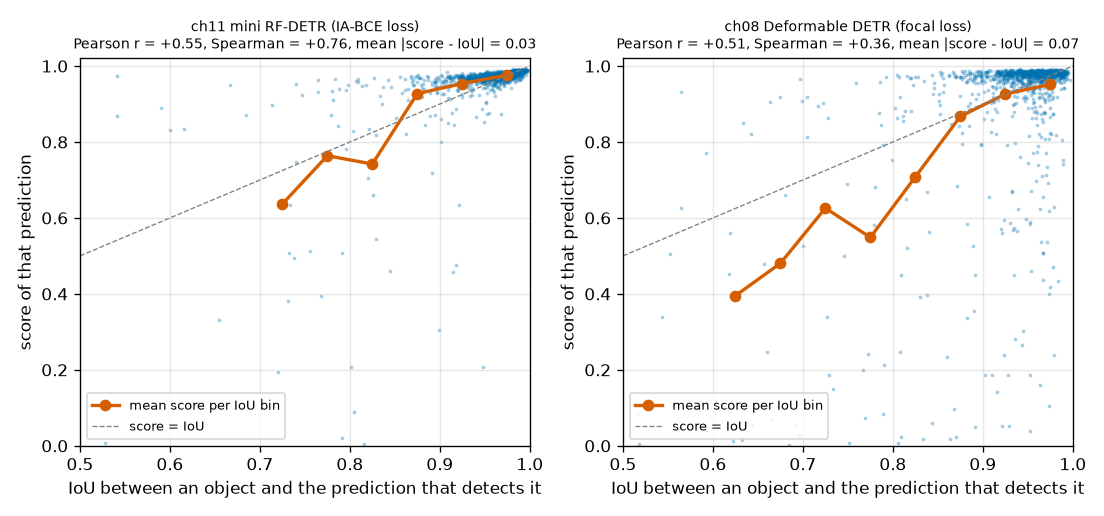
- 왼쪽은 점들이 대각선 둘레에 모여 있다. 주황 선(구간별 평균 점수)이 IoU 0.85 위에서 대각선에 붙어 올라간다. 평균 점수 0.959, 평균 IoU 0.953, 둘의 차의 절댓값 평균이 0.028 이다. 9장에서 유도한 “점수가 IoU 로 끌려간다” 가 학습된 모델에서 실제로 나타난다. 이 모델의 점수 0.95 는 “IoU 가 0.95 쯤 되는 박스” 라는 뜻에 가깝다.
- 오른쪽은 세로로 퍼져 있다. IoU 가 0.95 를 넘는 좋은 박스인데 점수가 0.2 – 0.8 인 점이 오른쪽 끝에 길게 늘어서 있다. 포컬 손실의 목표는 짝이면 1, 아니면 0 일 뿐이라 박스가 얼마나 좋은지를 점수에 담을 이유가 없다.
- 스피어만 상관이 +0.760 대 +0.358 이다. 이 장의 모델에서는 점수 순으로 줄을 세우면 대체로 IoU 순이 된다. 3장의 물음에 대한 답이다.
다만 이 비교는 두 모델의 구조도 학습 길이도 다르므로 “IA-BCE 덕분” 이라고 단정할 수 없다. 같은 구조에서 손실만 바꾼 비교가 필요하다. 다음 절의 절제 (a)가 그것이다.
결과 읽기: 절제 실험
본 실험은 “이 설정 전체가 잘 동작한다” 는 것만 보여 준다. 부품 하나하나가 얼마나 기여하는지 알려면 한 번에 하나만 바꿔 다시 학습해 봐야 한다. 1장에서 본 절제 실험이다. 다섯 가지를 했다.
| 절제 | 바꾼 것 | 기준(base) | 이 장의 어느 주제 |
| (a) | 분류 손실을 포컬 손실로 | IA-BCE | 손실 |
| (b) | 질의 묶음을 1개로 | 묶음 4개 | 손실(Group DETR) |
| (c) | EMA 를 쓰지 않음(일반 모델로 채점) | EMA 모델로 채점 | EMA |
| (d) | 윈도를 1 × 1 로(모든 블록이 전역 어텐션) | 윈도 2 × 2 | 9 · 10장의 구조 |
| (e) | 백본을 사전 학습한 것으로, 학습률 규칙을 일정하게 | 무작위 백본, 공식 학습률 규칙 | 사전 학습, 층별 학습률 감쇠 |
실험 설계와 읽는 규칙
- (a) – (d): 학습 4,000장, 15 에폭, 나머지는 본 실험과 같은 설정. 시드 0 · 1 · 2 로 세 번씩 돌렸다(시드는 모델의 초기값과 데이터 순서를 바꾼다).
- (c) 는 따로 학습하지 않았다. EMA 는 학습에 끼어들지 않으므로, base 한 번의 학습에서 EMA 모델과 일반 모델을 같은 에폭에 채점해 견주면 그것이 곧 “EMA 를 켠 것” 과 “끈 것” 의 비교이다.
- (e): 뒤에서 따로 설명한다. 학습 그림 200장(시드 3개)과 4,000장(시드 1개)에서 견주었다.
- 설정은 결과를 보기 전에 정했고, 결과를 본 뒤에 바꾸지 않았다. 처음에는 시드 하나로 돌렸는데 차이가 너무 작아 판단할 수 없어서, 같은 설정으로 시드만 둘 더 돌렸다.
숫자를 읽기 전에 얼마나 큰 차이부터 믿을 것인가 를 정해 둔다. 재는 자의 눈금보다 작은 차이는 읽을 수 없다. 이 실험의 눈금은 두 가지로 알 수 있다.
- 같은 설정 · 같은 시드를 다시 돌려도 결과가 다르다. base(시드 0)를 두 번 학습한 마지막 AP 는 0.9180 과 0.9182 로 가깝지만, 도중에는 더 벌어진다(1 에폭 0.3145 대 0.3113, 5 에폭 0.8643 대 0.8688). GPU 연산의 비결정성 때문이다.
- 시드를 바꾸면 더 다르다. base 의 세 시드는 0.9180, 0.9210, 0.9163 으로 폭이 0.0047 이다.
- 읽는 규칙 · 0.005 보다 작은 차이는 읽지 않는다
- 아무것도 바꾸지 않아도 AP 가 0.005 쯤은 움직인다. 그러니 이 절의 표에서 두 설정의 차이가 0.005 안쪽이면 “차이가 보이지 않았다” 고 읽는다. 차이가 그보다 크더라도, 세 시드에서 방향이 같은지를 함께 본다.
네 가지 절제의 표
시드 0 의 실행에서 나온 표이다.
[절제 (a) – (d)] 학습 4000장, 15 에폭, 시드 1개 — 마지막 에폭의 검증 AP
  설정                                  | EMA 모델: AP    AP50   AP75  | 일반 모델: AP   AP50   AP75  | AP≥0.8 첫 에폭 (EMA) | 학습 시간
  base: IA-BCE, 4 groups, 2x2 windows   |          0.9180 0.9858 0.9695 |          0.9027 0.9828 0.9664 |          3           |   255초
  focal loss                            |          0.9144 0.9869 0.9681 |          0.9092 0.9880 0.9690 |          5           |   254초
  1 query group                         |          0.9156 0.9864 0.9712 |          0.8921 0.9885 0.9683 |          3           |   214초
  1x1 window (all global)               |          0.9166 0.9861 0.9667 |          0.9074 0.9859 0.9664 |          3           |   189초
  (c) EMA 유무는 base 한 번의 학습에서 EMA 모델과 일반 모델을 견준 것이다. 에폭별:
      에폭           1      2      3      5      7     10     15
      EMA  AP   0.3145 0.7172 0.8091 0.8643 0.8885 0.9053 0.9180
      일반 AP   0.2998 0.6859 0.7994 0.8500 0.8789 0.8875 0.9027
세 시드를 모은 요약이다. 마지막 에폭의 EMA 모델 검증 AP 와, 같은 시드의 base 와의 차이이다.
[절제 (a) – (d) 시드별 요약] 시드 [0, 1, 2] — 마지막 에폭의 EMA 모델 검증 AP 와, 같은 시드의 base 와의 차이
  설정                                  | 시드별 AP                | 평균   | base 와의 차이 (시드별)        | 차이의 평균
  base: IA-BCE, 4 groups, 2x2 windows   | 0.9180 0.9210 0.9163     | 0.9184 | +0.0000 +0.0000 +0.0000        | +0.0000
  focal loss                            | 0.9144 0.9103 0.9136     | 0.9128 | -0.0036 -0.0107 -0.0028        | -0.0057
  1 query group                         | 0.9156 0.9165 0.9158     | 0.9160 | -0.0024 -0.0045 -0.0005        | -0.0025
  1x1 window (all global)               | 0.9166 0.9251 0.9154     | 0.9190 | -0.0014 +0.0041 -0.0009        | +0.0006
  base, raw model (no EMA)              | 0.9027 0.9121 0.9000     | 0.9049 | -0.0153 -0.0089 -0.0163        | -0.0135
  AP50 의 시드 평균: base 0.9853 | focal loss 0.9834 | 1 query group 0.9860 | 1x1 window (all global) 0.9871
  AP75 의 시드 평균: base 0.9674 | focal loss 0.9679 | 1 query group 0.9701 | 1x1 window (all global) 0.9694
  점수와 IoU 의 상관 (스피어만), 시드별: IA-BCE +0.659 +0.631 +0.667 | focal +0.215 +0.318 +0.240
- 그림: 그림 11-12 절제 (a) – (d) 의 검증 AP(왼쪽)와 AP75(오른쪽), 시드 0. 파랑 실선: base. 주황 점선: 포컬 손실. 초록 쇄선: 묶음 1개. 분홍 점선: 윈도 1 × 1. 노랑 긴 점선: base 의 일반 모델(EMA 없음).
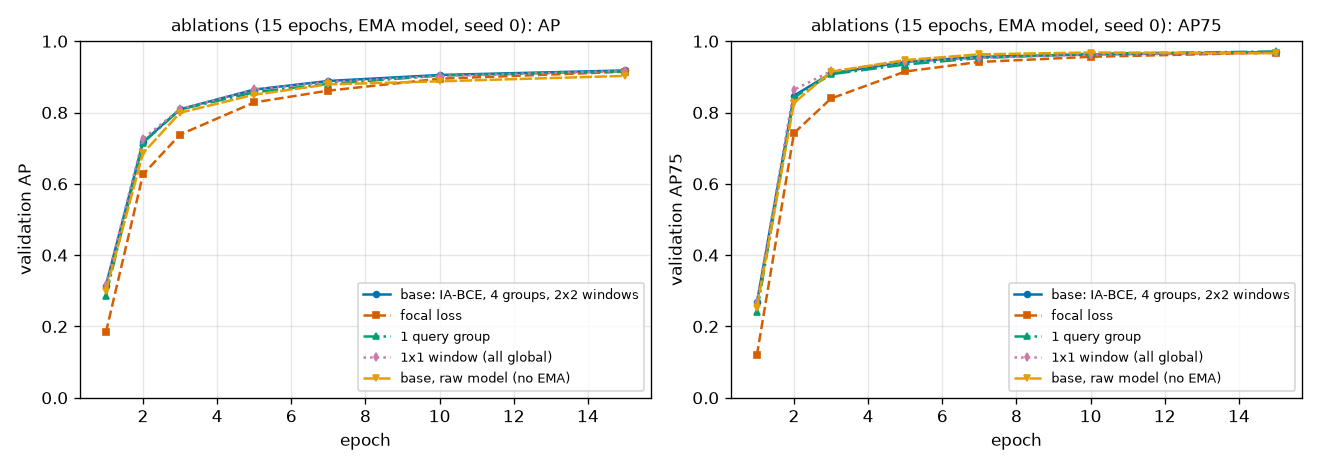
그림 11-12 에서 먼저 눈에 들어오는 것은 곡선들이 거의 겹친다 는 점이다. 초반에 뚜렷이 처지는 것은 주황 점선(포컬 손실) 하나이고(2 에폭 0.63 대 0.72), 15 에폭에는 다섯 곡선이 모두 0.90 – 0.92 에 모인다. 요약 표의 “차이의 평균” 열을 읽는 규칙에 비추면 이렇게 갈린다.
| 절제 | base 와의 차이(시드 0 · 1 · 2) | 평균 | 읽기 |
| (c) EMA 없음 | −0.0153, −0.0089, −0.0163 | −0.0135 | 뚜렷함. 세 시드 모두 눈금보다 크고 방향이 같음 |
| (a) 포컬 손실 | −0.0036, −0.0107, −0.0028 | −0.0057 | 방향은 세 시드 모두 같지만 크기가 눈금 언저리 |
| (b) 묶음 1개 | −0.0024, −0.0045, −0.0005 | −0.0025 | 보이지 않음(눈금 안) |
| (d) 윈도 1 × 1 | −0.0014, +0.0041, −0.0009 | +0.0006 | 보이지 않음(부호도 섞임) |
네 가지 가운데 효과가 가장 크고, 유일하게 세 시드 모두에서 뚜렷한 것은 EMA 이다. EMA 를 끄면 AP 가 평균 0.0135 내려간다. 60 에폭 본 실험의 마지막 차이(0.0055)보다 큰데, 15 에폭은 일반 모델이 아직 더 흔들리는 때이기 때문일 것이다. 나머지 셋을 차례로 본다.
IA-BCE 대 포컬 손실
AP 만 보면 IA-BCE 의 이득은 작다. 세 시드 모두 IA-BCE 쪽이 높기는 하지만 평균 0.0057 이고, 두 시드에서는 0.004 가 안 된다. AP50 의 시드 평균은 0.9853 대 0.9834, AP75 는 0.9674 대 0.9679 로 차이가 없다. 일관된 차이는 초반의 빠르기 에 있다. AP 0.8 에 처음 닿는 에폭이 세 시드 모두 IA-BCE 는 3, 포컬은 5 이다.
그런데 점수와 IoU 의 관계를 보면 이야기가 달라진다. 이번에는 모델 구조와 학습 길이가 같고 분류 손실만 다른 두 모델의 비교이다.
[절제 (a)] 점수와 IoU — 같은 모델 구조, 분류 손실만 다름 (정답 객체마다 그 객체를 찾은 예측의 점수와 IoU)
  IA-BCE loss (base)           | 찾은 객체 1258 / 1265 | 피어슨 +0.569 | 스피어만 +0.659 | 평균 점수 0.935 | 평균 IoU 0.945 | 평균 |점수 − IoU| 0.035
  focal loss                   | 찾은 객체 1262 / 1265 | 피어슨 +0.429 | 스피어만 +0.215 | 평균 점수 0.808 | 평균 IoU 0.945 | 평균 |점수 − IoU| 0.140
- 그림: 그림 11-13 같은 미니 RF-DETR 을 15 에폭 학습한 두 모델(시드 0). 왼쪽: IA-BCE. 오른쪽: 포컬 손실. 형식은 그림 11-11 과 같다(가로 IoU, 세로 점수, 주황 선은 구간별 평균 점수, 회색 점선은 점수 = IoU).
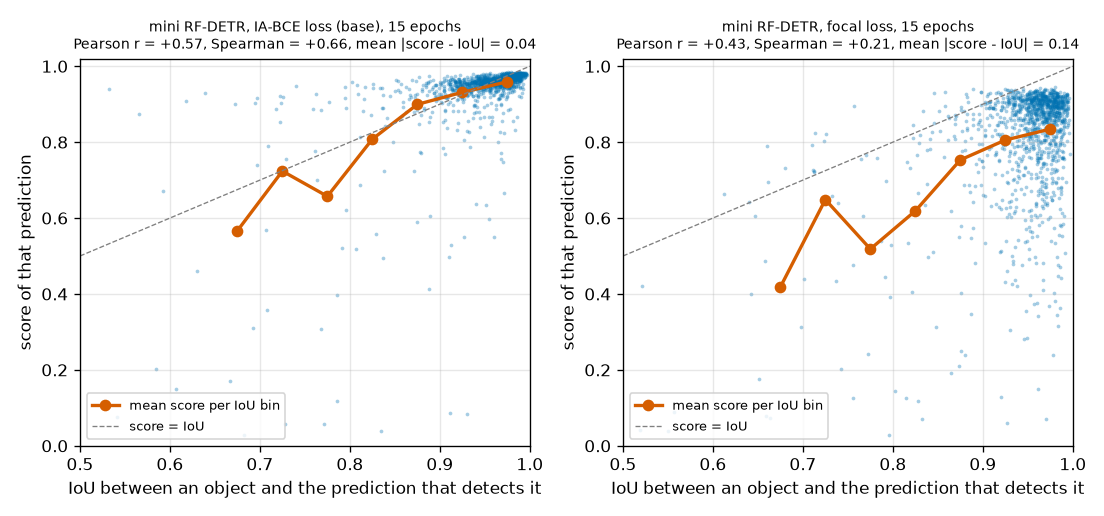
| 시드 0 | 시드 1 | 시드 2 | |
| 스피어만 상관: IA-BCE / 포컬 | +0.659 / +0.215 | +0.631 / +0.318 | +0.667 / +0.240 |
| 평균 점수(평균 IoU): IA-BCE | 0.935 (0.945) | 0.926 (0.946) | 0.930 (0.943) |
| 평균 점수(평균 IoU): 포컬 | 0.808 (0.945) | 0.783 (0.945) | 0.788 (0.945) |
| 평균 \(|\text{점수} - \text{IoU}|\): IA-BCE / 포컬 | 0.035 / 0.140 | 0.040 / 0.165 | 0.036 / 0.159 |
- 스피어만 상관이 세 시드 평균 +0.65 에서 +0.26 으로 떨어진다. 눈금을 따질 필요가 없는 크기이고 세 시드 모두 그렇다. 손실만 바꿔도 “점수가 박스 품질을 따라가는 정도” 가 크게 달라진다. 앞 절의 8장 모델과의 비교(+0.76 대 +0.36)가 구조 차이 때문만은 아니었다는 뜻이다.
- 박스는 똑같이 좋다. 평균 IoU 가 두 손실에서 0.945 로 같다. 다른 것은 점수뿐이다. IA-BCE 모델은 평균 점수 0.93 이 평균 IoU 0.945 와 거의 같고(그림 왼쪽: 대각선 둘레), 포컬 모델은 평균 점수가 0.78 – 0.81 로 IoU 와 무관하게 낮으며 0.6 – 0.95 에 넓게 퍼져 있다(그림 오른쪽).
점수의 뜻은 이만큼 달라졌는데 AP 는 왜 조금밖에 안 달라질까? 3장의 실험이 답을 준다. 점수의 순서는 참 양성과 거짓 양성이 섞여 있을 때 중요하다. 이 데이터는 그림마다 객체가 1 – 4개뿐이고 대부분의 예측 박스가 IoU 0.9 를 넘는다. 엄격한 문턱값에서도 거짓 양성이 될 박스가 적어서, 순서를 바로잡아 얻을 것이 적다. 3장의 복선은 이 실험에서 절반만 회수된 셈이다. “IA-BCE 는 점수를 박스 품질에 맞춘다” 는 뚜렷이 확인되었고, “그래서 AP 가 오른다” 는 약하게만 확인되었다.
- 참고 · 논문이 COCO 에서 보고한 값
- LW-DETR 논문의 표 2 는 COCO 에서(12 에폭 설정) IoU 인지 분류 손실을 더하면 34.7 → 35.4 mAP 로 0.7 오른다고 보고한다. 그림마다 객체가 많고 박스의 질이 고르지 않은 데이터에서의 값이다. 이 장의 값(도형 세상, 평균 +0.006)과는 다른 실험이니 나란히 두고 크기를 견주지 말자. 또 이 절제의 포컬 손실은 계수가 1 이다(공식 구현에서 IA-BCE 만 끈 것). 계수를 2 로 하면 결과가 달라질 수 있는데 해 보지 않았다.
질의 묶음과 윈도 수
(b) Group DETR. 묶음 4개와 1개의 차이는 −0.0024, −0.0045, −0.0005 이다. 세 시드 모두 묶음 4개 쪽이 높기는 하지만 눈금보다 작다. AP 0.8 에 닿는 에폭도 3 으로 같다. 이 실험에서는 Group DETR 의 효과가 보이지 않았다. 그럴 만한 까닭을 생각해 볼 수는 있다(따로 확인하지는 않았다).
- 질의가 12개이고 객체가 1 – 4개이니, 묶음 하나에서도 질의의 1/5 쯤이 짝을 얻는다. 공식 설정은 질의가 300개여서 짝을 얻는 질의의 비율이 훨씬 낮다. 묶음을 늘려 짝을 늘리는 일이 더 절실한 상황이다.
- 인코더 제안과 디코더 세 층의 손실이 이미 네 자리에서 학습 신호를 준다.
- 공식의 13 묶음에 견주면 4 묶음은 변화 자체가 작다.
LW-DETR 논문의 표 2 는 COCO 에서 Group DETR(“more supervision”)을 더하면 35.4 → 38.4 mAP 로 3.0 오른다고 보고한다. 논문의 표에서 큰 효과였던 것이 이 작은 실험에서는 나타나지 않았다. 이 실험이 논문을 반박하는 것은 아니다. 질의 300개 · 객체 수십 개의 COCO 와 질의 12개 · 객체 네 개의 도형 세상은 다른 상황이다. 다만 어떤 기법의 효과는 데이터와 규모에 따라 달라진다 는 것은 기억해 둘 만하다. 묶음 1개 쪽의 학습은 시드 1 · 2 에서 약 10% 빨랐다.
(d) 윈도 어텐션. 윈도 2 × 2(base)와 모든 블록을 전역 어텐션으로 바꾼 것의 차이는 −0.0014, +0.0041, −0.0009 로 부호가 섞여 있다. 윈도 어텐션은 정확도를 깎지 않았다. 윈도 어텐션의 목적은 정확도를 올리는 것이 아니라 계산을 줄이는 것이므로(9장), “차이가 없다” 가 바라던 결과이다. 참고로 LW-DETR 논문의 표 2 에서는 윈도 어텐션을 넣으면 연산량이 23.0 → 16.6 GFLOPs 로 줄면서 mAP 가 36.0 → 34.7 로 조금 내려간다. 이 실험에서는 그 하락도 보이지 않았다.
[절제 (d) 보충] 윈도 수를 추론 때만 바꿔 채점 (EMA 모델)
    base: IA-BCE, 4 groups, 2x2 windows   → num_windows=1: AP 0.9169 | num_windows=2: AP 0.9180 | num_windows=3: AP 0.9174
    1x1 window (all global)               → num_windows=1: AP 0.9166 | num_windows=2: AP 0.9118 | num_windows=3: AP 0.8937
덤으로 본 것이 하나 있다. 학습을 마친 모델의 윈도 수를 추론 때만 바꿔 채점한 위의 결과이다. 윈도 2 × 2 로 학습한 모델은 추론 때 윈도를 1 × 1 이나 3 × 3 으로 바꿔도 AP 가 그대로이다(0.9169, 0.9180, 0.9174. 다른 두 시드도 ±0.002 안). 반대로 전역 어텐션으로만 학습한 모델은 윈도를 넣으면 내려간다(시드 0 에서 2 × 2 는 −0.005, 3 × 3 은 −0.023. 세 시드에서 3 × 3 은 −0.012 – −0.023). 윈도를 섞어 학습한 백본이 윈도 수가 달라지는 데에 더 잘 견딘다는 것으로, 윈도 수를 손잡이로 쓰는 12장에서 다시 만난다.
백본 사전 학습 실험: 마스크 이미지 모델링
마지막 절제 (e)는 이 장의 큰 주제 둘, 사전 학습 과 층별 학습률 감쇠 를 함께 점검한다. 논문의 주장은 “사전 학습한 백본이 작은 데이터셋에서 유리하다” 이고, 층별 감쇠는 그 백본을 지키는 장치였다. 도형 세상에서 같은 것을 시험하려면 먼저 사전 학습한 백본이 있어야 한다.
DINOv2 를 통째로 흉내 내는 대신 구현이 몇 줄인 방법을 골랐다. 마스크 이미지 모델링(masked image modeling, MIM)이다. 그림의 패치 일부를 가리고, 보이는 패치만으로 가려진 패치의 픽셀을 맞히게 한다. 라벨이 필요 없는 자기 지도 학습이다(6장). 가려진 곳을 채우려면 도형의 경계와 색이 어디까지 이어지는지 알아야 하므로, 그 과정에서 쓸모 있는 특징이 생기리라 기대하는 것이다. LW-DETR 의 백본 사전 학습(CAEv2)이 이 계열이다. DINOv2 는 6장에서 본 대로 자기 증류라는 다른 방식이다.
ch11_train.py · pretrain — 원문에서 접어 둔 긴 코드라 옮기지 않는다. code/ch11_train.py 의 pretrain 영역에 있다.
-
patchify: 그림(B, 3, H, W)을 패치마다 픽셀을 한 줄로 편(B, h·w, 3·p·p)로 바꾼다. 패치 8 이면 패치 하나가 \(3 \times 8 \times 8 = 192\) 개의 수이다. -
mask: 패치마다 확률 0.5 로 “가린다” 를 정한(B, h·w)의 참 · 거짓 배열. 가린 자리의 패치 임베딩은 백본 안에서 학습되는 마스크 토큰으로 바뀐다. - 백본의 마지막 특징 맵
(B, C, h, w)의 칸마다 선형 층 하나가 그 패치의 픽셀 192개를 예측하고, 손실은 가린 패치에서만 잰 L1 이다.
설계는 다음과 같다.
- 사전 학습 데이터: 도형 세상의 그림 8,000장(시드 100). 학습 · 검증 그림과 겹치지 않고, 라벨은 읽지 않는다. 30 에폭(1,860 스텝), 배치 128.
- 작은 데이터 실험: 탐지 학습 그림을 200장으로 줄이고 100 에폭(600 스텝). 백본 {무작위, 사전 학습} × 학습률 {공식 규칙, 일정} 의 네 설정을 시드 셋으로.
- 큰 데이터 실험: 학습 4,000장 · 15 에폭 · 공식 학습률 규칙에서 무작위 대 사전 학습(시드 1개).
- “일정” 은 그림 11-4 의 주황 막대, 곧 모든 매개변수의 학습률이 \(2 \times 10^{-4}\) 인 설정이다.
[절제 (e)] 백본 사전 학습: 라벨 없는 그림 8000장 (seed 100), 마스크 그림 모델링 30 에폭, 배치 128, AdamW lr 5e-4, 가린 비율 0.5
  사전 학습 에폭   1 | 가린 패치의 L1 손실 0.6457
  사전 학습 에폭   2 | 가린 패치의 L1 손실 0.4096
  사전 학습 에폭   3 | 가린 패치의 L1 손실 0.4005
  사전 학습 에폭   5 | 가린 패치의 L1 손실 0.3961
  사전 학습 에폭  10 | 가린 패치의 L1 손실 0.3871
  사전 학습 에폭  15 | 가린 패치의 L1 손실 0.3809
  사전 학습 에폭  20 | 가린 패치의 L1 손실 0.3765
  사전 학습 에폭  25 | 가린 패치의 L1 손실 0.3739
  사전 학습 에폭  30 | 가린 패치의 L1 손실 0.3669
  사전 학습 205초 (1860 스텝), 손실 0.6457 → 0.3669
- 그림: 그림 11-14 사전 학습한 백본의 복원 예(사전 학습에 쓰지 않은 검증 그림 여섯 장). 위: 원본. 가운데: 패치의 50% 를 가린 입력(회색이 가린 곳). 아래: 가린 패치를 모델의 예측으로 채운 것.
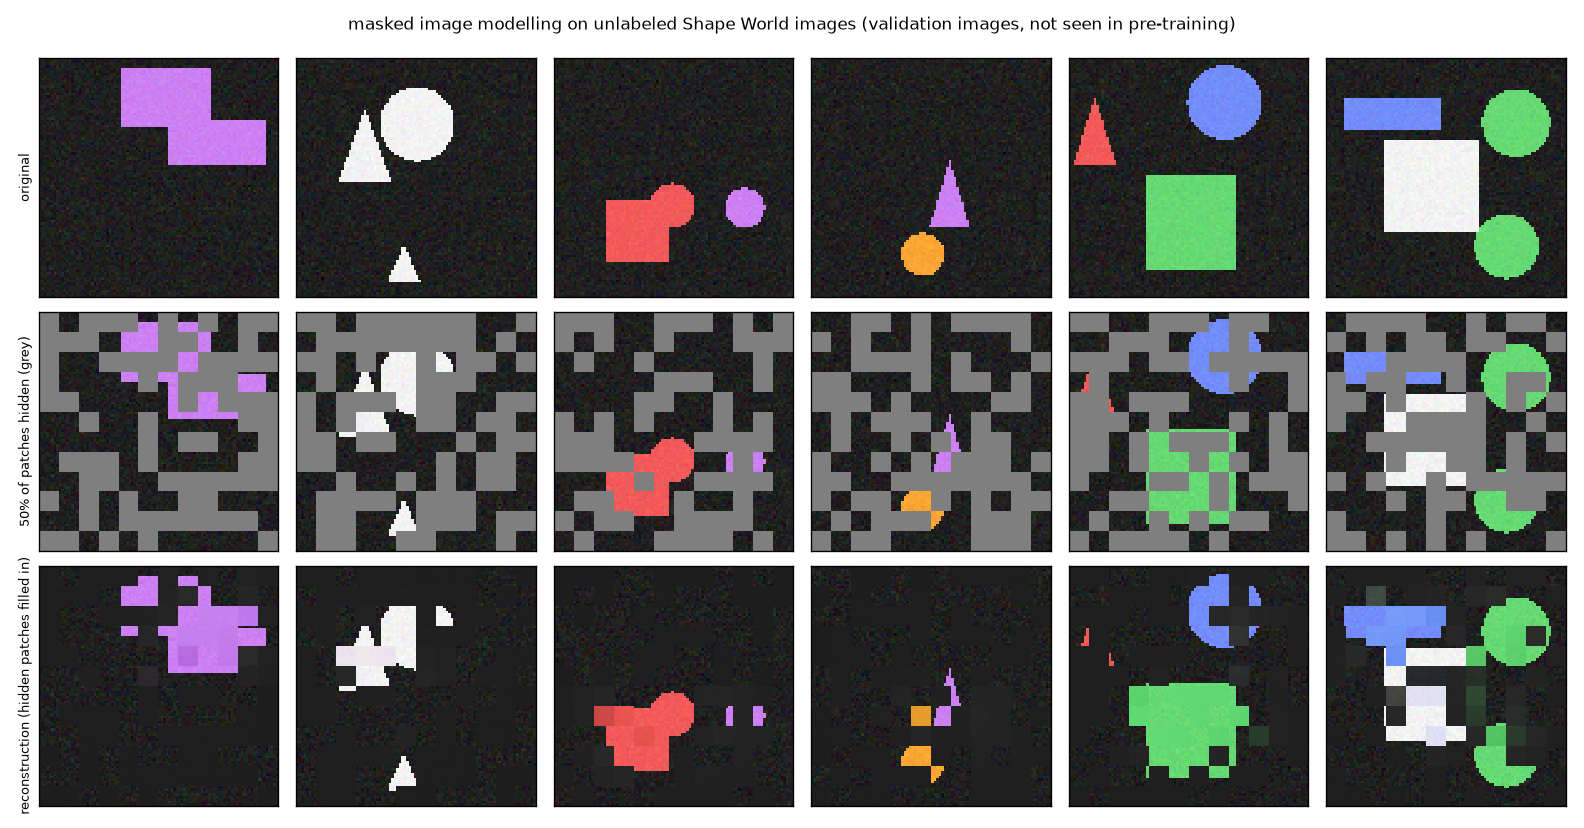
그림 11-14 는 이 사전 학습이 얼마나 약한지 를 보여 준다. 이웃 패치가 보이는 도형의 안쪽은 색을 채우지만, 채운 모양이 패치 단위로 뭉툭하다. 가려진 부분이 넓으면 그냥 배경으로 채운 곳도 많다. 둘째 그림의 원은 왼쪽이 잘려 나갔고, 넷째 그림의 주황 원은 네모 조각 몇 개로 남았다. 손실도 2 에폭 만에 0.41 로 내려온 뒤 30 에폭에 0.37 까지 느리게 내려가는 중이었다. 이 점은 뒤에서 결과를 해석할 때 다시 나온다.
사전 학습 실험의 결과
  [작은 데이터 200장] 마지막 에폭의 EMA 모델 검증 AP (시드 3개)
    설정                            | 시드별 AP                | 평균   | 최소 – 최대     | AP50 평균 | AP75 평균
    random init, official lr rule   | 0.6676 0.6877 0.6703     | 0.6752 | 0.6676 – 0.6877 | 0.8680    | 0.7792
    random init, flat lr            | 0.7124 0.7315 0.7071     | 0.7170 | 0.7071 – 0.7315 | 0.8920    | 0.8132
    pre-trained, official lr rule   | 0.6938 0.6965 0.6681     | 0.6861 | 0.6681 – 0.6965 | 0.8783    | 0.7853
    pre-trained, flat lr            | 0.7038 0.7125 0.6840     | 0.7001 | 0.6840 – 0.7125 | 0.8787    | 0.7953
    사전 학습의 이득 (평균 AP): 공식 학습률 규칙 +0.0109, 일정한 학습률 -0.0169
    공식 학습률 규칙의 이득 (평균 AP): 사전 학습 백본 -0.0140, 무작위 초기화 -0.0418
  [큰 데이터 4000장, 15 에폭, 시드 1개, 공식 학습률 규칙] EMA 모델의 검증 AP
      에폭               1      2      3      5      7     10     15
      무작위 초기화 0.3113 0.7221 0.8201 0.8688 0.8869 0.9059 0.9182
      사전 학습     0.3018 0.6940 0.8011 0.8520 0.8801 0.9047 0.9177
  사전 학습의 이득 (공식 학습률 규칙, 마지막 에폭 AP): 200장 +0.0109 (0.6752 → 0.6861), 4000장 -0.0005 (0.9182 → 0.9177)
- 그림: 그림 11-15 왼쪽: 사전 학습 손실(가린 패치의 L1). 가운데: 학습 200장에서의 검증 AP(EMA 모델). 선은 시드 셋의 평균, 띠는 최소 – 최대. 파랑 실선: 무작위 + 공식 규칙. 주황 점선: 무작위 + 일정. 초록 쇄선: 사전 학습 + 공식 규칙. 분홍 점선: 사전 학습 + 일정. 오른쪽: 공식 학습률 규칙에서 마지막 AP. 파랑이 무작위, 초록이 사전 학습.
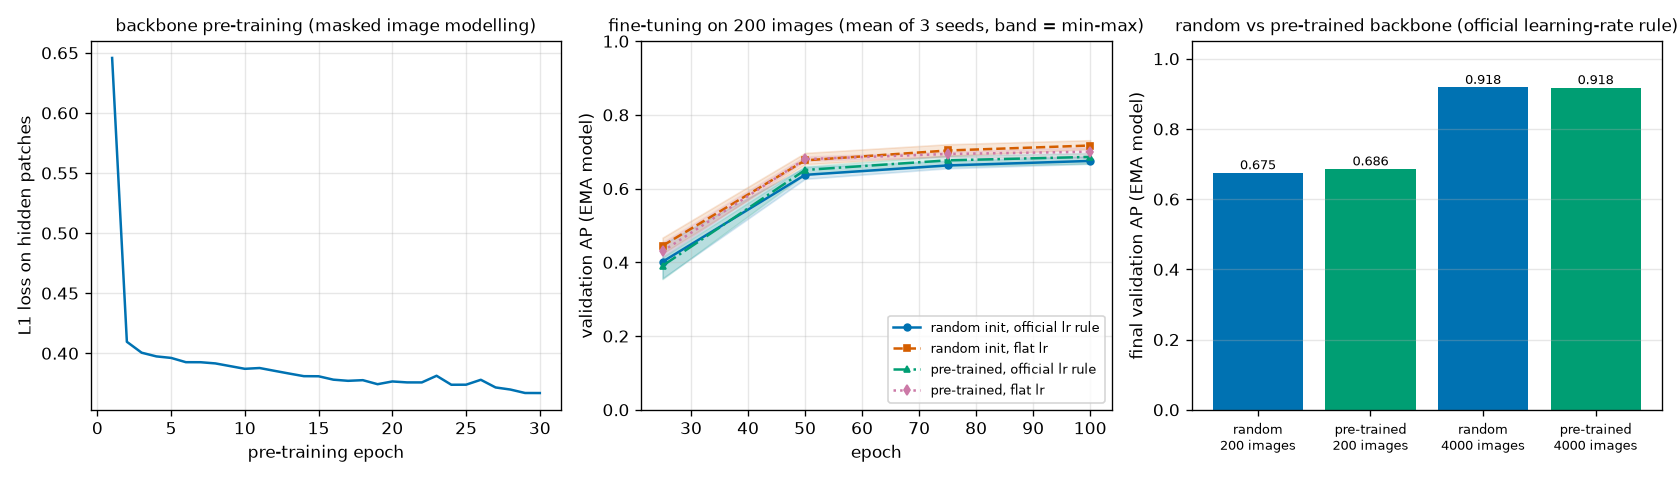
| 학습 200장, 마지막 AP(시드 셋의 평균과 범위) | 공식 학습률 규칙 | 일정한 학습률 | 공식 규칙의 손익 |
| 무작위 초기화 백본 | 0.6752 (0.6676 – 0.6877) | 0.7170 (0.7071 – 0.7315) | −0.0418 |
| 사전 학습 백본 | 0.6861 (0.6681 – 0.6965) | 0.7001 (0.6840 – 0.7125) | −0.0140 |
| 사전 학습의 손익 | +0.0109 | −0.0169 |
결과를 있는 그대로 적는다. 이 미니 실험에서는 백본 사전 학습의 이득이 재현되지 않았다.
- 학습 200장, 공식 학습률 규칙: 무작위 0.6752, 사전 학습 0.6861. 사전 학습 쪽이 0.011 높지만 두 설정의 시드 범위가 겹친다(0.6676 – 0.6877 과 0.6681 – 0.6965). 그림 11-15 가운데의 파란 띠와 초록 띠가 겹쳐 있다.
- 학습 200장, 일정한 학습률: 무작위 0.7170, 사전 학습 0.7001. 이번에는 사전 학습 쪽이 0.017 낮다.
- 네 설정 가운데 가장 좋은 것은 “무작위 초기화 + 일정한 학습률” 이다(그림 가운데의 주황 점선이 가장 위).
- 학습 4,000장: 0.9182 대 0.9177 로 차이가 없다. 초반에는 사전 학습 쪽이 오히려 느리다(2 에폭 0.7221 대 0.6940, 5 에폭 0.8688 대 0.8520).
기대와 맞은 것이 하나 있다. 표의 맨 오른쪽 열이다. 공식 학습률 규칙(낮은 백본 학습률과 층별 감쇠)의 손해가 사전 학습 백본에서 더 작다. 일정한 학습률에 견준 손해가 무작위 백본에서는 0.042, 사전 학습 백본에서는 0.014 이다. “백본을 조금만 고쳐라” 는 규칙은 고칠 것이 많은 무작위 백본에는 맞지 않고, 이미 무언가를 배운 백본에는 덜 해롭다. 층별 감쇠가 무엇을 전제로 한 장치인지와 맞는 방향이다. 그렇더라도 이 예산(600 스텝)에서는 두 백본 모두 일정한 학습률이 나았다. 그리고 이것은 이 장의 본 실험에 대한 단서이기도 하다. 본 실험은 무작위 백본에 공식 규칙을 썼으므로, 일정한 학습률이었다면 더 나았을 수 있다(4,000장 · 60 에폭에서는 재어 보지 않았다).
왜 이득이 보이지 않았을까
아래는 가설 이다. 하나하나를 따로 실험해 확인하지 않았다. 결과를 본 뒤에 설정을 바꿔 다시 돌리지도 않았다. 원하는 결론이 나올 때까지 설정을 고치는 일을 피하려는 것이다.
- 사전 학습이 약하다. 1,860 스텝의 마스크 이미지 모델링이고, 복원은 그림 11-14 에서 본 대로 뭉툭한 색 채우기 수준이다. DINOv2 는 1억 4,200만 장으로 학습한 모델이다. 그림 수만 해도 만 배 넘게 차이 난다.
- 사전 학습 데이터가 과제와 같은 분포이다. 같은 생성기가 만든 도형 그림 8,000장이다. 진짜 사전 학습의 이점은 “목표 데이터보다 훨씬 넓은 세상을 미리 보았다” 는 데 있는데, 여기에는 그것이 없다. 그리고 이 과제에 필요한 특징(색 덩어리와 경계)은 라벨 200장, 객체 약 500개만으로도 금방 배운다. 무작위 백본이 600 스텝에 AP 0.72 까지 간다.
- 과제가 쉽고 백본이 작다. 200장이 이 과제에는 “아주 적은 데이터” 가 아닐 수 있다. 20 – 50장으로는 해 보지 않았다.
- 목표가 다르다. 픽셀을 복원하도록 학습한 백본의 마지막 층들은 복원에 맞춰져 있다. 탐지에 쓰려면 충분히 다시 배워야 하는데, 600 스텝과 낮은 백본 학습률로는 모자랐을 수 있다. 4,000장 실험에서 사전 학습 쪽이 초반에 느렸던 것, 일정한 학습률에서 사전 학습이 오히려 손해였던 것과 어긋나지 않는 설명이다.
- 수렴한 값의 비교가 아니다. 200장 실험은 100 에폭에도 AP 가 아직 오르는 중이었다(75 → 100 에폭 사이에 열두 번 가운데 열한 번 올랐다).
이 실험이 말해 주는 것은 좁다. “약한, 같은 분포의 사전 학습은 이 쉬운 과제에서 도움이 되지 않았다.” 여기까지이다. 더 긴 사전 학습, DINO 방식의 목표, 더 적은 라벨, 백본을 얼려 둔 비교는 하지 않았다. 그러니 이것으로 논문의 주장을 반박할 수 없고, 확인했다고 할 수도 없다.
진짜 가중치와 논문의 근거
그러면 “사전 학습이 중요하다” 는 말은 무엇에 기대고 있을까? 근거는 세 종류이고, 서로 다른 것이므로 구별해 적는다.
| 근거 | 무엇을 견주었나 | 결과 |
| 이 장의 미니 실험(도형 세상, 직접 돌림) | 약한 MIM 사전 학습 백본 대 무작위 백본 | 이득이 보이지 않음(200장 +0.011 / −0.017, 4,000장 −0.0005) |
| 14장의 실험(도형 세상, 직접 돌림, 진짜 RF-DETR Nano 가중치) | 공식 사전 학습 가중치에서 시작 대 전부 무작위 초기화. 학습 1,000장, 같은 설정 | 같은 3 에폭째 검증 AP 0.9816 대 0.7749. 사전 학습 쪽은 1 에폭에 이미 0.9476 |
| 논문(COCO) | RF-DETR 표 5 · 6: 백본을 DINOv2 로. LW-DETR 표 5: Objects365 사전 학습 유무 | +2.0 AP(51.6 → 53.6, 52.3 → 54.3). +4.4 – +6.6 mAP(크기별) |
둘째 줄이 중요하다. 같은 도형 세상에서, 같은 패키지 · 같은 설정으로, 출발점만 바꾼 비교이다. 14장에서 학습을 마친 두 모델을 시험 세트로 채점하면 AP 0.9830(사전 학습에서 시작, 5 에폭)과 0.7738(무작위 초기화, 3 에폭)이다. 에폭 수가 다르므로 같은 에폭끼리 견준 값은 표의 0.9816 대 0.7749 이다. 어느 쪽으로 보아도 차이가 0.2 를 넘는다. 이 장의 미니 실험에서 다투던 0.01 과는 자릿수가 다르다.
두 실험의 차이는 사전 학습의 질과 폭 이다. 14장의 가중치는 1억 장이 넘는 사진으로 자기 지도 학습을 하고 Objects365 로 탐지까지 미리 배운 것이다. 도형을 본 적은 없어도 “물체에 박스를 두르는 법” 을 이미 안다. 이 장의 사전 학습은 도형 8,000장으로 픽셀 채우기를 몇 분 연습한 것이다. 같은 “사전 학습” 이라는 낱말로 부르기에는 너무 다르다.
- 핵심 · 절제 실험에서 가져갈 것
- 재는 자의 눈금(같은 설정의 재실행 · 시드 간 차이)을 먼저 재고, 그보다 작은 차이는 읽지 않는다.
- 이 장의 실험에서 뚜렷했던 것: EMA 의 이득(끄면 AP −0.0135), IA-BCE 가 점수를 IoU 에 맞추는 효과(스피어만 +0.65 대 +0.26).
- 보이지 않았던 것: Group DETR, 윈도 수(정확도 손해 없음), 약한 사전 학습의 이득.
- “보이지 않았다” 는 “효과가 없다” 가 아니다. 이 데이터 · 이 규모에서 눈금보다 작았다는 뜻이다. 논문이 COCO 에서 보고한 효과와, 진짜 가중치로 잰 14장의 결과를 함께 놓고 읽어야 한다.
실전 학습과의 대응
14장에서 rfdetr 패키지로 실제 모델을 미세 조정할 때 만나는 TrainConfig 의 기본값들이 이 장의 개념과 어떻게 이어지는지 한 표로 모은다. 손실의 계수 · 묶음 수 · IA-BCE 사용 여부는 학습 설정이 아니라 모델 설정 쪽에 있다.
| 설정 이름 | 기본값 | 이 장의 개념 |
| | 1e-4 | 기본 학습률 \(\eta\). 프로젝터 · 머리 · 질의 임베딩이 이 값으로 배움 |
| | 1.5e-4 | 백본의 기준 학습률 \(\eta_{\text{enc}}\) |
| | 0.8 | 층별 학습률 감쇠율 \(\lambda\) |
| | 0.7 | 구성 요소별 감쇠율 \(\rho\)(디코더 한 번, 백본 두 번) |
| | 1e-4 | AdamW 의 가중치 감쇠(4장) |
| | 4, 1 | 배치 크기와 기울기 누적. 둘의 곱이 실효 배치 크기. 패키지 문서는 실효 배치 16 을 권한다 |
| | 100 | 학습률이 일정하므로 이 값을 바꿔도 학습률 곡선이 달라지지 않음 |
| | 0 | 워밍업 없음 |
| | 0.1 | 기울기 자르기의 한계 \(c_{\max}\) |
| | True, 0.993, 100 | EMA 와 감쇠 \(d\), 워밍업의 \(\tau\) |
| | per-batch, True | 배치 단위 다중 해상도 학습과 넓힌 해상도 범위 |
| | 0.0 | 드롭 패스(아래). 기본은 쓰지 않음 |
| | 1, 5, 2 | 손실의 계수 |
| | 13, True | 질의 묶음 수 \(G\), 분류 손실로 IA-BCE |
표에 이 장에서 다루지 않은 이름이 하나 있다. 드롭 패스(drop path, stochastic depth)는 학습 중에 잔차 블록의 가지를 무작위로 통째로 건너뛰는 규제 기법이다. 잔차 블록이 \(y = x + F(x)\) 일 때(4장), 확률 \(q\) 로 \(F(x)\) 를 0 으로 만들고 나머지 경우에는 \(F(x)/(1 - q)\) 로 키워 기댓값을 맞춘다. 학습할 때마다 깊이가 다른 망을 학습하는 효과를 낸다. RF-DETR 의 기본값은 0, 곧 쓰지 않는다. 이 튜토리얼의 실험에서도 쓰지 않는다.
기본값들을 한 줄로 읽으면 이 장의 차례 그대로이다: AdamW, 학습률 1e-4 로 끝까지 일정하게, 워밍업 없이, 기울기는 0.1 로 자르고, 백본은 층마다 0.8배씩 느리게, 평가는 감쇠 0.993 의 EMA 가중치로. 14장에서 이 설정으로 실제 모델을 학습하고, 로그에 나오는 손실 이름 아홉 개와 가장 작은 학습률 \(3.23 \times 10^{-6}\) 을 이 장의 식으로 다시 읽는다.
정리
- 전체 손실: 인코더 제안과 디코더 각 층, 그 자리마다 질의 묶음별로 헝가리안 매칭을 하고(비용 2 · 포컬 꼴 + 5 · L1 + 2 · (−GIoU)), IA-BCE · L1 · \((1 - \operatorname{GIoU})\) 를 정답 수 × 묶음 수로 나누어 계수 1 · 5 · 2 로 더한다. 손실 값의 수는 (디코더 층 수 + 1) × 3 이고 묶음 수와 무관하다.
- 인코더 제안의 손실은 질의 선택을 가르치는 유일한 신호이고, 층마다의 손실은 디코더 층을 추론 때 떼어 낼 수 있게 한다.
- 스케줄러 없는 학습: 코사인 스케줄의 학습률은 \(n / n_{\text{end}}\) 로만 정해지므로 학습 길이를 미리 알아야 한다. RF-DETR 은 학습률을 끝까지 일정하게 두고 워밍업도 쓰지 않는다.
- 기울기 누적: 작은 배치 여러 번의 기울기를 더해 큰 배치의 기울기를 만든다. 배치 정규화가 없어야 등식이 성립한다.
- 기울기 자르기: \(\mathbf{g} \leftarrow \mathbf{g} \cdot \min(1,\ c_{\max} / \lVert \mathbf{g} \rVert)\), \(c_{\max} = 0.1\). 이 모델에서는 매 스텝 걸리고, Adam 에 들어가는 기울기의 크기를 스텝마다 같게 만든다.
- EMA: \(\theta_{\text{ema}} \leftarrow d\,\theta_{\text{ema}} + (1 - d)\,\theta\). 최근 약 \(1/(1 - d)\) 스텝의 평균이고, \(d = 0.993\) 이면 약 143 스텝이다. 감쇠는 \(d\,(1 - e^{-n/\tau})\) 로 0 근처에서 올라간다. 학습에는 끼어들지 않고 평가 · 저장에 쓴다.
- 층별 학습률 감쇠: 백본 매개변수의 학습률은 \(\eta_{\text{enc}} \cdot \lambda^{L + 1 - i} \cdot \rho^2\). Nano 에서 맨 아래 블록은 맨 위 블록의 1/11.6, 임베딩은 머리의 1/31 로 배운다. 사전 학습 백본을 지키려는 장치이다.
- 증강은 수평 뒤집기와 무작위 자르기만, 다중 해상도는 배치 단위로. 사전 학습은 DINOv2 → Objects365 → 목표 데이터의 세 단계이다.
- 미니 실험: 60 에폭에 AP 0.9347(EMA). EMA 는 스무 번 가운데 열아홉 번 일반 모델보다 높았고, 인코더 제안만으로 AP 0.8928, IA-BCE 모델의 점수와 IoU 의 스피어만 상관은 +0.76 이었다. Group DETR · 윈도 수 · 약한 사전 학습의 효과는 이 실험의 눈금으로는 보이지 않았다.
이 장에서 미니 RF-DETR 은 구조 하나, 해상도 하나, 디코더 3층으로 학습되었다. 그런데 층 수별 AP 를 재면서 본 대로 이 모델은 이미 “디코더 0층짜리”, “1층짜리”, “2층짜리” 탐지기를 함께 품고 있다. 윈도 수를 추론 때만 바꿔도 AP 가 유지되는 것도 보았다. 한 번 학습한 가중치에서 여러 모델을 꺼낼 수 있다면, 디코더 층 수뿐 아니라 해상도 · 패치 크기 · 윈도 수 · 질의 수까지 그렇게 할 수 있지 않을까? 그렇게 꺼낸 수천 가지 모델 가운데 주어진 지연 시간에서 가장 정확한 것을 고르는 일이 RF-DETR 논문의 제목에 들어 있는 신경망 구조 탐색이다. 12장에서 이 장의 학습 고리에 “스텝마다 구조를 무작위로 바꾸기” 를 더해 직접 해 본다.
확인 문제
- 문제 1 · 손실 항 세기
- RF-DETR Medium 은 디코더가 4층이고 질의 300개 · 묶음 13개로 학습한다. (1) 학습 로그에 나오는 손실 값은 몇 개인가? (2) 학습 때 질의는 모두 몇 개인가? (3) 그림 8장짜리 배치를 한 스텝 학습할 때 헝가리안 풀이는 몇 번 도는가? (4) 그 배치의 정답 객체가 모두 40개라면
num_boxes는 얼마인가? - 답. (1) 자리가 \(4 + 1 = 5\) 개(디코더 4층 + 인코더 제안)이고 자리마다 세 값이므로 \(5 \times 3 = 15\) 개이다. 묶음 수는 이 수를 바꾸지 않는다.
- (2) \(13 \times 300 = 3{,}900\) 개.
- (3) 자리 5 × 그림 8 × 묶음 13 = 520번.
- (4) 정답 수 × 묶음 수 \(= 40 \times 13 = 520\).
- 문제 2 · 손실 손계산
- 그림 한 장에 정답이 하나(원)이고, 묶음 하나에 질의가 둘이다. 질의 0 이 정답과 짝이 되었고, 원에 준 확률이 \(0.5\), 박스의 IoU 가 \(0.9\), GIoU 도 \(0.9\), L1 거리가 \(0.04\) 이다. 나머지 다섯 칸 가운데 질의 1 의 원 칸만 확률이 \(0.2\) 이고 다른 칸은 0 으로 봐도 될 만큼 작다. (1) 목표 \(t\) 를 구하라(\(0.5^{0.25} = 0.8409\), \(0.9^{0.75} = 0.9240\)). (2) 이 자리의 세 손실과 가중합을 구하라. (3) 짝이 된 칸의 로짓은 어느 방향으로 움직이는가?
- 답. (1) \(t = 0.8409 \times 0.9240 = 0.7770\).
- (2) 짝이 된 칸: \(-t \log 0.5 - (1 - t)\log 0.5 = \log 2 = 0.6931\). \(\hat{p} = 0.5\) 이면 두 로그가 같아 \(t\) 와 무관하게 \(\log 2\) 이다. 질의 1 의 원 칸: \(0.2^2 \times (-\log 0.8) = 0.04 \times 0.2231 = 0.0089\).
num_boxes\(= 1 \times 1 = 1\) 이므로 \(\mathcal{L}_{\text{cls}} = 0.6931 + 0.0089 = 0.7020\). \(\mathcal{L}_{\text{L1}} = 0.04\), \(\mathcal{L}_{\operatorname{GIoU}} = 1 - 0.9 = 0.1\). 가중합은 \(0.7020 + 5 \times 0.04 + 2 \times 0.1 = 0.7020 + 0.2 + 0.2 = 1.1020\). - (3) 로짓에 대한 기울기가 \(\hat{p} - t = 0.5 - 0.777 = -0.277\) 로 음수이므로 로짓을 올리는 방향, 곧 점수를 0.5 에서 IoU 쪽으로 올리는 방향이다.
- 문제 3 · 기울기 자르기
- 한계 \(c_{\max} = 0.1\) 로 노름 자르기를 한다. (1) \(\mathbf{g} = (0.6,\ 0.8,\ 0)\) 은 어떻게 되는가? (2) \(\mathbf{g} = (0.02,\ 0.01,\ 0.02)\) 는? (3) 옵티마이저가 학습률 \(10^{-4}\) 의 SGD 라면 한 스텝에 가중치 벡터가 움직일 수 있는 거리는 최대 얼마인가? (4) “성분마다 따로 \([-0.1, 0.1]\) 로 자르는” 방법과 견주어 노름 자르기의 좋은 점은 무엇인가?
- 답. (1) \(\lVert \mathbf{g} \rVert = \sqrt{0.36 + 0.64} = 1\). \(s = \min(1,\ 0.1/1) = 0.1\) 이므로 \((0.06,\ 0.08,\ 0)\). 길이는 0.1 이다.
- (2) \(\lVert \mathbf{g} \rVert = \sqrt{0.0004 + 0.0001 + 0.0004} = 0.03 \le 0.1\) 이므로 그대로이다.
- (3) \(\eta \cdot c_{\max} = 10^{-4} \times 0.1 = 10^{-5}\).
- (4) 방향이 바뀌지 않는다. 성분별로 자르면 큰 성분만 줄어 기울기의 방향이 달라진다. (1)의 벡터를 성분별로 자르면 \((0.1,\ 0.1,\ 0)\) 이 되어 3 : 4 였던 비가 1 : 1 이 된다.
- 문제 4 · EMA 의 길이
- 감쇠 \(d = 0.99\) 인 EMA 가 있다(워밍업 없음). (1) 최근 약 몇 스텝의 평균인가? (2) \(\theta_{\text{ema}} = 0.50\), \(\theta = 0.60\) 일 때 한 번 갱신한 값은? (3) 100 스텝 뒤에 EMA 의 처음 값이 차지하는 무게는 얼마인가(\(0.99^{100} = 0.366\))? (4) 어떤 스텝의 가중치가 받는 무게가 절반으로 줄기까지 몇 스텝인가(\(\ln 0.5 = -0.6931\), \(\ln 0.99 = -0.01005\))?
- 답. (1) \(1/(1 - 0.99) = 100\) 스텝.
- (2) \(0.99 \times 0.50 + 0.01 \times 0.60 = 0.495 + 0.006 = 0.501\).
- (3) \(d^{100} = 0.366\), 곧 37% 이다. \(1/(1 - d)\) 스텝이 지나도 처음 값이 3분의 1 넘게 남는다. 감쇠 워밍업이 필요한 까닭이다.
- (4) \(n = \ln 0.5 / \ln 0.99 = 0.6931 / 0.01005 = 69.0\) 스텝.
- 문제 5 · 감쇠 워밍업
- 공식 구현의 식 \(d_n = 0.993\,(1 - e^{-n/100})\) 에서 (1) \(n = 50\) 일 때의 감쇠와 평균 길이 \(1/(1 - d_n)\) 를 구하라(\(e^{-0.5} = 0.6065\)). (2) 워밍업 없이 처음부터 \(d = 0.993\) 을 썼다면, 에폭당 125 스텝인 학습에서 1 에폭 뒤 EMA 모델에 남은 학습 전 가중치의 무게는 얼마인가(\(0.993^{125} = 0.416\))? 그 EMA 모델을 채점하면 어떨지 예상해 보라.
- 답. (1) \(d_{50} = 0.993 \times (1 - 0.6065) = 0.993 \times 0.3935 = 0.3907\). 평균 길이는 \(1/(1 - 0.3907) = 1.64\) 스텝. 실습 출력의 “스텝 50: 0.3907” 과 같다.
- (2) 0.416, 곧 42% 이다. EMA 가중치의 42% 가 무작위 초기값이고 나머지도 학습 초반의 가중치들이라, 1 에폭째의 일반 모델보다 훨씬 나쁜 AP 가 나올 것이다. 워밍업이 있으면 첫 갱신의 감쇠가 0.0099 여서 초기값의 무게가 곧바로 1% 아래로 떨어진다. 이 장의 실험에서 1 에폭째 EMA 모델(0.3085)이 일반 모델(0.3011)에 뒤지지 않았다.
- 문제 6 · 층별 학습률 감쇠
- RF-DETR Nano(블록 12개, \(L = 13\), \(\eta = 10^{-4}\), \(\eta_{\text{enc}} = 1.5 \times 10^{-4}\), \(\lambda = 0.8\), \(\rho = 0.7\))에서 (1) 블록 8 의 학습률을 구하라(\(0.8^5 = 0.32768\)). (2) 디코더의 학습률은 얼마이고, 블록 0 의 학습률(\(4.04 \times 10^{-6}\))은 그 몇 배인가? (3) 만약 \(L\) 을 블록 수인 12 로 넣었다면 블록 11 의 학습률은 얼마가 되는가? 공개 코드의 값과 견주어 보라.
- 답. (1) 지수는 \(L - j = 13 - 8 = 5\). \(1.5 \times 10^{-4} \times 0.49 \times 0.32768 = 7.35 \times 10^{-5} \times 0.32768 = 2.41 \times 10^{-5}\).
- (2) 디코더는 \(\eta \cdot \rho = 7.0 \times 10^{-5}\). 블록 0 은 그 \(4.04 \times 10^{-6} / 7.0 \times 10^{-5} = 0.058\) 배, 약 1/17 이다.
- (3) 지수가 \(12 - 11 = 1\) 이 되어 \(7.35 \times 10^{-5} \times 0.8 = 5.88 \times 10^{-5}\) 이다. 공개 코드의 실제 값은 \(7.35 \times 10^{-5} \times 0.64 = 4.70 \times 10^{-5}\) 이다. \(L\) 을 하나 크게 세는 것만으로 백본의 모든 블록이 0.8배씩 더 느리게 배운다. 논문의 문장만으로는 알 수 없고 코드를 읽어야 알 수 있는 차이이다.
- 문제 7 · 코사인 스케줄
- \(\eta_0 = 2 \times 10^{-4}\), \(\eta_{\min} = 0\) 인 코사인 스케줄을 \(n_{\text{end}} = 40\) 에폭으로 짰다. (1) 10 에폭째와 30 에폭째의 학습률을 구하라(\(\cos(\pi/4) = 0.7071\)). (2) 20 에폭에서 검증 AP 가 더 오르지 않아 학습을 멈췄다. 그때의 학습률은 얼마였는가? (3) 같은 상황에서 RF-DETR 의 방식이었다면 무엇이 달랐을까?
- 답. (1) 10 에폭: \(\tfrac{1}{2}(1 + \cos(\pi/4)) = 0.8536\) 이므로 \(1.71 \times 10^{-4}\). 30 에폭: \(\tfrac{1}{2}(1 + \cos(3\pi/4)) = \tfrac{1}{2}(1 - 0.7071) = 0.1464\) 이므로 \(0.29 \times 10^{-4}\).
- (2) 정확히 절반이므로 \(\tfrac{1}{2}\eta_0 = 1.0 \times 10^{-4}\). 학습률이 아직 시작 값의 절반인 채로 끝났다. “AP 가 멈췄다” 가 학습이 다 된 것인지, 학습률이 높아서인지 가르기 어렵다.
- (3) 학습률이 처음부터 끝까지 같으므로 20 에폭에서 멈추든 40 에폭까지 가든 20 에폭째의 모델이 같다. 멈춘 시점의 가중치는 흔들리고 있겠지만, 평가에는 최근 약 143 스텝을 평균한 EMA 가중치를 쓴다. 학습 길이를 미리 정할 필요가 없다.
- 문제 8 · 절제 실험 읽기
- (1) 이 장의 절제 (c)는 EMA 를 끈 학습을 따로 돌리지 않았다. 왜 그래도 되는지 설명하라. 같은 방법을 6장의 DINO 에 쓸 수 있는가? (2) 어떤 기법을 넣었더니 세 시드에서 AP 가 +0.003, +0.004, +0.002 올랐다. 같은 설정을 시드만 바꿔 돌렸을 때의 폭이 0.005 라면 어떻게 보고해야 하는가? (3) 절제 (a)에서 IA-BCE 와 포컬 손실의 AP 차이는 작았는데 스피어만 상관은 크게 달랐다. 두 결과가 모순이 아닌 이유를 설명하라.
- 답. (1) RF-DETR 의 EMA 모델은 학습에 끼어들지 않는다. 순전파 · 손실 · 역전파는 일반 모델로만 하므로 EMA 를 켜든 끄든 일반 모델의 가중치가 똑같다. 그래서 한 번의 학습에서 일반 모델을 채점한 값이 곧 “EMA 를 끈 학습” 의 결과이다. DINO 에서는 안 된다. EMA 로 만든 교사의 출력이 학생의 학습 목표이므로 EMA 를 바꾸면 학습 자체가 달라진다.
- (2) 세 시드 모두 방향이 같다는 점과, 크기가 재실행의 폭보다 작다는 점을 둘 다 적어야 한다. “효과가 있을 수 있지만 이 실험의 눈금으로는 확인되지 않았다” 가 정직한 보고이다. 평균 +0.003 을 “성능 향상” 이라고만 쓰면 안 된다.
- (3) 스피어만 상관은 “찾은 예측들” 사이에서 점수의 순서가 IoU 의 순서와 맞는지를 본다. AP 는 점수 순으로 세웠을 때 참 양성과 거짓 양성이 어떻게 섞이는지를 본다. 이 데이터에서는 대부분의 예측이 IoU 0.9 를 넘어 어느 문턱값에서도 참 양성이다. 참 양성끼리의 순서가 바뀌어도 AP 는 변하지 않으므로, 순서가 많이 달라도 AP 는 거의 같을 수 있다.
See also
Favorite site
- 11. RF-DETR 의 학습
- code/ch11_train.py
- RF-DETR: Neural Architecture Search for Real-Time Detection Transformers (arXiv:2511.09554)
- LW-DETR: A Transformer Replacement to YOLO for Real-Time Detection (arXiv:2406.03459)
- DINOv2: Learning Robust Visual Features without Supervision (arXiv:2304.07193)
- Github - roboflow/rf-detr