RF-DETR:Tutorial:12-NAS
lastmod 2026-11-18created 2026-11-184 edits
가중치 공유 NAS는 RF-DETR 튜토리얼의 12장이다. RF-DETR 논문의 제목은 “실시간 탐지 Transformer 를 위한 신경망 구조 탐색” 이다. 10장에서 구조를, 11장에서 학습을 봤으니 이제 제목이 말하는 바로 그 기여를 볼 차례이다. 모델을 한 번만 학습하고, 그 가중치를 그대로 둔 채 해상도 · 패치 크기 · 윈도 수 · 디코더 층 수 · 질의 수라는 다섯 손잡이를 돌려 빠른 모델부터 정확한 모델까지 수천 개를 꺼내는 방법이다. 이 장에서는 “더 나은 모델” 을 정의하는 파레토 최적부터 시작해, 손잡이마다 왜 가중치를 그대로 쓸 수 있는지를 식으로 따지고, 도형 세상의 미니 RF-DETR 로 408개 구성의 파레토 곡선을 직접 그린다. 가로축인 지연 시간을 제대로 재는 법도 여기서 다룬다. 다음 13장에서는 같은 틀 위에 분할 머리를 얹는다.
- 원문: 12. 가중치 공유 NAS (읽는 시간 약 110분, 난이도 ★★★★☆)
- 실습 코드:
code/ch12_nas.py.python ch12_nas.py가 미니 RF-DETR 의 가중치 공유 NAS 학습(약 18분),--search가 408개 구성의 격자 탐색과 그림(약 15분),--finetune이 NAS 뒤 미세 조정 점검,--checks가 파레토 · PI-resize 손계산 확인을 한다. 고정 구성 모델로는 11장의ch11_rfdetr.pt를 쓴다. - 이전: 11. RF-DETR 의 학습 / 다음: 13. RF-DETR-Seg: 인스턴스 분할
이 장의 표기
- \(\theta\)(세타): 모델의 가중치 전부. \(c\): 구성 하나(손잡이 다섯 개의 값). \(\mathcal{C}\): 탐색 공간(가능한 구성의 집합). \(|\mathcal{C}|\) 는 그 개수이다.
- \(\mathcal{L}(\theta; c)\): 가중치 \(\theta\) 를 구성 \(c\) 로 돌렸을 때의 손실(11장의 전체 손실). 세미콜론 뒤의 \(c\) 는 “학습되는 값이 아니라 고르는 값” 이라는 표시이다.
- \(H\): 입력 그림의 한 변(픽셀, 해상도). \(p\): 패치의 한 변(픽셀). \(g = H/p\): 토큰 격자의 한 변. \(N = g^2\): 패치 토큰의 수(6장과 같다).
- \(x\): 패치 하나의 픽셀을 한 줄로 편 벡터. \(w\): 패치 임베딩 커널의 한 채널을 한 줄로 편 벡터. \(\langle x, w \rangle = x^\top w\) 는 둘의 내적이다. 이 장에서 \(w\) 는 박스의 너비가 아니다.
- \(R\): 패치를 \(p \times p\) 에서 \(p' \times p'\) 로 리사이즈하는 연산을 행렬로 쓴 것(6장의 표기). FlexiViT 논문은 이 행렬을 \(B\), 새 패치 크기를 \(p_*\) 로 쓴다. \(A^{+}\) 는 행렬 \(A\) 의 의사 역행렬이다.
- \(t_i\), \(a_i\): 모델 \(i\) 의 비용(지연 시간 등, 작을수록 좋음)과 정확도(AP, 클수록 좋음).
- 구성은 “해상도 / 패치 / 윈도 / 디코더 층 / 질의” 순서로 적는다. 예:
96 / 8 / 2 / 3 / 12.
크기가 다른 모델이 왜 여러 개 필요한가
하드웨어도 데이터도 제각각
탐지기를 쓰는 자리는 다양하다. 공장 라인의 작은 보드는 그림 한 장을 몇 밀리초 안에 처리해야 하고, 서버의 큰 GPU 는 조금 느려도 정확한 쪽이 낫다. 1장에서 본 것처럼 정확도와 지연 시간은 맞바꿈 관계라서, “가장 좋은 모델 하나” 는 없고 자리마다 알맞은 크기 가 있을 뿐이다.
데이터도 마찬가지이다. 작은 객체가 많은 데이터는 높은 해상도가 필요하고, 그림 한 장에 객체가 몇 개 없는 데이터는 질의 300개가 필요 없다. RF-DETR 논문은 기존의 실시간 탐지기들이 구조와 학습 설정을 COCO 에 맞춰 손으로 다듬어 왔고, 그래서 다른 분포의 데이터(RF100-VL)로 가면 그 이점이 줄어든다고 지적한다. 하드웨어와 데이터셋이 바뀔 때마다 사람이 구조를 다시 다듬을 수는 없다.
크기마다 따로 설계하고 따로 학습하기
지금까지의 표준적인 방법은 크기별 모델을 하나씩 손으로 설계 하는 것이다. YOLO 의 N · S · M · L · X, LW-DETR 의 tiny – xlarge 가 그렇다. 층 수 · 채널 수 · 해상도를 사람이 정하고, 크기마다 처음부터 따로 학습한다. 이 방식에는 세 가지 비용이 따른다.
- 학습 비용이 크기의 수에 비례한다. 다섯 크기면 학습도 다섯 번이다.
- 고를 수 있는 점이 몇 개뿐이다. 내 장비의 예산이 S 와 M 사이라면 S 를 쓰며 정확도를 포기하거나 M 을 쓰며 예산을 넘겨야 한다.
- 설계가 벤치마크에 맞춰진다. 어떤 크기 조합이 좋은지는 보통 COCO 에서 정해지고, 내 데이터에서도 그 조합이 좋으리라는 보장은 없다.
구조를 기계가 찾게 하기
NAS(Neural Architecture Search, 신경망 구조 탐색)는 구조를 사람이 정하는 대신 탐색으로 찾는 방법이다. 먼저 “어떤 구조들 가운데서 고를 것인가” 를 정한다. 이 후보들의 집합이 탐색 공간(search space)이고, 그 안의 후보 하나를 이 장에서는 구성(configuration)이라고 부르겠다. 그다음 후보들의 정확도와 비용을 알아내어 좋은 것을 고른다.
RF-DETR 논문 2절은 NAS 의 흐름을 세 단계로 정리한다.
- 초기 NAS. Zoph 와 Le(2016) 등의 초기 방법은 정확도를 높이는 데 집중했고 효율은 거의 고려하지 않았다. 그래서 찾아낸 구조(NASNet, AmoebaNet)가 계산이 무거운 경우가 많았다.
- 하드웨어를 아는 NAS. 그 뒤의 방법들은 하드웨어에서 잰 값(지연 시간 등)을 탐색 과정에 직접 넣었다. 하지만 하드웨어가 바뀔 때마다 탐색과 학습을 되풀이해야 했다.
- 가중치 공유 NAS. OFA(Cai 외, 2019)는 정확도 – 지연 시간 맞바꿈이 서로 다른 수천 개의 부분망을 한꺼번에 학습해, 학습과 탐색을 떼어 놓았다.
무엇이 그렇게 비쌌는지는 OFA 논문이 숫자 없이도 분명하게 적는다. 배치할 자리(하드웨어와 제약 조건)마다 구조를 새로 설계하거나 탐색하고, 찾은 구조를 처음부터 다시 학습 해야 했다. 그래서 전체 비용이 배치할 자리의 수에 비례해 늘어난다. OFA 는 이것을 자리의 수와 무관한 한 번의 학습으로 바꾸겠다는 제안이었다.
가중치 공유: 학습과 탐색을 떼어 놓기
OFA(Once-for-All)(“한 번으로 모두를”)의 생각은 이렇다. 여러 구조를 지원하는 큰 신경망 하나를 학습해 두고, 필요한 자리가 생기면 그 안에서 알맞은 부분을 재학습 없이 골라 꺼낸다. 꺼낸 작은 모델을 부분망(sub-network, sub-net)이라고 하고, 모든 부분망이 큰 신경망의 가중치를 함께 쓰므로 가중치 공유(weight sharing) NAS 라고 부른다. OFA 는 합성곱 신경망에서 깊이 · 너비 · 커널 크기 · 해상도를 바꿀 수 있게 했고, 지원하는 부분망이 \(10^{19}\) 개가 넘는다고 보고한다. 그 모두를 저장하는 데 필요한 가중치는 한 벌뿐이다.
비유. 맞춤 양복점과 기성복 공장을 떠올려 보자. 손님이 올 때마다 치수를 재고 옷을 새로 짓는 것이 “크기마다 따로 학습” 이다. 가중치 공유 NAS 는 허리끈 · 소매 단추 · 밑단 지퍼로 치수를 조절할 수 있는 옷 한 벌 을 공들여 짓는 쪽이다. 손님이 오면 끈을 조이고 단추를 옮기기만 하면 된다. 다만 조절식 옷이 모든 치수에서 맞춤복만큼 잘 맞을지는 따져 봐야 한다. 이 장의 실험이 확인하려는 것이 그것이다.
RF-DETR 은 이 생각을 탐지와 분할에 가져왔다. 논문은 자신들이 아는 한 객체 탐지와 분할에 종단 간 가중치 공유 NAS 를 적용한 것은 처음이라고 적는다. 그때까지 탐지에서의 NAS 는 주로 백본이나 FPN 같은 부품 하나 를 NAS 로 찾은 것으로 바꿔 끼우는 방식이었고, RF-DETR 은 탐지 정확도 자체를 기준으로 모델 전체의 구성을 고른다.
조절하는 부분을 논문은 “tunable knob” 이라고 부른다. 이 튜토리얼에서는 손잡이(tunable knob)라고 하겠다. RF-DETR 의 손잡이는 다섯 개이다.
- 패치 크기
- 디코더 층 수
- 질의 수
- 입력 해상도
- 윈도 어텐션 블록의 윈도 수
손잡이를 하나씩 뜯어보기 전에, 수천 개의 구성 가운데 “좋은 것” 을 고른다는 말의 뜻부터 정확히 해 둔다.
정확도 – 지연 시간 평면과 파레토 최적
지배한다는 것
모델마다 숫자 두 개를 잰다. 비용 \(t\)(지연 시간처럼 작을수록 좋은 값)와 정확도 \(a\)(AP 처럼 클수록 좋은 값)이다. 가로축을 \(t\), 세로축을 \(a\) 로 놓으면 모델 하나가 점 하나가 되고, 왼쪽 위 에 있을수록 좋다.
두 모델을 견줄 때 한쪽이 빠르고 다른 쪽이 정확하면 어느 쪽이 낫다고 말할 수 없다. 쓰는 자리에 따라 답이 다르다. 하지만 한쪽이 더 느리지도 않고 덜 정확하지도 않으면서, 적어도 하나는 진짜로 나을 때는 말할 수 있다. 이때 앞의 모델이 뒤의 모델을 지배(dominate)한다고 한다.
\(i \text{ 가 } j \text{ 를 지배한다} \quad\Longleftrightarrow\quad t_i \le t_j \ \text{ 이고 } \ a_i \ge a_j \ \text{ 이고 } \ (\, t_i \lt t_j \ \text{ 또는 } \ a_i \gt a_j \,)\)
읽는 법: “\(i\) 의 비용이 \(j\) 보다 크지 않고, \(i\) 의 정확도가 \(j\) 보다 작지 않고, 둘 가운데 하나는 등호가 아니다.” 마지막 조건은 비용도 정확도도 똑같은 두 모델이 서로를 지배한다고 하지 않기 위한 것이다.
어떤 모델에게도 지배당하지 않는 모델을 파레토 최적(Pareto optimal)이라고 하고, 파레토 최적인 점들을 이은 선이 1장에서 본 파레토 경계(Pareto frontier)(파레토 곡선)이다.
\(i \text{ 가 파레토 최적} \quad\Longleftrightarrow\quad i \text{ 를 지배하는 } j \text{ 가 하나도 없다}\)
파레토 최적이 아닌 모델은 고를 이유가 없다. 그것보다 빠르면서 정확한(또는 한쪽은 같고 다른 쪽이 나은) 모델이 이미 있기 때문이다. 반대로 파레토 최적인 모델들 사이에서는 우열이 없다. 어느 것을 고를지는 “내 예산이 몇 밀리초인가” 가 정한다.
손으로 파레토 경계 찾기
모델 여덟 개가 있다고 하자. 숫자는 설명을 위해 지어낸 것이다.
| 모델 | a | b | c | d | e | f | g | h |
| 지연 시간 \(t\) (ms) | 1.0 | 2.0 | 2.5 | 3.0 | 4.0 | 5.0 | 6.0 | 7.0 |
| 정확도 \(a\) (AP) | 30 | 45 | 40 | 52 | 50 | 58 | 58 | 61 |
- 정의대로 한 쌍씩 견주기
- \(\text{c } (2.5,\ 40) \ \text{ 와 } \ \text{b } (2.0,\ 45): \qquad 2.0 \le 2.5, \quad 45 \ge 40, \quad 2.0 \lt 2.5\)
- b 는 c 보다 빠르고(\(t\) 가 작고) 정확하다. 세 조건이 모두 참이므로 b 가 c 를 지배한다. c 는 파레토 최적이 아니다.
- d 가 e 를 지배한다.
- 정확도는 같지만 f 가 더 빠르다. “크거나 같다” 와 “진짜로 작다” 가 성립하므로 f 가 g 를 지배한다. 정확도가 같으면 빠른 쪽만 남는다.
- d 는 빠르고 f 는 정확하다. d 는 f 를 지배하지 못하고, 거꾸로 f 도 d 를 지배하지 못한다(\(5.0 \not\le 3.0\)). 둘 다 살아남는다.
- 나머지 쌍도 같은 식으로 확인하면 a · b · d · f · h 를 지배하는 모델은 없다. 가장 빠른 a 와 가장 정확한 h 는 언제나 경계 위에 있다(그보다 빠르거나 정확한 모델이 없으므로).
정렬하고 한 번 훑기
정의대로 하면 모든 쌍을 견줘야 해서 모델이 \(n\) 개일 때 \(n(n-1)\) 번의 비교가 필요하다. 여덟 개면 56번, RF-DETR 논문의 6,468개면 약 4,180만 번이다. 더 빠른 방법이 있다. 비용이 작은 순으로 늘어놓으면, 어떤 점을 지배할 수 있는 점은 모두 그 점의 앞에 있다. 그러니 앞에서부터 훑으며 “지금까지 본 정확도의 최댓값” 만 기억하면 된다.
- 비용이 작은 순으로 정렬한다(비용이 같으면 정확도가 큰 것을 앞에).
- 앞에서부터 하나씩 본다. 정확도가 지금까지의 최댓값보다 크면 경계에 넣고 최댓값을 갱신한다.
- 크지 않으면 버린다. 앞에 이미 “더 싸거나 같은 값에 그만큼 정확한” 모델이 있다는 뜻이기 때문이다.
정렬에 \(n \log n\) 에 비례하는 시간, 훑는 데 \(n\) 에 비례하는 시간이 든다. 코드는 다음과 같다.
code/ch12_nas.py · pareto
def dominates(a, b) -> bool:
    """점 a = (비용, 정확도) 가 점 b 를 지배하는가: 비용은 같거나 작고, 정확도는 같거나 크고, 둘 중 하나는 진짜로 낫다."""
    return a[0] <= b[0] and a[1] >= b[1] and (a[0] < b[0] or a[1] > b[1])

def pareto_front(cost, accuracy) -> np.ndarray:
    """파레토 경계 위에 있는 점의 번호를 비용이 작은 순서로 돌려준다.

    cost: (n,) 작을수록 좋은 값 (지연 시간, 연산량 …).  accuracy: (n,) 클수록 좋은 값 (AP).
    방법: 비용이 작은 순으로 (비용이 같으면 정확도가 큰 순으로) 늘어놓고 앞에서부터 훑으며,
    "지금까지 본 정확도의 최댓값" 을 넘는 점만 남긴다. 넘지 못한 점은 앞에 있는 (더 싸거나 같은 값인) 어떤 점보다
    정확하지 않으므로 지배당한다. 정렬에 O(n log n), 훑기에 O(n).
    (비용과 정확도가 모두 같은 점이 여럿이면 하나만 남긴다.)
    """
    cost, accuracy = np.asarray(cost, dtype=float), np.asarray(accuracy, dtype=float)
    order = np.lexsort((-accuracy, cost))  # 마지막 열쇠(cost)가 1순위, -accuracy 가 2순위
    keep, best = [], -np.inf
    for i in order:
        if accuracy[i] > best:
            keep.append(i)
            best = accuracy[i]
    return np.array(keep, dtype=int)
앞의 여덟 점에 돌린 출력이다. 손으로 찾은 것과 같고, 무작위 점 300개에서 정의대로 구한 경계와도 일치한다.
[파레토] 손계산 예: (지연 시간 ms, AP)
  a (1.0, 30) | 지금까지의 최댓값   nan | 경계
  b (2.0, 45) | 지금까지의 최댓값    30 | 경계
  c (2.5, 40) | 지금까지의 최댓값    45 | 지배당함 ← b
  d (3.0, 52) | 지금까지의 최댓값    45 | 경계
  e (4.0, 50) | 지금까지의 최댓값    52 | 지배당함 ← d
  f (5.0, 58) | 지금까지의 최댓값    52 | 경계
  g (6.0, 58) | 지금까지의 최댓값    58 | 지배당함 ← f
  h (7.0, 61) | 지금까지의 최댓값    58 | 경계
  파레토 경계: a → b → d → f → h
  check 무작위 점 300개: 정의대로 모든 쌍을 견준 경계 12개 = pareto_front 12개, 같은 집합인가: True
- 그림 12-1: ch12-pareto-toy.png 손계산 예의 여덟 모델. 파란 동그라미가 파레토 최적, 회색 X 가 지배당하는 모델이다. 옅은 주황 영역은 d 가 지배하는 영역(d 보다 느리면서 덜 정확한 곳)이다.
- (그림 내용) 가로축 지연 시간, 세로축 정확도인 평면에 여덟 모델이 찍혀 있다. a, b, d, f, h 를 잇는 계단 모양의 선이 파레토 경계이고 c, e, g 는 그 아래에 있다.
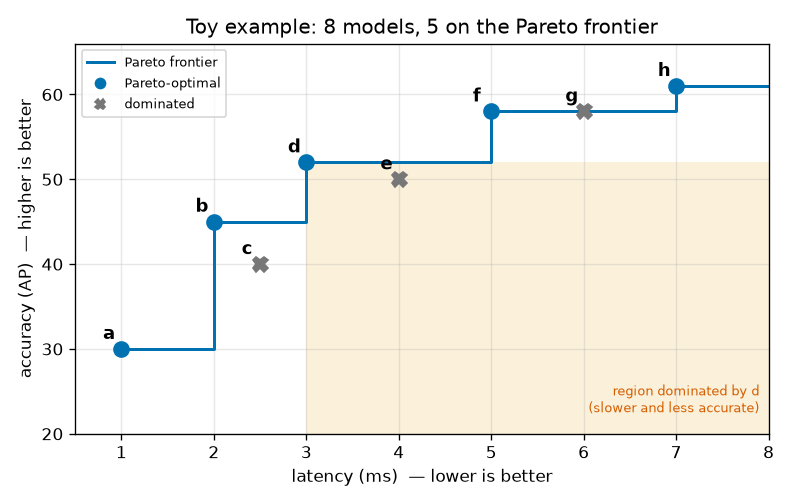
그림 12-1 에서 읽을 것은 세 가지이다.
- 경계가 계단 모양이다. 1장의 개념도는 점들을 비스듬한 선으로 이었지만, 엄밀히는 “예산이 \(t\) 일 때 얻을 수 있는 가장 높은 정확도” 를 그린 계단이다. 예산이 3.0 ms 에서 4.9 ms 로 늘어도 쓸 수 있는 가장 좋은 모델은 여전히 d 이다.
- e 는 주황 영역 안에 있다. 어떤 점이 지배하는 영역은 그 점의 오른쪽 아래 사분면이다. 파레토 경계는 “어느 점의 오른쪽 아래에도 들어가지 않는 점들” 이다.
- g 는 경계선 위에 놓여 있지만 경계가 아니다. f 와 정확도가 같고 더 느리기 때문이다.
참고 · 가로축은 하나가 아니다. “비용” 으로 무엇을 쓰느냐에 따라 파레토 경계가 달라진다. 지연 시간은 하드웨어와 재는 방법에 따라 달라지고, 연산량(FLOPs)이나 매개변수 수는 하드웨어와 무관하지만 실제 속도와 어긋날 수 있다. 논문도 “매개변수 수가 비슷한 구성들의 지연 시간이 크게 다를 수 있다” 고 적는다. 이 장의 실험에서는 가로축을 세 가지로 바꿔 가며 경계가 어떻게 달라지는지 본다.
가중치 공유 NAS 의 틀
하나의 가중치, 여러 구성
기호를 정한다. 모델의 가중치 전부를 \(\theta\), 구성 하나를 \(c\), 탐색 공간을 \(\mathcal{C}\) 라고 한다. RF-DETR 에서 구성은 다섯 손잡이의 값이다. 예를 들어 논문의 Nano 는 \(c = (\text{해상도 } 384,\ \text{패치 } 16,\ \text{윈도 } 2,\ \text{디코더 } 2\text{층},\ \text{질의 } 300)\) 이다.
보통의 학습은 구성 하나를 정해 놓고 그 구성의 손실을 줄인다. 11장이 그랬다. 크기가 세 가지 필요하면 가중치도 세 벌 \(\theta_1, \theta_2, \theta_3\) 을 따로 학습한다. 가중치 공유 NAS 는 가중치 한 벌 \(\theta\) 가 탐색 공간의 모든 구성에서 잘 동작하도록 학습한다. 전체 흐름은 세 단계이다.
원문 그림 12-2는 가중치 공유 NAS 의 세 단계를 왼쪽에서 오른쪽으로 그린 도식이다. 비용이 큰 학습은 한 번뿐이고, 탐색은 순전파만으로 끝난다.
- ① 학습(한 번): 구성 \(c\) 를 하나 뽑는다(해상도 · 패치 · 윈도) → 그 구성으로 순전파해 손실 \(\mathcal{L}(\theta; c)\) 를 구한다 → 모든 구성이 함께 쓰는 가중치 \(\theta\) 를 한 번 갱신한다. 이 고리를 스텝마다 되풀이한다(첫 상자로 되돌아가는 화살표).
- ② 탐색(재학습 없음): 학습이 끝난 \(\theta\) 를 그대로 두고, 모든 구성 \(c\) 에 대해 검증 AP 와 지연 시간을 잰다. 다섯 손잡이를 모두 돌리며, 디코더 층 · 질의는 여기서만 바꾼다. 논문은 6,468개 구성, 이 장의 실험은 408개 구성이다.
- ③ 선택: 가로축 지연 시간, 세로축 AP 인 평면에 구성마다 점을 하나씩 찍고(모든 점이 같은 가중치 \(\theta\) 에서 나온다), 파레토 경계 위에서 예산에 맞는 점을 고른다.
그림 12-2 에서 눈여겨볼 곳은 ① 의 되돌아가는 화살표이다. 구성은 스텝마다 바뀌지만 갱신되는 가중치는 늘 같은 \(\theta\) 이다. 그리고 ② 에는 학습이 없다. 논문은 “기반 모델을 목표 데이터셋에서 끝까지 학습하기 전에는 탐색 공간을 평가하지 않는다” 고 적는다. 탐색은 학습이 다 끝난 가중치에 대한 측정일 뿐이다.
학습 목표와 한 스텝의 근사
“모든 구성에서 잘 동작하는 \(\theta\)” 를 식으로 쓰면, 구성마다의 손실을 평균한 것을 가장 작게 하는 \(\theta\) 이다. 논문은 이 식을 적지 않고 절차만 설명한다(“매 학습 반복마다 모델 구성 하나를 균등하게 무작위로 뽑아 기울기 갱신을 한 번 한다”). 그 절차가 무엇을 푸는 것인지 식으로 옮겨 본다.
- 스텝마다 구성 하나를 뽑는 것이 왜 평균 손실을 줄이는가
- \(J(\theta) = \mathbb{E}_{c \sim \mathcal{C}}\big[\, \mathcal{L}(\theta; c) \,\big] = \frac{1}{|\mathcal{C}|} \sum_{c \in \mathcal{C}} \mathcal{L}(\theta; c)\)
- 목표 \(J\) 는 탐색 공간의 모든 구성에 대한 손실의 평균이다. \(c \sim \mathcal{C}\) 는 “\(\mathcal{C}\) 에서 모든 구성을 같은 확률 \(1/|\mathcal{C}|\) 로 뽑는다” 는 뜻이다. 같은 확률이므로 기댓값이 곧 산술 평균이다. (OFA 논문의 식 (1) 도 모든 구조에 대한 손실의 합을 가중치에 대해 최소화하는 꼴이다.)
- 합의 미분은 미분의 합이다. 정확한 기울기를 구하려면 스텝마다 모든 구성 으로 순전파 · 역전파를 해야 한다. 구성이 수천 개면 한 스텝이 수천 배 비싸진다.
- 그래서 구성 하나 \(c'\) 만 뽑아 그 구성의 기울기 \(\hat{g}\) 를 쓴다. 모자는 “어림값” 이라는 뜻이다.
- \(\hat{g}\) 의 기댓값은 각 구성이 뽑힐 확률 \(1/|\mathcal{C}|\) 을 곱해 더한 것이고, 그것은 둘째 줄의 정확한 기울기와 같다. 한 번 한 번은 틀려도 평균적으로는 옳은 방향 이다. 미니배치 경사 하강법이 데이터 전체 대신 몇 장만 뽑아 쓰는 것과 똑같은 논리이고(4장), 여기서는 뽑는 대상이 하나 더 늘었을 뿐이다: 그림 몇 장과 구성 하나.
숫자로 확인한다. 가중치가 숫자 하나 \(\theta\) 이고 구성이 둘뿐인 장난감 문제이다. 구성 1 의 손실은 \(\mathcal{L}_1 = (\theta - 1)^2\), 구성 2 의 손실은 \(\mathcal{L}_2 = (\theta - 3)^2\) 이라고 하자. 구성 1 은 \(\theta = 1\) 을, 구성 2 는 \(\theta = 3\) 을 원한다.
- 손계산: 구성이 둘인 장난감 문제
- \(J(\theta) = \tfrac{1}{2}(\theta - 1)^2 + \tfrac{1}{2}(\theta - 3)^2\)
- 두 구성의 손실을 평균했다.
- \((\theta - k)^2\) 의 미분은 \(2(\theta - k)\) 이고 앞의 \(\tfrac{1}{2}\) 과 곱해져 \((\theta - k)\) 가 된다. \(\theta = 0\) 에서 정확한 기울기는 \(-4\) 이다.
- 구성 하나만 뽑으면 기울기는 \(-2\) 또는 \(-6\) 이다. 어느 쪽도 \(-4\) 는 아니지만 반반의 확률로 평균하면 \(-4\) 이다. 방향(음수 → \(\theta\) 를 키워라)은 둘 다 옳다.
- 평균 손실이 가장 작은 곳은 두 구성이 원하는 값의 한가운데이다. 여기서 두 구성의 손실은 각각 1 이다. 따로 학습했다면 각각 0 이 될 수 있었다. 가중치를 공유하면 구성들이 서로 양보해야 한다.
마지막 줄이 가중치 공유의 값이다. OFA 논문은 이것을 부분망들이 “서로 간섭한다(interfere)” 고 표현한다. 실제 신경망은 가중치가 수천만 개라서 여러 구성을 동시에 만족시킬 여지가 장난감 문제보다 훨씬 크지만, 공짜는 아니다. 공유 때문에 각 구성의 정확도가 얼마나 내려가는지(또는 올라가는지)는 실험으로만 알 수 있고, 이 장의 뒤쪽에서 직접 잰다.
드롭아웃과 닮은 점, 구조 증강
논문은 이 학습을 드롭아웃(Srivastava 외, 2014)의 앙상블 학습에 견준다. 드롭아웃은 스텝마다 뉴런의 일부를 무작위로 꺼서, 가중치를 공유하는 수많은 “얇은 신경망” 을 번갈아 학습하는 셈이 된다. 가중치 공유 NAS 는 뉴런 대신 구성 을 무작위로 바꾼다. 한 번의 학습이 수천 개의 부분망을 함께 학습시킨다는 점이 같다.
여기서 논문이 덧붙이는 관찰이 있다. 이 학습이 정규화 로도 작용한다는 것이다. 논문은 이것을 구조 증강(architecture augmentation)이라고 부른다. 데이터 증강이 그림을 뒤집고 잘라 “같은 내용의 다른 입력” 을 보여 주듯, 구조 증강은 “같은 그림을 보는 다른 구조” 를 번갈아 쓴다. 가중치가 특정 해상도나 특정 패치 크기에서만 통하는 요령에 기대지 못하게 된다.
근거는 논문의 표 5 이다. Medium 크기에서 다른 조건을 그대로 둔 채 가중치 공유 NAS 로 학습하는 것만으로 COCO AP 가 54.3 에서 54.6 으로 올랐다. 구성(패치 14, 해상도 560)은 바꾸지 않았는데도 그렇다. 논문은 “직관과 달리, 패치 크기 14 는 NAS 탐색 공간에 들어 있지도 않은데 기반 구성의 성능이 올랐다” 고 적는다.
주의 · 이 이득은 조건에 달려 있다. +0.3 AP 는 DINOv2 사전 학습 백본, Objects365 사전 학습, COCO 라는 조건에서 보고된 값이다. 앞의 장난감 문제가 보여 주듯 가중치 공유는 원리적으로 손해가 될 수도 있다. 정규화가 필요한 상황(모델이 데이터에 비해 커서 과적합하는 상황)에서는 이득이, 그렇지 않은 상황에서는 손해가 앞설 수 있다. 이 장의 미니 실험에서 어느 쪽이 나오는지는 뒤에서 확인한다.
학습이 끝난 뒤의 격자 탐색
학습이 끝나면 손잡이마다 값의 목록을 정하고, 그 목록들의 모든 조합 을 하나씩 평가한다. 이것이 격자 탐색(grid search)이다. 손잡이가 다섯 개이니 5차원 격자의 모든 칸을 방문하는 셈이다. 칸마다 하는 일은 검증 세트에서 AP 를 재고 지연 시간을 재는 것뿐이다.
초기 NAS 가 강화 학습이나 진화 알고리즘 같은 정교한 탐색 방법을 썼던 것과 대비된다. 후보 하나를 평가하는 데 학습이 필요할 때는 “어느 후보를 볼지” 를 아껴 골라야 했다. 평가가 순전파만으로 끝나면 전부 보는 것이 가장 단순하고 확실하다. 논문은 이 탐색에 약 10,000 GPU 시간(T4 GPU 200대 × 48시간)이 들었다고 추정한다. 적은 비용은 아니지만 학습이 아니라 측정이므로 얼마든지 나눠서 돌릴 수 있다.
탐색에서 얻은 (AP, 지연 시간) 점들에서 파레토 경계를 뽑으면 그것이 모델 가족이 된다. 논문의 N · S · M · L · XL · 2XL 은 그 경계 위에서 고른 점들이다. 새 하드웨어가 생기면 지연 시간만 다시 재면 되고, 새 예산이 생기면 경계 위의 다른 점을 고르면 된다. 어느 경우에도 학습은 다시 하지 않는다.
OFA 와 다른 점
RF-DETR 의 방법은 OFA 에서 출발했지만 학습 절차가 다르다. OFA 는 모든 부분망을 처음부터 무작위로 뽑아 학습하면 부분망끼리의 간섭 때문에 정확도가 크게 떨어진다고 보고하고, 점진적 축소(progressive shrinking)라는 순서를 제안했다. 가장 큰 신경망을 먼저 끝까지 학습하고, 그 뒤 커널 크기 → 깊이 → 너비 순으로 작은 부분망을 단계적으로 뽑는 범위에 넣으며 미세 조정한다.
| OFA (Cai 외, 2019) | RF-DETR | |
| 대상 | 합성곱 신경망, 이미지 분류 | ViT 백본의 DETR, 탐지와 분할(종단 간) |
| 손잡이 | 깊이, 너비, 커널 크기, 해상도 | 패치 크기, 디코더 층 수, 질의 수, 해상도, 윈도 수 |
| 학습 순서 | 큰 신경망을 먼저 학습한 뒤 단계별로 작은 부분망을 추가(점진적 축소) | 단계 없이 처음부터 구성을 균등하게 뽑는다 |
| 학습률 스케줄 | 단계마다 다른 스케줄 | 스케줄러 없음 |
| 탐색 | 부분망 일부로 정확도 · 지연 시간 예측기를 학습하고, 그 예측기로 탐색 | 검증 세트에서 모든 구성을 격자 탐색 |
RF-DETR 이 단계를 없앤 이유를 논문은 이렇게 설명한다. 단계별 스케줄은 “모델이 언제 수렴하는가” 에 대한 강한 가정을 담고 있는데, 데이터셋이 다양하면 그 가정이 맞지 않을 수 있다는 것이다. 11장에서 본 “스케줄러 없는 학습” 과 같은 문제의식이다. 논문은 자신들의 모델을 “스케줄러 없는 NAS 기반 모델 가족” 이라고 부른다.
손잡이의 성격도 다르다. OFA 의 너비 · 커널 크기 손잡이는 가중치의 일부를 잘라 쓰는 것이어서, 어느 채널을 남길지 정렬하거나 큰 커널에서 작은 커널을 만드는 변환 행렬을 학습해야 했다. RF-DETR 의 손잡이는 뒤에서 보듯 대부분 “가중치는 그대로 두고 입력의 모양이나 순전파의 길이만 바꾸는” 것들이다. 단계 없는 학습이 통하는 데에는 이 차이도 한몫할 것으로 보이지만, 논문이 그 점을 따로 실험하지는 않았다.
다섯 손잡이: 왜 가중치를 그대로 쓸 수 있는가
구조가 바뀌는데 가중치를 그대로 쓴다는 것은 당연한 일이 아니다. 층의 수가 바뀌면 가중치의 개수가 바뀌고, 입력의 크기가 바뀌면 행렬의 모양이 맞지 않게 된다. 손잡이마다 물어야 할 질문은 같다. 가중치의 어느 부분이 이 손잡이의 값에 묶여 있고, 그 묶임을 어떻게 풀었는가. 먼저 답을 표로 모아 두고 하나씩 본다.
| 손잡이 | 바꾸면 달라지는 것 | 묶여 있는 가중치 | 푸는 방법 | 언제 바꾸나 |
| (a) 패치 크기 | 토큰 수, 패치 하나가 담는 픽셀 수 | 패치 임베딩 커널(\(p \times p\)), 위치 임베딩 | 커널을 PI-resize 로 변환, 위치 임베딩은 보간 | 학습 + 추론 |
| (b) 디코더 층 수 | 디코더의 깊이 | 없음(뒤 층을 안 쓸 뿐) | 모든 층에 손실을 걸어 둔다 | 추론만 |
| (c) 질의 수 | 디코더가 다루는 질의 수, 예측의 최대 개수 | 질의 임베딩의 뒤쪽 줄 | 점수 순으로 뽑힌 앞쪽만 쓴다 | 추론만 |
| (d) 해상도 | 토큰 수, 그림의 세밀함 | 위치 임베딩 | 가장 큰 격자로 두고 보간 | 학습 + 추론 |
| (e) 윈도 수 | 윈도 블록에서 서로 볼 수 있는 토큰의 범위 | 없음 | 토큰을 묶는 방식만 바꾼다 | 학습 + 추론 |
손잡이 하나: 패치 크기
ViT 는 그림을 \(p \times p\) 픽셀 패치로 잘라 토큰으로 만든다(6장). 한 변이 \(H\) 픽셀인 그림에서 토큰 격자의 한 변은 \(g = H/p\), 토큰 수는 \(N = g^2\) 이다.
\(N = \left( \frac{H}{p} \right)^2 \qquad \text{예: } H = 96 \text{ 일 때 } \ p = 8 \to 12^2 = 144, \quad p = 12 \to 8^2 = 64, \quad p = 16 \to 6^2 = 36\)
패치를 2배로 키우면 토큰이 1/4 로 줄어든다. 블록마다의 계산량이 토큰 수에 비례하거나(선형 층) 제곱에 비례하므로(어텐션) 모델이 크게 빨라지고, 대신 토큰 하나가 넓은 영역을 뭉뚱그려 담게 되어 세밀함을 잃는다. 논문의 표현으로는 “작은 패치는 더 큰 계산 비용으로 더 높은 정확도를 준다” 이다.
문제는 패치 임베딩이다. 패치 임베딩은 \(p \times p\) 커널의 합성곱이고, 커널의 크기가 곧 패치 크기이다. 패치 8 로 학습한 \(8 \times 8\) 커널은 \(16 \times 16\) 패치에 댈 수 없다. 6장에서 예고한 대로, 이것을 푸는 것이 FlexiViT(Beyer et al., 2023) 의 변환이다. 논문은 “FlexiViT 식 변환으로 학습 중에 패치 크기 사이를 보간한다” 고 적는다.
커널을 그림처럼 보간하면 왜 안 되는가
가장 먼저 떠오르는 방법은 커널을 작은 그림으로 보고 쌍선형 보간으로 키우는 것이다. 그런데 패치 임베딩이 계산하는 것은 내적 \(\langle x, w \rangle\) 이고, 보간은 내적을 지켜 주지 않는다. 패치와 커널을 둘 다 2배로 키우면 더하는 항의 수가 \(p^2\) 개에서 \(4p^2\) 개로 늘어나므로 값이 약 4배가 된다. FlexiViT 논문의 표현으로는 \(\langle x, w \rangle \approx \tfrac{1}{4} \langle \text{resize}(x),\ \text{resize}(w) \rangle\) 이다. 토큰의 크기가 학습 때와 4배 다르면 뒤의 블록들은 본 적 없는 입력을 받는다.
“그러면 4 로 나누면 되지 않나” 싶지만, 그것은 크기만 맞출 뿐 값을 맞추지는 못한다. 원하는 것을 정확히 적어 본다. 패치를 리사이즈한 것과 새 커널의 내적이, 원래 패치와 원래 커널의 내적과 같아야 한다. 어떤 패치에 대해서든.
리사이즈는 행렬 곱이다
쌍선형 리사이즈는 선형 연산 이다. 출력의 각 픽셀이 입력 픽셀들의 가중 평균이고(8장의 쌍선형 보간), 그 가중치는 입력의 값과 무관하게 위치로만 정해지기 때문이다. 선형 연산은 행렬 곱으로 쓸 수 있다. \(p \times p\) 패치를 길이 \(p^2\) 의 벡터 \(x\) 로 펴면, \(p' \times p'\) 로 리사이즈한 결과는 \(Rx\) 이다. \(R\) 은 \(p'^2 \times p^2\) 행렬이다.
\(R\) 을 구하는 방법은 단순하다. “한 칸만 1 이고 나머지는 0” 인 패치를 리사이즈하면 그 결과가 \(R\) 의 한 열이다. 그런 패치 \(p^2\) 장을 차례로 리사이즈해 열로 세우면 \(R\) 전체가 나온다. 1차원의 가장 작은 예로 직접 구해 본다. 길이 2 인 “패치” 를 길이 4 로 늘린다.
- 손계산: 길이 2 를 길이 4 로 늘리는 행렬 R
- \(u_i = (i + 0.5) \cdot \frac{2}{4} - 0.5, \qquad u_0 = -0.25, \quad u_1 = 0.25, \quad u_2 = 0.75, \quad u_3 = 1.25\)
- 출력의 \(i\) 번째 칸의 중심이 입력의 눈금으로 어디인지 구한다(8장의 좌표 규약: 칸의 중심이 정수 + 0.5 에 있다고 보고 비율 \(2/4\) 로 줄인 뒤 0.5 를 뺀다). 입력의 두 칸은 눈금 0 과 1 에 있다.
- 선형 보간 \((1 - t)\, x_0 + t\, x_1\) 에 \(t = 0.25\) 와 \(0.75\) 를 넣었다. \(u_0 = -0.25\) 와 \(u_3 = 1.25\) 는 입력의 바깥이라 가장 가까운 칸의 값을 그대로 쓴다.
- 위의 네 식에서 \(x_0\) 의 계수를 첫째 열에, \(x_1\) 의 계수를 둘째 열에 적었다. 첫째 열 \((1, 0.75, 0.25, 0)\) 은 패치 \((1, 0)\) 을 늘린 결과이고, 둘째 열은 패치 \((0, 1)\) 을 늘린 결과이다.
PI-resize 의 유도
이제 조건을 식으로 쓴다. 새 커널을 \(\hat{w}\)(길이 \(p'^2\))라고 하면, 원하는 것은 모든 패치 \(x\) 에 대해 \(\langle Rx, \hat{w} \rangle = \langle x, w \rangle\) 이다.
- 패치를 키울 때: 내적을 정확히 지키는 새 커널
- \(\langle Rx,\ \hat{w} \rangle = (Rx)^\top \hat{w} = x^\top R^\top \hat{w}\)
- 내적을 행렬 곱으로 쓰고, 곱의 전치는 순서를 뒤집은 전치의 곱이라는 것 \((Rx)^\top = x^\top R^\top\) 을 썼다.
- \(x^\top(R^\top \hat{w} - w) = 0\) 이 모든 \(x\) 에서 성립하려면 괄호 안이 영벡터여야 한다(\(x\) 로 괄호 안의 벡터 자신을 넣으면 그 길이의 제곱이 0 이 되어야 하므로). 조건이 \(\hat{w}\) 에 대한 연립 일차 방정식이 됐다.
- 패치를 키우면(\(p' \gt p\)) 미지수가 식보다 많다. 해가 하나가 아니라 무수히 많다. 그 가운데 하나를 골라야 한다.
- “원래 크기의 어떤 커널 \(z\) 를 리사이즈한 것” 의 꼴로 해를 찾는다. \(R^\top R\) 은 \(p^2 \times p^2\) 정사각 행렬이고, 키우는 리사이즈에서는 \(R\) 의 열들이 서로 독립이라 역행렬이 있다.
- \(R (R^\top R)^{-1}\) 이 바로 \(R^\top\) 의 의사 역행렬(pseudo-inverse) \((R^\top)^{+}\) 이다. 검산: \(R^\top \hat{w} = R^\top R (R^\top R)^{-1} w = w\). FlexiViT 논문의 식 (3) 이 이것이고, 이 변환을 PI-resize(pseudo-inverse resize)라고 부른다.
무수히 많은 해 가운데 왜 이것일까? \(\hat{w} = Rz\) 꼴의 해는 길이가 가장 짧은 해이다. 다른 해는 모두 \(\hat{w} + n\) 꼴이고 \(n\) 은 \(R^\top n = 0\) 을 만족한다. 그런데 \(\hat{w}^\top n = (Rz)^\top n = z^\top (R^\top n) = 0\) 이라 둘은 직교하고, 피타고라스 정리로 \(\| \hat{w} + n \|^2 = \| \hat{w} \|^2 + \| n \|^2 \ge \| \hat{w} \|^2\) 이다. \(n\) 은 “리사이즈된 패치에는 아무 영향이 없지만 다른 입력에는 반응하는” 성분이므로, 필요 없는 성분을 하나도 넣지 않은 해라고 할 수 있다.
앞의 1차원 예로 끝까지 계산해 본다. 커널 \(w = (1, 3)\), 패치 \(x = (2, 4)\) 이다. 원래 내적은 \(2 \cdot 1 + 4 \cdot 3 = 14\) 이다.
- 손계산: 길이 2 인 커널을 길이 4 로 PI-resize
- \(R^\top R = \begin{pmatrix} 1 & 0.75 & 0.25 & 0 \\ 0 & 0.25 & 0.75 & 1 \end{pmatrix} \begin{pmatrix} 1 & 0 \\ 0.75 & 0.25 \\ 0.25 & 0.75 \\ 0 & 1 \end{pmatrix} = \begin{pmatrix} 1.625 & 0.375 \\ 0.375 & 1.625 \end{pmatrix}\)
- 왼쪽 위: \(1^2 + 0.75^2 + 0.25^2 + 0^2 = 1 + 0.5625 + 0.0625 = 1.625\). 오른쪽 위: \(1 \cdot 0 + 0.75 \cdot 0.25 + 0.25 \cdot 0.75 + 0 \cdot 1 = 0.1875 + 0.1875 = 0.375\). 대칭이라 나머지도 같다.
- 2×2 행렬의 역행렬 공식이다. 행렬식은 \(2.640625 - 0.140625 = 2.5\) 이다.
- \(0.65 - 0.45 = 0.2\), \(-0.15 + 1.95 = 1.8\).
- \(0.15 + 0.45 = 0.6\), \(0.05 + 1.35 = 1.4\). 새 커널은 원래 커널 \((1, 3)\) 을 그대로 늘린 \((1, 1.5, 2.5, 3)\) 과 다르다. 값이 전체적으로 작아졌다(항이 늘어난 만큼).
- 원래 내적 14 와 정확히 같다. 견주어 보면, 커널을 그냥 늘린 \(Rw = (1, 1.5, 2.5, 3)\) 으로는 \(2 + 3.75 + 8.75 + 12 = 26.5\) 가 나오고, 길이의 비 \(2/4\) 를 곱해 보정해도 \(13.25\) 로 14 와 다르다.
원문 그림 12-3은 PI-resize 가 지키려는 것을 그린 도식이다. 위 줄은 원래 패치 \(x\)(\(p \times p\))와 커널 \(w\)(\(p \times p\))의 내적, 곧 학습 때 본 토큰 \(\langle x, w \rangle\) 이다. 아래로 내려가며 패치는 리사이즈 \(R\) 로 \(Rx\)(\(p' \times p'\))가 되고, 커널은 PI-resize \((R^\top)^{+}\) 로 \(\hat{w}\)(\(p' \times p'\))가 된다. 아래 줄의 토큰 \(\langle Rx, \hat{w} \rangle\) 는 위 줄의 \(\langle x, w \rangle\) 와 같다(키울 때는 정확히). 패치를 키운 것과 새 커널의 내적이 원래 패치와 원래 커널의 내적과 같아지도록 커널을 바꾸므로, 뒤의 블록들이 받는 토큰이 달라지지 않는다.
이 결과를 다르게 읽을 수도 있다. 실제로 쓰일 때 큰 패치 \(x'\)(길이 \(p'^2\))는 작은 패치를 늘린 것이 아니라 그림에서 바로 잘라 낸 진짜 \(p' \times p'\) 패치이다. 그때 새 커널이 내는 값은
\(\langle x',\ \hat{w} \rangle = x'^\top R\,(R^\top R)^{-1} w = \big\langle (R^\top R)^{-1} R^\top x',\ w \big\rangle = \langle R^{+} x',\ w \rangle\)
이다. \(R^{+} x' = (R^\top R)^{-1} R^\top x'\) 는 “리사이즈해서 \(x'\) 에 가장 가까워지는 작은 패치”, 곧 최소제곱의 뜻에서 \(x'\) 를 가장 잘 줄인 \(p \times p\) 패치 이다. 그러니 PI-resize 한 커널로 큰 패치를 읽는 것은 큰 패치를 원래 크기로 잘 줄인 다음 원래 커널로 읽는 것 과 같다. 커널이 배운 것(어떤 무늬에 반응하는가)은 그대로이고, 보는 범위만 넓어진다.
참고 · 패치를 줄일 때
\(p' \lt p\) 이면 \(R^\top \hat{w} = w\) 는 식이 미지수보다 많아 일반적으로 해가 없다. 작은 커널로는 큰 커널의 세밀한 무늬를 다 담을 수 없으니 당연하다. FlexiViT 는 이때 “평균적으로 가장 덜 틀리는” \(\hat{w}\) 를 찾는다. 패치가 표준 정규 분포를 따른다고 가정하면 그 답은 \(\| w - R^\top \hat{w} \|^2\) 을 가장 작게 하는 최소제곱 해이고, 이것도 같은 식 \(\hat{w} = (R^\top)^{+} w\) 로 구해진다(FlexiViT 부록 A.2). 의사 역행렬은 “해가 많으면 가장 짧은 해를, 해가 없으면 가장 덜 틀리는 해를” 주는 연산이다. FlexiViT 는 실제로 커널을 큰 크기(32×32)로 저장해 두고 필요한 크기로 바꿔 쓴다.
구현과 확인
2차원에서도 똑같다. \(8 \times 8\) 기저 패치 64장을 리사이즈해 \(R\) 을 만들고 의사 역행렬을 한 번 구해 둔 뒤, 커널의 채널마다 곱한다. 9장의 WindowedViT 는 패치 크기를 바꿀 때 patch_resize_fn 을 부르게 되어 있으므로 이 함수를 끼우기만 하면 된다.
code/ch12_nas.py · pi-resize
def resize_matrix(old: int, new: int, ndim: int = 2) -> torch.Tensor:
    """쌍선형 리사이즈를 행렬로 쓴 것. 돌려주는 값 R: (new^ndim, old^ndim), float64.

    리사이즈는 선형 연산이다: 리사이즈(a·x + b·y) = a·리사이즈(x) + b·리사이즈(y). 그러므로 "한 칸만 1 이고 나머지는 0" 인
    패치(기저 벡터)들을 리사이즈한 결과를 열로 세우면 그것이 곧 행렬 R 이고, 어떤 패치 x 든 리사이즈(x) = R·vec(x) 다.
    ndim=1 은 본문의 1차원 손계산 예를 위한 것.
    """
    basis = torch.eye(old**ndim, dtype=torch.float64).reshape(old**ndim, 1, *([old] * ndim))  # 기저 패치 old^ndim 장
    mode = "bilinear" if ndim == 2 else "linear"
    resized = F.interpolate(basis, size=[new] * ndim, mode=mode, align_corners=False)  # (old^ndim, 1, new, …)
    return resized.reshape(old**ndim, new**ndim).T  # j 번째 열 = j 번째 기저 패치를 리사이즈한 것

_PI_CACHE: dict = {}

def pi_resize_matrix(old: int, new: int, ndim: int = 2) -> torch.Tensor:
    """PI-resize 행렬 P = (Rᵀ)⁺: (new^ndim, old^ndim).  새 커널 = P · vec(원래 커널).

    키울 때(new ≥ old)는 P = R (RᵀR)⁻¹ 이고 Rᵀ P = I — 리사이즈한 패치와 새 커널의 내적이 원래 내적과 정확히 같다.
    줄일 때(new < old)는 정확한 답이 없고, P 는 ‖w − Rᵀ ŵ‖² 을 가장 작게 하는 ŵ 를 준다.
    """
    key = (old, new, ndim)
    if key not in _PI_CACHE:
        _PI_CACHE[key] = torch.linalg.pinv(resize_matrix(old, new, ndim).T)
    return _PI_CACHE[key]

def pi_resize_patch_embed(weight: torch.Tensor, new_patch: int) -> torch.Tensor:
    """FlexiViT 의 PI-resize 로 패치 임베딩 합성곱의 가중치를 다른 패치 크기로 바꾼다.

    weight: (C, 3, p, p) → (C, 3, p', p').  출력 채널 · 입력 채널마다 따로 같은 행렬 P 를 곱한다.
    WindowedViT.patch_resize_fn 에 끼워 쓴다 (순전파마다 불린다. P 는 한 번만 계산해 둔다. 기울기는 P 를 거슬러 흐른다).
    """
    old_patch = weight.shape[-1]
    if new_patch == old_patch:
        return weight
    P = pi_resize_matrix(old_patch, new_patch).to(weight)  # (p'², p²)
    flat = weight.reshape(-1, old_patch * old_patch)  # (C·3, p²): 커널의 채널마다 한 줄
    return (flat @ P.T).reshape(*weight.shape[:2], new_patch, new_patch)
손계산 예를 코드로 돌린 값과, 실제 패치로 잰 내적 보존 오차이다. 커널은 11장에서 학습한 미니 RF-DETR 의 패치 임베딩(96채널 × RGB × 8 × 8)이고, 패치는 검증 그림에서 무작위로 자른 \(8 \times 8\) 조각 2,000개이다. 세 방법을 견준다: PI-resize, 9장의 단순 판(쌍삼차 보간 뒤 \((p/p')^2\) 을 곱함), 쌍선형 보간만 한 것.
[PI-resize] 1차원 손계산 예: 길이 2 인 패치를 길이 4 로
  R = [[1.0, 0.0], [0.75, 0.25], [0.25, 0.75], [0.0, 1.0]]
  RᵀR = [[1.625, 0.375], [0.375, 1.625]]  (RᵀR)⁻¹ = [[0.65, -0.15], [-0.15, 0.65]]
  w = [1, 3], x = [2, 4]:  ⟨x, w⟩ = 14.0
  Rx = [2.0, 2.5, 3.5, 4.0]  ŵ = P w = [0.2, 0.6, 1.4, 1.8]  ⟨Rx, ŵ⟩ = 14.0
  단순 보간 Rw = [1.0, 1.5, 2.5, 3.0]  ⟨Rx, Rw⟩ = 26.5  길이 비로 보정 (2/4)·⟨Rx, Rw⟩ = 13.25
  check Rᵀ ŵ = w 인가: [1.0, 3.0] | P = R(RᵀR)⁻¹ 과의 차이 1.1e-16
  check 2차원 R (8→12, 모양 (144, 64)) 과 F.interpolate 의 차이: 1.1e-16
[PI-resize] 내적 보존: 11장 모델의 패치 임베딩 (96, 3, 8, 8), 검증 그림에서 자른 8×8 패치 2000개
  새 패치 | 방법                        | 상대 오차 ‖⟨Rx, ŵ⟩ − ⟨x, w⟩‖ / ‖⟨x, w⟩‖ | 토큰 크기의 비 ‖⟨Rx, ŵ⟩‖ / ‖⟨x, w⟩‖
        4 | PI-resize                   |     1.57e-01                             | 0.9853
        4 | bicubic x (p/p')^2 (ch09)   |     1.98e-01                             | 1.0134
        4 | bilinear only               |     7.58e-01                             | 0.2463
        6 | PI-resize                   |     9.99e-02                             | 0.9947
        6 | bicubic x (p/p')^2 (ch09)   |     1.17e-01                             | 0.9958
        6 | bilinear only               |     4.71e-01                             | 0.5511
       10 | PI-resize                   |     1.54e-15                             | 1.0000
       10 | bicubic x (p/p')^2 (ch09)   |     7.22e-02                             | 0.9884
       10 | bilinear only               |     5.47e-01                             | 1.5325
       12 | PI-resize                   |     1.87e-15                             | 1.0000
       12 | bicubic x (p/p')^2 (ch09)   |     7.16e-02                             | 0.9870
       12 | bilinear only               |     1.22e+00                             | 2.2180
       16 | PI-resize                   |     1.68e-15                             | 1.0000
       16 | bicubic x (p/p')^2 (ch09)   |     7.41e-02                             | 0.9871
       16 | bilinear only               |     2.95e+00                             | 3.9402
       24 | PI-resize                   |     1.23e-15                             | 1.0000
       24 | bicubic x (p/p')^2 (ch09)   |     6.40e-02                             | 0.9885
       24 | bilinear only               |     7.89e+00                             | 8.8867
       32 | PI-resize                   |     1.15e-15                             | 1.0000
       32 | bicubic x (p/p')^2 (ch09)   |     6.96e-02                             | 0.9877
       32 | bilinear only               |     1.48e+01                             | 15.7752
- 그림 12-4: ch12-pi-resize.png 왼쪽: 커널 하나(빨강 채널)와 그것을 세 방법으로 \(16 \times 16\) 으로 키운 것(같은 색 눈금). 가운데: 패치와 커널을 둘 다 8 → 16 으로 키우기 전(가로)과 후(세로)의 토큰 값. 검은 선이 “그대로”. 오른쪽: 새 패치 크기에 따른 토큰의 상대 오차(로그 축). 세로 점선의 왼쪽은 줄이는 경우이다.
- (그림 내용) 왼쪽: 패치 임베딩 커널 하나와 세 방법으로 16×16 으로 키운 것. 가운데: 리사이즈 전의 토큰 값과 리사이즈 뒤의 토큰 값의 산점도. 오른쪽: 새 패치 크기에 따른 내적 보존 오차.
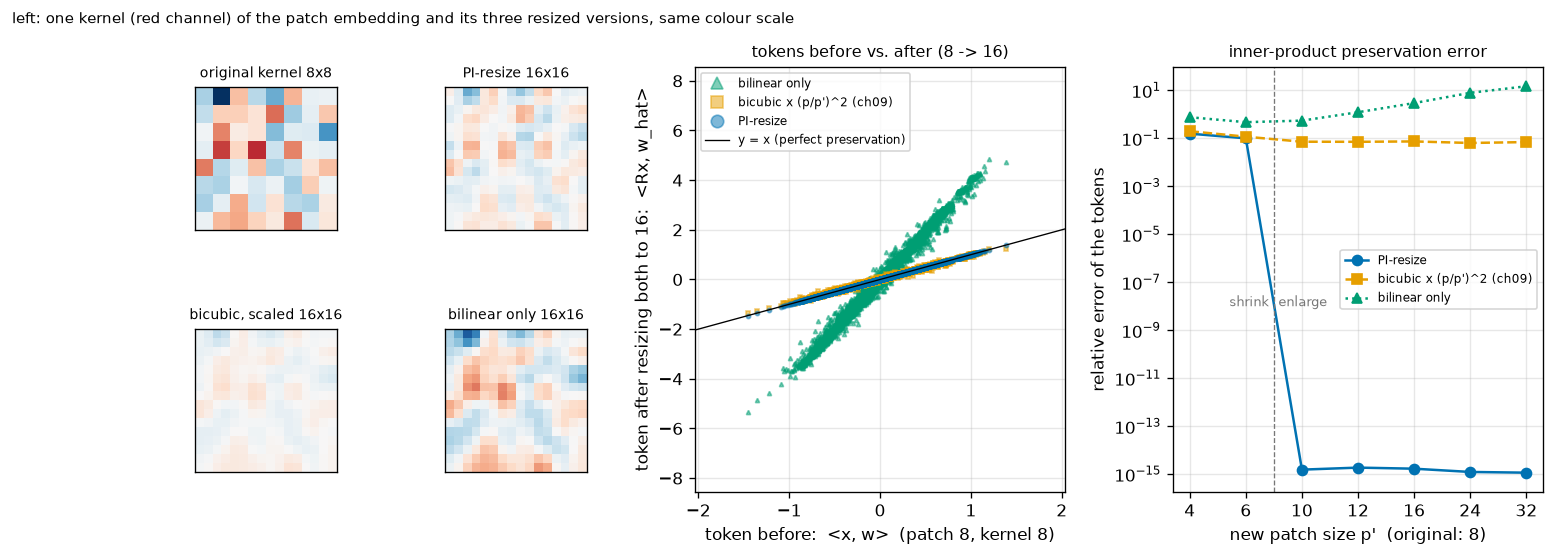
출력과 그림 12-4 에서 읽을 것이다.
- 키울 때 PI-resize 의 오차는 \(10^{-15}\) 수준이다. 64비트 부동소수의 반올림 오차일 뿐, 유도한 대로 정확히 같다. 가운데 그림에서 파란 점이 검은 선 위에 그대로 놓인다.
- 쌍선형 보간만 하면 토큰이 커진다. 8 → 16 에서 크기의 비가 3.94 로, 앞에서 어림한 “약 4배” 그대로이다(8 → 32 는 15.8, 약 16배). 가운데 그림의 초록 점이 검은 선보다 4배 가파른 직선을 이룬다. 왼쪽 그림에서도 쌍선형 판은 원래 커널과 색의 세기가 비슷한데, 칸 수가 4배이므로 합이 4배쯤 된다.
- 9장의 단순 판은 크기는 맞추지만 값이 7% 쯤 어긋난다. \((p/p')^2\) 을 곱해 크기의 비는 0.99 로 맞췄지만 상대 오차가 0.07 남는다. 손계산 예의 13.25 와 14 의 차이와 같은 종류이다.
- 줄일 때는 PI-resize 도 정확하지 않다. 8 → 6 에서 0.10, 8 → 4 에서 0.16 이다. 정보가 사라지므로 어떤 방법도 정확할 수 없고, 그 가운데서는 PI-resize 의 오차가 가장 작다.
- 왼쪽 그림의 PI-resize 커널과 단순 판의 커널은 옅다. 칸이 4배로 늘어난 만큼 칸마다의 값이 작아졌기 때문이다. PI-resize 커널에는 단순 판에 없는 잔무늬가 보이는데, 내적을 정확히 맞추려고 들어간 성분이다.
토큰이 같으면 모델의 출력도 같을까? FlexiViT 논문의 그림 4 는 학습이 끝난 ViT 에서 그림과 패치를 같은 배율로 키워 가며 정확도를 재어, 키울 때 정확도를 지키는 것은 PI-resize 뿐이었다고 보고한다. 같은 실험을 11장의 미니 RF-DETR 로 해 봤다. 이 모델은 해상도 96 · 패치 8 로만 학습했고 다른 패치 크기를 본 적이 없다. 그림과 패치를 함께 키우면 토큰 격자는 12×12 그대로이다.
[PI-resize] 11장 모델(해상도 96 · 패치 8 로만 학습)에서 그림과 패치를 같은 배율로 키운다. 원래 AP 0.9345
  해상도 / 패치 (격자) | PI-resize                   | bicubic x (p/p')^2 (ch09)   | bilinear only
   120 / 10 (12×12)     | AP 0.9348                   | AP 0.9347                   | AP 0.8585
   144 / 12 (12×12)     | AP 0.9352                   | AP 0.9344                   | AP 0.7579
   192 / 16 (12×12)     | AP 0.9351                   | AP 0.9348                   | AP 0.6315
- PI-resize 로는 AP 가 그대로이다(0.9345 → 0.9348 – 0.9352). 한 번도 본 적 없는 패치 크기 10 · 12 · 16 에서, 재학습 없이 그렇다. (그림 전체를 리사이즈하는 것과 패치마다 리사이즈하는 것은 패치의 가장자리에서 조금 달라서 토큰이 완전히 같지는 않다. 그 차이가 AP 로는 0.001 안쪽이다.)
- 쌍선형 보간만 하면 무너진다(0.8585 → 0.7579 → 0.6315). 배율이 커질수록, 곧 토큰이 학습 때보다 커질수록 더 나빠진다. FlexiViT 가 말한 “토큰 크기의 급격한 변화” 가 원인이라는 설명과 맞다.
- 9장의 단순 판도 AP 는 지킨다(0.9344 – 0.9348). 이 실험에서는 토큰의 7% 오차가 AP 에 영향을 주지 않았다. 정확한 변환과 어림 변환의 차이는 이 작은 모델 · 쉬운 데이터에서는 드러나지 않았고, 크기를 맞추는 것이 결정적이었다. 이 튜토리얼은 유도가 분명한 PI-resize 를 쓴다.
참고 · 논문과 공개 코드. RF-DETR 논문은 “FlexiViT 식 변환” 이라고만 적고 구체적인 식은 밝히지 않는다. 이 튜토리얼이 살펴본 공개 코드(rfdetr 패키지)는 패치 크기를 모델을 만들 때 정하며, 순전파마다 패치 크기를 바꾸는 NAS 학습 코드는 들어 있지 않았다. 여기서 만든 pi_resize_patch_embed 는 FlexiViT 논문의 식을 그대로 구현한 것이고, RF-DETR 의 내부 구현과 같은지는 확인하지 못했다.
패치 크기가 바뀌면 토큰 격자도 바뀌므로 위치 임베딩도 맞춰야 한다. 이것은 해상도 손잡이와 같은 문제라서 그 자리에서 함께 본다.
손잡이 둘: 디코더 층 수
디코더는 같은 모양의 층을 여러 번 쌓은 것이고, 층마다 질의 임베딩을 조금씩 다듬는다. 7장의 보조 손실을 떠올려 보자. DETR 계열은 마지막 층의 출력에만 손실을 걸지 않고 모든 층의 출력 에 같은 머리를 달아 같은 손실을 건다. 11장의 전체 손실이 그랬다.
\(\mathcal{L}(\theta; c) = \sum_{l=0}^{L} \mathcal{L}_{\text{det}}\big( \hat{y}^{(l)},\ y \big)\)
\(\hat{y}^{(l)}\) 는 디코더 \(l\) 번째 층까지만 지난 질의에 머리를 단 예측, \(y\) 는 정답, \(\mathcal{L}_{\text{det}}\) 는 매칭 뒤의 분류 + 박스 손실이다. \(l = 0\) 은 디코더에 들어가기 전의 인코더 제안이다(10장의 2단계 질의 선택). 미니 모델은 \(L = 3\) 이라 네 벌의 손실을 더했다.
보조 손실은 원래 깊은 디코더의 학습을 돕는 장치였다. 그런데 이 식을 다시 보면 다른 뜻이 읽힌다. 모든 \(l\) 에 대해 \(\hat{y}^{(l)}\) 가 그 자체로 좋은 예측이 되도록 학습했다 는 것이다. 그러면 추론 때 \(l\) 층에서 멈추고 그 출력을 답으로 써도 된다. \(l\) 층에서 멈춘 모델은 따로 학습한 적은 없지만, 학습 내내 손실을 받아 온 “이미 학습된 부분망” 이다.
그래서 이 손잡이에는 풀어야 할 묶임이 없다. 순전파를 일찍 끝낼 뿐이다. 10장의 점검에서 “디코더 \(k\) 층만 쓴 출력” 과 “전체 모델의 \(k\) 번째 보조 출력” 의 차이가 정확히 0 이었던 것이 이것이다. 논문은 이 생각이 RT-DETR 등에서 이미 쓰였다고 밝히고(층마다 독립적으로 감독하므로 추론 때 층을 잘라 낼 수 있다), 거기서 더 나아간다.
- 0층: 디코더를 전부 뗀다. 인코더 제안만 남는다. 질의끼리의 자기 어텐션도, 특징 맵을 읽는 교차 어텐션도 없으므로 크게 빨라진다. 논문은 이 모델이 “NMS 없는 YOLO 식 1단계 탐지기” 를 닮는다고 적는다. 특징 맵의 칸마다 점수와 박스를 내고 상위 몇 개를 고르는 것이 전부이기 때문이다.
- 마지막 층 하나를 뗀다. 논문(부록 B)은 지연 시간이 10% 줄고 mAP 가 2 내려간다고 보고한다.
- 분할에서는 효과가 더 크다. RF-DETR-Seg 는 디코더 층마다 마스크를 만들므로(13장), 디코더를 줄이면 분할 쪽 계산도 함께 줄어든다.
11장의 미니 실험에서는 디코더 0 · 1 · 2 · 3층의 AP 가 0.8928 · 0.9289 · 0.9332 · 0.9347 이었다. 첫 층이 대부분을 올리고 뒤로 갈수록 이득이 줄어든다. 이 수치는 이 장의 탐색에서 다시 만난다.
손잡이 셋: 질의 수
질의 수는 모델이 낼 수 있는 예측의 최대 개수이자 디코더의 일감이다. 디코더의 자기 어텐션은 질의 수의 제곱에, 교차 어텐션과 FFN 은 질의 수에 비례하는 계산을 한다. RF-DETR 은 질의 300개로 학습한다. 그런데 그림 한 장의 객체가 많아야 수십 개인 데이터라면 300개 가운데 대부분은 “객체 없음” 을 내려고 계산된다.
질의를 줄이려면 어느 질의를 버릴지 를 정해야 한다. 7장의 DETR 처럼 질의가 그림과 무관한 학습된 벡터라면 어느 것이 덜 중요한지 미리 알 수 없다. RF-DETR 은 2단계 질의 선택(8장, 10장)을 쓰므로 사정이 다르다. 질의의 출발점은 특징 맵의 모든 칸 가운데 클래스 점수가 높은 순으로 뽑은 상위 \(N\) 칸 이다. 이미 순위가 매겨져 있다.
- 질의를 줄이는 것 = 순위표를 위에서 자르는 것
- \(s_j = \max_k\ \sigma(z_{jk}), \qquad j = 1, \dots, HW\)
- 특징 맵의 칸 \(j\) 마다, 인코더 쪽 분류 머리가 낸 클래스 로짓 \(z_{jk}\) 의 시그모이드 가운데 가장 큰 값을 그 칸의 점수 \(s_j\) 로 삼는다. 논문의 표현으로는 “인코더 출력에서, 토큰마다의 클래스 로짓의 시그모이드 최댓값”. (시그모이드는 순서를 바꾸지 않으므로 로짓의 최댓값으로 순위를 매겨도 같다.)
- 점수가 큰 순서로 \(N\) 칸을 뽑는다. 학습 때는 \(N = 300\)(미니 모델은 12)이다.
topk는 점수의 내림차순으로 돌려준다.
- \(N'\) 개만 뽑은 것은 \(N\) 개를 뽑아 앞의 \(N'\) 개만 남긴 것과 같다. 곧 “점수가 낮은 질의부터 버리는 것” 이다. 질의 임베딩(
query_feat,refpoint_embed)도 순위에 맞춰 앞의 \(N'\) 줄만 쓴다.
버려지는 것은 인코더가 보기에 객체일 가능성이 가장 낮은 칸들이다. 그림에 객체가 5개 있다면 순위표의 위쪽 몇 줄에 그 객체들이 있을 것이고, 200위와 300위 사이를 잘라 내도 잃을 것이 거의 없다. 논문 부록 B(그림 4)는 Nano 에서 점수가 가장 낮은 질의 100개를 버려도 성능이 크게 줄지 않고 지연 시간은 조금 나아졌다고 보고한다.
주의할 점이 두 가지 있다.
- 남은 질의의 출력도 조금 달라진다. 디코더의 자기 어텐션에서 질의들은 서로를 본다. 상대가 줄면 결과도 달라진다(10장의 점검에서, 학습 전 가중치로 질의 12개를 6개로 줄였을 때 남은 질의의 로짓이 최대 0.298 달라졌다). 디코더 층을 떼는 것과 달리 “정확히 같은 출력의 일부” 가 아니다.
- 학습 때 본 적 없는 상황이다. 질의 수는 학습 때 바꾸지 않는다. 줄인 질의 수에서 잘 동작하는지는 실험으로 확인할 일이고, 논문과 이 장의 실험이 그것을 잰다.
논문은 이 손잡이의 뜻을 이렇게 읽는다. 파레토 최적인 질의 수는 데이터셋의 통계(그림 한 장에 객체가 평균 몇 개인가)를 암묵적으로 담는다는 것이다. 실제로 RF100-VL 에서 찾은 저지연 모델들은 같은 지연 시간의 COCO 모델보다 질의 수가 적었고, 논문은 그 이유를 RF100-VL 의 그림당 객체 수가 COCO 보다 적기 때문으로 본다(부록 L).
참고 · 14장의 num_select 와 다르다. 14장에서 바꿔 본 num_select 는 후처리가 남기는 예측의 수이다. 디코더는 여전히 질의 300개를 모두 계산하므로 신경망의 계산량은 줄지 않는다. 이 장의 질의 수 손잡이는 디코더에 들어가는 질의 자체 를 줄인다.
손잡이 넷: 입력 해상도
해상도를 올리면 작은 객체가 더 많은 픽셀로 보이고, 내리면 토큰이 줄어 빨라진다. 패치 크기와 반대 방향으로 같은 식 \(N = (H/p)^2\) 을 움직이는 손잡이이다. ViT 블록의 가중치는 토큰 수와 무관하다(어텐션은 토큰이 몇 개든 같은 행렬로 계산한다. 5장). 그림 크기에 묶인 가중치는 6장에서 본 대로 둘뿐이다.
- 패치 임베딩: 해상도와는 무관하다(패치 크기에만 묶여 있다).
- 위치 임베딩: 토큰 격자의 칸마다 벡터가 하나씩 있으므로 격자 크기 \(g \times g\) 에 묶여 있다.
위치 임베딩은 6장에서 본 방법으로 푼다. 2차원 격자로 되돌려 필요한 크기로 보간한다. 논문의 방식은 가장 큰 격자를 기준으로 저장 하는 것이다. “가장 큰 해상도를 가장 작은 패치 크기로 나눈 것에 해당하는 \(N\) 개의 위치 임베딩을 미리 두고, 더 작은 해상도나 더 큰 패치에는 그것을 보간한다.” 논문의 학습 격자(해상도 최대 960, 패치 최소 8)로 계산하면 한 변 \(960 / 8 = 120\) 칸이다. 이 장의 미니 실험은 \(128 / 8 = 16\) 칸으로 둔다. 큰 격자를 저장해 두고 줄여 쓰면 늘 “있는 정보를 줄이는” 방향이라, 작은 격자를 늘려 쓰는 것보다 잃는 것이 적다.
백본 뒤쪽은 어떨까? 프로젝터는 합성곱이라 특징 맵의 크기와 무관하게 동작한다. 2단계 질의 선택은 칸마다 같은 머리를 적용하므로 칸이 몇 개든 된다. 변형 어텐션은 정규화 좌표 로 특징 맵을 읽으므로 맵의 크기가 달라져도 같은 식이다(8장). 그리고 박스 머리가 내는 값도 정규화 좌표이다. 2장에서 박스를 그림 크기에 대한 비율로 적기로 한 것이 여기서 값을 한다. 그림을 64 로 줄이든 128 로 키우든 정답 박스 \((c_x, c_y, w, h)\) 는 숫자 하나 바뀌지 않고, 머리는 해상도를 몰라도 된다.
해상도는 LW-DETR 에서도 바뀌었다. 다만 그때는 학습을 돕는 데이터 증강(다중 스케일 학습)이었고, 추론은 정해진 해상도 하나로 했다. RF-DETR 은 같은 것을 손잡이로 승격시켰다. 논문 부록 A 의 표현으로는 “우리는 해상도를 NAS 탐색 공간의 조절 가능한 손잡이로 넣었고, LW-DETR 은 데이터 증강의 한 형태로 썼다.” 학습 때의 처리도 조금 다르다. LW-DETR 은 그림마다 크기를 바꾸고 배치에서 가장 큰 그림에 맞춰 나머지를 채웠는데, RF-DETR 은 배치 단위로 크기를 바꾼다. 채운 영역에 낭비되는 계산이 없고, 모든 위치 임베딩 해상도가 학습 때 고르게 나타난다.
손잡이 다섯: 윈도 수
9장의 윈도 어텐션은 토큰 격자를 \(W \times W\) 개의 윈도로 나누고, 윈도 블록에서는 같은 윈도 안의 토큰끼리만 어텐션을 한다(\(W\) 는 한 변의 윈도 수). 전역 블록에서는 모든 토큰이 서로 본다. 9장에서 확인한 대로 윈도 어텐션에는 전용 가중치가 없다. 토큰을 윈도 단위로 다시 늘어놓아 배치 축으로 넘기는 것이 전부이고, 어텐션 계산 자체는 같은 블록의 같은 가중치가 한다. 그래서 윈도 수를 바꾸는 데에는 풀어야 할 묶임이 없다. 묶는 방식만 바꾸면 된다.
윈도를 늘리면 무엇을 얻고 무엇을 잃는지 쌍의 수로 세어 본다. 미니 모델의 기본 격자(\(g = 12\), \(N = 144\))에서 윈도 블록 4개 · 전역 블록 2개이다. DINOv2 백본은 CLS 토큰이 필요하므로 RF-DETR 은 윈도마다 CLS 토큰을 하나씩 복제 해 붙인다. 윈도 하나의 토큰 수는 \(N/W^2 + 1\) 이다.
- 손계산: 윈도 수에 따른 어텐션 쌍의 수 (격자 12×12)
- \(\text{윈도 블록 하나: } \ W^2 \left( \frac{N}{W^2} + 1 \right)^2, \qquad \text{전역 블록 하나: } \ \left( N + W^2 \right)^2\)
- 윈도 블록은 윈도 \(W^2\) 개가 저마다 자기 토큰끼리 쌍을 만든다. 전역 블록은 모든 패치 토큰 \(N\) 개와 CLS 토큰 \(W^2\) 개가 한 줄이 되어 서로 본다.
- 윈도가 하나면 윈도 블록과 전역 블록이 같다. 여섯 블록 합계는 \(6 \times 21{,}025 = 126{,}150\) 쌍.
- 윈도 하나에 \(36 + 1 = 37\) 토큰. 합계는 \(4 \times 5{,}476 + 2 \times 21{,}904 = 21{,}904 + 43{,}808 = 65{,}712\) 쌍. \(W = 1\) 의 52% 이다.
- 윈도 하나에 \(9 + 1 = 10\) 토큰. 윈도 블록은 더 싸졌지만 전역 블록은 CLS 토큰이 16개로 늘어 오히려 비싸졌다. 합계는 \(W = 2\) 의 88% 로, 1 → 2 에서 절반으로 줄던 것에 비하면 이득이 작다.
윈도를 늘릴수록 이득은 빠르게 줄어들고, 복제된 CLS 토큰이라는 비용은 늘어난다. 정확도 쪽에서는 윈도 블록에서 멀리 있는 토큰끼리 정보를 주고받지 못하게 된다. 논문 부록 L 의 관찰이 이것과 맞다. 파레토 최적인 RF-DETR 모델은 대부분 윈도 2 를 썼다(LW-DETR 은 4 가 최적이었다). 논문은 그 차이를 CLS 토큰으로 설명한다. LW-DETR 의 CAEv2 백본은 CLS 토큰이 없지만 DINOv2 는 사전 학습의 핵심으로 CLS 토큰을 쓰고, 윈도마다 CLS 를 복제해야 하므로 윈도가 많을수록 실행 효율이 떨어진다는 것이다. 전역 블록에서는 윈도마다의 CLS 토큰끼리도 서로 보고, 다른 토큰들은 모든 CLS 토큰을 본다.
학습 때 바꾸는 것과 추론 때만 바꾸는 것
다섯 손잡이는 두 무리로 나뉜다. 논문 부록 A 는 “디코더 층과 질의는 추론 때만 줄인다” 고 분명히 적는다.
- 학습 때부터 바꾸는 것: 해상도, 패치 크기, 윈도 수. 이 셋은 백본에 들어가는 입력의 모양을 바꾼다. 가중치가 여러 모양의 입력을 겪어 봐야 하므로 스텝마다 무작위로 바꾼다.
- 추론 때만 바꾸는 것: 디코더 층 수, 질의 수. 학습은 늘 가장 큰 설정(6층, 질의 300개)으로 한다. 층은 보조 손실 덕분에, 질의는 점수 순위 덕분에 추론 때 줄일 수 있다.
논문 부록 A 의 격자는 다음과 같다.
| 손잡이 | 학습 때 뽑는 값 | 탐색(추론) 때 훑는 값 |
| 해상도 | 320, 384, 448, 512, 576, 640, 704, 768, 832, 896, 960 (11개, 64 간격) | |
| 패치 크기 | 8, 10, 12, 16, 20, 24, 32 (7개) | 8, 10, 12, 14, 16, 20, 24, 32 (8개) |
| 디코더 층 수 | 6 | 0, 1, 2, 3, 4, 5, 6 (7개) |
| 윈도 수 | 1, 2, 4 | |
| 질의 수 | 300 | 50, 100, 200, 300 (4개) |
논문은 탐색에서 6,468개 구성을 평가했다고 적고, 그 수를 이렇게 푼다: 해상도 11 × 패치 크기 7 × 디코더 층 7 × 윈도 3 × 질의 4.
- 구성의 수 세기
- \(11 \times 7 = 77, \qquad 77 \times 7 = 539, \qquad 539 \times 3 = 1{,}617, \qquad 1{,}617 \times 4 = 6{,}468\)
- 손잡이가 서로 독립이면 조합의 수는 각 손잡이의 값의 수를 곱한 것이다. 논문의 숫자와 맞다.
- 그런데 같은 부록의 추론 격자에는 패치 크기가 14 를 포함해 8개 적혀 있다. 8개로 세면 7,392 이다. 논문의 6,468 은 패치 크기를 7개로 센 값이고, 이 불일치를 논문은 설명하지 않는다. 여기서는 논문의 표기를 그대로 옮기고 두 사실을 함께 적어 둔다.
- 학습 때는 디코더 층과 질의가 고정이므로 뽑는 것은 (해상도, 패치, 윈도) 의 조합이다. 탐색 때의 6,468 은 여기에 디코더 층 7가지와 질의 4가지를 곱한 것이다(\(231 \times 28 = 6{,}468\)).
패치 크기 14 는 흥미로운 값이다. DINOv2 가 사전 학습된 패치 크기가 14 인데(6장), 학습 격자에는 14 가 없다. 표 5 의 설명도 “패치 크기 14 는 NAS 탐색 공간에 없다” 고 적는다. 그런데도 그 구성의 성능이 NAS 학습으로 올랐다는 것이 앞에서 본 구조 증강의 근거였다.
또 하나, 이 수는 나누어떨어짐을 따지지 않은 곱이다. 예를 들어 해상도 320 은 패치 12 로 나누어떨어지지 않는다. 그런 조합을 논문이 어떻게 처리했는지(해상도를 가까운 배수로 맞췄는지 등)는 적혀 있지 않다. 이 장의 미니 실험에서는 나누어떨어지지 않는 조합을 탐색 공간에서 뺀다.
비용에 대해 논문이 적은 것은 두 가지이다.
- 학습 시간: NAS 없는 기준의 약 2 – 4배(데이터셋에 따라). 대신 그 한 번의 학습에서 모든 크기가 나온다. NAS 를 쓰지 않으면 크기마다 다시 학습해야 한다.
- 탐색 시간: 약 10,000 GPU 시간으로 추정(T4 GPU 200대 × 48시간 = 9,600 GPU 시간).
논문이 찾은 구조 읽기
파레토 위의 구성들
COCO 에서 찾은 파레토 최적 구성이 논문의 표 7(탐지)과 표 8(분할)이다. 마지막 열 “격자” 는 해상도를 패치 크기로 나눈 값으로, 이 튜토리얼이 계산해 덧붙인 것이다.
| 탐지 (표 7) | 해상도 | 패치 | 윈도 | 디코더 층 | 질의 | 백본 | 격자 (해상도 ÷ 패치) |
| N | 384 | 16 | 2 | 2 | 300 | DINOv2-S | 24 |
| S | 512 | 16 | 2 | 3 | 300 | DINOv2-S | 32 |
| M | 576 | 16 | 2 | 4 | 300 | DINOv2-S | 36 |
| L | 704 | 16 | 2 | 4 | 300 | DINOv2-S | 44 |
| XL | 700 | 20 | 1 | 5 | 300 | DINOv2-B | 35 |
| 2XL | 880 | 20 | 2 | 5 | 300 | DINOv2-B | 44 |
| Max | 828 | 12 | 1 | 6 | 300 | DINOv2-B | 69 |
| 분할 (표 8) | 해상도 | 패치 | 윈도 | 디코더 층 | 질의 | 백본 | 격자 (해상도 ÷ 패치) |
| N | 312 | 12 | 1 | 4 | 100 | DINOv2-S | 26 |
| S | 384 | 12 | 2 | 4 | 100 | DINOv2-S | 32 |
| M | 432 | 12 | 2 | 5 | 200 | DINOv2-S | 36 |
| L | 504 | 12 | 2 | 5 | 300 | DINOv2-S | 42 |
| XL | 624 | 12 | 2 | 6 | 300 | DINOv2-S | 52 |
| 2XL | 768 | 12 | 2 | 6 | 300 | DINOv2-S | 64 |
| Max | 890 | 10 | 1 | 6 | 300 | DINOv2-S | 89 |
표에서 읽을 수 있는 것을 논문 부록 L 의 관찰과 함께 정리한다.
- 모든 손잡이가 쓰였다. 파레토 최적 가족을 이루는 데 다섯 손잡이가 모두 다른 값을 가진다. 논문은 이것이 탐색 공간이 쓸모 있게 정해졌다는 뜻이고, 탐색 공간을 넓히면 더 나아질 수도 있음을 시사한다고 적는다.
- 패치 크기는 가족 안에서 일정하다. DINOv2-S 백본의 탐지 모델은 16, DINOv2-B 백본은 20, 분할 모델은 12 이다.
- 가족 안에서는 주로 해상도로 크기를 키운다. 탐지 N → L 은 해상도가 384 → 704 로 커지고(격자 24 → 44) 디코더가 2 → 4 층으로 늘어난다. 인코더 쪽 계산(패치 · 윈도 · 해상도)과 디코더 쪽 계산(층 · 질의)이 함께 커진다.
- 윈도는 대개 2 이다. 앞 절에서 본 CLS 토큰 복제의 비용과 맞는 관찰이다.
- 탐지는 질의를 300 으로 두고 디코더 깊이를 키우고, 분할은 둘을 함께 움직인다. 분할의 N · S 는 질의 100개에 디코더 4층이다. 논문은 분할 머리가 제 구실을 하려면 디코더가 어느 정도 깊어야 하고, 그 지연 시간을 질의 수를 줄여 메운 것으로 해석한다(“얇고 깊은 디코더”, 탐지는 “넓고 얕은 디코더”).
- XL 의 해상도 700, Max 의 828 · 890 은 부록 A 의 격자(64 간격)에 없는 값이다. 표 7 · 8 의 구성이 그 격자에서만 나온 것은 아닌 셈인데, 논문은 이 값들이 어떻게 정해졌는지 따로 설명하지 않는다.
공간 위치 수가 성능을 좌우한다
부록 L 의 가장 쓸모 있는 관찰은 이것이다. RF-DETR 의 성능은 해상도나 패치 크기 각각보다 둘의 비, 곧 공간 위치 수(number of spatial locations)(한 변의 토큰 수 \(g = H/p\))와 더 상관이 깊다. 논문의 설명은 6장에서 본 그대로이다. 패치로 잘라 투영하고 나면 ViT 는 원래 그림이 몇 픽셀이었는지 모른다. 블록들이 보는 것은 \(g \times g\) 개의 토큰뿐이다.
논문은 이것을 확인하려고 해상도를 640 으로 고정하고 패치 크기만 바꾼 모델 가족을 따로 만들었다. Nano 에 패치 27, Small 에 패치 21, Medium 에 패치 18 이다. 격자를 계산해 보면 \(640/27 \approx 23.7\), \(640/21 \approx 30.5\), \(640/18 \approx 35.6\) 으로, 원래 가족의 24 · 32 · 36 에 가깝다(나누어떨어지지 않는 값을 어떻게 처리했는지는 논문에 없다). 결과는 원래의 파레토 최적 가족과 “거의 같았다” 고 한다. 게다가 패치 27 과 18 은 학습 때 한 번도 보지 않은 값이다.
분할에서는 이 관찰이 성립하지 않았다. 분할 특징은 늘 입력 해상도의 1/4 크기로 만들어지기 때문이다(13장). 해상도를 올리면 공간 위치 수와 함께 마스크의 세밀함도 올라가지만, 패치만 키우면 공간 위치 수는 같아도 마스크 특징의 해상도가 달라진다. 손잡이 둘이 더는 한 가지 효과로 묶이지 않는다.
손잡이를 하나씩 돌린 표
논문의 표 5 는 LW-DETR (M) 에서 출발해 RF-DETR (M) 에 이르는 길을 한 줄씩 보여 준다. NAS 와 관련된 뒤쪽 줄만 옮기면 다음과 같다(COCO, T4 지연 시간).
| 단계 | GFLOPs | 지연 시간 (ms) | AP | 읽는 법 |
| (NAS 전) + Objects365 추가 사전 학습 | 78.2 | 4.7 | 54.3 | 출발점. 패치 14, 해상도 560 |
| + 가중치 공유 NAS 로 학습 | 78.2 | 4.7 | 54.6 | 구성은 그대로인데 +0.3 (구조 증강) |
| 패치 14 → 16, 해상도 560 → 640 | 78.5 | 4.7 | 54.4 | 격자 40 → 40. 거의 그대로 |
| 해상도 640 → 576 | 64.2 | 4.0 | 53.6 | 격자 40 → 36. 빨라지고 −0.8 |
| 윈도 4 → 2 | 63.7 | 4.3 | 54.3 | +0.7, 지연 +0.3 ms |
| 디코더 3 → 4층 | 64.8 | 4.4 | 54.6 | +0.3, 지연 +0.1 ms |
| 질의 300 → 300 | 64.8 | 4.4 | 54.6 | 변화 없음. 표 7 의 M 과 같은 구성 |
이 표는 손잡이의 쓰임새를 잘 보여 준다. 해상도를 낮춰 0.7 ms 를 벌고(−0.8 AP), 그 여유의 일부를 윈도와 디코더 층에 다시 써서 AP 를 되찾는다(+1.0 AP, +0.4 ms). 결과적으로 출발점과 같은 AP 54.6 을 0.3 ms 빠르게(4.7 → 4.4 ms) 얻었다. 손잡이 하나만 돌려서는 갈 수 없는 자리이다. 셋째 줄도 눈여겨볼 만하다. 패치와 해상도를 함께 바꿔 격자를 40 으로 유지하면 AP 와 지연 시간이 거의 그대로이다. 공간 위치 수의 관찰과 같은 이야기이다.
못 본 구성과 미세 조정
학습 때 못 본 구성(부록 F). 논문의 그림 5 는 해상도와 패치 크기를 하나씩 바꿔 가며 성능을 그린 것인데, 학습 때 본 값과 못 본 값을 다른 표시로 찍었다. 못 본 구성들이 본 구성들이 이루는 추세선을 그대로 따라간다. 논문은 이것을 “RF-DETR 이 학습 때 만난 구성 너머로 일반화한다” 는 근거로 든다. 앞 절의 패치 27 · 18 도 같은 종류의 증거이다. 탐색 공간이 띄엄띄엄한 격자가 아니라 그 사이를 매끄럽게 메우는 연속체 처럼 동작한다는 뜻이므로, 실용적으로 중요하다.
NAS 뒤의 미세 조정(부록 G). 파레토 위의 구성 하나를 골랐다면, 그 구성으로 고정해 조금 더 학습하면 더 좋아지지 않을까? 가중치가 더는 다른 구성에 양보할 필요가 없으니 그럴 법하다. 논문의 답은 “COCO 에서는 이득이 거의 없다” 이다. 표 15 의 AP 변화는 다음과 같다.
| 크기 | N | S | M | L | XL | 2XL |
| NAS 그대로 (COCO AP) | 48.0 | 52.9 | 54.7 | 56.5 | 58.6 | 60.1 |
| 미세 조정 뒤의 변화 | +0.4 | +0.1 | +0.0 | +0.0 | +0.3 | +0.1 |
논문의 해석은 이렇다. 구조 증강이 강한 정규화로 작용했는데, 미세 조정에서 그 정규화를 걷어 내면 과적합 쪽으로 기울어 이득이 사라진다는 것이다. OFA 도 비슷한 관찰을 보고했다고 논문은 적는다. 반면 RF100-VL 에서는 미세 조정이 조금 도움이 됐다(표 4: N 57.8 → 58.6, S 60.9 → 61.2, M 61.7 → 62.0, 2XL 63.3 → 63.5). 논문은 작은 데이터셋에서는 구조 증강이라는 정규화가 수렴하는 데 100 에폭보다 더 걸리기 때문일 것이라고 추측한다. 그래서 미세 조정은 “선택 사항이고 실제 배치에서는 대개 필요 없다” 는 것이 논문의 입장이다.
데이터셋마다 다른 답
데이터셋의 특성과 손잡이(부록 H). 논문은 RF100-VL 의 100개 데이터셋마다 Medium 크기의 최적 구성을 찾고, 데이터셋의 특성과 손잡이 값 사이의 관계를 직선으로 맞춰 봤다(표 17). 결정계수 \(R^2\) 가 눈에 띄는 것은 둘이다. 공간 위치 수와 윈도 수(\(R^2 = 0.492\)), 평균 객체 크기와 공간 위치 수(\(R^2 = 0.148\), 기울기가 음수: 객체가 작을수록 공간 위치가 많이 필요). 나머지는 약하다. 예를 들어 그림당 객체 수와 질의 수는 \(R^2 = 0.019\), 클래스 수와 디코더 층 수는 \(R^2 = 0.026\) 이다. 부록의 본문은 이 가운데 몇 쌍에 “강한 상관” 이 있다고 적지만, 같은 부록의 그림 6 설명은 “데이터셋의 특성은 구조 선택에 완만한 영향만 주며 … 뚜렷한 결정적 관계는 없다” 고 정리한다. 표의 수치와 맞는 것은 뒤쪽이다. 데이터셋의 통계 몇 개로 최적 구성을 미리 알아맞히기는 어렵고, 그래서 탐색이 필요하다 는 것이 이 부록에서 가져갈 결론이다.
COCO 에서 찾은 구조를 그대로 쓰면(부록 I). 그렇다면 COCO 에서 찾은 구성(표 7)을 다른 데이터에 그대로 가져가도 될까? 표 18 이 RF100-VL 에서 둘을 견준다(AP).
| 크기 | N | S | M | L | XL | 2XL |
| COCO 의 구성을 그대로 (고정 구조) | 57.7 | 60.2 | 61.2 | 62.2 | 62.9 | 63.2 |
| RF100-VL 에서 NAS | 57.8 | 60.9 | 61.7 | 62.0 | 62.6 | 63.3 |
| NAS + 미세 조정 | 58.6 | 61.2 | 62.0 | 62.3 | 63.0 | 63.5 |
고정 구조만으로도 이미 강하다(논문: “데이터셋별 NAS 없이도 놀랄 만큼 잘 동작한다”). 데이터셋별 NAS 는 N · S · M 에서 0.1 – 0.7 AP 를 더했고, L 과 XL 에서는 AP 만 보면 고정 구조가 조금 높다 (다만 지연 시간이 다르다. 표 18 에서 L 은 고정 구조 6.8 ms 대 NAS 6.2 ms 이다). 쓰는 사람의 관점에서는 이렇게 정리할 수 있다. 공개된 N · S · M · L 을 그대로 써도 손해가 크지 않고, 내 데이터에서 NAS 를 돌리면 조금 더 얻을 여지가 있다.
지연 시간을 제대로 재기
파레토 곡선의 세로축(AP)은 3장에서 정확히 정의했다. 가로축은 어떨까? RF-DETR 논문의 세 번째 기여는 “지연 시간을 재는 방법이 논문마다 달라서 숫자를 믿기 어렵다” 는 문제 제기와 표준화한 절차이다. NAS 는 수천 개의 구성을 지연 시간으로 줄 세우는 일이므로, 자가 흔들리면 결과 전체가 흔들린다. 실제 RF-DETR 모델을 여러 실행 환경에서 재 보는 실습은 14장에 있고, 여기서는 원리와 논문의 절차, 그리고 이 장의 탐색에 쓸 측정 함수를 다룬다.
무엇이 측정을 흔드는가
논문은 재현이 안 되는 예로 이런 사례를 든다. D-FINE 논문이 다시 잰 LW-DETR 의 지연 시간은 LW-DETR 논문이 보고한 값보다 25% 빨랐다. 새 논문마다 앞선 모델들을 자기 장비에서 다시 재는데, 그 값이 서로 맞지 않는다. 논문이 찾은 주된 원인은 GPU 의 전력 제한(power throttling)이다. 순전파를 쉬지 않고 돌리면 GPU 가 전력 · 발열 한도에 닿아 스스로 속도를 낮추고, 얼마나 낮추는지는 그때그때 다르다.
논문의 처방은 단순하다. 순전파 사이에 200 ms 를 쉰다(논문은 buffering 이라고 부른다). GPU 가 한도에 닿지 않게 해서 “한 번의 순전파가 방해 없이 끝나는 데 걸리는 시간” 을 잰다. 부록 K 의 표 20 은 쉬는 시간을 0 · 200 · 400 · 800 ms 로 바꿔 가며 잰 결과이다(T4, TensorRT, FP16).
| 모델 | 쉬지 않음 | 200 ms | 400 ms | 800 ms |
| YOLOv8 (M) | 5.5 ms | 5.4 ms | 5.4 ms | 5.4 ms |
| YOLOv11 (M) | 5.0 ms | 5.0 ms | 5.1 ms | 5.1 ms |
| RT-DETR (R18) | 4.4 ms | 4.4 ms | 4.4 ms | 4.4 ms |
| LW-DETR (M) | 4.5 ms | 4.3 ms | 4.3 ms | 4.3 ms |
| D-FINE (M) | 5.7 ms | 5.4 ms | 5.4 ms | 5.4 ms |
| RF-DETR (M) | 4.7 ms | 4.4 ms | 4.4 ms | 4.4 ms |
표에서 읽을 것은 두 가지이다.
- 쉬지 않으면 순서가 바뀔 수 있다. 200 ms 를 쉬면 RT-DETR · RF-DETR 이 똑같이 4.4 ms 인데, 쉬지 않으면 4.4 와 4.7 ms 이다. 0.3 ms 는 표 5 에서 손잡이 하나를 돌려 얻는 차이와 같은 크기이다.
- 200 ms 면 충분하다. 그보다 길게 쉬어도 값이 달라지지 않는다.
논문은 이 방식의 한계도 적는다. 순전파마다 200 ms 를 쉬면 측정 자체가 훨씬 오래 걸리고(이 문제의 다른 해법은 앞으로의 과제라고 한다), 이 절차는 쉬지 않고 돌릴 때의 처리량 을 재는 것이 아니라 재현되는 지연 시간 을 얻기 위한 것이다. 또 TensorRT 가 모델을 컴파일하는 과정이 실행할 때마다 조금씩 달라서 같은 모델의 지연 시간이 최대 0.1 ms 까지 흔들린다. 그래서 논문의 표는 지연 시간을 소수 첫째 자리까지만 적는다.
같은 산출물로 정확도와 지연 시간을
논문이 짚는 나머지 함정은 “무엇을 쟀는가” 에 관한 것이다.
- 정확도와 지연 시간을 다른 모델로 재기. 지연 시간은 FP16 으로 바꾼 TensorRT 엔진으로 재고, 정확도는 원래의 FP32 모델로 재어 한 표에 적는 관행이다. FP16 으로 바꾸면 정확도가 달라질 수 있다. 논문의 표 1 에서 YOLOv8 (M) 의 AP 는 보고된 50.2 에서 FP32 엔진 49.3, FP16 엔진 47.3 으로 내려갔고, D-FINE (M) 은 공개된 내보내기 코드 그대로 FP16 으로 바꾸면 AP 가 0.5 로 무너졌다(논문은 ONNX opset 17 로 바꿔 고쳤다. 고친 뒤 55.0). 처방은 정확도와 지연 시간을 같은 산출물(같은 엔진 파일)로 재어 보고하는 것 이다.
- NMS 를 빼고 재기. YOLO 계열은 신경망 뒤에 NMS(3장)가 있어야 결과가 나오는데, 지연 시간에서 그 시간을 빼는 경우가 많다. DETR 계열은 NMS 가 없으므로 이렇게 견주면 공정하지 않다.
- FP32 와 FP16 의 차이는 크다. 같은 표 1 에서 RF-DETR (M) 은 FP32 엔진으로 20.5 ms, FP16 엔진으로 4.4 ms 이다. 숫자 옆에 어느 정밀도인지 적혀 있지 않으면 견줄 수 없다.
논문은 여기에 TensorRT 의 CUDA graphs 를 켠다. 보통은 CPU 가 GPU 연산(커널)을 하나씩 차례로 내보내는데, CUDA graphs 는 필요한 커널을 미리 한꺼번에 줄 세워 둔다. 논문은 RT-DETR · LW-DETR · RF-DETR 이 이 최적화로 빨라졌고 D-FINE 은 그렇지 않았다고 보고한다. “CPU 가 연산을 하나씩 내보내는 비용” 이 지연 시간의 적지 않은 몫일 수 있다는 뜻인데, 이 장의 실험에서 바로 그 현상을 만나게 된다.
참고 · 모델을 크기로 묶는 기준. 논문은 LW-DETR 을 따라 지연 시간이 비슷한 모델끼리 같은 크기(N, S, M …)로 묶는다. 매개변수 수로 묶지 않는다. RF-DETR 의 N · S · M · L 은 매개변수가 30.5M – 33.9M 으로 거의 같지만 지연 시간은 2.3 – 6.8 ms 로 세 배 차이가 난다(논문 표 2, 표 12). 같은 가중치를 다른 해상도 · 다른 깊이로 돌리는 가족이기 때문이다.
GPU 에서 시간을 재는 기본기
전력 제한을 따지기 전에 지켜야 할 기본이 있다. 이 장의 측정 함수는 다음과 같다.
code/ch12_nas.py · timer
def time_once(fn, device) -> float:
    """fn() 한 번에 걸린 시간 (ms). GPU 는 일을 맡기고 바로 돌아오므로, 시계를 보기 전후에 끝나기를 기다린다."""
    if device == "cuda":
        torch.cuda.synchronize()  # 앞서 맡긴 일이 끝날 때까지 기다린다 (없으면 그 일의 시간이 섞인다)
    start = time.perf_counter()
    fn()
    if device == "cuda":
        torch.cuda.synchronize()  # fn 이 맡긴 일이 끝날 때까지 기다린다 (없으면 "맡기는 시간" 만 잰다)
    return (time.perf_counter() - start) * 1e3

@torch.no_grad()
def measure_interleaved(fns: dict, device, rounds: int = 10, reps: int = 3, warmup_rounds: int = 1, sleep: float = 0.0,
                        seed: int = 0) -> dict:
    """여러 구성의 시간을 번갈아 잰다. fns: {이름: 인자 없는 함수}.  돌려주는 값: {이름: 잰 시간들 (ms) 의 배열}.

    한 라운드 = 모든 구성을 (무작위 순서로) reps 번씩. 처음 warmup_rounds 라운드는 버린다 (예열).
    구성 A 를 다 잰 뒤 B 를 재면 "그때 GPU 가 바빴는가 · 뜨거웠는가" 가 A 와 B 의 차이에 섞인다.
    번갈아 재면 그런 변화가 모든 구성에 고르게 묻는다. 대푯값은 부르는 쪽이 고른다: 보통은 중앙값 (평균은 가끔 튀는 값에
    끌려간다), 기계의 상태가 빠른 상태와 느린 상태를 오가는 경우에는 최솟값 (가장 방해를 덜 받은 측정).
    sleep: 순전파 사이에 쉬는 시간 (초). RF-DETR 논문의 처방은 0.2 초 (전력 제한을 피하려고).
    """
    rng = np.random.default_rng(seed)
    names = list(fns)
    times = {name: [] for name in names}
    for round_index in range(warmup_rounds + rounds):
        for i in rng.permutation(len(names)):
            for _ in range(reps):
                elapsed = time_once(fns[names[i]], device)
                if round_index >= warmup_rounds:
                    times[names[i]].append(elapsed)
                if sleep:
                    time.sleep(sleep)
    return {name: np.array(values) for name, values in times.items()}

def count_flops(model, images, **forward_kwargs) -> float:
    """순전파 한 번의 연산량 (FLOPs). PyTorch 의 FlopCounterMode 로 센다 (RF-DETR 논문 부록 C 가 쓴 도구).

    합성곱 · 선형 층 · 행렬 곱 · 어텐션의 곱셈 – 덧셈을 센다. 활성 함수 · 정규화의 일부 · 덧셈, 그리고 변형 어텐션의
    grid_sample(쌍선형 보간으로 읽기)은 세지 않는다. 그림 크기와 구성으로 정해지는 값이라 잴 때마다 같다.
    """
    from torch.utils.flop_counter import FlopCounterMode

    model.eval()
    with FlopCounterMode(display=False) as counter:  # (이 도구는 기울기 기록이 켜진 상태에서만 돈다)
        model(images, **forward_kwargs)
    return float(counter.get_total_flops())
- 동기화. PyTorch 의 GPU 연산은 일을 맡기고 바로 돌아온다.
torch.cuda.synchronize()로 GPU 가 일을 끝낼 때까지 기다린 뒤에 시계를 봐야 한다. 시작하기 전에도 한 번 기다려, 앞서 맡긴 일의 시간이 섞이지 않게 한다. - 예열. 프로세스에서 처음 부르는 순전파는 메모리를 잡고 연산의 구현을 고르느라 훨씬 느리다. 처음 몇 번은 버린다.
- 여러 번 재서 중앙값. 한 번의 값은 그 순간 다른 프로그램이 무엇을 했는지에 흔들린다. 평균은 가끔 튀는 큰 값에 끌려가므로 중앙값을 대푯값으로 쓴다.
- 배치 1. 지연 시간은 그림 한 장이 들어와 답이 나올 때까지의 시간이다.
- 견줄 구성들은 번갈아. 구성 A 를 다 잰 뒤 B 를 재면, 그 사이에 기계의 상태(다른 작업의 부하, GPU 의 온도)가 달라진 것이 A 와 B 의 차이로 둔갑한다. 모든 구성을 조금씩 번갈아 재면 그런 변화가 고르게 묻는다.
이 기본기가 실제로 얼마나 중요한지 숫자로 본다. 탐색을 실행하면(python ch12_nas.py --search) 본격적인 측정에 앞서 기본 구성 하나를 여러 방식으로 잰다. 재는 순간 GPU 를 쓰는 프로세스는 이것 하나뿐이었다.
[기계 상태] load average 7.7 (CPU 코어 16개), GPU 사용률 · 메모리 3 %, 919 MiB, GPU 를 쓰는 프로세스 1개 (이 프로세스 포함)
[시간 재기의 기본] 기본 구성, 장치 cuda. 방법들을 번갈아 잰다
  이 프로세스의 첫 순전파들 (ms): 1번째 1125.08, 2번째 6.97, 3번째 6.06, 10번째 5.88, 40번째 5.84
  배치 1, 동기화 없이 (틀린 방법)             200번: 중앙값   5.913 ms, 평균   5.368, 10% – 90% 분위수 3.077 – 6.037, 최대 25.331
  배치 1, 동기화하고                      200번: 중앙값   5.929 ms, 평균   5.356, 10% – 90% 분위수 3.099 – 6.057, 최대 22.124
  배치 1, 200 ms 쉰 직후                 50번: 중앙값  11.304 ms, 평균  11.487, 10% – 90% 분위수 9.638 – 12.031, 최대 28.488
  배치 1, 그 바로 다음 호출                  50번: 중앙값   7.624 ms, 평균   7.511, 10% – 90% 분위수 7.147 – 7.941, 최대 10.674
  배치 64 · 해상도 128, 동기화 없이           40번: 중앙값   6.158 ms, 평균   5.528, 10% – 90% 분위수 3.199 – 6.311, 최대 6.494
  배치 64 · 해상도 128, 동기화하고            40번: 중앙값  15.912 ms, 평균  16.600, 10% – 90% 분위수 15.263 – 17.071, 최대 37.071
  '배치 1, 동기화하고' 를 앞 · 뒤 절반으로 나눈 중앙값: 5.950 / 5.897 ms
  배치 1, 스레드를 성능 코어 하나(3번)에 묶고 100번: 중앙값   5.889 ms, 10% – 90% 분위수 3.097 – 5.999
  배치 1, 스레드를 효율 코어 하나(10번)에 묶고 100번: 중앙값  10.139 ms, 10% – 90% 분위수 4.487 – 10.263
- 첫 호출은 1,125 ms 이다. 둘째부터는 6 – 7 ms 이므로 첫 호출 하나가 200배 가까이 느리다. 이것을 평균에 넣으면 100번을 재도 평균이 세 배 가까이 된다.
- 배치 1 에서는 동기화를 빼먹어도 티가 나지 않았다(5.91 대 5.93 ms). 기대와 다른 결과이다. 이 작은 모델에서는 GPU 가 계산하는 속도보다 CPU 가 연산을 내보내는 속도가 느려, 함수가 돌아올 때쯤이면 GPU 의 일도 거의 끝나 있다(순전파 안에 결과를 CPU 로 가져와야 하는 연산도 섞여 있다).
- GPU 가 정말로 바쁜 일감에서는 2.6배 차이가 난다. 배치 64 · 해상도 128 의 순전파는 동기화 없이 6.2 ms, 동기화하면 15.9 ms 이다. 동기화 없이 잰 값은 “일을 맡기는 데 걸린 시간” 일 뿐이다. 큰 모델일수록 이 차이는 커진다. 빼먹어도 괜찮은 경우가 있다고 해서 빼먹어도 되는 것이 아니다.
- 같은 순전파의 시간이 두 무리로 갈린다. 동기화해서 잰 200번의 10% 분위수가 3.10 ms, 중앙값이 5.93 ms 이다. 값이 그 사이에 고르게 퍼진 것이 아니라 약 3.1 ms 와 약 5.9 ms 두 곳에 몰려 있다. 기계가 빠른 상태와 느린 상태(약 1.9배)를 몇 초마다 오간다.
- 200 ms 를 쉬면 오히려 느려진다. 쉰 직후의 순전파는 11.3 ms, 바로 이어진 호출도 7.6 ms 이다. 논문의 T4 에서는 쉬어야 전력 제한을 피할 수 있었지만, 이 노트북에서는 쉬는 사이에 장치가 절전 상태로 내려갔다가 다시 올라오는 데 시간이 걸리는 것으로 보인다. 14장에서 실제 RF-DETR 모델을 쟀을 때도 같은 일이 있었다. 200 ms 라는 처방은 그 하드웨어의 것이고, 보편적인 규칙이 아니다.
- 어느 CPU 코어에서 도느냐에 따라 달라진다. 이 노트북의 CPU 는 성능 코어와 효율 코어가 섞여 있다. 순전파를 내보내는 스레드를 성능 코어 하나에 묶으면 중앙값 5.89 ms(빠른 상태 3.10 ms), 효율 코어 하나에 묶으면 10.14 ms(빠른 상태 4.49 ms)이다. GPU 는 같은데 CPU 코어만 바꿔 1.5 – 1.7배가 달라졌다. “GPU 의 지연 시간” 을 잰다고 생각했지만 이 모델 · 이 배치 크기에서는 CPU 가 연산을 내보내는 속도 를 재고 있었던 셈이다.
두 상태를 오가는 원인은 확정하지 못했다. CPU 의 주파수 조절(이 PC 는 절전 모드로 설정되어 있다)이나 전력 · 발열 한도가 유력하지만 따로 확인하지 않았고, 상태가 언제 바뀌는지도 실행마다 달랐다(성능 코어에 묶은 100번의 중앙값이 어떤 실행에서는 3.05 ms, 다른 실행에서는 5.9 ms 였다). 논문이 T4 에서 만난 전력 제한과 원인은 다를 수 있어도 교훈은 같다. 측정값에는 모델의 성질과 기계의 그 순간 상태가 섞여 있고, 견주려는 차이보다 기계 상태의 차이가 클 수 있다. 그래서 이 장의 탐색은 다음 세 가지를 한다.
- 모든 구성을 번갈아 잰다(20 라운드, 라운드마다 구성 408개를 무작위 순서로 3번씩). 상태 변화가 모든 구성에 고르게 묻는다.
- 재는 스레드를 성능 코어 하나에 묶는다. 스레드가 효율 코어로 옮겨 가는 일을 막는다.
- 대푯값으로 중앙값 대신 최솟값 을 쓴다. 값이 두 무리로 갈릴 때 중앙값은 “느린 상태의 라운드가 절반을 넘었는가” 에 따라 어느 무리에 떨어질지가 달라진다. 최솟값은 가장 방해를 덜 받은 측정, 곧 빠른 상태에서의 시간이다(파이썬의
timeit문서가 권하는 방식이기도 하다).
지연 시간, 처리량, 연산량
파레토 곡선의 가로축으로 쓸 수 있는 “비용” 은 여러 가지이다. 이 장의 실험은 셋을 함께 잰다.
- 지연 시간(1장): 그림 한 장(배치 1)의 순전파 시간. 실시간 탐지에서 가장 직접적인 값이지만 하드웨어 · 실행 환경 · 재는 방법에 따라 달라진다.
- 처리량(throughput): 일정 시간에 처리하는 그림의 수(초당 장 수). 여러 장을 한 배치로 묶어 넣었을 때의 값이다. 지연 시간의 역수가 아니다. 배치로 묶으면 GPU 가 한꺼번에 계산하므로 한 장당 시간이 배치 1 의 지연 시간보다 훨씬 짧아진다. 이 장에서는 배치 64 로 재고 “그림 한 장당 시간(ms)” 으로 적는다(처리량 = 1000 ÷ 그 값).
- FLOPs(floating-point operations)(연산량): 순전파 한 번에 드는 곱셈 · 덧셈의 수. \(10^9\) 개를 1 GFLOPs, \(10^6\) 개를 1 MFLOPs 라고 적는다. 하드웨어와 무관하고 잴 때마다 같은 값이 나온다. 논문은 PyTorch 의
FlopCounterMode로 세었고(부록 C), 세는 도구에 따라 값이 달라진다는 점도 함께 보고한다(LW-DETR 이 보고한 값은 자신들이 센 값의 절반쯤이었고, 논문은 곱셈 – 덧셈을 한 번으로 세는 MACs 를 보고했기 때문일 것으로 추정한다). 이 장도 같은 도구를 쓴다(위 코드의count_flops).
세 값은 같은 것을 재지 않는다. 어느 것을 가로축으로 삼느냐에 따라 “좋은 구성” 이 달라질 수 있고, 실험의 뒤쪽에서 실제로 그렇게 된다.
실험: 미니 RF-DETR 로 가중치 공유 NAS
이제 10 · 11장의 미니 RF-DETR 로 전 과정을 해 본다. 견줄 두 모델은 다음과 같다. 데이터(도형 세상 학습 4,000장, 검증 500장), 에폭 수(60), 배치(32), 학습률을 비롯한 학습 설정은 모두 같다.
- 고정 구성 모델: 11장에서 학습한 모델(
ch11_rfdetr.pt). 학습 내내 해상도 96 · 패치 8 · 윈도 2 하나만 봤다. - NAS 학습 모델: 이 장에서 학습하는 모델(
ch12_nas.pt). 스텝마다 (해상도, 패치, 윈도) 를 무작위로 바꾼다.
실행은 세 번으로 나뉜다. python ch12_nas.py 가 NAS 학습을(약 18분), python ch12_nas.py --search 가 격자 탐색과 그림을(약 15분), --finetune 이 마지막 절의 미세 조정 점검을 한다. 시드는 본 실행이 0 하나이고, 기본 구성의 AP 처럼 결론에 중요한 수치는 시드 1 의 학습과 두 배 긴 학습으로 한 번씩 더 확인했다. 고정 구성 모델은 11장의 한 번의 학습(시드 0)이다.
미니 탐색 공간
code/ch12_nas.py · search-space
class Config(NamedTuple):
    """구성 하나 = 손잡이 다섯 개의 값."""
    resolution: int   # 입력 그림의 한 변 (픽셀)
    patch_size: int   # 패치의 한 변 (픽셀)
    num_windows: int  # 윈도 블록에서 한 변을 몇 윈도로 나누는가
    dec_layers: int   # 디코더 층 수 (0 이면 인코더 제안이 곧 예측)
    num_queries: int  # 질의 수

BASE = Config(96, 8, 2, 3, 12)  # 11장의 고정 구성
# 학습 때 뽑는 값 (디코더 3층 · 질의 12개는 고정: 이 둘은 추론 때만 줄인다)
TRAIN_SPACE = {"resolution": (64, 80, 96, 112, 128), "patch_size": (8, 16), "num_windows": (1, 2, 4)}
# 탐색(추론) 때 훑는 값. 해상도 72 · 88 · 104 · 120 과 패치 12 는 학습 때 한 번도 보지 않는다
SEARCH_SPACE = {"resolution": (64, 72, 80, 88, 96, 104, 112, 120, 128), "patch_size": (8, 12, 16),
                "num_windows": (1, 2, 4), "dec_layers": (0, 1, 2, 3), "num_queries": (4, 8, 12)}

def is_valid(resolution: int, patch_size: int, num_windows: int) -> bool:
    """손잡이의 조합이 모델에 넣을 수 있는 것인가: 그림이 패치로, 토큰 격자가 윈도로 나누어떨어져야 한다."""
    return resolution % patch_size == 0 and (resolution // patch_size) % num_windows == 0

def backbone_configs(space) -> list:
    """(해상도, 패치, 윈도) 의 쓸 수 있는 조합 전부."""
    return [(r, p, w) for r in space["resolution"] for p in space["patch_size"] for w in space["num_windows"]
            if is_valid(r, p, w)]

def all_configs(space) -> list:
    """탐색 공간의 모든 구성 (Config 의 목록)."""
    return [Config(r, p, w, d, q) for r, p, w in backbone_configs(space)
            for d in space["dec_layers"] for q in space["num_queries"]]
[탐색 공간] 학습: 해상도 (64, 80, 96, 112, 128) × 패치 (8, 16) × 윈도 (1, 2, 4) = 30가지 가운데 쓸 수 있는 조합 23개
  탐색: 해상도 9 × 패치 3 × 윈도 3 × 디코더 층 4 × 질의 3 = 972가지 가운데 쓸 수 있는 구성 408개 (백본 쪽 조합 34개 × 12)
  그 가운데 (해상도, 패치, 윈도) 가 학습 때 뽑힌 적 있는 구성 276개, 한 번도 뽑히지 않은 구성 132개
  패치  8: 토큰 격자의 한 변 [8, 9, 10, 11, 12, 13, 14, 15, 16]
  패치 12: 토큰 격자의 한 변 [6, 8, 10]
  패치 16: 토큰 격자의 한 변 [4, 5, 6, 7, 8]
논문의 격자를 줄인 것이고, 줄이면서 정한 것들은 다음과 같다.
- 학습 때 뽑는 조합은 23개이다. 해상도 5 × 패치 2 × 윈도 3 = 30가지 가운데, 그림이 패치로 나누어떨어지고 토큰 격자가 윈도로 나누어떨어지는 것만 남긴다(예: 해상도 80 · 패치 16 은 격자가 5×5 라 윈도 1 만 가능). 실제
rfdetr패키지도 같은 제약을 건다. 14장에서 해상도 400 을 넣었더니 “32(패치 16 × 윈도 2)의 배수여야 한다” 며 거절당한 것이 이것이다. - 탐색 때는 손잡이 다섯 개를 모두 돌려 408개 구성이 된다. 디코더 층 0 – 3, 질의 4 · 8 · 12 는 탐색 때만 바뀐다. 도형 세상의 그림에는 객체가 1 – 4개 있으므로 질의 4개가 “겨우 모자라지 않는” 최소이다.
- 일부러 학습에서 뺀 값이 있다. 해상도 72 · 88 · 104 · 120(학습 격자의 사잇값)과 패치 12 전부이다. 408개 가운데 132개 구성이 학습 때 한 번도 뽑히지 않은 (해상도, 패치, 윈도) 를 쓴다. 논문의 추론 격자에 학습 격자에 없는 패치 14 가 들어 있는 것, 부록 L 이 못 본 패치 27 · 18 을 시험한 것을 흉내 낸 것이다.
- 패치 8 과 16, 그리고 12 는 서로 다른 해상도에서 같은 격자를 만든다. 격자 8×8 은 64/8, 96/12, 128/16 세 가지로, 격자 6×6 은 72/12 와 96/16 으로, 격자 10×10 은 80/8 과 120/12 로 만들 수 있다. “공간 위치 수가 같으면 성능이 비슷한가” 를 볼 수 있게 한 설계이다.
학습: 스텝마다 구성 하나
학습 고리는 11장의 것에 세 줄 을 더한 것이다. 구성을 뽑고, 그림을 그 해상도로 바꾸고, 그 패치 크기와 윈도 수로 순전파한다.
code/ch12_nas.py · nas-train
def train_nas_epoch(model, criterion, loader, optimizer, device, ema, train_configs, rng, max_norm: float = 0.1,
                    counts=None):
    """가중치 공유 NAS 의 한 에폭: 스텝마다 구성 하나를 균등하게 뽑아 그 구성으로 순전파 · 역전파 · 갱신을 한 번 한다.

    train_configs: [(해상도, 패치 크기, 윈도 수), …] — 쓸 수 있는 조합의 목록. 모두 같은 확률로 뽑힌다.
    디코더는 늘 3층 전부, 질의는 늘 12개 × 묶음 4개를 쓴다 (모든 층에 손실이 걸려 있으므로 층 · 질의는 추론 때 줄이면 된다).
    그림은 뽑힌 해상도로 배치째 리사이즈한다. 정답 박스는 정규화 좌표라 손대지 않는다.
    11장 train_one_epoch 와 다른 곳은 "구성을 뽑는 세 줄" 뿐이다. 돌려주는 값: 손실 이름 → 에폭 평균.
    """
    model.train()
    criterion.train()
    sums, steps = {}, 0
    for images, targets in loader:
        resolution, patch_size, num_windows = train_configs[rng.integers(len(train_configs))]  # ← 구성 하나를 뽑는다
        images = images.to(device)
        if resolution != images.shape[-1]:
            images = F.interpolate(images, size=(resolution, resolution), mode="bilinear", align_corners=False,
                                   antialias=True)
        outputs = model(images, patch_size=patch_size, num_windows=num_windows)  # ← 같은 가중치, 뽑힌 구성
        losses = criterion(outputs, targets_to(targets, device))
        optimizer.zero_grad(set_to_none=True)
        losses["loss"].backward()
        nn.utils.clip_grad_norm_(model.parameters(), max_norm)
        optimizer.step()
        ema.update(model)
        if counts is not None:
            counts[(resolution, patch_size, num_windows)] = counts.get((resolution, patch_size, num_windows), 0) + 1
        for k, v in losses.items():
            sums[k] = sums.get(k, 0.0) + v.detach()
        steps += 1
    return {k: float(v) / steps for k, v in sums.items()}

def build_nas_model(device, seed: int = 0, max_resolution: int = 128):
    """NAS 용 미니 RF-DETR. 11장 모델과 다른 점은 둘이다.

    ① 위치 임베딩을 "가장 큰 해상도 ÷ 가장 작은 패치" = 128 / 8 = 16×16 격자로 둔다 (11장은 12×12). 더 작은 격자에는 보간한다.
    ② 패치 임베딩 리사이즈를 PI-resize 로 갈아 끼운다.
    """
    torch.manual_seed(seed)
    model = MiniRFDETR(img_size=max_resolution).to(device)  # img_size 는 위치 임베딩 격자의 크기만 정한다
    model.backbone.patch_resize_fn = pi_resize_patch_embed
    return model
모델은 11장과 두 군데가 다르다(build_nas_model).
- 위치 임베딩을 가장 큰 격자 16×16(\(128/8\))으로 둔다. 11장 모델은 12×12 였다. 그래서 매개변수가 \((16^2 - 12^2) \times 96 = 10{,}752\) 개 늘어 1,843,459개이다. 기본 구성(격자 12)에서는 16×16 을 12×12 로 보간해 쓴다.
- 패치 임베딩의 리사이즈를 앞에서 만든 PI-resize 로 갈아 끼운다. 저장하는 커널은 \(8 \times 8\) 이고, 패치 16 일 때는 순전파마다 \(16 \times 16\) 으로 바꾼다. 기울기는 변환 행렬을 거슬러 \(8 \times 8\) 커널로 흐른다.
손실 · 옵티마이저 · EMA · 기울기 자르기는 11장의 것을 그대로 가져다 쓴다. 디코더는 늘 3층, 질의는 12개 × 묶음 4개이다. 학습 중에는 EMA 모델을 세 구성(기본 구성, 해상도 64, 해상도 128 · 패치 16)에서 채점한다.
[NAS 학습] 매개변수 1,843,459개 (위치 임베딩 격자 16×16), 에폭 60, 에폭당 125 스텝, 시드 0, 스텝마다 23개 조합에서 하나
  채점하는 구성 (EMA 모델, 디코더 3층 · 질의 12개): 96/8/w2, 64/8/w2, 128/16/w2
에폭   1 | 손실 14.3734 (ce 0.6664 bbox 0.3033 giou 0.6725) | EMA AP 0.0532  0.0547  0.0542 |    33초
에폭   2 | 손실 10.4998 (ce 0.9046 bbox 0.1592 giou 0.4168) | EMA AP 0.2046  0.1689  0.1676 |    73초
에폭   3 | 손실  8.9672 (ce 0.9312 bbox 0.1144 giou 0.3106) | EMA AP 0.3938  0.3391  0.3384 |   107초
에폭   5 | 손실  6.9490 (ce 0.8744 bbox 0.0662 giou 0.1881) | EMA AP 0.5987  0.5582  0.5521 |   147초
에폭   7 | 손실  6.2189 (ce 0.7818 bbox 0.0592 giou 0.1693) | EMA AP 0.7193  0.6757  0.6715 |   185초
에폭  10 | 손실  5.3896 (ce 0.6252 bbox 0.0529 giou 0.1517) | EMA AP 0.8184  0.7630  0.7555 |   233초
에폭  20 | 손실  4.0886 (ce 0.4116 bbox 0.0396 giou 0.1158) | EMA AP 0.8996  0.8632  0.8590 |   386초
에폭  30 | 손실  3.6617 (ce 0.3542 bbox 0.0355 giou 0.1059) | EMA AP 0.9244  0.8912  0.8878 |   539초
에폭  40 | 손실  3.0998 (ce 0.2969 bbox 0.0285 giou 0.0865) | EMA AP 0.9349  0.9098  0.9053 |   663초
에폭  50 | 손실  2.9965 (ce 0.2927 bbox 0.0279 giou 0.0861) | EMA AP 0.9417  0.9145  0.9125 |   793초
에폭  60 | 손실  2.5167 (ce 0.2489 bbox 0.0221 giou 0.0698) | EMA AP 0.9498  0.9208  0.9226 |   949초
학습 끝: 949초 (7500 스텝). 조합마다 뽑힌 횟수: 최소 300, 최대 372, 평균 326.1 (기본 구성 96/8/w2 는 335번 = 전체의 4.5%)
저장: ch12_nas.pt (model · ema · config · history)
[짧은 성적표] 검증 AP (EMA 모델). 구성 = 해상도 / 패치 / 윈도 / 디코더 층 / 질의
  구성                | NAS 학습 모델 | 11장 고정 구성 모델
   96 /  8 / 2 / 3 / 12  (기본) | 0.9498        | 0.9345
   64 /  8 / 2 / 3 / 12         | 0.9208        | 0.1329
  128 /  8 / 2 / 3 / 12         | 0.9567        | 0.3063
  128 / 16 / 2 / 3 / 12         | 0.9226        | 0.1237
   96 / 12 / 2 / 3 / 12         | 0.9210        | 0.1203
   96 /  8 / 1 / 3 / 12         | 0.9496        | 0.9350
   96 /  8 / 2 / 1 / 12         | 0.9351        | 0.9289
   96 /  8 / 2 / 0 / 12         | 0.8031        | 0.8928
   96 /  8 / 2 / 3 /  4         | 0.9244        | 0.9163
전체 1057초
- 그림 12-5: ch12-training.png 왼쪽: 학습 손실(로그 축). 파랑 = NAS 학습, 주황 점선 = 11장의 고정 구성 학습. 오른쪽: 검증 AP(EMA 모델, 디코더 3층 · 질의 12개). 파랑 · 초록 · 분홍은 NAS 모델을 세 구성에서 채점한 것, 주황 X 는 고정 구성 모델을 그 구성에서 채점한 것이다.
- (그림 내용) 왼쪽: 에폭에 따른 학습 손실. NAS 학습이 고정 구성 학습보다 위에 있다. 오른쪽: 에폭에 따른 검증 AP. 고정 구성 모델이 빨리 오르고 0.935 에서 멈추며, NAS 모델은 느리게 오르다 에폭 40 쯤에 앞지른다.
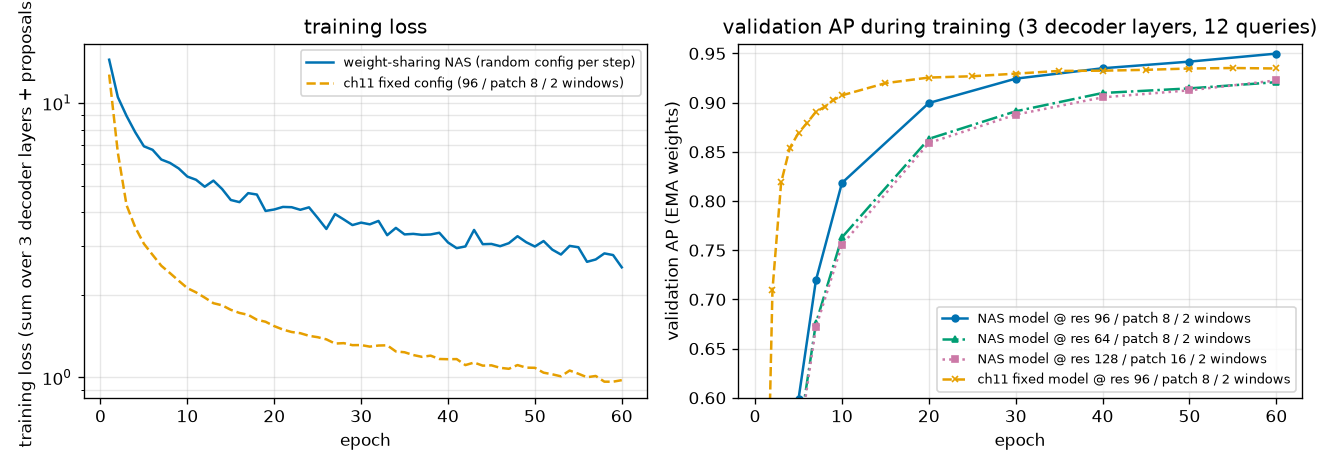
학습 로그와 그림 12-5 에서 읽을 것이다.
- 조합마다 고르게 학습했다. 7,500 스텝이 23개 조합에 300 – 372번씩 돌아갔다. 기본 구성(96 / 8 / 윈도 2)은 335번, 전체의 4.5% 이다. 고정 구성 모델은 7,500 스텝을 모두 이 구성에 썼다.
- 초반에는 NAS 학습이 느리다. 기본 구성의 AP 가 에폭 10 에 0.8184 이다(고정 구성 모델은 0.9074). 가중치가 23가지 모양의 입력에 동시에 맞춰야 하니 당연하다.
- 그런데 에폭 40 쯤에 따라잡고, 끝에서는 앞선다. 에폭 30 에 0.9244 대 0.9294, 에폭 40 에 0.9349 대 0.9325, 에폭 60 에 0.9498 대 0.9347 이다. 고정 구성 모델은 에폭 40 뒤로 0.933 – 0.935 에서 멈췄는데(11장), NAS 모델은 60 에폭에도 아직 오르는 중이다. 기본 구성을 22분의 1 만큼만 직접 학습하고도 그렇다.
- 학습 손실은 NAS 쪽이 훨씬 크다(마지막 에폭 2.52 대 0.98). 다만 이 둘은 바로 견줄 수 없다. NAS 쪽은 격자 4×4 같은 어려운 구성까지 섞은 평균이기 때문이다. 같은 구성에서 견준 값은 뒤의 “일반화 간격” 표에 있다.
- 다른 구성에서도 동작한다. 마지막 성적표에서 NAS 모델은 해상도 64 에서 0.9208, 해상도 128 에서 0.9567, 한 번도 본 적 없는 패치 12 에서 0.9210 이다. 고정 구성 모델은 같은 구성에서 0.1329, 0.3063, 0.1203 이다. (고정 구성 모델의 기본 구성 AP 가 여기서는 0.9345 로, 11장 로그의 0.9347 과 0.0002 다르다. 채점할 때 그림을 묶는 배치 크기가 달라 생긴 부동소수 오차이다.)
- 디코더 0층(인코더 제안만)에서는 NAS 모델이 오히려 낮다(0.8031 대 0.8928). 기대와 다른 결과이고, 뒤에서 따로 본다.
- 학습 시간은 같았다(949초. 11장의 고정 구성 학습은 964초였고, 둘 다 GPU 를 다른 실행과 나눠 쓰며 잰 값이다). 스텝 수가 같고, 이 작은 모델에서는 스텝 시간이 토큰 수보다 연산 호출 수에 좌우되기 때문이다. 논문이 말하는 “NAS 없는 기준의 2 – 4배” 는 같은 품질에 이르는 데 필요한 학습 길이에 대한 것이고, 이 실험은 길이를 같게 맞춘 것이다.
탐색: 모든 구성을 재기
학습이 끝난 가중치로 408개 구성을 모두 평가한다. 재학습은 없다. 두 가지 요령으로 시간을 줄였다.
- 순전파 한 번에서 디코더 0 – 3층짜리 모델의 출력을 모두 얻는다. 인코더 제안이 0층 모델의 출력, 보조 출력이 1 · 2층 모델의 출력, 마지막 출력이 3층 모델의 출력이다. “디코더 층 손잡이에는 묶임이 없다” 는 것을 그대로 이용한 것이다. 그래서 순전파는 (해상도, 패치, 윈도, 질의 수) 의 조합 \(34 \times 3 = 102\) 가지만 하면 된다.
- AP 계산을 여러 프로세스에 나눈다. 이 크기에서는 순전파보다 3장의
evaluate_ap가 느리다(구성 하나에 1 – 2초).
code/ch12_nas.py · grid-search
def grid_search(model, val_set, device, space, workers: int = 0) -> dict:
    """탐색 공간의 모든 구성에서 검증 AP 를 잰다 (재학습 없음). 돌려주는 값: {Config: (AP, AP50, AP75)}.

    (해상도, 패치, 윈도, 질의 수) 마다 검증 세트를 한 번만 순전파한다. 그 한 번에서 디코더 0 · 1 · 2 · 3층짜리 모델의
    출력이 모두 나온다: 인코더 제안 = 0층, 보조 출력 = 1 · 2층, 마지막 출력 = 3층 (10장에서 확인한 것처럼 정확히 같다).
    AP 계산(3장의 evaluate_ap)이 순전파보다 느려서, 채점은 여러 프로세스에 나눠 맡긴다 (workers > 0).
    """
    model.eval()
    jobs = []
    for resolution, patch_size, num_windows in backbone_configs(space):
        for num_queries in space["num_queries"]:
            out = predict(model, val_set, device, batch_size=125, size=resolution, patch_size=patch_size,
                          num_windows=num_windows, num_queries=num_queries)
            by_depth = [out["enc_outputs"]] + out["aux_outputs"] + [out]  # 디코더 0, 1, 2, 3층
            for dec_layers in space["dec_layers"]:
                layer = by_depth[dec_layers]
                jobs.append((Config(resolution, patch_size, num_windows, dec_layers, num_queries),
                             layer["pred_logits"].numpy(), layer["pred_boxes"].numpy()))
    if workers > 0:
        with multiprocessing.get_context("spawn").Pool(workers, _worker_init, (len(val_set),)) as pool:
            return dict(pool.imap_unordered(_worker_eval, jobs, chunksize=4))
    _WORKER["targets"] = val_set.targets
    return dict(_worker_eval(job) for job in jobs)
[격자 탐색] NAS 학습 모델 (ch12_nas.pt, 60 에폭): 구성 408개의 검증 AP, 169초
[격자 탐색] 11장 고정 구성 모델 (ch11_rfdetr.pt): 구성 408개의 검증 AP, 165초
  check 구성  64 /  8 / 1 / 1 / 12 을 따로 순전파해 잰 AP 0.909987 = 격자 탐색의 값 0.909987
[연산량] FlopCounterMode, 그림 한 장: 45.4 – 705.6 MFLOPs (기본 구성 348.2), 17초
같은 격자를 고정 구성 모델에도 돌린다(패치 리사이즈는 두 모델 모두 PI-resize). 연산량은 구성마다 그림 한 장의 순전파를 FlopCounterMode 로 센 값이고 45.4 – 705.6 MFLOPs 로 15배쯤 벌어진다. 두 모델은 구조가 같으므로 연산량과 시간은 NAS 모델에서만 쟀다.
[기본 구성] 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
   96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156
[전체 요약] 구성 408개 (학습 때 본 조합 276개, 못 본 조합 132개)
  NAS 학습 모델          | AP 평균 0.8469, 중앙값 0.8774, 최소 0.5126, 최대 0.9575 | AP ≥ 0.90 인 구성 170개, ≥ 0.80 321개, < 0.50 0개
  11장 고정 구성 모델       | AP 평균 0.2988, 중앙값 0.1315, 최소 0.0000, 최대 0.9350 | AP ≥ 0.90 인 구성 27개, ≥ 0.80 54개, < 0.50 294개
  NAS 학습 모델의 최고 AP: 128 /  8 / 4 / 3 / 12 → 0.9575
  11장 모델: 학습한 (해상도 96, 패치 8) 인 구성 36개의 AP 평균 0.9167 (최소 0.8855), 그 밖의 구성 372개의 AP 평균 0.2390 (최대 0.8676)
  NAS 모델이 11장 모델보다 AP 가 높은 구성: 393 / 408개. (해상도 96, 패치 8) 구성들에서의 차이 NAS − 고정: 평균 -0.0209, 범위 -0.0946 – +0.0153
  학습 때 본 조합의 AP 평균 0.8347, 못 본 조합 0.8725 (디코더 3층 · 질의 12개만: 0.8894 / 0.9233)
[일반화 간격] 기본 구성, 학습 세트의 앞 500장과 검증 500장 (EMA 모델, 추론 모드)
  모델                | 학습 그림: 손실   AP     | 검증 그림: 손실   AP     | 손실의 차이 (검증 − 학습)
  NAS 학습 모델          |           1.7299 0.9566 |           1.8506 0.9498 | +0.1207
  11장 고정 구성 모델       |           0.7040 0.9971 |           1.6477 0.9345 | +0.9437
표의 열은 왼쪽부터 구성, 그 (해상도, 패치, 윈도) 가 학습 때 뽑힌 적이 있는지, NAS 모델의 AP · AP50 · AP75, 고정 구성 모델의 AP, 연산량, 배치 1 의 지연 시간, 배치 64 의 장당 시간이다(시간은 둘 다 여러 번 잰 값 가운데 최솟값이다). 이 형식은 뒤의 표들에서도 같다.
파레토 곡선
- 그림 12-6: ch12-pareto.png 한 번 학습한 NAS 모델에서 꺼낸 408개 구성. 점 하나가 구성 하나이고 색 · 모양은 디코더 층 수이다(빨강 ▼ 0층, 주황 ■ 1층, 초록 ▲ 2층, 파랑 ● 3층). 검은 계단선과 검은 테두리가 파레토 경계. 왼쪽은 가로축이 연산량(MFLOPs), 오른쪽은 같은 점들을 이 노트북 GPU 에서 잰 배치 1 지연 시간으로 다시 찍은 것이다.
- (그림 내용) NAS 모델의 408개 구성을 찍은 산점도 두 장. 왼쪽은 가로축이 연산량, 오른쪽은 가로축이 배치 1 지연 시간이고 세로축은 검증 AP. 검은 계단선이 파레토 경계.
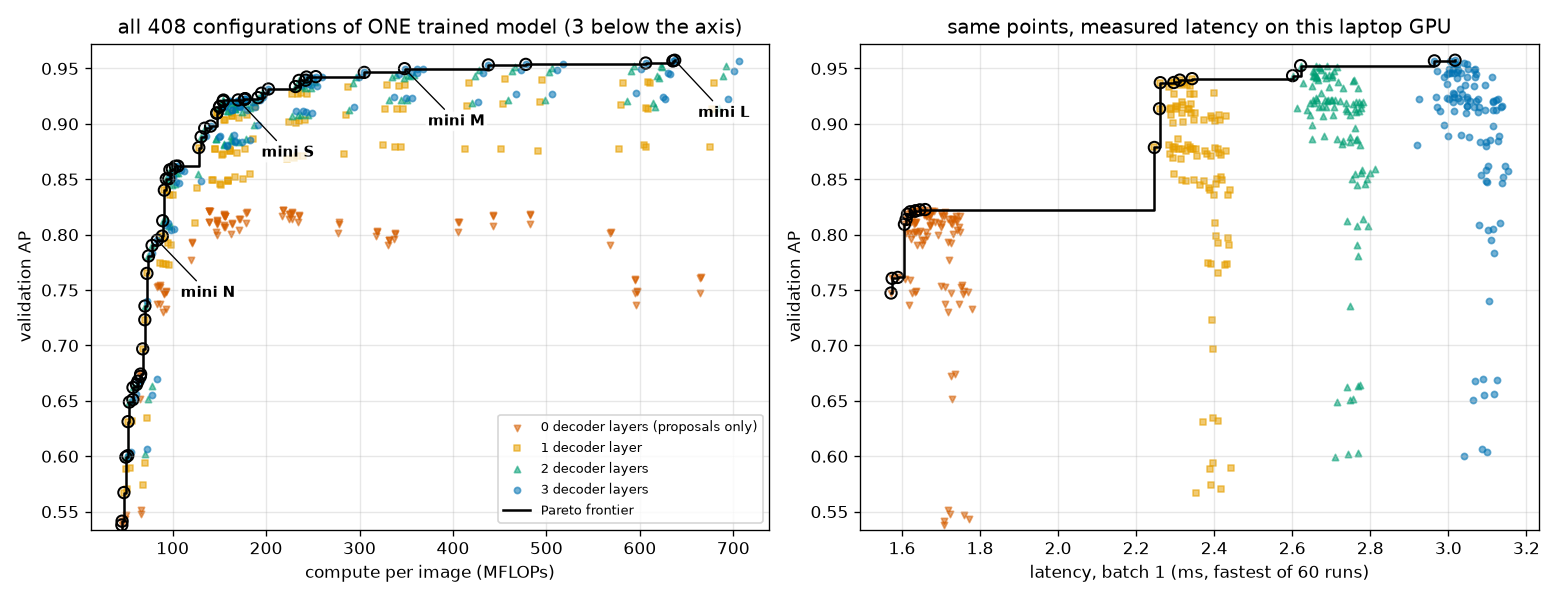
1장에서 약속한 그림이다. 먼저 왼쪽(연산량)부터 읽는다.
- 408개 가운데 59개가 파레토 경계 위에 있다. 경계는 45 MFLOPs · AP 0.51 에서 637 MFLOPs · AP 0.9575 까지 이어진다. 가장 싼 구성과 가장 정확한 구성 사이가 14배, 그 사이를 59개의 점이 촘촘히 메운다. 이 모든 점이 가중치 한 벌 에서 나왔다.
- 경계는 처음에 가파르고 뒤로 갈수록 눕는다. 100 MFLOPs 까지는 연산량을 조금만 더 써도 AP 가 크게 오르고(0.51 → 0.86), 200 MFLOPs 를 넘으면 두 배를 써도 0.01 – 0.02 오른다. 어디까지 쓸지는 예산이 정한다.
- 다섯 손잡이가 모두 쓰인다. 경계 위의 구성들이 쓰는 값은 해상도 아홉 가지 전부, 패치 8 · 12 · 16, 윈도 1 · 2 · 4, 디코더 0 – 3층, 질의 4 · 8 · 12 이다. 논문 부록 L 의 첫 관찰(“모든 손잡이가 파레토 최적 가족에 쓰인다”)과 같다.
- 빨간 점(디코더 0층)은 아래쪽에 따로 띠를 이룬다. 디코더를 떼어 아끼는 연산량은 적은데(기본 구성에서 348 → 319 MFLOPs) AP 는 0.15 쯤 내려간다. 연산량을 기준으로 하면 디코더 0층은 가장 작은 격자들(4×4, 5×5)에서만 경계에 든다.
- 오른쪽 그림은 전혀 다르게 생겼다. 같은 점들인데 가로로 네 무리(디코더 층 수)로 갈리고, 경계 위의 점이 훨씬 적다. 이것은 “가로축을 바꾸면 달라지는 경계” 절에서 본다.
[파레토 경계] 가로축 = MFLOPs: 408개 가운데 59개가 경계 위
  해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
   64 / 16 / 1 / 0 /  4 | 봄  | 0.5126 0.7902 0.5815 | 0.0002 |    45.4 |  1.71 | 0.035
   64 / 16 / 1 / 0 /  8 | 봄  | 0.5380 0.8425 0.6053 | 0.0002 |    45.7 |  1.71 | 0.034
   64 / 16 / 1 / 0 / 12 | 봄  | 0.5414 0.8482 0.6095 | 0.0002 |    45.9 |  1.71 | 0.036
  … (가운데 53줄 생략) …
  120 /  8 / 1 / 3 / 12 | 못 봄 | 0.9549 0.9981 0.9865 | 0.4784 |   606.2 |  3.04 | 0.210
  128 /  8 / 2 / 3 / 12 | 봄  | 0.9567 0.9986 0.9899 | 0.3063 |   635.3 |  3.01 | 0.269
  128 /  8 / 4 / 3 / 12 | 봄  | 0.9575 0.9984 0.9898 | 0.3081 |   637.3 |  3.02 | 0.308
    경계 위 구성이 쓰는 resolution: [64, 72, 80, 88, 96, 104, 112, 120, 128]
    경계 위 구성이 쓰는 patch_size: [8, 12, 16]
    경계 위 구성이 쓰는 num_windows: [1, 2, 4]
    경계 위 구성이 쓰는 dec_layers: [0, 1, 2, 3]
    경계 위 구성이 쓰는 num_queries: [4, 8, 12]
논문이 파레토 경계에서 N · S · M · L 을 골랐듯, 여기서도 예산을 정해 네 개를 골라 본다. 규칙은 결과를 보기 전에 정했다. 기본 구성의 연산량(348.2 MFLOPs)의 1/4 · 1/2 · 1배, 그리고 제한 없음 안에서 AP 가 가장 높은 구성이다.
[미니 N / S / M / L] 연산량 예산 = 기본 구성(348.2 MFLOPs)의 1/4 · 1/2 · 1배 · 제한 없음 안에서 AP 가 가장 높은 구성
  이름 | 예산 MFLOPs | 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
  N    |        87.0 |  80 / 16 / 1 / 3 / 12 | 봄  | 0.7950 0.9636 0.8736 | 0.0001 |    83.6 |  3.11 | 0.061
  S    |       174.1 |  64 /  8 / 4 / 2 / 12 | 봄  | 0.9216 0.9941 0.9813 | 0.1326 |   170.1 |  2.70 | 0.130
  M    |       348.2 |  96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156
  L    |         inf | 128 /  8 / 4 / 3 / 12 | 봄  | 0.9575 0.9984 0.9898 | 0.3081 |   637.3 |  3.02 | 0.308
  같은 예산에서 11장 고정 구성 모델로 고르면: N 72/12/1/1/4 AP 0.0009, S 64/8/2/2/12 AP 0.1431, M 96/8/2/3/12 AP 0.9345, L 96/8/4/3/8 AP 0.9350
| 이름 | 구성 (해상도 / 패치 / 윈도 / 층 / 질의) | 격자 | MFLOPs | AP (NAS 모델) | 같은 구성의 고정 구성 모델 |
| 미니 N | 80 / 16 / 1 / 3 / 12 | 5×5 | 83.6 | 0.7950 | 0.0001 |
| 미니 S | 64 / 8 / 4 / 2 / 12 | 8×8 | 170.1 | 0.9216 | 0.1326 |
| 미니 M | 96 / 8 / 2 / 3 / 12 (기본 구성) | 12×12 | 348.2 | 0.9498 | 0.9345 |
| 미니 L | 128 / 8 / 4 / 3 / 12 | 16×16 | 637.3 | 0.9575 | 0.3081 |
- 크기를 키우는 주된 손잡이는 격자(해상도 ÷ 패치)이다. N → S → M → L 로 격자가 5 → 8 → 12 → 16 으로 커진다. 논문의 N → L 이 해상도 384 → 704 로 커지는 것과 같은 모양이다.
- 미니 M 이 정확히 11장의 기본 구성이다. 그 예산 안에서 그보다 나은 구성이 없었다는 뜻이다.
- 미니 S · L 의 “윈도 4” 는 읽지 마라. 같은 격자에서 윈도 1 · 2 · 4 의 AP 차이는 0.001 안쪽이다(예: 128 / 8 / · / 3 / 12 에서 0.9569, 0.9567, 0.9575). 11장에서 본 대로 같은 실험을 다시 돌려도 이 정도는 달라진다. 최댓값을 고르는 규칙이 우연히 집은 것이다.
- 고정 구성 모델에서는 이런 가족이 나오지 않는다. 같은 예산 규칙으로 고르면 N 0.0009, S 0.1431, M 0.9345, L 0.9350 이다. 예산을 줄이면 쓸 수 있는 모델이 없고, 늘려도 나아지지 않는다.
고정 구성 모델에서 꺼내면
“학습 때 구성을 바꾸지 않아도 추론 때 손잡이를 돌릴 수 있지 않을까?” 를 확인한다. 같은 408개 구성을 두 모델에서 꺼내 견준다.
- 그림 12-7: ch12-fixed-vs-nas.png 왼쪽: 구성마다 고정 구성 모델의 AP(가로)와 NAS 모델의 AP(세로). 대각선 위쪽이면 NAS 모델이 높다. 주황 네모는 고정 구성 모델이 학습한 해상도 96 · 패치 8 인 구성들, 초록 별은 NAS 학습 때도 뽑힌 적 없는 구성들이다. 가운데: 추론 해상도를 바꿀 때의 AP(윈도 1, 디코더 3층, 질의 12개). 실선이 NAS 모델, 점선이 고정 구성 모델이고 색은 패치 크기이다. 오른쪽: 두 모델에서 뽑은 파레토 경계(가로축 연산량).
- (그림 내용) 왼쪽: 같은 구성에서 고정 구성 모델의 AP 를 가로로, NAS 모델의 AP 를 세로로 찍은 산점도. 대부분의 점이 대각선 위에 있다. 가운데: 추론 해상도에 따른 AP. 오른쪽: 두 모델의 파레토 경계.
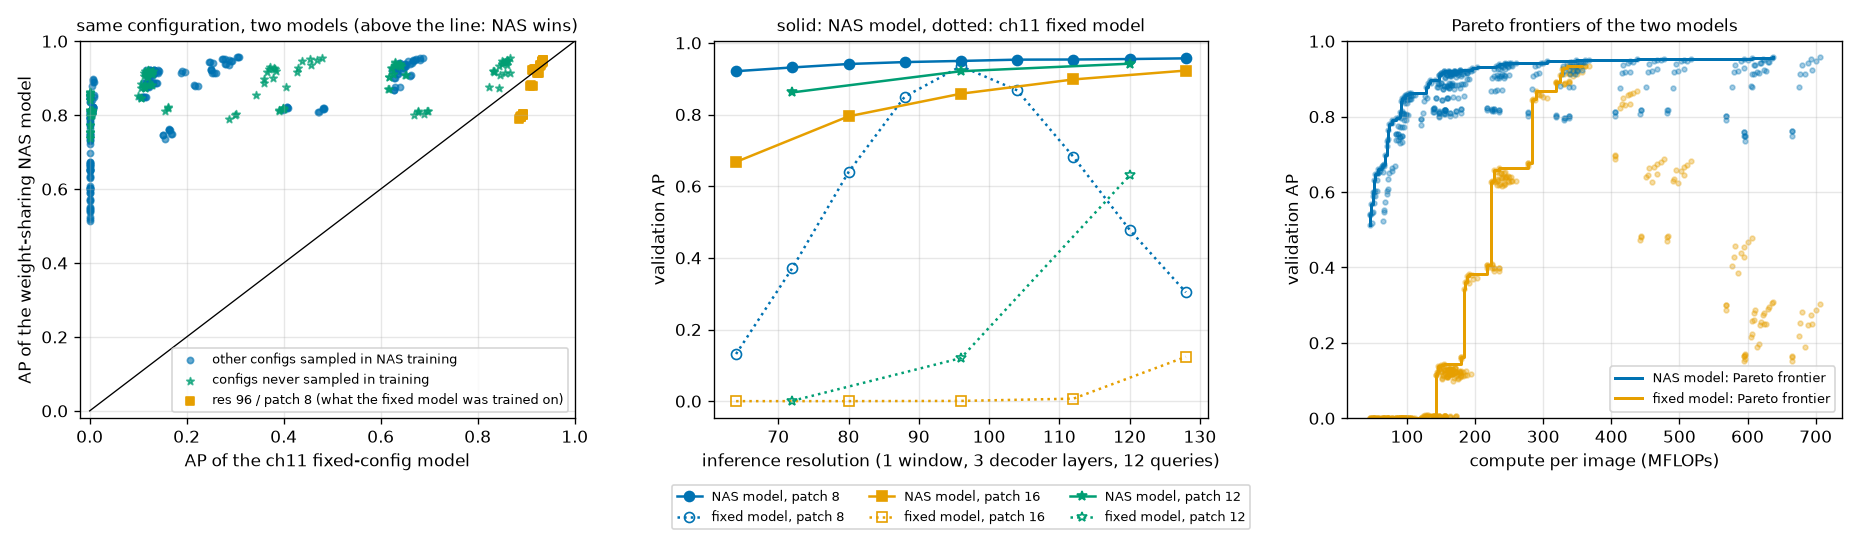
앞의 전체 요약 출력과 그림 12-7 을 함께 읽는다.
- 고정 구성 모델은 학습한 해상도 · 패치에서만 동작한다. 해상도 96 · 패치 8 인 구성 36개의 AP 평균은 0.9167 이고, 나머지 372개의 평균은 0.2390 이다. 408개 가운데 294개가 AP 0.5 에 못 미친다. NAS 모델은 0.5 아래가 하나도 없고 321개가 0.8 을 넘는다.
- 해상도를 조금만 벗어나도 무너진다(가운데 그림의 파란 점선). 96 에서 0.935 이던 것이 88 · 104 에서 0.85 · 0.87, 80 · 112 에서 0.64 · 0.68, 64 · 128 에서 0.13 · 0.30 이다. 학습한 해상도를 꼭짓점으로 하는 뾰족한 산 모양이다. NAS 모델(파란 실선)은 64 에서 128 까지 0.92 – 0.96 으로 평평하다.
- 패치 크기는 더 못 견딘다. 고정 구성 모델은 패치 16 에서 AP 가 0 에 가깝다(주황 점선: 해상도 112 까지 0.01 아래, 128 에서 0.12). PI-resize 가 토큰의 값 은 지켜 주지만, 패치가 커지면 토큰 격자가 12×12 에서 6×6 으로 바뀌고 객체 하나가 차지하는 토큰 수가 1/4 이 된다. 그런 입력을 뒤의 블록들과 머리가 본 적이 없다. 앞에서 그림과 패치를 함께 키웠을 때 AP 가 그대로였던 것(격자가 12×12 로 유지됨)과 견주어 보면, 깨지는 원인이 패치 임베딩이 아니라 격자의 변화라는 것을 알 수 있다.
- 학습 없이도 돌릴 수 있는 손잡이가 있다. 왼쪽 그림의 주황 네모(해상도 96 · 패치 8 인 구성들)는 고정 구성 모델에서도 0.89 – 0.94 로 모여 있다. 이 36개는 윈도 수 · 디코더 층 수 · 질의 수만 다른 구성들이다. 논문이 디코더 층과 질의를 “추론 때만” 바꾸는 손잡이로 둔 것과 맞고, 윈도 수는 11장에서 본 대로 윈도 2 로 학습한 모델이 1 · 4 에서도 그대로 동작한다.
- 오른쪽 그림: 고정 구성 모델의 “경계” 는 한 점으로 가는 절벽이다. 연산량 300 MFLOPs 아래에서는 AP 0.85 를 넘는 구성이 없고, 그 위로는 더 써도 오르지 않는다. NAS 모델의 경계는 전 구간에서 그 위에 있다.
여기까지는 예상한 대로이다. 예상하지 못한 것은 기본 구성에서조차 NAS 모델이 더 높다 는 점이다(0.9498 대 0.9345). 장난감 문제에서는 가중치를 공유하면 구성마다 양보해야 했다. 왜 반대가 됐을까? 위 출력의 “일반화 간격” 표가 실마리이다. 두 모델을 기본 구성으로 놓고 학습 그림 500장과 검증 그림 500장에서 손실과 AP 를 쟀다.
| 모델 (기본 구성에서 채점) | 학습 그림: 손실 | 학습 그림: AP | 검증 그림: 손실 | 검증 그림: AP | 손실의 차이 |
| 고정 구성 모델 | 0.7040 | 0.9971 | 1.6477 | 0.9345 | +0.9437 |
| NAS 학습 모델 | 1.7299 | 0.9566 | 1.8506 | 0.9498 | +0.1207 |
- 고정 구성 모델은 학습 그림을 거의 외웠다. 학습 그림에서 AP 0.9971 인데 검증 그림에서는 0.9345 이다. 손실은 0.70 대 1.65 로 두 배가 넘게 벌어진다. 과적합이다. 11장에서 “학습 손실은 계속 줄어드는데 검증 AP 는 에폭 40 뒤로 멈췄다” 고 본 것의 정체이다.
- NAS 모델은 간격이 거의 없다. 학습 그림 0.9566, 검증 그림 0.9498 이다. 학습 그림에서의 성적은 고정 구성 모델보다 훨씬 낮지만(외우지 못했다) 검증 그림에서는 더 높다.
이것은 정규화의 전형적인 모습이고, 논문이 “구조 증강” 이라고 부른 효과와 같은 방향이다. 구성이 스텝마다 바뀌면 가중치가 특정 격자에서만 통하는 방식으로 학습 그림을 외우기 어렵다. 학습 그림이 4,000장뿐이고 매개변수가 184만 개인 이 실험은 과적합하기 쉬운 조건이고, 그래서 정규화의 이득이 공유의 손해보다 컸다고 해석할 수 있다.
주의 · 이 결과가 말해 주지 않는 것
- “구조” 를 바꾼 덕인지 “해상도” 를 바꾼 덕인지 가르지 못했다. 그림을 여러 해상도로 줄이고 키워 보여 주는 것은 그 자체로 데이터 증강이다(LW-DETR 은 바로 그 목적으로 썼다). 해상도만 바꾸고 패치 · 윈도는 고정한 대조 실험을 하지 않았으므로, 이득 가운데 얼마가 다중 해상도 학습의 몫인지는 알 수 없다. 11장의 고정 구성 모델은 데이터 증강을 전혀 쓰지 않았다.
- 논문의 +0.3 AP 와 같은 것이라고 할 수 없다. 논문의 기준 모델은 이미 다중 스케일 학습과 증강을 쓰는 모델이고, 사전 학습된 백본에서 출발하며, 데이터는 COCO 이다. 여기서의 +0.015 는 증강이 전혀 없는 작은 모델이 작은 데이터에 과적합하던 것이 풀린 효과가 대부분일 수 있다.
- 고정 구성 모델은 시드가 하나이다. NAS 모델은 시드 0 · 1 이 0.9498 · 0.9494 로 가깝지만, 고정 구성 모델의 0.9347 은 한 번의 학습이다. 11장에서 같은 설정을 15 에폭씩 세 시드로 돌렸을 때의 폭은 0.005 쯤이었으므로 0.015 의 차이는 그보다 크지만, 60 에폭에서의 시드 폭을 직접 잰 것은 아니다.
다른 실행과도 견주어 본다. 시드를 바꾼 NAS 학습(60 에폭)과 두 배 길게 한 NAS 학습(120 에폭)에 같은 격자 탐색을 돌린 결과이다.
[다른 실행과의 비교] 같은 격자의 검증 AP
  실행                         | 기본 구성 AP | 기본 구성에서 디코더 0층 | 전체 평균 | 최고   | AP ≥ 0.90 인 구성 | N      S      M      L (위에서 고른 구성의 AP)
  NAS 60 에폭, 시드 0 (본 실행)       | 0.9498       | 0.8031                   | 0.8469    | 0.9575 |  170              | 0.7950 0.9216 0.9498 0.9575
  NAS 120 에폭, 시드 0 (long)      | 0.9596       | 0.8548                   | 0.8761    | 0.9651 |  196              | 0.8401 0.9380 0.9596 0.9651
  NAS 60 에폭, 시드 1 (seed1)      | 0.9494       | 0.8157                   | 0.8452    | 0.9544 |  173              | 0.7960 0.9174 0.9494 0.9522
  11장 고정 구성, 60 에폭             | 0.9345       | 0.8928                   | 0.2988    | 0.9350 |   27              | 0.0001 0.1326 0.9345 0.3081
- 시드를 바꿔도 결과가 같다. 기본 구성 0.9498 · 0.9494, 전체 평균 0.8469 · 0.8452, AP 0.9 이상인 구성 170 · 173개. 미니 N · S · M · L 의 AP 도 0.006 안에서 같다.
- 더 길게 학습하면 전체가 올라간다. 120 에폭에서 기본 구성 0.9596, 전체 평균 0.8761 이고 미니 N 은 0.7950 → 0.8401 로 가장 많이 올랐다. 60 에폭은 NAS 학습에 모자란 길이였다. 논문이 학습 시간을 기준의 2 – 4배로 잡는 것, RF100-VL 에서 “구조 증강이 수렴하는 데 100 에폭보다 더 걸린다” 고 본 것과 같은 방향이다. (고정 구성 모델을 120 에폭 학습한 값은 없다. 11장에서 검증 AP 가 에폭 40 뒤로 멈춰 있었다는 것만 알고 있다.)
- 디코더 0층의 약점은 세 실행 모두에서 나타난다(다음 절).
손잡이별 민감도
기본 구성에서 손잡이를 하나씩만 돌려 본다. 논문의 표 5 · 부록 F 에 해당하는 실험이다.
[손잡이별 민감도] 기본 구성에서 손잡이 하나만 바꾼다
  (resolution) 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
     64 /  8 / 2 / 3 / 12 | 봄  | 0.9208 0.9914 0.9789 | 0.1329 |   160.8 |  3.06 | 0.097
     80 /  8 / 2 / 3 / 12 | 봄  | 0.9423 0.9955 0.9799 | 0.6374 |   243.3 |  3.05 | 0.115
     96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156   ← 기본
    112 /  8 / 2 / 3 / 12 | 봄  | 0.9537 0.9966 0.9899 | 0.6878 |   477.9 |  3.05 | 0.196
    128 /  8 / 2 / 3 / 12 | 봄  | 0.9567 0.9986 0.9899 | 0.3063 |   635.3 |  3.01 | 0.269
  (patch_size) 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
     96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156   ← 기본
     96 / 12 / 2 / 3 / 12 | 못 봄 | 0.9210 0.9947 0.9823 | 0.1203 |   169.0 |  3.12 | 0.102
     96 / 16 / 2 / 3 / 12 | 봄  | 0.8573 0.9861 0.9340 | 0.0007 |   112.1 |  3.15 | 0.084
  (num_windows) 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
     96 /  8 / 1 / 3 / 12 | 봄  | 0.9496 0.9965 0.9879 | 0.9350 |   367.4 |  3.01 | 0.150
     96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156   ← 기본
     96 /  8 / 4 / 3 / 12 | 봄  | 0.9497 0.9992 0.9865 | 0.9348 |   361.0 |  3.05 | 0.188
  (dec_layers) 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
     96 /  8 / 2 / 0 / 12 | 봄  | 0.8031 0.9920 0.9647 | 0.8928 |   318.7 |  1.65 | 0.129
     96 /  8 / 2 / 1 / 12 | 봄  | 0.9351 0.9957 0.9853 | 0.9289 |   329.3 |  2.33 | 0.132
     96 /  8 / 2 / 2 / 12 | 봄  | 0.9443 0.9964 0.9882 | 0.9332 |   338.7 |  2.70 | 0.148
     96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156   ← 기본
  (num_queries) 해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
     96 /  8 / 2 / 3 /  4 | 봄  | 0.9244 0.9849 0.9805 | 0.9163 |   337.4 |  3.05 | 0.148
     96 /  8 / 2 / 3 /  8 | 봄  | 0.9454 0.9963 0.9859 | 0.9342 |   342.8 |  3.07 | 0.156
     96 /  8 / 2 / 3 / 12 | 봄  | 0.9498 0.9966 0.9892 | 0.9345 |   348.2 |  3.07 | 0.156   ← 기본
- 그림 12-8: ch12-knobs.png 기본 구성(세로 점선)에서 손잡이 하나만 바꿨을 때의 검증 AP. 파랑 실선이 NAS 모델, 주황 점선이 고정 구성 모델이고, 회색 막대(오른쪽 축)는 그 구성의 연산량이다. 칸의 순서는 논문 그림 3 의 (a) – (e).
- (그림 내용) 다섯 손잡이 각각에 대해 값을 바꿀 때의 AP 를 그린 다섯 칸. NAS 모델은 모든 칸에서 완만하게 변하고, 고정 구성 모델은 패치 크기와 해상도에서 급격히 떨어진다.
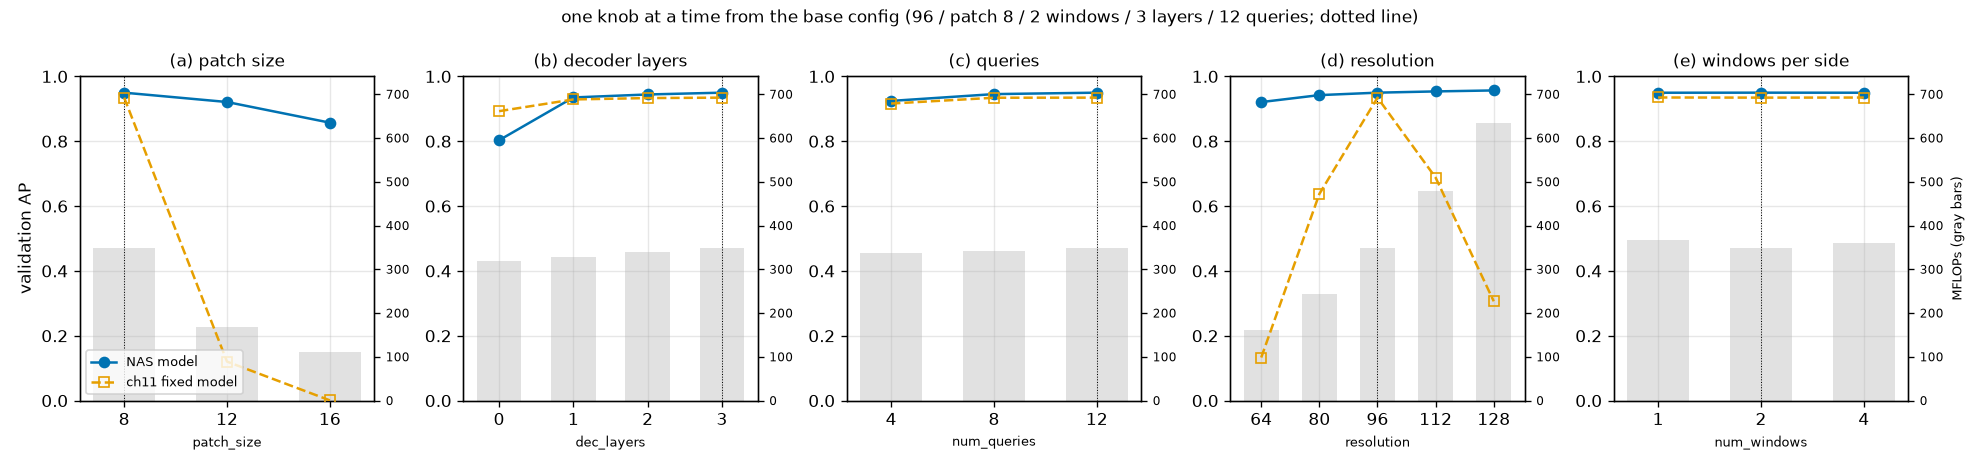
- (a) 패치 크기: 연산량을 가장 크게 줄이고 AP 도 가장 많이 내린다. 8 → 12 → 16 에서 연산량이 348 → 169 → 112 MFLOPs, AP 가 0.9498 → 0.9210 → 0.8573 이다. 패치 12 는 학습 때 한 번도 보지 않은 값인데 8 과 16 의 사이에 자연스럽게 놓인다.
- (b) 디코더 층: 첫 층이 대부분을 한다. 0 → 1 → 2 → 3층에서 0.8031 → 0.9351 → 0.9443 → 0.9498. 마지막 층 하나를 떼면 −0.0055, 둘을 떼면 −0.0147 이다. 연산량은 층 하나에 약 10 MFLOPs(3%)로, 이 미니 모델에서는 디코더가 전체의 8% 밖에 안 된다. (논문은 COCO 의 Nano 에서 마지막 층을 떼면 지연 10% 감소에 2 mAP 하락이라고 보고한다. 방향은 같고 크기는 데이터와 모델에 따라 다르다.)
- (c) 질의 수: 8개까지는 거의 그대로, 4개에서 내려간다. 12 → 8 → 4 에서 0.9498 → 0.9454 → 0.9244. 그림마다 객체가 많아야 4개인데도 질의 4개로는 모자란다. 인코더 점수 상위 4칸이 서로 다른 객체 넷을 하나씩 가리킨다는 보장이 없기 때문이다(한 객체 위의 두 칸이 함께 뽑히면 다른 객체가 빠진다). 질의 수는 객체 수의 상한보다 넉넉해야 한다. 14장에서
num_select를 줄였을 때 본 것과 같은 교훈이다. - (d) 해상도: 올릴수록 조금씩 오르고, 연산량은 제곱으로 는다. 64 → 128 에서 AP 0.9208 → 0.9567, 연산량 161 → 635 MFLOPs. 도형 세상의 객체는 큼직해서 해상도의 이득이 작다.
- (e) 윈도 수: AP 는 그대로이고, 연산량은 윈도 2 가 가장 작다. 1 · 2 · 4 에서 AP 0.9496 · 0.9498 · 0.9497, 연산량 367.4 · 348.2 · 361.0 MFLOPs. 앞의 손계산에서 어텐션 쌍의 수는 윈도 4 가 가장 적었는데 전체 연산량은 윈도 2 가 가장 작다. 토큰마다 드는 선형 층의 계산이 토큰 수 \(N + W^2\)(145 · 148 · 160)에 비례하기 때문이다. 윈도 4 는 CLS 토큰 16개가 여섯 블록 내내 따라다닌다. 논문 부록 L 이 “윈도는 대개 2 가 최적이고, 윈도를 늘리면 CLS 토큰 복제 때문에 효율이 떨어진다” 고 한 것이 이 작은 모델의 연산량에서도 보인다.
- 고정 구성 모델(주황 점선)은 (b) · (c) · (e) 에서만 따라온다. 앞 절에서 본 그대로이다.
(b) 에서 눈에 띄는 것이 디코더 0층이다. NAS 모델 0.8031, 고정 구성 모델 0.8928 로 이 구성에서만 NAS 모델이 0.09 낮다. 시드 1 과 120 에폭 학습에서도 같은 모습이다(위의 비교 표: 0층 AP 가 세 NAS 실행 모두 고정 구성 모델보다 낮다). AP50 은 0.9920 으로 고정 구성 모델(11장: 0.9898)과 같으므로 객체를 못 찾는 것이 아니라 박스가 덜 정밀한 것이다. 그리고 NAS 모델의 0층 AP 는 격자가 커질수록 오히려 내려간다(패치 8 · 윈도 1 · 질의 12개에서 해상도 64: 0.8215, 128: 0.7614). 디코더를 붙인 구성에서는 반대로 오르는 방향이다.
그럴 만한 이유는 있다(확인한 것은 아니다). 인코더 제안은 특징 맵의 칸마다 “그 칸 중심의 작은 제안 박스에서 얼마나 옮기고 키울지” 를 한 번에 맞혀야 한다(10장). 고정 구성 모델은 칸의 크기가 늘 그림의 1/12 이지만, NAS 모델에서는 격자가 4×4 에서 16×16 까지 바뀌므로 같은 머리가 칸 크기가 네 배씩 다른 상황을 모두 감당해야 한다. 디코더 층은 변형 어텐션으로 특징 맵을 다시 읽어 박스를 고치므로 한 층만 붙여도 차이가 사라진다(1층: 0.9351 대 0.9289). 가중치 공유가 공짜가 아니라는 것을 보여 주는 예이다. 어떤 부분망은 공유 때문에 손해를 본다.
[디코더 층 × 질의 수] 백본 쪽은 기본 구성 (96 / 8 / 윈도 2). 칸: AP (배치 1 지연 시간 ms)
  디코더 층 | 질의  4         | 질의  8         | 질의 12
          0 | 0.7987 (1.66) | 0.8028 (1.66) | 0.8031 (1.65)
          1 | 0.8813 (2.33) | 0.9133 (2.34) | 0.9351 (2.33)
          2 | 0.9215 (2.69) | 0.9426 (2.70) | 0.9443 (2.70)
          3 | 0.9244 (3.05) | 0.9454 (3.07) | 0.9498 (3.07)
논문 부록 B(그림 4)의 미니판이다. 디코더 층 수와 질의 수를 함께 바꾼 12칸으로, 괄호 안은 배치 1 지연 시간이다. 질의를 줄였을 때의 손해는 디코더가 얕을수록 크다(1층: 0.9351 → 0.8813, 3층: 0.9498 → 0.9244). 디코더 층이 많으면 질의들이 자기 어텐션으로 역할을 나눌 기회가 늘어나기 때문일 것이다. 지연 시간은 층 수에 따라 뚜렷이 달라지고 질의 수에는 거의 반응하지 않는다. 질의가 12개뿐이라 줄여도 아낄 계산이 없다(논문은 300개에서 100개를 덜어 “조금” 빨라졌다고 보고한다).
공간 위치 수와 못 본 구성
부록 L 의 주장(“성능은 해상도 · 패치 각각보다 공간 위치 수를 따른다”)과 부록 F 의 주장(“못 본 구성도 추세를 따른다”)을 미니 실험으로 점검한다. 윈도 1 · 디코더 3층 · 질의 12개로 고정하고 (해상도, 패치) 만 바꾼 17개 구성이다.
[공간 위치 수] 토큰 격자의 한 변 = 해상도 ÷ 패치. 윈도 1, 디코더 3층, 질의 12개
  격자 | (해상도 / 패치: AP, *는 학습 때 못 본 조합) …                                   | AP 의 범위
     4 | 64/16: 0.6677                                                                  |   -
     5 | 80/16: 0.7950                                                                  |   -
     6 | 72/12: 0.8618*, 96/16: 0.8582                                                  | 0.0036
     7 | 112/16: 0.8980                                                                 |   -
     8 | 64/8: 0.9210, 96/12: 0.9209*, 128/16: 0.9228                                   | 0.0019
     9 | 72/8: 0.9315*                                                                  |   -
    10 | 80/8: 0.9411, 120/12: 0.9419*                                                  | 0.0008
    11 | 88/8: 0.9465*                                                                  |   -
    12 | 96/8: 0.9496                                                                   |   -
    13 | 104/8: 0.9532*                                                                 |   -
    14 | 112/8: 0.9536                                                                  |   -
    15 | 120/8: 0.9549*                                                                 |   -
    16 | 128/8: 0.9569                                                                  |   -

[학습 때 못 본 해상도] 패치 8, 윈도 1, 디코더 3층, 질의 12개: 해상도 → AP (*는 못 본 해상도)
  64: 0.9210,  72*: 0.9315,  80: 0.9411,  88*: 0.9465,  96: 0.9496,  104*: 0.9532,  112: 0.9536,  120*: 0.9549,  128: 0.9569
  해상도 72 – 120 가운데 학습 때 본 해상도 3개의 AP 평균 0.9481
  해상도 72 – 120 가운데 학습 때 못 본 해상도 4개의 AP 평균 0.9465
- 그림 12-9: ch12-spatial.png 가로축은 공간 위치 수(토큰 격자의 한 변 = 해상도 ÷ 패치). 파랑 동그라미 = 패치 8, 초록 별 = 패치 12, 주황 네모 = 패치 16. 속이 빈 표시는 학습 때 뽑힌 적 없는 (해상도, 패치) 이다. 왼쪽은 검증 AP, 오른쪽은 배치 64 에서의 그림 한 장당 시간이다.
- (그림 내용) 왼쪽: 토큰 격자의 한 변에 따른 검증 AP. 패치 크기가 달라도 격자가 같으면 점이 겹친다. 오른쪽: 격자의 한 변에 따른 배치 64 의 그림 한 장당 시간.
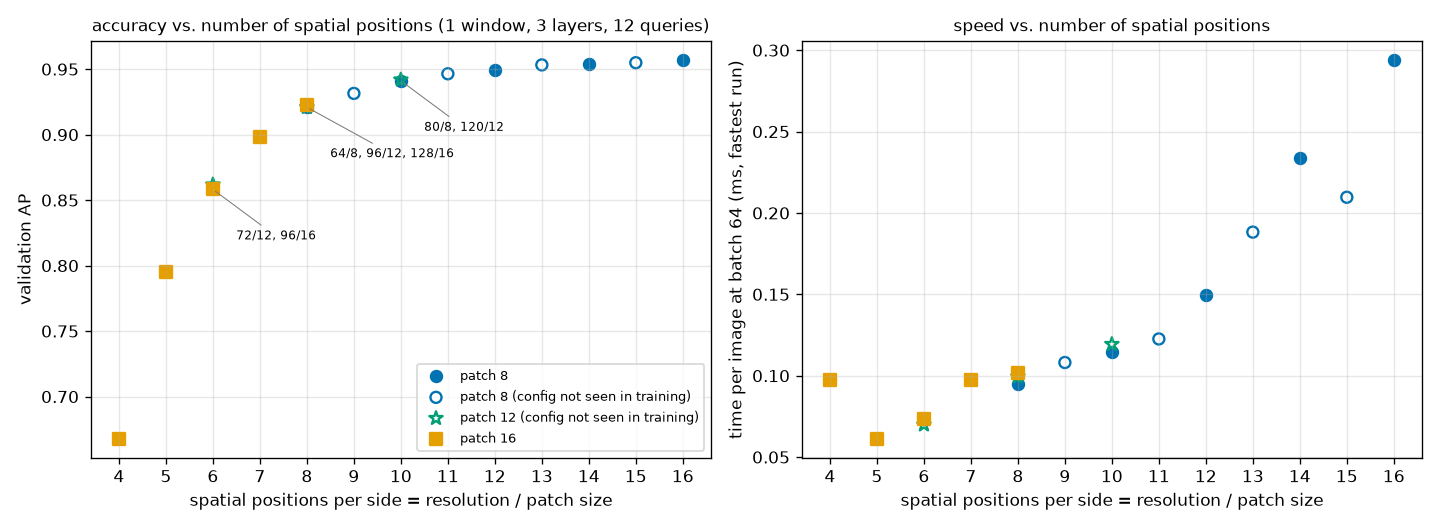
- 격자가 같으면 AP 가 같다. 격자 8×8 을 만드는 세 가지 방법(64/8, 96/12, 128/16)의 AP 가 0.9210, 0.9209, 0.9228 로 폭이 0.0019 이다. 격자 6×6 의 두 방법은 0.8618 · 0.8582, 격자 10×10 의 두 방법은 0.9411 · 0.9419 이다. 해상도가 두 배(64 대 128)나 다른데도 그렇다. 반면 격자를 8 에서 10 으로 한 단계 올리면 0.02 가 오른다. 그림 12-9 왼쪽에서 세 가지 표시가 한 곡선 위에 겹쳐 놓인다.
- 패치 12 는 학습 때 본 적이 없는데도 그 곡선 위에 있다(초록 별). 논문이 못 본 패치 27 · 18 로 확인한 것과 같은 결과이다.
- 못 본 해상도도 사이를 매끄럽게 잇는다. 패치 8 에서 해상도 64 → 128 의 AP 는 0.9210, 0.9315, 0.9411, 0.9465, 0.9496, 0.9532, 0.9536, 0.9549, 0.9569 로(*가 못 본 해상도) 단조롭게 오르고, 못 본 값이 본 값들의 사이에 정확히 놓인다. 탐색 공간이 띄엄띄엄한 점들이 아니라 연속체처럼 동작한다.
- 격자가 작아질수록 AP 는 점점 빨리 떨어진다. 16 → 12 에서 −0.007, 12 → 8 에서 −0.029, 8 → 4 에서 −0.25 이다. 격자 4×4 에서는 토큰 하나가 그림의 1/16 을 덮어, 작은 도형은 토큰 하나보다도 작다.
- 속도도 격자를 따른다(오른쪽 그림). 배치 64 에서의 장당 시간이 패치 크기와 무관하게 격자의 크기로 정해진다(격자 6 · 8 · 10 에서 서로 다른 표시가 겹친다). 10장에서 학습 전 모델로 본 것과 같다. 격자 4 와 15 의 점이 이웃보다 튀는 까닭은 확인하지 않았다.
참고 · “못 본 조합의 평균 AP 가 더 높다” 는 숫자. 전체 요약 출력에 “학습 때 본 조합의 AP 평균 0.8347, 못 본 조합 0.8725” 라는 줄이 있다. 못 본 구성이 더 잘한다는 뜻이 아니다. 본 조합에는 격자 4×4 · 5×5 같은 작은 격자(패치 16)가 들어 있고, 못 본 조합은 격자 6 이상뿐이라 평균이 높게 나온 것이다. 같은 격자끼리 견준 위의 표가 올바른 비교이다.
이 관찰의 쓸모는 크다. 탐색해야 할 것이 사실상 (해상도, 패치) 의 2차원이 아니라 격자 크기라는 1차원으로 줄어든다. 그리고 같은 격자를 만드는 여러 방법 가운데 무엇을 고를지는 정확도가 아닌 다른 기준(전처리 비용, 하드웨어가 선호하는 입력 크기, 분할이라면 마스크의 세밀함)으로 정할 수 있다.
가로축을 바꾸면 달라지는 경계
지금까지는 연산량을 가로축으로 썼다. 이제 같은 408개 구성을 이 노트북 GPU 에서 실제로 잰 시간으로 본다.
[시간] 구성을 재는 스레드: 성능 코어 3번에 묶음
[시간] 배치 1: 구성마다 60번 (라운드 20 × 3, 번갈아), 103초. 중앙값 1.69 – 6.09 ms (기본 구성 5.91), 최솟값 1.57 – 3.15 ms (기본 구성 3.07)
  기본 구성의 60번: 최소 3.07, 10% 3.12, 25% 5.87, 중앙값 5.91, 75% 5.96, 90% 6.01 ms
  기본 구성의 라운드별 평균 (ms): 6.0 5.9 3.1 6.0 5.9 3.1 5.9 3.1 3.1 6.0 5.9 5.9 5.9 5.9 6.0 5.9 5.9 6.0 5.9 5.9
  구성마다의 '중앙값 ÷ 최솟값': 중앙값 1.93, 최소 1.02, 최대 1.95. 이 비가 1.3 보다 작은 구성 20개, 큰 구성 388개
  → 같은 구성의 값이 빠른 무리와 느린 무리로 갈린다 (중앙값이 어느 무리에 떨어지는지는 구성마다 다를 수 있다). 지연 시간의 대푯값으로 최솟값을 쓴다
[시간] 배치 64: 구성마다 16번, 65초 ('중앙값 ÷ 최솟값' 의 중앙값 1.11, 최대 1.90; 여기서도 최솟값을 쓴다). 그림 한 장당 0.034 – 0.316 ms (처리량 초당 3,165 – 29,038장), 기본 구성 0.156 ms (초당 6,430장)
  디코더 층 수별 (그 층 수인 구성들의 중앙값과 범위): 0층 배치 1 1.68 ms (1.57 – 1.78) · 배치 64 0.093 ms/장, 1층 배치 1 2.35 ms (2.25 – 2.44) · 배치 64 0.103 ms/장, 2층 배치 1 2.71 ms (2.60 – 2.81) · 배치 64 0.107 ms/장, 3층 배치 1 3.06 ms (2.92 – 3.15) · 배치 64 0.111 ms/장
  연산량(MFLOPs)과의 순위 상관(스피어만): 배치 1 지연 시간 -0.102, 배치 64 장당 시간 +0.909 | 디코더 층 수와의 순위 상관: 배치 1 +0.968, 배치 64 +0.180
  GPU 메모리 최대 사용 256 MiB
[기계 상태] load average 3.4 (CPU 코어 16개), GPU 사용률 · 메모리 94 %, 919 MiB, GPU 를 쓰는 프로세스 1개 (이 프로세스 포함)
저장: ch12_search.json  |  측정 전체 873초
- 그림 12-10: ch12-latency.png 위 왼쪽: 프로세스에서 처음 부른 순전파 40번의 시간(로그 축). 위 가운데: 기본 구성을 네 가지 방식으로 잰 시간의 분포(상자 = 25 – 75%, 가로선 = 중앙값). 위 오른쪽: 기본 구성을 60번 잰 값의 히스토그램. 빨간 선이 최솟값, 검은 점선이 중앙값. 아래 왼쪽 · 가운데: 구성마다의 연산량(가로)과 배치 1 지연 시간 · 배치 64 의 그림 한 장당 시간(세로). 색은 디코더 층 수. 아래 오른쪽: 격자 크기에 따른 시간(가장 작은 격자를 1 로 둔 상대값).
- (그림 내용) 여섯 칸. 위: 프로세스의 첫 순전파들의 시간, 재는 방법에 따른 시간의 상자 그림, 기본 구성을 60번 잰 값의 히스토그램. 아래: 연산량에 따른 배치 1 지연 시간, 연산량에 따른 배치 64 의 장당 시간, 격자 크기에 따른 상대 시간.
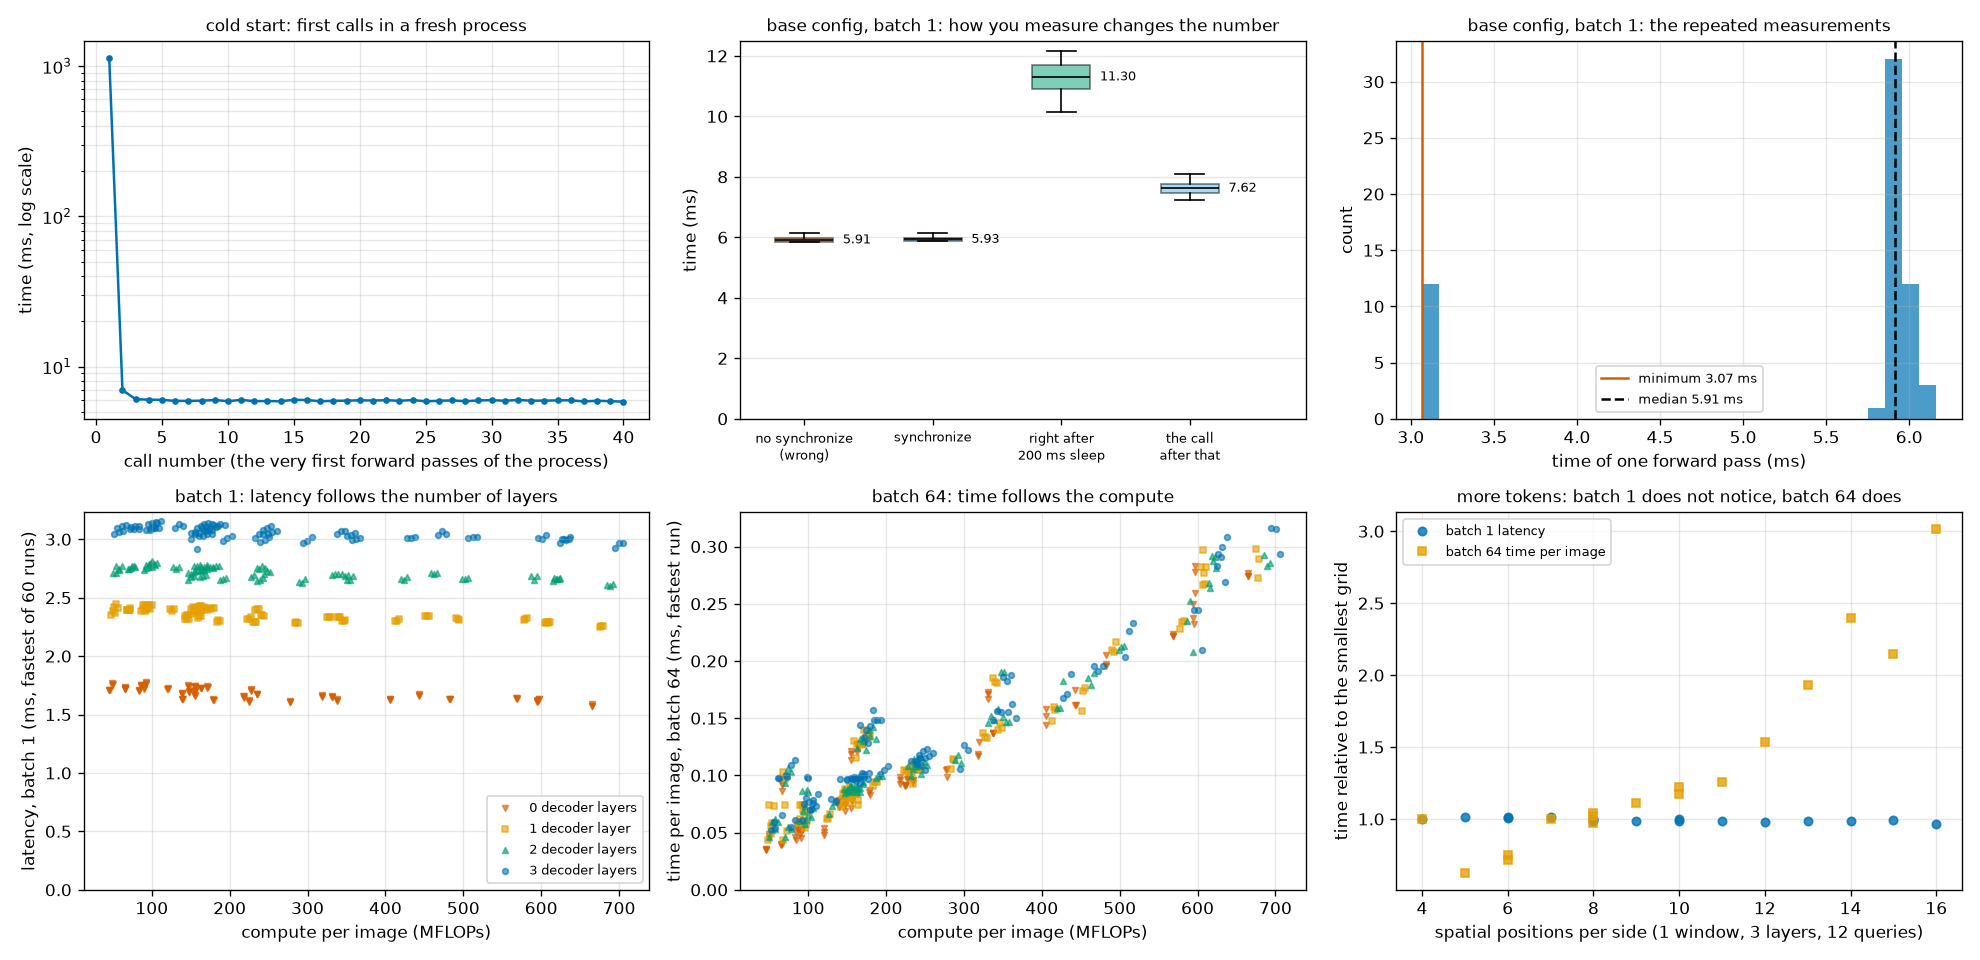
- 히스토그램(위 오른쪽)이 두 봉우리이다. 기본 구성의 60번 가운데 12번(20 라운드 가운데 4 라운드)이 3.1 ms 근처, 나머지가 5.9 ms 근처이다. 중앙값은 5.91 ms, 최솟값은 3.07 ms 이다. 구성 408개 가운데 20개는 중앙값이 빠른 쪽에 떨어졌다. 중앙값으로 줄을 세웠다면 이 20개가 까닭 없이 두 배 빠른 구성으로 보였을 것이다. 최솟값으로는 같은 디코더 층 수인 구성들이 0.2 ms 남짓한 폭 안에 모인다.
- 배치 1 의 지연 시간은 디코더 층 수로 정해진다(아래 왼쪽). 0 · 1 · 2 · 3층이 1.68 · 2.35 · 2.71 · 3.06 ms 의 네 줄로 갈리고, 줄 안에서는 연산량이 45 MFLOPs 든 700 MFLOPs 든 평평하다. 지연 시간과 디코더 층 수의 순위 상관은 +0.968, 연산량과의 순위 상관은 −0.102 이다. 연산량이 15배 차이 나는데 시간에는 보이지 않는다.
- 배치 64 의 장당 시간은 연산량을 따른다(아래 가운데). 순위 상관 +0.909 이다. 0.034 – 0.316 ms 로 9배 벌어지고, 처리량으로는 초당 3,165 – 29,038장이다. 여기서는 디코더 층 수가 거의 보이지 않는다(순위 상관 +0.180).
- 토큰을 늘려도 배치 1 은 모른다(아래 오른쪽). 격자를 4×4 에서 16×16 으로 키우면(토큰 16배, 연산량 11배) 배치 64 의 장당 시간은 3배(0.098 → 0.294 ms)가 되지만 배치 1 의 지연 시간은 그대로이다(3.07 → 2.96 ms).
왜 이런 차이가 날까? 이 미니 모델을 PyTorch 로 한 장씩 돌리면 GPU 는 대부분의 시간을 놀고 있다. 시간을 쓰는 것은 CPU 가 파이썬 코드를 따라가며 GPU 연산을 하나씩 내보내는 일 이고, 그 비용은 연산의 크기가 아니라 개수 에 비례한다. 토큰이 144개든 256개든 내보내는 연산의 수는 같고, 디코더 층을 하나 떼면 그 층의 연산 수십 개가 통째로 사라진다. 앞 절에서 CPU 코어를 바꾸자 “GPU 지연 시간” 이 달라진 것과 같은 현상이다. 배치 64 에서는 연산 하나하나가 커져 GPU 의 계산 시간이 드러나고, 그제야 연산량이 시간을 정한다.
논문이 TensorRT 의 CUDA graphs 를 켠 이유가 바로 이것이다. 커널을 미리 한꺼번에 줄 세워 “CPU 가 하나씩 내보내는 비용” 을 없애면, 지연 시간이 실제 계산량을 더 충실히 반영한다. 논문의 T4 측정에서는 해상도를 640 에서 576 으로 낮추자 지연 시간이 4.7 에서 4.0 ms 로 줄었다(표 5). 거기서는 토큰 수가 지연 시간에 보인다.
이 차이는 파레토 경계를 바꾼다. 배치 1 의 지연 시간을 가로축으로 뽑은 경계이다.
[파레토 경계] 가로축 = 배치 1 ms: 408개 가운데 21개가 경계 위
  해상도 / 패치 / 윈도 / 층 / 질의 | 학습 때 | NAS: AP AP50   AP75   | 고정   | MFLOPs  | 배치 1 ms | 배치 64 ms/장
  128 /  8 / 1 / 0 /  4 | 봄  | 0.7473 0.9812 0.9021 | 0.1513 |   664.6 |  1.57 | 0.275
  128 /  8 / 1 / 0 /  8 | 봄  | 0.7606 0.9937 0.9156 | 0.1631 |   664.9 |  1.57 | 0.274
  128 /  8 / 1 / 0 / 12 | 봄  | 0.7614 0.9936 0.9155 | 0.1643 |   665.2 |  1.59 | 0.277
   88 /  8 / 1 / 0 /  8 | 못 봄 | 0.8094 0.9884 0.9613 | 0.6773 |   277.6 |  1.61 | 0.105
   80 /  8 / 1 / 0 /  4 | 봄  | 0.8137 0.9837 0.9520 | 0.3981 |   224.6 |  1.61 | 0.090
   80 /  8 / 1 / 0 /  8 | 봄  | 0.8185 0.9899 0.9590 | 0.4076 |   224.9 |  1.61 | 0.092
   72 /  8 / 1 / 0 / 12 | 못 봄 | 0.8207 0.9871 0.9442 | 0.1623 |   179.3 |  1.62 | 0.083
   64 /  8 / 1 / 0 /  8 | 봄  | 0.8213 0.9838 0.9490 | 0.0070 |   139.3 |  1.63 | 0.072
   64 /  8 / 1 / 0 / 12 | 봄  | 0.8215 0.9834 0.9495 | 0.0071 |   139.6 |  1.63 | 0.073
   80 /  8 / 2 / 0 /  8 | 봄  | 0.8224 0.9900 0.9619 | 0.4069 |   217.9 |  1.65 | 0.099
   80 /  8 / 2 / 0 / 12 | 봄  | 0.8227 0.9899 0.9621 | 0.4075 |   218.1 |  1.66 | 0.096
  128 /  8 / 1 / 1 /  4 | 봄  | 0.8787 0.9749 0.9635 | 0.2171 |   675.0 |  2.25 | 0.298
  128 /  8 / 1 / 1 /  8 | 봄  | 0.9137 0.9792 0.9723 | 0.2530 |   677.2 |  2.26 | 0.273
  128 /  8 / 1 / 1 / 12 | 봄  | 0.9372 0.9961 0.9871 | 0.2808 |   679.4 |  2.26 | 0.289
  128 /  8 / 2 / 1 / 12 | 봄  | 0.9374 0.9959 0.9874 | 0.2793 |   609.1 |  2.30 | 0.267
  112 /  8 / 1 / 1 / 12 | 봄  | 0.9395 0.9952 0.9880 | 0.6597 |   495.0 |  2.31 | 0.216
  112 /  8 / 2 / 1 / 12 | 봄  | 0.9408 0.9952 0.9878 | 0.6649 |   455.6 |  2.34 | 0.177
  128 /  8 / 1 / 2 /  8 | 봄  | 0.9435 0.9927 0.9885 | 0.2463 |   688.7 |  2.60 | 0.283
  128 /  8 / 1 / 2 / 12 | 봄  | 0.9526 0.9983 0.9899 | 0.2741 |   692.5 |  2.62 | 0.286
  128 /  8 / 1 / 3 / 12 | 봄  | 0.9569 0.9985 0.9899 | 0.3038 |   705.6 |  2.96 | 0.294
  128 /  8 / 4 / 3 / 12 | 봄  | 0.9575 0.9984 0.9898 | 0.3081 |   637.3 |  3.02 | 0.308
    경계 위 구성이 쓰는 resolution: [64, 72, 80, 88, 112, 128]
    경계 위 구성이 쓰는 patch_size: [8]
    경계 위 구성이 쓰는 num_windows: [1, 2, 4]
    경계 위 구성이 쓰는 dec_layers: [0, 1, 2, 3]
    경계 위 구성이 쓰는 num_queries: [4, 8, 12]
- 경계 위의 구성이 59개에서 21개로 줄었고, 모두 패치 8 이다. 연산량으로 뽑은 경계의 절반을 차지하던 패치 12 · 16 의 구성은 하나도 남지 않았다. 디코더가 1층 이상인 구성은 해상도 112 · 128 뿐이다.
- 까닭은 단순하다. 이 측정에서 토큰을 늘리는 것은 공짜이다. 공짜라면 가장 큰 격자를 쓰는 것이 언제나 유리하고, 격자를 줄인 구성은 모두 “같은 시간에 덜 정확한” 지배당하는 점이 된다. 시간을 줄이는 손잡이는 디코더 층 수뿐이므로 경계는 디코더 0 → 1 → 2 → 3층을 따라 네 계단을 이룬다(그림 12-6 오른쪽). 디코더 0층의 계단에만 낮은 해상도가 섞여 있는데, 앞에서 본 대로 NAS 모델의 0층 AP 가 해상도가 높을수록 낮기 때문이다.
- 같은 계단 안의 순서는 읽지 마라. 같은 디코더 층 수인 구성들의 지연 시간은 0.2 ms 남짓한 폭 안에 있고, 그 안의 차이는 측정의 흔들림과 구별되지 않는다. 경계에 오른 구성이 그 계단에서 “가장 빠른” 구성이라는 뜻은 아니다.
핵심 · 파레토 경계는 모델만의 성질이 아니다. 같은 가중치, 같은 408개 구성, 같은 AP 인데 가로축을 연산량에서 이 PC 의 배치 1 지연 시간으로 바꾸자 “좋은 구성” 의 목록이 바뀌었다. 파레토 경계는 모델 + 하드웨어 + 실행 방식 의 성질이다. 논문이 T4 의 TensorRT FP16 엔진이라는 조건을 못박고 측정 절차를 표준화한 것, 탐색에 1만 GPU 시간을 들여 구성마다 실제 지연 시간을 잰 것은 그래서이다. 가중치 공유 NAS 의 실용적인 값도 여기에 있다. 배치할 장비가 바뀌면 AP 는 그대로 두고 지연 시간만 다시 재어 경계를 다시 뽑으면 된다. 학습은 다시 하지 않는다.
NAS 뒤 미세 조정의 미니 점검
마지막으로 논문 부록 G 의 질문을 미니 실험으로 던져 본다. 파레토 위의 구성 하나를 골랐다면, 그 구성만으로 조금 더 학습하면 더 좋아질까? NAS 모델의 EMA 가중치에서 출발해 10 에폭을 더 학습한다(학습률 등은 그대로, 시드 0 한 번). 네 가지를 견준다.
- 대조군: NAS 학습을 그대로 10 에폭 더 한다(구성을 계속 무작위로). “그냥 더 오래 학습한 효과” 를 가려내기 위한 것이다.
- 구성 하나로 고정: 가장 작은 격자(64 / 16 / 윈도 1, 격자 4×4), 중간(64 / 8 / 윈도 2, 격자 8×8), 기본 구성(96 / 8 / 윈도 2, 격자 12×12) 각각으로 고정해 10 에폭.
[NAS 뒤 미세 조정] ch12_nas.pt 의 EMA 가중치에서 출발해 10 에폭 더 학습 (학습률 등은 그대로, 시드 0)
  NAS 를 계속 (대조군)         학습 끝 (130초)
  64/16/w1 로 고정          학습 끝 (138초)
  64/8/w2 로 고정           학습 끝 (114초)
  96/8/w2 로 고정           학습 끝 (106초)
  채점하는 구성 →            | 64/16/w1         | 64/8/w2          | 96/8/w2
  미세 조정 전 (NAS 모델)     | 0.6677           | 0.9208           | 0.9498
  NAS 를 계속 (대조군)             | 0.6883 (+0.0205) | 0.9285 (+0.0077) | 0.9520 (+0.0022)
  64/16/w1 로 고정              | 0.7210 (+0.0533) | 0.5974 (-0.3235) | 0.5229 (-0.4269)
  64/8/w2 로 고정               | 0.1558 (-0.5119) | 0.9282 (+0.0074) | 0.8416 (-0.1082)
  96/8/w2 로 고정               | 0.0087 (-0.6591) | 0.5912 (-0.3297) | 0.9582 (+0.0084)
  (괄호 = 미세 조정 전과의 차이. 대각선 — 고정한 구성과 채점하는 구성이 같은 칸 — 이 '그 구성만으로 미세 조정' 의 효과다)
전체 517초
표의 줄이 “어떻게 더 학습했는가”, 칸이 “어느 구성에서 채점했는가” 이다(디코더 3층 · 질의 12개). 대각선이 미세 조정의 효과이고, 대조군 줄과 견주어야 한다.
- 중간 구성(64 / 8)은 이득이 없다. 고정 미세 조정 +0.0074, 대조군 +0.0077 이다. 구성을 고정하든 계속 섞든 같다.
- 기본 구성(96 / 8)은 대조군보다 0.006 높다(+0.0084 대 +0.0022). 방향은 이득이지만 11장에서 본 실행 간 흔들림(0.005 안팎)과 같은 크기라, 시드 하나로는 이득이 있다고 말하기 어렵다.
- 가장 작은 구성(64 / 16)은 눈에 띄게 오른다(+0.0533, 대조군 +0.0205). 격자 4×4 는 다른 구성들과 가장 동떨어진 부분망이고, 확인 문제 5 의 장난감 문제처럼 “멀리 떨어진 것을 원하는 구성일수록 공유 때문에 많이 양보한다” 는 그림과 맞다.
- 미세 조정한 모델은 더는 가족이 아니다. 대각선 밖의 칸을 보라. 96 / 8 로 고정해 10 에폭을 더 학습하면 64 / 8 에서 0.9208 → 0.5912, 64 / 16 에서 0.6677 → 0.0087 로 무너진다. 겨우 10 에폭 만에 고정 구성 모델과 같은 처지가 된다. 미세 조정은 한 번의 학습으로 얻은 가족을 포기하고 모델 하나를 얻는 선택이다.
논문의 관찰과 견주면 방향이 같다. COCO 에서 미세 조정의 이득은 N 에서 +0.4, S – L 에서 0.0 – 0.1 AP 로, 가장 작은 모델에서만 조금 보였다. 논문이 “미세 조정은 선택 사항” 이라고 한 것과 이 미니 실험의 결과가 어긋나지 않는다. 다만 여기서는 대조군(NAS 를 더 하는 것)도 계속 오르고 있었으므로, 60 에폭의 NAS 학습이 아직 수렴하지 않은 상태에서의 비교라는 점을 감안해야 한다.
이 실험이 말해 주는 것과 말해 주지 않는 것
미니 실험에서 확인한 것을 논문의 주장과 나란히 놓는다.
| 논문의 주장 (COCO · RF100-VL) | 이 장의 미니 실험 (도형 세상) | 판정 |
| 한 번의 학습에서 파레토 곡선 위의 모든 모델이 나온다 | 408개 구성 가운데 321개가 AP 0.8 이상. 연산량 14배 범위의 경계가 가중치 한 벌에서 나옴 | 같은 모습 |
| NAS 로 학습하면 기반 구성의 성능도 오른다 (+0.3 AP, 구조 증강) | 기본 구성 0.9345 → 0.9498 (시드 2개 일치). 일반화 간격이 0.94 → 0.12 로 줄어듦 | 방향은 같음. 다중 해상도 증강의 효과와 가르지 못함 |
| 디코더 층 · 질의는 추론 때만 줄여도 된다 | 고정 구성 모델에서도 디코더 층 · 질의 · 윈도 손잡이는 동작 | 같은 모습 |
| 성능은 공간 위치 수(해상도 ÷ 패치)를 따른다 | 격자가 같은 구성들의 AP 차이 0.004 이하 | 같은 모습 (더 뚜렷) |
| 학습 때 못 본 구성도 추세를 따른다 | 못 본 해상도 4개 · 못 본 패치 12 가 곡선 위에 놓임 | 같은 모습 |
| 윈도는 대개 2 가 최적 (CLS 복제 때문) | AP 는 윈도 수와 무관, 연산량은 윈도 2 가 최소 | 연산량 쪽만 확인 |
| NAS 뒤 미세 조정은 이득이 거의 없다 (작은 모델에서만 조금) | 가장 작은 구성에서만 뚜렷한 이득 | 같은 방향 (시드 1개) |
| (논문에 없음) | 디코더 0층에서는 NAS 모델이 고정 구성 모델보다 0.09 낮음 | 가중치 공유의 손해가 드러난 부분망 |
그리고 이 실험으로는 말할 수 없는 것들이다.
- 수치의 크기. 도형 세상은 객체가 크고 배경이 단순하다. 해상도를 반으로 줄여도 AP 가 0.04 밖에 내려가지 않는 것은 이 데이터의 성질이다. COCO 에서는 손잡이마다의 값이 훨씬 크다.
- 사전 학습 백본과의 관계. 논문의 모델은 DINOv2 에서 출발하고, 패치 14 로 사전 학습된 패치 임베딩을 다른 크기로 바꿔 쓴다. 미니 모델은 무작위 초기화에서 출발했다.
- 지연 시간에 대한 결론. 이 PC 에서 PyTorch 로 잰 값은 T4 의 TensorRT 엔진과 전혀 다른 병목을 갖는다(위의 “가로축을 바꾸면” 절). 어느 구성이 실제로 빠른지는 배치할 환경에서 재야 안다.
- 탐색에 쓴 검증 세트에 대한 과적합. 408개 가운데 최댓값을 고르면 고른 값은 낙관적으로 치우친다. 논문도 COCO 검증 세트로 모델을 고르고 같은 세트로 보고하는 관행의 위험을 직접 언급한다. 이 장에서는 고른 구성을 시험 세트에서 다시 채점하지 않았다. 0.001 단위의 순위(윈도 1 · 2 · 4 가운데 무엇이 최고인가 같은)는 읽지 않아야 한다.
실전과 연결
이 장에서 본 것이 실제 RF-DETR 을 쓸 때 어디에서 보이는지 정리한다.
- 공개된 N · S · M · L 이 바로 이렇게 찾은 구성이다. 14장에서
RFDETRNano,RFDETRSmall… 의 설정을 찍어 보면 표 7 의 값(Nano: 해상도 384, 패치 16, 윈도 2, 디코더 2층, 질의 300)이 그대로 나온다. 네 크기의 백본은 모두 같은 DINOv2-S 이고, 달라지는 것은 해상도와 디코더 층 수뿐이다. 저장소의 README 도 “공개된 RF-DETR 크기들은 신경망 구조 탐색으로 만들어졌다” 고 적는다. 다만 공개된 체크포인트는 크기마다 파일이 따로이고, 그 가중치들이 공유 가중치 한 벌을 그대로 나눠 담은 것인지 구성별로 미세 조정을 거친 것인지는 이 튜토리얼이 확인하지 못했다. - 공개 패키지에는 NAS 학습 코드가 없다. 이 튜토리얼이 살펴본
rfdetr저장소에는 구성을 스텝마다 뽑는 학습 고리나 패치 임베딩 변환이 들어 있지 않았다. 패치 크기 · 디코더 층 수 · 질의 수는 모델을 만들 때 정한다. 남아 있는 흔적은 다중 해상도 학습(11장: 배치 단위로 해상도를 바꿈)이다. - 그래서 실제 모델에서도 해상도 손잡이는 돌아간다. 14장에서 미세 조정한 Nano(학습 해상도 384)를 추론 해상도만 바꿔 채점했을 때, AP 가 192 에서 0.9566, 256 에서 0.9810, 384 에서 0.9830, 한 번도 쓰지 않은 640 에서 0.9833 이었다. 이 장의 고정 구성 모델이 해상도를 조금만 벗어나도 무너진 것과 대조된다. 차이는 학습 때 여러 해상도를 겪었느냐이다. 해상도가
patch_size × num_windows(= 32)의 배수여야 한다는 제약도 이 장의is_valid와 같은 것이다. -
num_select는 질의 수 손잡이가 아니다. 14장에서num_select를 300 에서 20 으로 줄여도 AP 가 그대로였고(0.9830) 2 로 줄이자 0.7116 으로 무너졌다. “객체 수의 상한보다 넉넉해야 한다” 는 교훈은 이 장의 질의 수 실험과 같지만,num_select는 후처리만 줄이고 디코더의 계산은 줄이지 않는다. - 내 데이터에서 NAS 를 돌리려면. README 는 같은 NAS 방법을 Roboflow 플랫폼에서 쓸 수 있다고 안내하고, 논문 발표 뒤 플랫폼의 NAS 학습을 더 개선해 “한 번의 학습으로 모든 크기를 얻으며, 공개 체크포인트와 논문의 NAS 결과보다 나은 결과” 를 낸다고 적는다. 이것은 README 의 설명이고 이 튜토리얼이 재 본 것은 아니다. NAS 로 만든 모델과 일부 크기의 사용 조건(라이선스)도 README 에 따로 적혀 있으니 쓰기 전에 확인하라.
- 지연 시간은 내 장비에서, 쓸 방식 그대로 잰다. 이 장의 측정에서 같은 구성의 시간이 CPU 코어와 그 순간의 기계 상태에 따라 두 배 가까이 달라졌다. 표의 숫자(T4, TensorRT, FP16)는 그 조건에서의 값이다. 14장에 실제 모델을 PyTorch · ONNX Runtime 으로 재는 실습이 있다.
정리
- 알맞은 모델 크기는 하드웨어와 데이터마다 다르다. 크기마다 따로 설계 · 학습하는 대신, 가중치 공유 NAS 는 가중치 한 벌이 탐색 공간의 모든 구성에서 동작하도록 한 번 학습하고, 그 뒤에는 재학습 없이 구성을 골라 꺼낸다.
- 모델 \(i\) 가 \(j\) 를 지배 한다는 것은 \(t_i \le t_j\), \(a_i \ge a_j\) 이고 둘 중 하나가 진짜로 나은 것이다. 지배당하지 않는 모델이 파레토 최적 이고, 비용으로 정렬한 뒤 정확도의 누적 최댓값을 넘는 점만 남기면 파레토 경계가 나온다.
- 학습 목표는 구성마다의 손실의 평균 \(\mathbb{E}_{c}[\mathcal{L}(\theta; c)]\) 이다. 스텝마다 구성 하나를 균등하게 뽑아 갱신하면 기울기의 기댓값이 이 목표의 기울기와 같다. 가중치를 공유하면 구성들이 서로 양보해야 하지만, 구성이 계속 바뀌는 것이 정규화(구조 증강)로도 작용한다.
- 다섯 손잡이는 저마다 다른 이유로 가중치를 그대로 쓴다. 패치 크기 는 PI-resize \(\hat{w} = (R^\top)^{+} w\) 로 내적을 지키며 커널을 바꾸고, 디코더 층 은 모든 층에 걸어 둔 손실 덕분에, 질의 는 점수 순으로 뽑힌 덕분에 추론 때 줄일 수 있다. 해상도 는 위치 임베딩을 보간하고(박스가 정규화 좌표라 머리는 그대로), 윈도 는 가중치가 없어 묶는 방식만 바꾼다.
- 해상도 · 패치 · 윈도는 학습 때부터 바꾸고, 디코더 층 · 질의는 추론 때만 바꾼다. 논문은 6,468개 구성(11 × 7 × 7 × 3 × 4)을 격자 탐색했고, 찾아낸 N – 2XL 은 주로 해상도와 디코더 깊이로 크기를 키운다. 성능은 해상도 · 패치 각각보다 공간 위치 수(해상도 ÷ 패치)를 따른다.
- 지연 시간은 재는 방법에 따라 달라진다. 동기화하고, 예열을 버리고, 여러 번 재고, 견줄 것들을 번갈아 재야 한다. 논문은 순전파 사이에 200 ms 를 쉬어 전력 제한을 피하고, 정확도와 지연 시간을 같은 산출물로 보고한다.
- 미니 실험: 같은 60 에폭으로 NAS 학습한 모델은 408개 구성 가운데 321개에서 AP 0.8 을 넘었고, 기본 구성의 AP 도 고정 구성 모델보다 높았다(0.9498 대 0.9345). 고정 구성 모델은 학습한 해상도 · 패치를 벗어나면 무너졌다. 격자가 같은 구성들의 AP 는 0.004 안에서 같았고, 학습 때 못 본 해상도 · 패치도 추세 위에 놓였다. 반면 디코더 0층에서는 NAS 모델이 0.09 낮았다.
- 같은 구성들을 연산량으로 줄 세운 파레토 경계와 이 PC 의 배치 1 지연 시간으로 줄 세운 경계는 달랐다. 파레토 경계는 모델 + 하드웨어 + 실행 방식의 성질이고, 가중치 공유 NAS 에서는 장비가 바뀌면 지연 시간만 다시 재면 된다.
이 장으로 RF-DETR 탐지기의 이야기가 한 바퀴 돌았다. 구조(10장), 학습(11장), 그리고 그 한 번의 학습에서 모델 가족을 꺼내는 방법(이 장)이다. 남은 것은 논문이 같은 틀 위에 얹은 둘째 과제, 인스턴스 분할이다. 13장에서는 디코더의 질의 임베딩과 픽셀 임베딩 맵의 내적으로 마스크를 만드는 가벼운 분할 머리를 붙인다. 이 장에서 본 손잡이들이 분할에서는 조금 다르게 움직인다는 것(마스크 특징의 해상도가 입력 해상도에 묶여 있어 “공간 위치 수” 만으로는 설명되지 않는다는 것)도 그 구조를 보면 이해가 된다.
확인 문제
- 1. 파레토 경계 찾기
- 일곱 모델의 (지연 시간 ms, AP) 가 다음과 같다: P (2, 40), Q (3, 52), R (3, 48), S (4, 50), V (5, 53), T (6, 55), U (7, 55). “정렬하고 한 번 훑기” 로 파레토 경계를 찾고, 경계에 들지 못한 모델마다 그것을 지배하는 모델을 하나씩 대라.
- 지연 시간이 작은 순으로(같으면 AP 가 큰 것을 앞에) 늘어놓으면 P, Q, R, S, V, T, U 이다. 지금까지의 최댓값을 기억하며 훑는다.
- P 40 → 경계(최댓값 40). Q 52 → 경계(52). R 48 → 버림. S 50 → 버림. V 53 → 경계(53). T 55 → 경계(55). U 55 → 55 를 넘지 못하므로 버림.
- 파레토 경계는 P, Q, V, T 이다. R 은 Q 에게(지연 시간이 같고 AP 가 낮음), S 는 Q 에게(더 느리고 덜 정확함), U 는 T 에게(AP 가 같고 더 느림) 지배당한다.
- (1) \(3 \times 2 \times 3 \times 4 \times 2 = 144\) 개이다.
- (2) 격자의 한 변은 패치 8 에서 \(64/8 = 8\), \(96/8 = 12\), \(128/8 = 16\), 패치 16 에서 \(64/16 = 4\), \(96/16 = 6\), \(128/16 = 8\) 이다. 윈도 1 · 2 · 4 가운데 격자를 나누는 것의 수는 8 → 3개, 12 → 3개, 16 → 3개, 4 → 3개, 6 → 2개(4 로는 안 나누어떨어짐), 8 → 3개이다.
- 백본 쪽 조합은 \(3 + 3 + 3 + 3 + 2 + 3 = 17\) 개이고, 여기에 디코더 층 4가지 × 질의 2가지를 곱해 \(17 \times 8 = 136\) 개이다. 8개가 빠졌다(96 / 16 / 윈도 4 인 구성 \(1 \times 8\) 개).
- (1) Nano: \(384/16 = 24\), \(24^2 = 576\) 개. Medium: \(576/16 = 36\), \(36^2 = 1{,}296\) 개. 비는 \(1296/576 = 2.25\) 배이다(한 변이 1.5배이므로 \(1.5^2\)).
- (2) Max: \(828/12 = 69\), \(69^2 = 4{,}761\) 개. Nano 의 약 8.3배이다.
- (3) \(560/14 = 40\) 과 \(640/16 = 40\) 으로 둘 다 \(40^2 = 1{,}600\) 개이다. 공간 위치 수가 같다. 표 5 에서 이 변경은 AP 54.6 → 54.4, 지연 시간 4.7 ms 그대로였다. 성능이 해상도 · 패치 각각보다 둘의 비를 따른다는 관찰과 맞다.
- (1) \(\langle x, w \rangle = 1 \cdot 2 + 3 \cdot 0 = 2\).
- (2) \(z = (R^\top R)^{-1} w = (0.65 \cdot 2,\ -0.15 \cdot 2) = (1.3,\ -0.3)\). \(\hat{w} = Rz = (1.3,\ 0.75 \cdot 1.3 + 0.25 \cdot (-0.3),\ 0.25 \cdot 1.3 + 0.75 \cdot (-0.3),\ -0.3) = (1.3,\ 0.9,\ 0.1,\ -0.3)\).
- (3) \(Rx = (1,\ 0.75 + 0.75,\ 0.25 + 2.25,\ 3) = (1,\ 1.5,\ 2.5,\ 3)\). \(\langle Rx, \hat{w} \rangle = 1.3 + 1.35 + 0.25 - 0.9 = 2\). 원래 내적과 같다.
- (4) \(Rw = (2,\ 1.5,\ 0.5,\ 0)\). \(\langle Rx, Rw \rangle = 2 + 2.25 + 1.25 + 0 = 5.5\), 절반은 \(2.75\). 어느 쪽도 2 가 아니다.
- \(\hat{w}\) 의 마지막 값이 음수(\(-0.3\))인 것에 주목하라. 원래 커널에는 음수가 없었다. PI-resize 는 보간과 달리 원래 값의 범위를 벗어난 값을 만들 수 있고, FlexiViT 논문도 PI-resize 행렬에 음의 가중치가 들어 있다고 적는다.
- (1) \(J(\theta) = \tfrac{1}{3}\sum_k (\theta - k)^2\), \(\nabla J = \tfrac{2}{3}\big[(\theta - 1) + (\theta - 2) + (\theta - 6)\big] = 2\theta - 6\). 0 이 되는 곳은 \(\theta^\star = 3\)(세 값의 평균)이다. 손실은 \((3-1)^2 = 4\), \((3-2)^2 = 1\), \((3-6)^2 = 9\) 이고 평균은 \(14/3 \approx 4.67\) 이다.
- (2) \(\theta = 0\) 에서 기울기는 \(2(0-1) = -2\), \(2(0-2) = -4\), \(2(0-6) = -12\) 이고 평균은 \(-6\) 으로 \(2 \cdot 0 - 6\) 과 같다. 어느 구성을 뽑아도 방향은 같고 크기만 다르다.
- (3) 따로 학습하면 \(\theta = 6\) 에서 손실 0 이다. 공유했을 때의 9 와의 차이가 “다른 구성에 양보한 값” 이다. 다른 구성들과 멀리 떨어진 것을 원하는 구성일수록 많이 양보한다. 실제 신경망에서는 가중치가 많아 양보가 훨씬 작을 수 있고, 양보가 과적합을 막아 오히려 이득이 될 수도 있다(이 장의 실험에서 기본 구성이 그랬다).
- \(W = 1\): 모든 블록이 \(65^2 = 4{,}225\) 쌍이므로 \(6 \times 4{,}225 = 25{,}350\) 쌍.
- \(W = 2\): 윈도 하나에 \(16 + 1 = 17\) 토큰. 윈도 블록 하나는 \(4 \times 17^2 = 1{,}156\) 쌍, 전역 블록 하나는 \((64 + 4)^2 = 4{,}624\) 쌍. 합계 \(4 \times 1{,}156 + 2 \times 4{,}624 = 4{,}624 + 9{,}248 = 13{,}872\) 쌍.
- \(W = 2\) 는 \(W = 1\) 의 약 55% 이다. 다만 쌍의 수는 어텐션의 계산량일 뿐이고, 토큰마다 드는 선형 층의 계산은 토큰 수 \(N + W^2\) 에 비례해 오히려 늘어난다(\(65 \to 68\)). 전체 연산량이 얼마나 줄지는 둘의 비중에 달려 있다.
- (1) 보조 손실이다. 인코더 제안과 모든 디코더 층의 출력에 같은 머리와 같은 손실을 걸어 학습하므로, 각 층의 출력이 그 자체로 예측이 되도록 이미 학습되어 있다. \(k\) 층에서 멈춘 모델의 출력은 전체 모델의 \(k\) 번째 보조 출력과 정확히 같다.
- (2) 2단계 질의 선택이 특징 맵의 칸들을 인코더 쪽 클래스 점수 순으로 뽑으므로, 질의에 이미 순위가 있다. 상위 \(N'\) 개만 쓰면 점수가 낮은 것부터 버리는 셈이다. DETR 의 질의는 그림과 무관한 학습된 벡터라 그림마다의 순위가 없고, 이 방법을 쓸 수 없다.
- (3) 이 둘은 백본이 받는 입력의 모양(토큰 수, 토큰 하나가 담는 영역, 위치 임베딩의 보간)을 바꾸는데, 한 가지 모양만 본 가중치는 다른 모양에서 동작하지 않기 때문이다. 해상도 96 · 패치 8 로만 학습한 11장 모델은 해상도 64 에서 AP 0.13, 128 에서 0.31, 패치 16 에서 0.00 이었다. 같은 구성에서 NAS 로 학습한 모델은 0.92, 0.96, 0.86 이다.
- (1) 이 작은 모델을 PyTorch 로 배치 1 에서 돌리면 GPU 가 계산하는 시간보다 CPU 가 연산을 하나씩 내보내는 시간이 더 크다. 그 시간은 토큰 수가 아니라 연산의 수(층의 수)로 정해진다. 그래서 해상도를 올리거나 패치를 줄여 토큰을 늘려도 지연 시간은 거의 그대로이고 AP 만 오른다. “같은 값이면 큰 해상도 · 작은 패치” 가 되어, 토큰을 줄이는 구성들은 모두 지배당한다. 지연 시간을 줄이는 손잡이는 디코더 층 수뿐이다.
- (2) 파레토 경계는 모델만의 성질이 아니라 모델 + 하드웨어 + 실행 방식 의 성질이다. 그러므로 탐색은 실제로 배치할 장비에서, 실제로 쓸 실행 환경(논문이라면 T4 의 TensorRT FP16 엔진)으로 잰 값으로 해야 한다. 가중치 공유 NAS 에서는 이것이 싸게 가능하다. 장비가 바뀌면 AP 는 그대로 두고 지연 시간만 다시 재어 경계를 다시 뽑으면 된다.
See also
- RF-DETR:Tutorial
- RF-DETR
- RF-DETR:Review
- DINOv2
- Vision Transformer
- Object detection
- YOLO
- Dropout
- TensorRT
Favorite site
- 12. 가중치 공유 NAS
- RF-DETR: Neural Architecture Search for Real-Time Detection Transformers (Robinson 외, 2025)
- Once-for-All: Train One Network and Specialize it for Efficient Deployment (Cai 외, 2019)
- FlexiViT: One Model for All Patch Sizes (Beyer 외, 2022)