WorldModels:Tutorial:02-Probability
lastmod 2026-11-18created 2026-11-172 edits
확률과 최대우도는 World Model 튜토리얼의 2장이다. World Model 은 미래를 숫자 하나가 아니라 확률 분포로 예측하고, 그 모델은 최대우도(maximum likelihood) 원리로 학습된다. 이 장은 확률의 기초(분포, 조건부 확률, 베이즈 정리, 기댓값과 분산, 가우시안)에서 출발해 평균 제곱 오차(MSE)와 교차 엔트로피 손실이 모두 음의 로그 가능도(NLL)라는 사실을 유도한다.
- 원문: 02. 수학 ① 확률과 최대우도
- 실습 코드:
code/ch02_probability.py(CPU 로 몇 초, GPU 불필요.--quick은 표본 수를 1/10 로 줄인다) - 이전: 01. World Model 이란 무엇인가 / 다음: 03. 정보 이론과 KL 발산
왜 확률이 필요한가
World Model 은 다음 상태를 예측하는 함수인데, 세상에는 세 종류의 불확실성이 있다.
- 세상 자체의 무작위성: 주사위, 바람, 다른 사람의 선택처럼 같은 상황에서도 결과가 매번 다르다.
- 보이지 않는 정보: 그림 한 장으로는 진자의 속도를 알 수 없어 다음 장면이 여러 가지로 가능해 보인다.
- 모델 자신의 무지: 본 적 없는 상황에서는 모델도 확신할 수 없다.
"다음 상태는 0.3 이다" 대신 "0.3 근처일 가능성이 크고 0.5 일 수도 있다"고 말하려면 어떤 값이 얼마나 그럴듯한지를 나타내는 확률 분포가 필요하다. 이 장의 개념은 뒤에서 다음과 같이 쓰인다.
| 이 장의 개념 | 쓰이는 곳 |
| 조건부 확률 \(p(y \mid x)\) | World Model \(p_\theta(s_{t+1} \mid s_t, a_t)\), 정책 \(\pi(a \mid s)\) (모든 장) |
| 베이즈 정리 | 그림을 보고 숨은 상태를 추측하는 인코더 \(q_\phi(z \mid o)\) (8장, 11장), POMDP 의 믿음 상태 (5장) |
| 기댓값, 몬테카를로 | 리턴의 기댓값 (5장), ELBO 추정 (8장), λ-리턴 (12장) |
| 가우시안, \(\mu + \sigma\epsilon\) | 확률적 동역학 (7장), VAE 의 재매개변수화 (8장), RSSM (11장), 행동 분포 (12장) |
| 최대우도, 음의 로그 가능도 | 모든 World Model 의 학습 손실 |
확률변수와 확률 분포
확률변수(random variable)는 무작위 실험의 결과에 붙인 숫자다. 관례상 확률변수는 대문자 \(X\), 그것이 가진 값은 소문자 \(x\) 로 쓰지만, 문맥이 분명하면 구별 없이 소문자로 쓰기도 한다.
확률질량함수
값이 셀 수 있게 떨어져 있으면 이산(discrete) 확률변수다. 각 값의 확률을 주는 함수가 확률질량함수(probability mass function, PMF)이며 \(P(X = x)\) 또는 \(p(x)\) 로 쓴다.
\(0 \le p(x) \le 1, \qquad \sum_{x} p(x) = 1\)
공정한 주사위는 \(p(1) = \cdots = p(6) = \tfrac{1}{6}\) 이다.
확률밀도함수
진자의 각도처럼 값이 실수 전체에 걸쳐 있으면 연속(continuous) 확률변수다. 가능한 값이 무한히 많아 한 점의 확률은 0 이므로 구간의 확률을 말하고, 이를 위해 확률밀도함수(probability density function, PDF)를 쓴다.
\(P(a \le X \le b) = \int_a^b p(x)\,dx = \lim_{\Delta x \to 0} \sum_{i} p(x_i)\,\Delta x\)
적분은 구간을 폭 \(\Delta x\) 인 얇은 막대로 잘라 넓이 \(p(x)\,\Delta x\) 를 모두 더한 것이다. 밀도함수의 조건은 PMF 의 합이 적분으로 바뀐 꼴이다.
\(p(x) \ge 0, \qquad \int_{-\infty}^{\infty} p(x)\,dx = 1\)
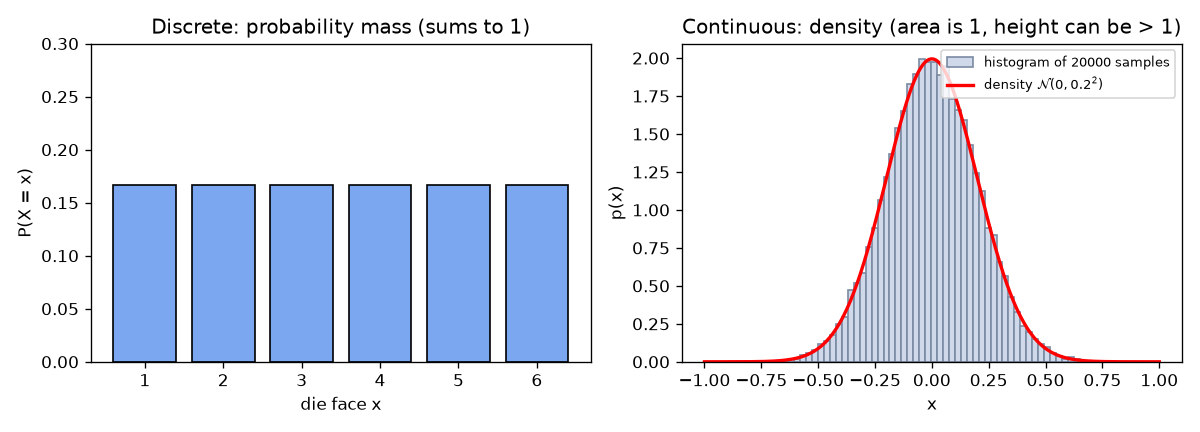
주의: 밀도는 확률이 아니다. 확률질량은 1 을 넘을 수 없지만 확률밀도는 1 을 넘을 수 있다. 밀도는 "단위 길이당 확률"이기 때문이다. 구간 \([0, 0.5]\) 의 균등 분포는 밀도가 구간 안에서 상수 \(c\) 이고, 넓이 \(0.5\,c = 1\) 에서 \(c = 2\) 가 된다. 밀도는 2 이지만 넓이(확률)는 정확히 1 이다.
실습 코드는 \(\sigma = 0.2\) 인 좁은 가우시안으로 같은 사실을 확인한다. np.sum(pdf) * (grid[1] - grid[0]) 는 높이 × 폭을 모두 더한 리만 합, 곧 적분의 근삿값이다.
def gaussian_pdf(x, mu, sigma):
    """1차원 가우시안 밀도  N(x; μ, σ²) = 1/(σ√(2π)) · exp(-(x-μ)² / (2σ²))."""
    return np.exp(-((x - mu) ** 2) / (2 * sigma**2)) / (sigma * np.sqrt(2 * np.pi))


def density_can_exceed_one(rng: np.random.Generator, n: int, fig_dir: str) -> None:
    mu, sigma = 0.0, 0.2
    x = rng.normal(mu, sigma, size=n)  # μ + σ·ε 로 뽑는 것과 같다
    grid = np.linspace(-1, 1, 400)
    pdf = gaussian_pdf(grid, mu, sigma)
    area = np.sum(pdf) * (grid[1] - grid[0])  # 넓이 = Σ 높이 × 폭 (리만 합)
    # 격자에 정확한 0 은 없어서 pdf.max() 는 p(±0.0025) 이지만, p(0) = 1.9947 과 거의 같다.
    print(f"[밀도] 최댓값 p(0) = {pdf.max():.4f} (1 보다 크다!),  밑넓이 ≈ {area:.4f}")
결합, 주변, 조건부 확률
World Model 은 지금 상태, 행동, 다음 상태처럼 여러 변수를 함께 다룬다. 날씨 \(X\)(맑음, 비)와 우산 \(Y\)(안 씀, 씀)를 100일 동안 기록한 비율을 예로 든다.
| 안 씀 | 씀 | 합 (주변 확률 \(p(x)\)) | |
| 맑음 | 0.45 | 0.05 | 0.50 |
| 비 | 0.10 | 0.40 | 0.50 |
| 합 (주변 확률 \(p(y)\)) | 0.55 | 0.45 | 1.00 |
- 결합 확률(joint probability) \(p(x, y)\)
- 두 일이 함께 일어날 확률이다. \(p(\text{비}, \text{씀}) = 0.40\). 표의 안쪽 네 칸이 결합 분포이고 합은 1 이다.
- 주변 확률(marginal probability) \(p(x)\)
- 다른 변수의 모든 경우를 더해서 없앤 확률이다. 이 계산을 주변화(marginalization)라고 한다. \(p(\text{비}) = 0.10 + 0.40 = 0.50\). 표의 가장자리(margin)에 적히는 값이다.
- 조건부 확률(conditional probability) \(p(y \mid x)\)
- \(x\) 가 일어났음을 알 때 \(y\) 의 확률이다. \(p(\text{씀} \mid \text{비}) = 0.40 / 0.50 = 0.8\). 조건부 확률도 \(y\) 에 대해 더하면 1 이다(\(0.2 + 0.8\)).
\(p(x) = \sum_{y} p(x, y) \quad \Big(\text{연속이면 } p(x) = \int p(x, y)\,dy\Big), \qquad p(y \mid x) = \frac{p(x, y)}{p(x)} \quad (p(x) \gt 0)\)
곱셈 법칙과 연쇄 법칙
조건부 확률의 정의 양변에 \(p(x)\) 를 곱하면 곱셈 법칙이 나온다. 두 번째 등호는 \(x\) 와 \(y\) 의 역할을 바꾼 것이다.
\(p(x, y) = p(y \mid x)\, p(x) = p(x \mid y)\, p(y)\)
변수가 셋 이상이면 곱셈 법칙을 거듭 써서 연쇄 법칙(chain rule)을 얻는다. \((x_1, x_2)\) 를 한 덩어리로 보고 한 번, 남은 \(p(x_1, x_2)\) 에 한 번 더 쓴다.
\(\begin{align} p(x_1, x_2, x_3) &= p(x_3 \mid x_1, x_2)\; p(x_1, x_2) \\ &= p(x_1)\; p(x_2 \mid x_1)\; p(x_3 \mid x_1, x_2) \end{align}\)
\(p(x_1, \dots, x_T) = \prod_{t=1}^{T} p(x_t \mid x_1, \dots, x_{t-1})\)
상태가 시간 순서로 이어질 때 이 식은 "전체 이야기의 확률 = 한 장면씩 다음 장면의 확률을 곱한 것"이라는 뜻이다. 여기에 5장의 마르코프 성질 \(p(s_{t+1} \mid s_1, \dots, s_t, a_1, \dots, a_t) = p(s_{t+1} \mid s_t, a_t)\) 을 더하면 한 에피소드의 확률이 World Model 이 예측하는 한 스텝 전이 확률들의 곱이 된다. 11장의 순차 ELBO 가 이 분해에서 출발한다.
독립
두 확률변수가 서로에 대해 아무 정보도 주지 않으면 독립(independent)이다.
\(p(x, y) = p(x)\, p(y) \quad\Longleftrightarrow\quad p(y \mid x) = p(y)\)
왼쪽 식을 조건부 확률의 정의에 넣으면 \(p(y \mid x) = p(x)p(y)/p(x) = p(y)\) 이므로 두 식은 같은 말이다. 날씨와 우산은 \(p(\text{비})\,p(\text{씀}) = 0.5 \times 0.45 = 0.225 \ne 0.40\) 이라 독립이 아니다. 주사위를 두 번 던진 결과는 독립이다. 최대우도 추정은 "데이터가 서로 독립"이라는 가정을 쓴다.
베이즈 정리
베이즈 정리(Bayes' theorem)는 \(p(y \mid x)\) 를 \(p(x \mid y)\) 로 뒤집는 공식이다. 곱셈 법칙의 두 표현 \(p(y \mid x)\, p(x) = p(x, y) = p(x \mid y)\, p(y)\) 의 양 끝을 \(p(x)\) 로 나누고, 분모를 주변화로 풀면 된다.
\(p(y \mid x) = \frac{p(x \mid y)\, p(y)}{p(x)} = \frac{p(x \mid y)\, p(y)}{\sum_{y'} p(x \mid y')\, p(y')}\)
숨은 원인을 \(y\), 관찰한 증거를 \(x\) 로 보면 각 부분의 이름은 다음과 같다.
- \(p(y)\): 사전 확률(prior). 증거를 보기 전의 믿음이다.
- \(p(x \mid y)\): 가능도(likelihood). 원인이 \(y\) 라면 증거 \(x\) 가 나올 확률이다.
- \(p(x)\): 증거(evidence). 원인을 모를 때 \(x\) 가 나올 전체 확률이다.
- \(p(y \mid x)\): 사후 확률(posterior). 증거를 본 뒤 고친 믿음이다.
이미 아는 것 \(C\) 가 더 있어도 모든 확률에 같은 조건 \(C\) 를 붙이면 그대로 성립한다. 5장에서 "지금까지의 기록 \(C\)"를 조건으로 둔 채 새 관측으로 믿음을 고칠 때 이 꼴을 쓴다.
\(p(A \mid B, C) = \frac{p(B \mid A, C)\, p(A \mid C)}{p(B \mid C)}\)
예제: 검사에서 양성이 나왔다면
어떤 병은 100명 중 1명이 걸린다. 검사는 병이 있으면 99% 로 양성, 건강해도 5% 로 양성이 나온다.
\(\begin{align} p(\text{양성}) &= 0.99 \times 0.01 + 0.05 \times 0.99 = 0.0099 + 0.0495 = 0.0594 \\ p(\text{병} \mid \text{양성}) &= \frac{0.99 \times 0.01}{0.0594} = \frac{0.0099}{0.0594} \approx 0.1667 \end{align}\)
검사가 99% 정확한데도 양성인 사람 중 실제 환자는 약 17% 다. 1만 명으로 세면 환자 100명 중 99명이 양성, 건강한 9900명 중 495명이 양성이라 \(99/594 \approx 0.167\) 이다. 사전 확률이 작아 오진 양성이 훨씬 많기 때문이다. 100만 명 시뮬레이션도 같은 값을 준다.
def bayes_example(rng: np.random.Generator, n_people: int) -> None:
    """병 검사 예제: 양성이 나왔을 때 정말 병이 있을 확률은?"""
    p_d = 0.01  # P(병)          : 100 명 중 1 명
    p_pos_d = 0.99  # P(양성 | 병)   : 병이 있으면 99% 양성
    p_pos_nd = 0.05  # P(양성 | 건강) : 건강해도 5% 는 양성(오진)

    # 공식: P(병 | 양성) = P(양성 | 병) P(병) / P(양성)
    p_pos = p_pos_d * p_d + p_pos_nd * (1 - p_d)  # 주변화: 병인 경우 + 건강한 경우
    posterior = p_pos_d * p_d / p_pos
    print(f"[베이즈] 공식     P(양성) = {p_pos:.4f},  P(병 | 양성) = {posterior:.4f}")

    # 시뮬레이션: 가상의 사람을 많이 만들어 실제로 세어 본다.
    sick = rng.random(n_people) < p_d  # 각 사람이 병이 있는지
    u = rng.random(n_people)
    positive = np.where(sick, u < p_pos_d, u < p_pos_nd)  # 병 여부에 따라 양성 확률이 다르다
    print(f"[베이즈] 시뮬레이션 양성 {positive.sum()} 명 중 병 {np.sum(sick & positive)} 명"
          f" → P(병 | 양성) ≈ {np.sum(sick & positive) / positive.sum():.4f}")
World Model 에서의 베이즈 정리
그림을 보는 World Model 에서 숨은 원인은 잠재 상태 \(z\)(예: 진자의 각도), 증거는 그림 \(o\) 다. 알고 싶은 것은 사후 확률 \(p(z \mid o)\) 인데, 분모 \(p(o) = \int p(o \mid z) p(z)\,dz\) 의 적분을 계산할 수 없다. 그래서 8장은 신경망 \(q_\phi(z \mid o)\) 로 사후 확률을 근사한다(8장은 VAE 논문의 관례대로 관측을 \(o\) 대신 \(x\) 로 쓴다).
기댓값
기댓값(expectation)은 확률로 가중한 평균이며, 같은 실험을 아주 많이 되풀이했을 때 결과의 평균이 다가가는 값이다.
\(\mathbb{E}[X] = \sum_x x\, p(x) \quad \Big(\text{연속이면 } \int x\, p(x)\,dx\Big), \qquad \mathbb{E}_{x \sim p}[f(x)] = \sum_x f(x)\, p(x)\)
주사위는 \(\mathbb{E}[X] = 21/6 = 3.5\) 이고 \(\mathbb{E}[X^2] = 91/6 \approx 15.17\) 이다. 3.5 는 실제로 나올 수 없는 값이다(1장의 "평균이 일어날 수 없는 값이 되는 문제").
선형성
상수배와 더하기는 기댓값 밖으로 꺼낼 수 있다.
\(\begin{align} \mathbb{E}[aX + b] &= \sum_x (a x + b)\, p(x) = a \sum_x x\, p(x) + b \sum_x p(x) = a\,\mathbb{E}[X] + b \\ \mathbb{E}[X + Y] &= \sum_x \sum_y (x + y)\, p(x, y) = \sum_x x \sum_y p(x, y) + \sum_y y \sum_x p(x, y) \\ &= \sum_x x\, p(x) + \sum_y y\, p(y) = \mathbb{E}[X] + \mathbb{E}[Y] \end{align}\)
둘째 유도는 주변화만 썼고 독립 가정을 쓰지 않았다. 기댓값의 합은 언제나 나눠진다. 곱은 다르다. \(\mathbb{E}[XY] = \mathbb{E}[X]\,\mathbb{E}[Y]\) 는 \(X, Y\) 가 독립일 때 성립한다. 결합 확률이 \(p(x)p(y)\) 로 쪼개져야 두 합이 분리되기 때문이다.
조건부 기댓값과 전체 기댓값의 법칙
조건부 기댓값(conditional expectation)은 확률 자리에 조건부 확률을 넣은 기댓값이다.
\(\mathbb{E}[X \mid Y = y] = \sum_x x\, p(x \mid y)\)
경우별 평균을 경우의 확률로 가중해 더하면 전체 평균이 된다. 이것이 전체 기댓값의 법칙(law of total expectation)이다. 주변화, 곱셈 법칙, 합 순서 교환으로 유도한다.
\(\begin{align} \mathbb{E}[X] &= \sum_x x \sum_y p(x, y) = \sum_x x \sum_y p(x \mid y)\, p(y) \\ &= \sum_y p(y) \sum_x x\, p(x \mid y) = \sum_y p(y)\; \mathbb{E}[X \mid Y = y] \end{align}\)
날씨와 우산 표에서 우산을 쓰면 \(Y = 1\), 안 쓰면 \(Y = 0\) 으로 두면 \(\mathbb{E}[Y \mid \text{맑음}] = 0.05/0.50 = 0.1\), \(\mathbb{E}[Y \mid \text{비}] = 0.40/0.50 = 0.8\) 이고 \(\mathbb{E}[Y] = 0.5 \times 0.1 + 0.5 \times 0.8 = 0.45 = p(\text{씀})\) 이다. 5장의 벨만 방정식("첫 행동이 무엇이었나"로 경우 나누기)과 7장의 앙상블("어느 모델이 뽑혔나"로 경우 나누기)이 이 법칙을 쓴다.
분산과 표준편차
분산(variance)은 값이 평균에서 얼마나 퍼져 있는지를 잰다. \(\mu = \mathbb{E}[X]\) 로 쓰면
\(\operatorname{Var}[X] = \mathbb{E}\big[(X - \mu)^2\big], \qquad \sigma = \sqrt{\operatorname{Var}[X]}\ \ \text{(표준편차)}\)
전개하고 선형성을 쓰면 계산에 편한 공식이 나온다.
\(\operatorname{Var}[X] = \mathbb{E}[X^2] - 2\mu\,\mathbb{E}[X] + \mu^2 = \mathbb{E}[X^2] - (\mathbb{E}[X])^2\)
"제곱의 평균 − 평균의 제곱"이다. 분산은 0 이상이므로 언제나 \(\mathbb{E}[X^2] \ge (\mathbb{E}[X])^2\) 이다(3장 젠센 부등식의 한 예). 주사위는 \(\operatorname{Var}[X] = 91/6 - 3.5^2 = 2.9167\ (= 35/12)\), \(\sigma \approx 1.708\) 이다.
분산의 성질 두 가지는 다음과 같다.
\(\begin{align} \operatorname{Var}[aX + b] &= \mathbb{E}\big[(aX + b - a\mu - b)^2\big] = \mathbb{E}\big[a^2 (X - \mu)^2\big] = a^2\, \operatorname{Var}[X] \\ \operatorname{Var}[X + Y] &= \mathbb{E}[(X - \mu_X)^2] + \mathbb{E}[(Y - \mu_Y)^2] + 2\,\mathbb{E}[(X - \mu_X)(Y - \mu_Y)] \end{align}\)
- 값을 옮기는 \(b\) 는 퍼짐에 영향이 없고, \(a\) 배로 늘리면 분산은 \(a^2\) 배가 된다.
- 마지막 기댓값이 공분산 \(\operatorname{Cov}[X, Y]\) 다. 독립이면 \(\mathbb{E}[X - \mu_X]\,\mathbb{E}[Y - \mu_Y] = 0 \times 0 = 0\) 으로 나뉘어 \(\operatorname{Var}[X + Y] = \operatorname{Var}[X] + \operatorname{Var}[Y]\) 가 된다. \(N\) 개여도 같다.
몬테카를로 추정과 큰 수의 법칙
기댓값을 정확히 계산하려면 모든 \(x\) 에 대해 더하거나 적분해야 하는데 대부분 불가능하다. 대신 분포에서 표본 \(N\) 개를 뽑아 평균을 낸다. 이것이 몬테카를로 추정(Monte Carlo estimation)이다.
\(\mathbb{E}_{x \sim p}[f(x)] \approx \hat{\mu}_N = \frac{1}{N} \sum_{i=1}^{N} f(x_i), \qquad x_i \sim p \ \text{(서로 독립)}\)
\(Y_i = f(x_i)\), \(\mu = \mathbb{E}[Y_i]\), \(\sigma^2 = \operatorname{Var}[Y_i]\) 로 두면 두 가지가 성립한다.
\(\begin{align} \mathbb{E}[\hat{\mu}_N] &= \frac{1}{N} \sum_{i=1}^N \mathbb{E}[Y_i] = \frac{1}{N} \cdot N\mu = \mu \\ \operatorname{Var}[\hat{\mu}_N] &= \frac{1}{N^2}\, \operatorname{Var}\Big[\sum_{i=1}^N Y_i\Big] = \frac{1}{N^2} \cdot N \sigma^2 = \frac{\sigma^2}{N} \end{align}\)
- 첫째 줄: 추정값의 평균이 정확히 정답이므로 편향이 없다(unbiased, 불편 추정).
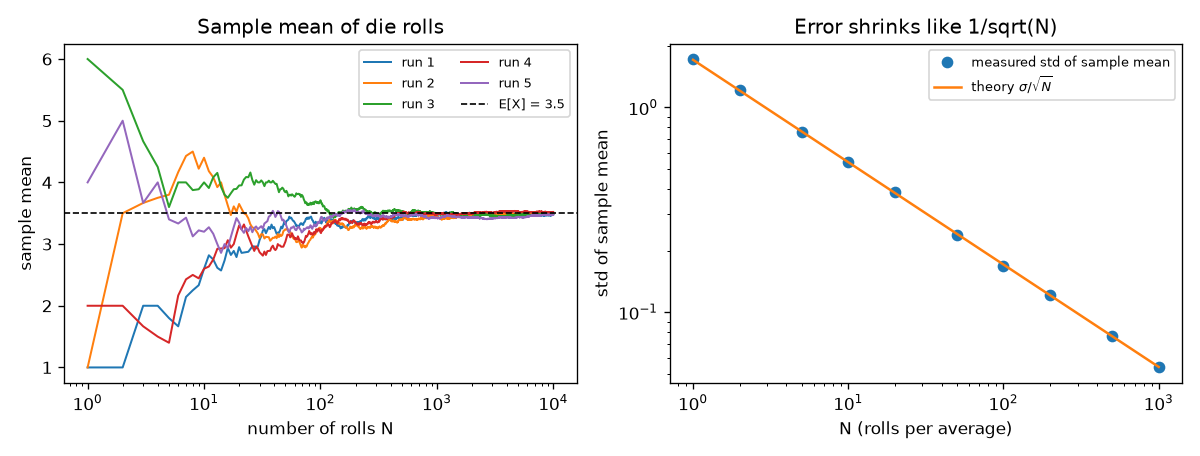
- 둘째 줄: \(\operatorname{Var}[aX] = a^2\operatorname{Var}[X]\) 와 독립 표본의 분산 합을 썼다. 추정값의 표준편차는 \(\sigma/\sqrt{N}\) 이다. \(\sqrt{N}\) 에 반비례하므로 오차를 반으로 줄이려면 표본이 4배 필요하다.
표본 평균이 \(N \to \infty\) 일 때 기댓값에 다가가는 것을 큰 수의 법칙(law of large numbers)이라고 하며, 위의 분산 공식이 그 이유다. 주사위(\(\sigma = 1.708\))로 확인한 결과는 다음과 같다. 실험값은 표본 평균을 4000번 만들어 그 표준편차를 잰 것이고, 누적 평균은 np.cumsum(rolls) / np.arange(1, n_rolls + 1) 로 구한다(lln 구간).
| \(N\) | 실험 표준편차 | 이론 \(\sigma/\sqrt{N}\) |
| 10 | 0.5440 | 0.5401 |
| 100 | 0.1681 | 0.1708 |
| 1000 | 0.0537 | 0.0540 |
미니배치 학습(4장)도 몬테카를로다. 전체 데이터의 평균 손실 대신 무작위로 뽑은 배치 하나의 평균 손실을 쓴다. 8장의 VAE 는 \(\mathbb{E}_{q}[\log p(o \mid z)]\) 를 표본 1개로 추정하는데, 수많은 반복에 걸쳐 오차가 평균으로 지워지므로 학습이 된다.
가우시안 분포
딥러닝과 World Model 에서 가장 많이 쓰는 연속 분포가 가우시안 분포(Gaussian distribution), 곧 정규 분포(Normal distribution)다. 평균 \(\mu\), 분산 \(\sigma^2\) 인 가우시안의 밀도는 다음과 같다.
\(\mathcal{N}(x;\, \mu, \sigma^2) = \frac{1}{\sigma\sqrt{2\pi}} \exp\!\left(-\frac{(x - \mu)^2}{2\sigma^2}\right)\)
세미콜론 앞의 \(x\) 는 밀도를 재는 자리, 뒤는 분포의 매개변수다. \(x \sim \mathcal{N}(\mu, \sigma^2)\) 처럼 분포 자체를 가리킬 때는 \(x;\) 를 생략한다.
- \((x - \mu)^2\): 평균에서 떨어진 거리의 제곱이다. 평균에서 0 이고 좌우 대칭이다.
- \(\dfrac{(x-\mu)^2}{2\sigma^2}\): 거리를 \(\sigma\) 단위로 잰다. \(\sigma\) 가 크면 곡선이 넓게 퍼진다.
- \(\exp(-\,\cdot\,)\): 0 에서 1 이고 커질수록 빠르게 0 으로 간다. 그래서 종 모양이 된다.
- \(\dfrac{1}{\sigma\sqrt{2\pi}}\): 곡선 아래 넓이를 1 로 맞추는 정규화 상수다.
숫자 예: \(\mathcal{N}(0; 0, 1) = 1/\sqrt{2\pi} \approx 0.3989\), \(\mathcal{N}(1; 0, 1) = 0.3989 \times e^{-0.5} \approx 0.2420\), \(\mathcal{N}(0; 0, 0.04) = 1/(0.2\sqrt{2\pi}) \approx 1.995\).
정규화 상수의 유도
\(I = \int_{-\infty}^{\infty} e^{-x^2/2}\,dx\) 를 두 번 곱해 평면 전체의 적분으로 보고, 극좌표 \(x = r\cos\alpha,\ y = r\sin\alpha,\ dx\,dy = r\,dr\,d\alpha\) 로 바꾼다.
\(\begin{align} I^2 &= \int\!\!\int e^{-(x^2 + y^2)/2}\,dx\,dy = \int_0^{2\pi} \int_0^{\infty} e^{-r^2/2}\; r\,dr\,d\alpha \\ \int_0^\infty e^{-r^2/2}\,r\,dr &= \int_0^\infty e^{-v}\,dv = \Big[-e^{-v}\Big]_0^\infty = 1 \qquad (v = r^2/2,\ dv = r\,dr) \\ I^2 &= \int_0^{2\pi} 1\; d\alpha = 2\pi \quad\Rightarrow\quad I = \sqrt{2\pi} \end{align}\)
일반 가우시안은 치환 \(t = (x - \mu)/\sigma\), \(dx = \sigma\,dt\) 로 같은 적분이 된다.
\(\int_{-\infty}^{\infty} \exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) dx = \sigma \int_{-\infty}^{\infty} e^{-t^2/2}\,dt = \sigma\sqrt{2\pi}\)
그래서 앞에 \(1/(\sigma\sqrt{2\pi})\) 를 붙이면 넓이가 정확히 1 이 된다.
표준 정규 분포와 샘플링
\(\mu = 0\), \(\sigma = 1\) 인 가우시안이 표준 정규 분포이고, 여기서 뽑은 값을 \(\epsilon \sim \mathcal{N}(0, 1)\) 로 쓴다. 어떤 가우시안이든 다음과 같이 표본을 뽑는다. 8장 VAE 의 재매개변수화(reparameterization)의 바탕이다.
\(x = \mu + \sigma\,\epsilon, \qquad \epsilon \sim \mathcal{N}(0, 1) \quad\Longrightarrow\quad x \sim \mathcal{N}(\mu, \sigma^2)\)
표준 정규 밀도를 \(\varphi(t) = \frac{1}{\sqrt{2\pi}} e^{-t^2/2}\) 로 쓴다. 먼저 \(\epsilon\) 의 평균이 0, 분산이 1 임을 보인다.
- \(\mathbb{E}[\epsilon] = \int t\,\varphi(t)\,dt = 0\): \(\varphi\) 가 좌우 대칭이라 \(t\varphi(t)\) 의 왼쪽 넓이와 오른쪽 넓이가 지워진다.
- \(\varphi'(t) = -t\,\varphi(t)\) 이므로 \(t^2\varphi = (-t)\,\varphi'\) 로 쓰고 부분 적분(\(u = -t,\ v = \varphi\))을 한다.
\(\mathbb{E}[\epsilon^2] = \int (-t)\,\varphi'(t)\,dt = \Big[-t\,\varphi(t)\Big]_{-\infty}^{\infty} + \int \varphi(t)\,dt = 0 + 1 = 1, \qquad \operatorname{Var}[\epsilon] = 1 - 0 = 1\)
이제 \(x = \mu + \sigma\epsilon\) 을 확인한다. 평균과 분산은 선형성과 \(\operatorname{Var}[aX + b] = a^2\operatorname{Var}[X]\) 에서 \(\mathbb{E}[x] = \mu\), \(\operatorname{Var}[x] = \sigma^2\) 이다. 모양은 누적 분포 함수 \(\Phi(t) = \int_{-\infty}^{t}\varphi\) 를 미분해 확인한다.
\(\begin{align} P(x \le c) &= P\!\left(\epsilon \le \frac{c - \mu}{\sigma}\right) = \Phi\!\left(\frac{c-\mu}{\sigma}\right) \\ p_x(c) &= \frac{d}{dc}\,\Phi\!\left(\frac{c-\mu}{\sigma}\right) = \varphi\!\left(\frac{c-\mu}{\sigma}\right) \cdot \frac{1}{\sigma} = \frac{1}{\sigma\sqrt{2\pi}} \exp\!\left(-\frac{(c-\mu)^2}{2\sigma^2}\right) = \mathcal{N}(c;\, \mu, \sigma^2) \end{align}\)
표준 정규 표본을 늘리고(\(\times\sigma\)) 옮기면(\(+\mu\)) 원하는 가우시안 표본이 된다.
68 – 95 – 99.7: 가우시안에서 값의 약 68% 는 \(\mu \pm \sigma\), 약 95% 는 \(\mu \pm 2\sigma\), 약 99.7% 는 \(\mu \pm 3\sigma\) 안에 있다. 그래서 \(\sigma\) 를 "예측이 이 정도 폭으로 흔들릴 수 있다"는 불확실성의 크기로 읽는다. 7장에서 World Model 이 \(\mu\) 와 함께 \(\sigma\) 를 예측하게 만드는 까닭이다.
대각 가우시안
World Model 이 예측하는 것은 벡터(진자라면 3개, 잠재 변수라면 30개 남짓)다. 가장 흔한 방법은 각 차원을 서로 독립인 가우시안으로 보는 대각 가우시안(diagonal Gaussian)이다. 독립이므로 결합 밀도는 곱이다. \(\operatorname{diag}(\sigma^2)\) 는 분산 \(\sigma_1^2, \dots, \sigma_D^2\) 을 대각선에 놓고 나머지(공분산)는 모두 0 인 공분산 행렬이다.
\(\mathcal{N}(x;\, \mu, \operatorname{diag}(\sigma^2)) = \prod_{d=1}^{D} \mathcal{N}(x_d;\, \mu_d, \sigma_d^2) = \frac{1}{(2\pi)^{D/2} \prod_d \sigma_d} \exp\!\left(-\sum_{d=1}^{D} \frac{(x_d - \mu_d)^2}{2\sigma_d^2}\right)\)
로그 밀도
실제 계산에서는 밀도 대신 로그 밀도를 쓴다. 로그의 성질 \(\log(ab) = \log a + \log b\), \(\log(a/b) = \log a - \log b\), \(\log(a^k) = k\log a\), \(\log(e^u) = u\) 로 곱, 나눗셈, 지수가 모두 덧셈으로 풀린다.
\(\log \mathcal{N}(x; \mu, \sigma^2) = -\frac12\log(2\pi) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2}\)
세 항은 상수(\(\tfrac12\log(2\pi) \approx 0.9189\)), \(\sigma\) 의 크기에 대한 벌점, 평균에서의 거리에 대한 벌점이다. \(x = 1, \mu = 0, \sigma = 1\) 이면 \(-0.9189 - 0 - 0.5 = -1.4189\) 이고 \(e^{-1.4189} = 0.2420\) 으로 앞의 밀도와 같다. 대각 가우시안의 로그 밀도는 차원마다의 로그 밀도를 더한 것이다.
\(\log \mathcal{N}(x;\, \mu, \operatorname{diag}(\sigma^2)) = -\frac{D}{2}\log(2\pi) - \sum_{d=1}^D \log\sigma_d - \sum_{d=1}^D \frac{(x_d - \mu_d)^2}{2\sigma_d^2}\)
예: \(D = 2\), \(x = (1, 0)\), \(\mu = (0, 0)\), \(\sigma = (1, 2)\) 이면 \(-1.8379 - 0.6931 - 0.5 = -3.0310\).
가능도와 최대우도 추정
데이터 \(x_1, \dots, x_N\) 과 매개변수 \(\theta\) 로 정해지는 모델 분포 \(p_\theta(x)\) 가 있을 때, 좋은 \(\theta\) 는 관찰된 데이터를 가장 그럴듯하게 만드는 값이다. 데이터가 서로 독립으로 같은 분포에서 나왔다고 가정하면(i.i.d., independent and identically distributed) 데이터 전체의 확률은 곱이다. 이것을 \(\theta\) 의 함수로 본 것이 가능도(likelihood)이고, 가능도를 최대로 만드는 \(\theta\) 를 찾는 방법이 최대우도 추정(Maximum likelihood estimation, MLE)이다.
\(L(\theta) = p_\theta(x_1, \dots, x_N) = \prod_{i=1}^{N} p_\theta(x_i)\)
로그를 씌우는 이유
- 숫자가 사라지지 않는다. 확률 0.1 짜리 데이터 1000개의 곱은 \(10^{-1000}\) 인데, float64 는 약 \(10^{-308}\) 보다 작은 수를 제대로 담지 못하고 약 \(10^{-324}\) 보다 작으면 0 으로 만든다. 로그를 씌우면 \(1000 \times \log 0.1 = -2302.6\) 이다.
- 곱이 합이 된다. \(\log \prod_i p_\theta(x_i) = \sum_i \log p_\theta(x_i)\). 합은 미분하기도, 미니배치로 나누기도 쉽다.
- 답이 바뀌지 않는다. \(\log\) 는 증가 함수라 \(L(\theta)\) 와 \(\log L(\theta)\) 를 최대로 만드는 \(\theta\) 가 같다.
딥러닝은 관례상 최소화를 하므로 부호를 바꾼 음의 로그 가능도(negative log-likelihood, NLL)를 손실로 쓴다. \(1/N\) 을 곱해도 최적의 \(\theta\) 는 같고, 평균으로 쓰면 데이터 수와 상관없이 손실의 크기가 비슷하다.
\(\hat\theta_{\text{MLE}} = \operatorname*{arg\,max}_\theta \sum_{i=1}^N \log p_\theta(x_i) = \operatorname*{arg\,min}_\theta \left(-\frac{1}{N}\sum_{i=1}^N \log p_\theta(x_i)\right)\)
예제 1: 동전(베르누이)
앞면(\(x = 1\))의 확률 \(p\), 뒷면(\(x = 0\))의 확률 \(1 - p\) 인 분포가 베르누이 분포(Bernoulli distribution)다. \(N\) 번 던져 앞면이 \(k\) 번 나왔다면
\(\begin{align} L(p) &= p^{k}\,(1 - p)^{N - k}, \qquad \log L(p) = k \log p + (N - k)\log(1 - p) \\ \frac{d}{dp}\log L(p) &= \frac{k}{p} - \frac{N - k}{1 - p} = 0 \;\Rightarrow\; k(1 - p) = (N - k)\,p \;\Rightarrow\; \hat p = \frac{k}{N} \end{align}\)
최대우도 추정은 "앞면이 나온 비율"이다. 10번 중 7번 앞면이면 \(\hat p = 0.7\) 이다.
예제 2: 가우시안
로그 밀도를 데이터마다 더하면 로그 가능도는
\(\log L(\mu, \sigma) = -\frac{N}{2}\log(2\pi) - N\log\sigma - \frac{1}{2\sigma^2}\sum_{i=1}^N (x_i - \mu)^2\)
\(\mu\) 와 \(\sigma\) 로 각각 편미분해 0 으로 놓는다.
\(\begin{align} \frac{\partial \log L}{\partial \mu} &= \frac{1}{\sigma^2}\sum_{i=1}^N (x_i - \mu) = 0 \;\Rightarrow\; \hat\mu = \frac{1}{N}\sum_{i=1}^N x_i \\ \frac{\partial \log L}{\partial \sigma} &= -\frac{N}{\sigma} + \frac{1}{\sigma^3}\sum_{i=1}^N (x_i - \mu)^2 = 0 \;\Rightarrow\; \hat\sigma^2 = \frac{1}{N}\sum_{i=1}^N (x_i - \hat\mu)^2 \end{align}\)
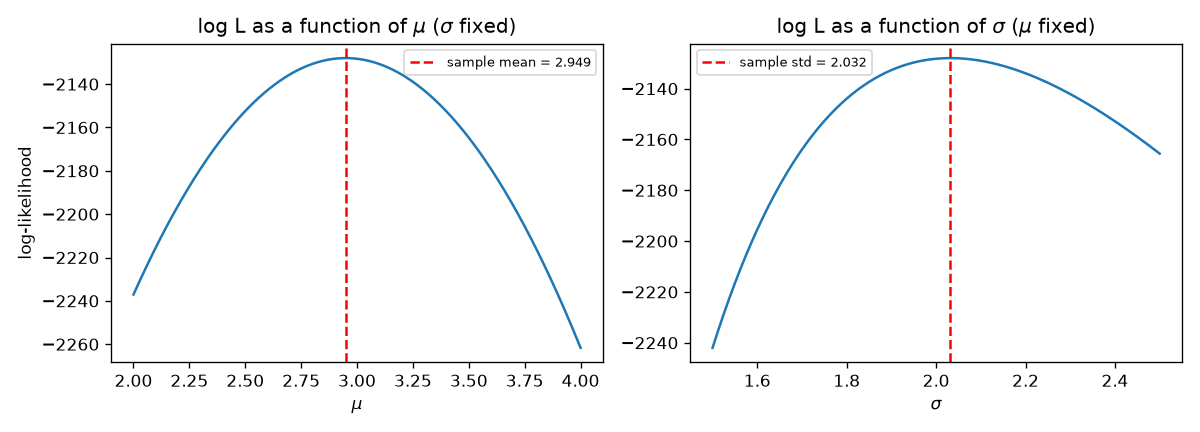
평균의 MLE 는 표본 평균, 분산의 MLE 는 표본 분산이다. \(\mu\) 로 두 번 미분하면 \(-N/\sigma^2 \lt 0\) 이므로 이 점은 최댓값이다. 통계에서는 표본 분산을 \(N-1\) 로 나누는데, \(N\) 으로 나눈 MLE 가 평균적으로 진짜 분산보다 조금 작게 나오기(편향) 때문이다. \(N\) 이 크면 차이가 거의 없어 딥러닝에서는 신경 쓰지 않는 경우가 많다.
코드는 진짜 \(\mu = 3\), \(\sigma = 2\) 인 가우시안에서 1000개를 뽑아 공식, 격자 탐색, 경사 하강 세 방법을 비교한다(mle 구간에서 그림 부분은 생략).
def gaussian_log_likelihood(x: np.ndarray, mu: float, sigma: float) -> float:
    """log L(μ, σ) = Σ_i log N(x_i; μ, σ²) = -N/2·log(2π) - N·log σ - Σ(x_i-μ)²/(2σ²)."""
    n = len(x)
    return -0.5 * n * math.log(2 * math.pi) - n * math.log(sigma) - np.sum((x - mu) ** 2) / (2 * sigma**2)


def gaussian_mle(rng: np.random.Generator, n: int, fig_dir: str) -> None:
    true_mu, true_sigma = 3.0, 2.0
    x = rng.normal(true_mu, true_sigma, size=n)

    # 풀이 상자에서 미분으로 구한 답
    mu_hat = x.mean()  # μ̂ = (1/N) Σ x_i
    var_hat = np.mean((x - mu_hat) ** 2)  # σ̂² = (1/N) Σ (x_i - μ̂)²
    sigma_hat = math.sqrt(var_hat)
    print(f"[MLE] 진짜 μ={true_mu}, σ={true_sigma}  /  공식 μ̂={mu_hat:.4f}, σ̂={sigma_hat:.4f}")

    # 확인 1: 격자에서 로그 가능도가 가장 큰 곳을 찾아본다.
    mus = np.linspace(2.0, 4.0, 401)
    sigmas = np.linspace(1.5, 2.5, 401)
    ll_mu = np.array([gaussian_log_likelihood(x, m, sigma_hat) for m in mus])
    ll_sigma = np.array([gaussian_log_likelihood(x, mu_hat, s) for s in sigmas])
    print(f"[MLE] 격자 탐색   μ*={mus[ll_mu.argmax()]:.4f}, σ*={sigmas[ll_sigma.argmax()]:.4f}")

    # 확인 2: 경사 하강(4장에서 배울 방법, 여기서는 Adam)으로 NLL 을 내려 본다 (= 로그 가능도를 올린다).
    xt = torch.tensor(x)
    mu_p = torch.tensor(0.0, requires_grad=True)
    log_sigma_p = torch.tensor(0.0, requires_grad=True)  # σ > 0 을 지키려고 log σ 를 학습한다
    opt = torch.optim.Adam([mu_p, log_sigma_p], lr=0.05)
    for _ in range(2000):
        sigma_p = log_sigma_p.exp()
        nll = (0.5 * math.log(2 * math.pi) + log_sigma_p + (xt - mu_p) ** 2 / (2 * sigma_p**2)).mean()
        opt.zero_grad()
        nll.backward()
        opt.step()
    print(f"[MLE] 경사 하강   μ*={mu_p.item():.4f}, σ*={log_sigma_p.exp().item():.4f}")
[MLE] 진짜 μ=3.0, σ=2.0  /  공식 μ̂=2.9492, σ̂=2.0321
[MLE] 격자 탐색   μ*=2.9500, σ*=2.0325
[MLE] 경사 하강   μ*=2.9492, σ*=2.0321
- 세 방법이 같은 답을 낸다. 진짜 값 (3, 2) 와 조금 다른 것은 표본이 1000개뿐이기 때문이다(몬테카를로의 \(\sigma/\sqrt{N}\) 오차).
- \(\sigma\) 는 늘 양수여야 하므로
log_sigma_p를 학습하고exp()로 \(\sigma\) 를 만든다. \(\log\sigma\) 가 어떤 실수여도 \(\sigma = e^{\log\sigma} \gt 0\) 이 보장된다. World Model 이 분산을 예측할 때(7장, 8장)도 같은 요령을 쓴다. - 손실 줄은 위에서 유도한 가우시안 NLL 을 그대로 옮긴 것이다.
- 그림: 그림 2-3. μ 와 σ 에 따른 로그 가능도 곡선. 꼭대기가 표본 평균과 표본 표준편차에 있다
손실 함수의 정체: 음의 로그 가능도
딥러닝과 World Model 은 입력 \(x\) 가 주어졌을 때 출력 \(y\) 의 조건부 분포 \(p_\theta(y \mid x)\) 를 배운다. World Model 이라면 \(x = (s_t, a_t)\), \(y = s_{t+1}\) 이다. 신경망이 분포의 매개변수(예: 평균)를 출력하고, 데이터 \((x_i, y_i)\) 에 대한 NLL 을 최소화한다. 익숙한 손실 함수는 모두 이 NLL 이다.
=== MSE = 가우시안 NLL === 신경망 \(f_\theta(x)\) 가 평균을 출력하고 표준편차는 \(\sigma\) 로 고정한 모델 \(p_\theta(y \mid x) = \mathcal{N}(y;\, f_\theta(x), \sigma^2)\) 를 생각한다.
\(\begin{align} \text{NLL}(\theta) &= \frac{1}{N}\sum_{i=1}^N \left[\frac12\log(2\pi) + \log\sigma + \frac{(y_i - f_\theta(x_i))^2}{2\sigma^2}\right] \\ &= \frac{1}{2\sigma^2} \cdot \underbrace{\frac{1}{N}\sum_{i=1}^N (y_i - f_\theta(x_i))^2}_{\text{MSE}(\theta)} + \underbrace{\frac12\log(2\pi) + \log\sigma}_{\theta \text{ 와 무관한 상수}} \end{align}\)
양수 상수를 곱하거나 상수를 더해도 최솟값의 위치는 바뀌지 않으므로 \(\operatorname*{arg\,min}_\theta \text{NLL}(\theta) = \operatorname*{arg\,min}_\theta \text{MSE}(\theta)\) 이다. MSE 로 학습한다 = 분산이 고정된 가우시안 모델을 최대우도로 학습한다. \(\sigma = 1\) 이면 \(\text{NLL} = \text{MSE}/2 + 0.9189\) 이다.
6장은 진자 World Model 을 MSE 로 학습하는데, 이것은 "다음 상태는 예측값을 중심으로 늘 같은 폭(\(\sigma\))으로 흔들리는 가우시안"이라고 가정한 것과 같다. 예측이 쉬운 곳과 어려운 곳의 폭이 같다고 보는 것이 한계이며, 7장에서는 \(\sigma\) 도 신경망이 예측한다.
σ 까지 배우면
\(\sigma\) 를 학습하면 NLL 의 \(\log\sigma\) 항이 살아난다. 데이터 하나에 대해 \(\ell(\sigma) = \log\sigma + \frac{\delta^2}{2\sigma^2}\) (\(\delta\) 는 예측 오차)를 미분하면
\(\frac{d\ell}{d\sigma} = \frac{1}{\sigma} - \frac{\delta^2}{\sigma^3} = 0 \;\Rightarrow\; \sigma^2 = \delta^2\)
모델은 오차가 큰 곳에서 \(\sigma\) 를 키우고 작은 곳에서 줄이도록 배운다. \(\log\sigma\) 항은 모른다고 \(\sigma\) 를 무작정 키우는 것을 막는 벌점이고, \(\delta^2/(2\sigma^2)\) 항은 자신 있는 척 \(\sigma\) 를 줄였다가 틀리는 것을 벌한다. 두 힘의 균형이 정직한 불확실성을 만든다.
=== 이진 교차 엔트로피 = 베르누이 NLL === 출력이 0 또는 1 인 경우(픽셀이 켜졌나, 에피소드가 끝났나)에는 신경망이 "1 일 확률" \(p = f_\theta(x) \in (0, 1)\) 을 출력하는 베르누이 모델을 쓴다. \(y = 1\) 이면 \(p\), \(y = 0\) 이면 \(1 - p\) 가 되도록 한 식에 담는다.
\(\begin{align} p_\theta(y \mid x) &= p^{\,y}\,(1 - p)^{1 - y}, \qquad y \in \{0, 1\} \\ \text{BCE} &= -\frac{1}{N}\sum_{i=1}^N \Big[y_i \log p_i + (1 - y_i)\log(1 - p_i)\Big] \end{align}\)
PyTorch 의 F.binary_cross_entropy 와 같은 식이다. 정답 \(y = (1, 0, 1, 1)\), 모델 확률 \(p = (0.9, 0.2, 0.6, 0.99)\) 이면 각 항은 0.1054, 0.2231, 0.5108, 0.0101 이고 평균은 \(0.8494/4 = 0.2123\) 이다. 8장의 VAE 는 그림의 각 픽셀을 이런 베르누이로 보고 복원 손실을 계산한다.
=== 교차 엔트로피 = 범주형 NLL === 출력이 \(K\) 개 범주 중 하나이면 신경망은 범주마다 아무 실수나 되는 점수 \(l_1, \dots, l_K\) (로짓, logit)를 출력하고 소프트맥스(Softmax)로 확률로 바꾼다.
\(\pi_k = \operatorname{softmax}(l)_k = \frac{e^{l_k}}{\sum_{j=1}^{K} e^{l_j}}\)
정답 범주가 \(y\) 이면 가능도는 \(\pi_y\) 이고, \(-\log \pi_y = -l_y + \log\sum_j e^{l_j}\) 이다.
\(\text{CE} = \frac{1}{N}\sum_{i=1}^N \Big(-l^{(i)}_{y_i} + \log\sum_{j=1}^K e^{l^{(i)}_j}\Big)\)
PyTorch 의 F.cross_entropy(logits, target) 가 계산하는 식이며(Cross entropy), 확률이 아니라 로짓을 넣는다.
\(\log\sum_j e^{l_j}\) 를 log-sum-exp(LSE)라고 부른다. 로짓이 1000 처럼 크면 \(e^{1000}\) 이 넘치므로 가장 큰 로짓 \(m\) 을 빼고 계산한다. 지수가 모두 0 이하라 안전하다. 9장의 혼합 밀도 네트워크에서 이 요령을 직접 쓴다.
\(\log\sum_j e^{l_j} = m + \log\sum_j e^{l_j - m}\)
숫자 예: 로짓 \((2.0, 1.0, 0.1)\), 정답 0번이면 \(e^2 = 7.389\), \(e^1 = 2.718\), \(e^{0.1} = 1.105\), 합 11.212 에서 \(\pi_0 = 0.659\), 손실 0.417 이다. 로짓 \((0.5, 2.5, 0.3)\), 정답 2번이면 \(\pi_2 = 1.350/15.181 = 0.0889\), 손실 2.420 이다. 둘의 평균은 1.4185 다.
코드로 확인
def losses_are_nll(rng: np.random.Generator) -> None:
    # (1) 회귀: σ = 1 로 고정한 가우시안 NLL 과 MSE 의 관계
    y = torch.tensor(rng.normal(size=8))  # 정답
    y_hat = y + torch.tensor(rng.normal(scale=0.5, size=8))  # 모델의 예측 (조금 틀림)
    sigma = 1.0
    nll = (0.5 * math.log(2 * math.pi) + math.log(sigma) + (y - y_hat) ** 2 / (2 * sigma**2)).mean()
    mse = F.mse_loss(y_hat, y)
    print(f"[손실] 가우시안 NLL = {nll.item():.6f}")
    print(f"[손실] MSE/2 + ½log(2π) = {(mse / 2 + 0.5 * math.log(2 * math.pi)).item():.6f}  (같다)")

    # (2) 이진 분류: 베르누이 NLL 과 BCE
    t = torch.tensor([1.0, 0.0, 1.0, 1.0])  # 정답 (0 또는 1)
    p = torch.tensor([0.9, 0.2, 0.6, 0.99])  # 모델이 말한 '1 일 확률'
    bern_nll = -(t * torch.log(p) + (1 - t) * torch.log(1 - p)).mean()
    print(f"[손실] 베르누이 NLL = {bern_nll.item():.6f},  F.binary_cross_entropy = "
          f"{F.binary_cross_entropy(p, t).item():.6f}")

    # (3) 다중 분류: softmax + 범주형 NLL 과 F.cross_entropy
    logits = torch.tensor([[2.0, 1.0, 0.1], [0.5, 2.5, 0.3]])  # 신경망의 날 출력 (2 개 샘플, 3 개 범주)
    target = torch.tensor([0, 2])  # 정답 범주 번호
    probs = torch.exp(logits) / torch.exp(logits).sum(dim=1, keepdim=True)  # softmax
    cat_nll = -torch.log(probs[torch.arange(2), target]).mean()
    print(f"[손실] softmax 확률 = {[[round(v, 4) for v in row] for row in probs.tolist()]}")
    print(f"[손실] 범주형 NLL = {cat_nll.item():.6f},  F.cross_entropy = {F.cross_entropy(logits, target).item():.6f}")
[손실] 가우시안 NLL = 1.037773
[손실] MSE/2 + ½log(2π) = 1.037773  (같다)
[손실] 베르누이 NLL = 0.212345,  F.binary_cross_entropy = 0.212345
[손실] softmax 확률 = [[0.659, 0.2424, 0.0986], [0.1086, 0.8025, 0.0889]]
[손실] 범주형 NLL = 1.418540,  F.cross_entropy = 1.418540
세 경우 모두 손으로 유도한 NLL 과 PyTorch 의 손실 함수가 소수점 여섯째 자리까지 같다.
출력 종류별 손실
| 출력의 종류 | 가정한 분포 | NLL 이 되는 손실 | 튜토리얼에서 쓰는 곳 |
| 실수 (다음 상태 등) | 가우시안, \(\sigma\) 고정 | MSE | 6장 동역학 모델 |
| 실수 + 불확실성 | 가우시안, \(\sigma\) 도 예측 | 가우시안 NLL | 7장 확률적 앙상블 |
| 여러 봉우리의 실수 | 가우시안 혼합 | 혼합 NLL (log-sum-exp) | 9장 MDN-RNN |
| 0 / 1 | 베르누이 | 이진 교차 엔트로피 | 8장 픽셀 복원, 12장 "계속 여부" |
| \(K\) 개 중 하나 | 범주형 + 소프트맥스 | 교차 엔트로피 | 12장 이산 잠재 변수, two-hot |
정리
- 이산은 확률질량(합이 1), 연속은 확률밀도(넓이가 1, 높이는 1 을 넘을 수 있다)로 나타낸다.
- 조건부 확률 \(p(y \mid x) = p(x, y)/p(x)\), 연쇄 법칙 \(p(x_{1:T}) = \prod_t p(x_t \mid x_{1:t-1})\), 베이즈 정리 \(p(y \mid x) = p(x \mid y)p(y)/p(x)\) 가 기본 도구다.
- 기댓값은 선형이다: \(\mathbb{E}[aX + b] = a\mathbb{E}[X] + b\), \(\mathbb{E}[X + Y] = \mathbb{E}[X] + \mathbb{E}[Y]\). 전체 기댓값의 법칙은 \(\mathbb{E}[X] = \sum_y p(y)\,\mathbb{E}[X \mid y]\), 분산은 \(\operatorname{Var}[X] = \mathbb{E}[X^2] - (\mathbb{E}[X])^2\) 이다.
- 몬테카를로 평균은 불편 추정이고 분산은 \(\sigma^2/N\) 로 줄어든다(큰 수의 법칙).
- 가우시안 \(\mathcal{N}(\mu, \sigma^2)\) 의 정규화 상수는 \(1/(\sigma\sqrt{2\pi})\), 샘플링은 \(x = \mu + \sigma\epsilon\), 로그 밀도는 \(-\frac12\log 2\pi - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2}\) 이다.
- 최대우도 = 로그 가능도의 합을 최대화 = NLL 최소화다. 가우시안의 MLE 는 표본 평균과 표본 분산이다.
- MSE 는 고정 분산 가우시안 NLL, BCE 는 베르누이 NLL, 교차 엔트로피는 범주형 NLL 이다. 딥러닝의 손실은 대부분 "어떤 분포를 가정한 최대우도"다.
- 3장에서 최대우도가 "데이터 분포와 모델 분포의 KL 을 줄이는 것"임을 보인다.
확인 문제
- 날씨와 우산 표에서 \(p(\text{비} \mid \text{씀})\) 을 정의와 베이즈 정리로 각각 구한다.
- 정의: \(0.40/0.45 \approx 0.889\). 베이즈 정리: \(0.8 \times 0.5 / 0.45 \approx 0.889\). 두 값이 같다.
- \(X\) 의 평균이 2, 분산이 3 일 때 \(Y = 4X - 1\) 의 평균과 분산은 얼마인가.
- \(\mathbb{E}[Y] = 4 \times 2 - 1 = 7\), \(\operatorname{Var}[Y] = 4^2 \times 3 = 48\). 더하는 \(-1\) 은 분산에 영향이 없다.
- 표준편차 2 인 분포의 평균을 몬테카를로로 추정할 때 추정값의 표준편차를 0.01 이하로 만드는 표본 수는 얼마인가.
- \(\sigma/\sqrt{N} \le 0.01\) 에서 \(\sqrt{N} \ge 200\), \(N \ge 40000\) 이다.
- \(\log\mathcal{N}(x; \mu, \sigma^2)\) 를 \(x = 3, \mu = 1, \sigma = 2\) 에서 계산한다.
- \(-0.9189 - 0.6931 - \frac{(3-1)^2}{2 \times 4} = -2.1120\).
- \(\sigma = 0.5\) 로 고정한 가우시안 NLL(평균)과 MSE 의 관계식을 쓰고, MSE 가 0.1 일 때의 NLL 을 구한다.
- \(\text{NLL} = \frac{\text{MSE}}{2\sigma^2} + \frac12\log(2\pi) + \log\sigma = 2\,\text{MSE} + 0.9189 + \log 0.5\). MSE 가 0.1 이면 \(0.2 + 0.9189 - 0.6931 = 0.4258\) 이다. 밀도가 1 보다 클 수 있으므로 NLL 은 음수가 될 수도 있다.
- 로짓이 \((1, 1, 1)\) 이고 정답이 0번일 때 교차 엔트로피 손실은 얼마이며, 로짓이 \((101, 101, 101)\) 이면 어떻게 되는가.
- 소프트맥스가 \((1/3, 1/3, 1/3)\) 이므로 \(\log 3 \approx 1.0986\) 이다. 로짓에 같은 수를 더해도 분자와 분모에 같은 \(e^{100}\) 이 곱해져 소프트맥스가 바뀌지 않으므로 손실도 같다. log-sum-exp 요령이 성립하는 이유이기도 하다.
See also
- World Models:Tutorial
- World Models
- Maximum likelihood estimation
- Bayes' theorem
- Normal distribution
- Cross entropy
- Softmax
- Information Theory