WorldModels:Tutorial:03-InformationTheory
lastmod 2026-11-18created 2026-11-172 edits
정보 이론과 KL 발산은 World Model 튜토리얼의 3장이다. VAE(8장), RSSM(11장), Dreamer(12장)의 손실 함수에 빠짐없이 들어가는 KL 발산(Kullback–Leibler divergence)을 "놀람의 양"이라는 직관에서 출발해 정보량, 엔트로피, 교차 엔트로피 순서로 유도한다. KL 이 늘 0 이상인 이유(젠센 부등식), KL 의 방향에 따른 성격 차이, 두 가우시안 사이 KL 의 닫힌 꼴, 상호정보량을 다루고 8장 ELBO 의 유도를 미리 본다.
- 원문: 03. 수학 ② 정보 이론과 KL 발산
- 실습 코드:
code/ch03_information.py(CPU 로 몇 초.--quick은 표본 수를 1,000,000 개에서 10,000 개로 줄인다) - 이전: 02. 확률과 최대우도 / 다음: 04. 딥러닝과 PyTorch 기초
왜 정보 이론인가
2장의 최대우도는 모델을 데이터에 맞추는 원리다. World Model 을 만들 때는 이것 말고도 "두 분포를 가깝게 만들고 싶다"는 상황이 계속 나온다.
| 장 | 필요한 것 |
| 8장 VAE | 인코더가 만든 잠재 분포 \(q_\phi(z \mid o)\) 를 기준 분포 \(p(z) = \mathcal{N}(0, I)\) (각 성분이 독립인 표준 정규 분포) 가까이에 붙잡아 둔다. |
| 11장 RSSM | 그림을 보고 추측한 상태 분포(사후)와 그림 없이 상상만으로 예측한 상태 분포(사전)를 가깝게 만든다. |
| 12장 Dreamer | 정책이 한쪽으로 치우치지 않게 엔트로피를 높게 유지한다. |
"두 분포가 얼마나 다른가"를 재는 표준 도구가 KL 발산이고, 그 뿌리는 1948년 클로드 섀넌(Claude Shannon)이 세운 정보 이론이다.
정보량
드문 사건일수록 그 사건이 일어났다는 소식은 더 놀랍고 더 많은 정보를 담는다. 확률 \(p\) 인 사건이 일어났을 때의 놀람, 곧 정보량(information content, surprisal) \(I(p)\) 에 세 조건을 요구한다.
- 확실한 사건은 놀랍지 않다: \(I(1) = 0\).
- 드물수록 더 놀랍다: \(p\) 가 작아지면 \(I(p)\) 가 커진다.
- 독립인 두 사건이 함께 일어나면 놀람은 더해진다: \(I(p_1 p_2) = I(p_1) + I(p_2)\).
이 세 조건만으로 \(I\) 의 꼴이 정해진다. \(I\) 가 미분 가능하다고 가정하고 조건 3 을 \(y\) 로 미분한 뒤 \(y = 1\) 을 넣는다.
\(\begin{align} I(xy) &= I(x) + I(y) \qquad (0 \lt x, y \le 1) \\ x\, I'(xy) &= I'(y) \\ x\, I'(x) &= I'(1) =: -c \qquad (c \gt 0,\ \text{조건 2}) \\ I'(x) &= -\frac{c}{x} \;\Rightarrow\; I(x) = -c\log x + C \\ I(p) &= -c\,\log p \qquad (C = 0,\ \text{조건 1}) \end{align}\)
정보량은 음의 로그 확률이고 \(c\) 는 단위만 정한다. \(c = 1\) 에 자연로그를 쓰면 단위는 내트(nat), 밑이 2 인 로그를 쓰면 bit 다(\(c = 1/\log 2\)). 이 튜토리얼은 자연로그(내트)를 쓴다.
| 사건의 확률 \(p\) | 정보량 (내트) \(-\log p\) | 정보량 (bit) \(-\log_2 p\) |
| 1 (확실) | 0 | 0 |
| 1/2 (동전 앞면) | 0.693 | 1 |
| 1/8 | 2.079 | 3 |
| 0.01 | 4.605 | 6.644 |
2장의 NLL \(-\log p_\theta(x)\) 는 모델이 데이터를 보고 느끼는 놀람이다. 최대우도 학습은 모델이 실제 데이터에 덜 놀라도록 만드는 일이다.
엔트로피
엔트로피(entropy)는 분포 \(p\) 에서 결과가 나올 때 느끼는 놀람의 기댓값이고, 분포의 불확실성을 잰다.
\(H(p) = \mathbb{E}_{x \sim p}[-\log p(x)] = -\sum_x p(x)\log p(x)\)
확률이 0 인 결과의 \(0 \cdot \log 0\) 은 0 으로 친다. \(p \to 0\) 일 때 \(p\log p \to 0\) 이기 때문이다(\(0.1\log 0.1 = -0.230\), \(0.01\log 0.01 = -0.046\), \(0.001\log 0.001 = -0.0069\)).
동전의 엔트로피
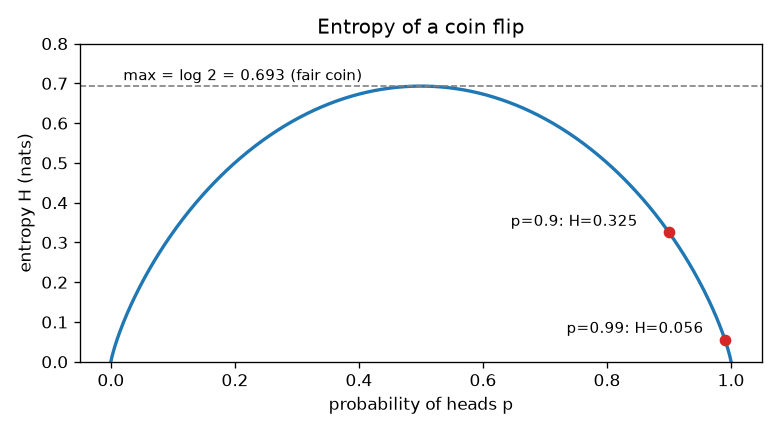
앞면 확률이 \(p\) 인 동전의 엔트로피는 다음과 같다.
\(H(p) = -p\log p - (1 - p)\log(1 - p)\)
| 앞면 확률 | 엔트로피 (내트) | 엔트로피 (bit) |
| 0.5 | \(\log 2 = 0.6931\) | 1.0000 |
| 0.9 | 0.3251 | 0.4690 |
| 0.99 | 0.0560 | 0.0808 |
\(p = 1/2\) 에서 최대라는 것은 미분으로 확인한다. \(\frac{d}{dp}(p\log p) = \log p + 1\) 이므로
\(\begin{align} H'(p) &= -(\log p + 1) + (\log(1-p) + 1) = \log\frac{1 - p}{p} \\ H'(p) &= 0 \;\Leftrightarrow\; p = \tfrac12 \\ H''(p) &= -\frac{1}{p} - \frac{1}{1-p} \lt 0 \end{align}\)
위로 볼록한 산 모양이고 꼭대기 값은 \(H(\tfrac12) = \log 2\) 다. 일반적으로 결과가 \(K\) 가지인 분포의 엔트로피는 균등 분포일 때 최대이고 그 값은 \(\log K\) 다(증명은 아래 "KL 이 0 이상인 이유"에 있다).
가우시안의 미분 엔트로피
연속 분포에서는 합 대신 적분 \(H(p) = -\int p(x)\log p(x)\,dx\) 를 쓰고 미분 엔트로피라고 부른다. 가우시안에 2장의 로그 밀도 공식을 넣으면
\(\begin{align} H &= \mathbb{E}\left[\frac12\log(2\pi) + \log\sigma + \frac{(x-\mu)^2}{2\sigma^2}\right] \\ &= \frac12\log(2\pi) + \log\sigma + \frac{\mathbb{E}[(x - \mu)^2]}{2\sigma^2} = \frac12\log(2\pi) + \log\sigma + \frac12 \\ H\big(\mathcal{N}(\mu, \sigma^2)\big) &= \frac12\log(2\pi e\,\sigma^2) \end{align}\)
- 평균 \(\mu\) 와 무관하고 퍼짐 \(\sigma\) 가 클수록 커진다.
- \(\sigma = 1\) 이면 1.419 내트, \(\sigma = 0.1\) 이면 \(1.419 + \log 0.1 = -0.884\) 내트다. 밀도가 1 을 넘을 수 있으므로 미분 엔트로피는 음수일 수 있다.
- 12장 Dreamer 의 행동 분포 엔트로피 계산이 이 식에서 출발한다(거기서는 행동을 \(\tanh\) 로 누르는 데 따른 보정 항이 하나 더 붙는다).
교차 엔트로피
실제 결과는 분포 \(p\) 에서 나오는데 그것이 \(q\) 라고 믿고 있다면, 결과마다 느끼는 놀람은 \(-\log q(x)\) 이고 그 평균은 실제 분포 \(p\) 로 낸다. 이것이 교차 엔트로피(cross-entropy)다.
\(H(p, q) = \mathbb{E}_{x \sim p}[-\log q(x)] = -\sum_x p(x)\log q(x)\)
진짜 분포 \(p = (0.5, 0.3, 0.2)\), 모델 \(q = (0.4, 0.4, 0.2)\) 의 예는 다음과 같다.
\(\begin{align} H(p) &= -(0.5\log 0.5 + 0.3\log 0.3 + 0.2\log 0.2) = 0.3466 + 0.3612 + 0.3219 = 1.0297 \\ H(p, q) &= -(0.5\log 0.4 + 0.3\log 0.4 + 0.2\log 0.2) = 0.4581 + 0.2749 + 0.3219 = 1.0549 \end{align}\)
로그 안에는 모델 \(q\) 의 확률이, 가중치에는 진짜 \(p\) 의 확률이 들어간다. 틀린 믿음 때문에 평균 놀람이 1.0297 에서 1.0549 로 커졌다.
2장의 분류 손실 "교차 엔트로피"가 이것이다. 정답이 범주 \(y\) 라는 것은 \(p\) 가 \(y\) 에만 1 을 준 원-핫 분포라는 뜻이고, 그러면 \(H(p, q) = -\log q(y)\), 곧 범주형 NLL 이 된다.
KL 발산
틀린 믿음 \(q\) 때문에 더 놀란 양, 곧 교차 엔트로피에서 엔트로피를 뺀 것이 KL 발산이다. 1951년 쿨백(Kullback)과 라이블러(Leibler)가 정의했다.
\(\begin{align} H(p, q) - H(p) &= -\sum_x p(x)\log q(x) + \sum_x p(x)\log p(x) \\ D_{\mathrm{KL}}(p \,\|\, q) &= \sum_x p(x)\log\frac{p(x)}{q(x)} = \mathbb{E}_{x \sim p}\!\left[\log\frac{p(x)}{q(x)}\right] \end{align}\)
연속 분포라면 합 대신 적분이다. 위의 예에서 값은 다음과 같다.
- \(D_{\mathrm{KL}}(p \,\|\, q) = 1.05492 - 1.02965 = 0.0253\). 정의대로 계산해도 \(0.5\log\frac{0.5}{0.4} + 0.3\log\frac{0.3}{0.4} + 0.2\log\frac{0.2}{0.2} = 0.1116 - 0.0863 + 0 = 0.0253\) 으로 같다.
- 순서를 바꾸면 \(D_{\mathrm{KL}}(q \,\|\, p) = 0.4\log\frac{0.4}{0.5} + 0.4\log\frac{0.4}{0.3} + 0 = -0.0893 + 0.1151 = 0.0258\) 로 값이 다르다.
def entropy(p: np.ndarray) -> float:
    """H(p) = -Σ p_i log p_i   (p_i = 0 인 항은 0 으로 친다: 0·log 0 = 0)"""
    p = p[p > 0]
    return float(-np.sum(p * np.log(p)))


def cross_entropy(p: np.ndarray, q: np.ndarray) -> float:
    """H(p, q) = -Σ p_i log q_i   (정답 분포 p 로 평균 낸, 모델 q 의 놀람)"""
    mask = p > 0
    return float(-np.sum(p[mask] * np.log(q[mask])))


def kl(p: np.ndarray, q: np.ndarray) -> float:
    """KL(p ‖ q) = Σ p_i log(p_i / q_i)"""
    mask = p > 0
    return float(np.sum(p[mask] * np.log(p[mask] / q[mask])))
mask = p > 0 은 \(p(x) = 0\) 인 항을 빼서 \(0 \cdot \log(0/q) = 0\) 으로 치는 약속을 구현한 줄이다. 같은 region(discrete)의 discrete_examples() 출력은 다음과 같다.
[엔트로피] 앞면 확률  0.5: H = 0.6931 nats = 1.0000 bits
[엔트로피] 앞면 확률  0.9: H = 0.3251 nats = 0.4690 bits
[엔트로피] 앞면 확률 0.99: H = 0.0560 nats = 0.0808 bits
[이산] H(p) = 1.0297,  H(p,q) = 1.0549
[이산] KL(p‖q) = 0.0253,  H(p,q) - H(p) = 0.0253
[이산] KL(q‖p) = 0.0258   ← 순서를 바꾸면 값이 다르다 (비대칭)
[이산] 균등 분포 3칸의 엔트로피 = 1.0986 = log 3 = 1.0986
KL 의 성질
- 늘 0 이상: \(D_{\mathrm{KL}}(p \,\|\, q) \ge 0\) 이고 같은 분포일 때만 0 이다.
- 비대칭: 일반적으로 \(D_{\mathrm{KL}}(p \,\|\, q) \ne D_{\mathrm{KL}}(q \,\|\, p)\) 다. 그래서 거리(distance)가 아니라 발산(divergence)이라고 부른다.
- \(q\) 가 0 인 곳에 \(p\) 가 있으면 무한대: \(p(x) \gt 0\), \(q(x) = 0\) 이면 \(\log(p/0) = \infty\) 다. 일어날 수 있는 일을 불가능하다고 믿은 대가다.
최대우도는 KL 최소화다
데이터를 만든 진짜 분포를 \(p_{\text{data}}\), 모델을 \(p_\theta\) 라고 한다.
\(\begin{align} D_{\mathrm{KL}}(p_{\text{data}} \,\|\, p_\theta) &= \mathbb{E}_{x \sim p_{\text{data}}}[\log p_{\text{data}}(x)] - \mathbb{E}_{x \sim p_{\text{data}}}[\log p_\theta(x)] \\ &= -H(p_{\text{data}}) - \mathbb{E}_{x \sim p_{\text{data}}}[\log p_\theta(x)] \\ \operatorname*{arg\,min}_\theta D_{\mathrm{KL}}(p_{\text{data}} \,\|\, p_\theta) &= \operatorname*{arg\,max}_\theta \mathbb{E}_{x \sim p_{\text{data}}}[\log p_\theta(x)] \approx \operatorname*{arg\,max}_\theta \frac{1}{N}\sum_{i=1}^N \log p_\theta(x_i) \end{align}\)
첫 항 \(-H(p_{\text{data}})\) 는 \(\theta\) 와 무관한 상수다. 진짜 분포에 대한 기댓값은 알 수 없으므로 데이터 \(N\) 개의 평균으로 몬테카를로 추정하면 평균 로그 가능도, 곧 최대우도가 된다. 최대우도 학습은 모델 분포를 데이터 분포 쪽으로 KL 이 작아지게 끌어당기는 일이고, 그 방향은 데이터가 앞에 오는 \(D_{\mathrm{KL}}(p_{\text{data}} \,\|\, p_\theta)\) 다.
볼록 함수와 젠센 부등식
KL 이 0 이상임을 증명하고 8장의 ELBO 를 유도하는 데 젠센 부등식(Jensen's inequality)이 필요하다.
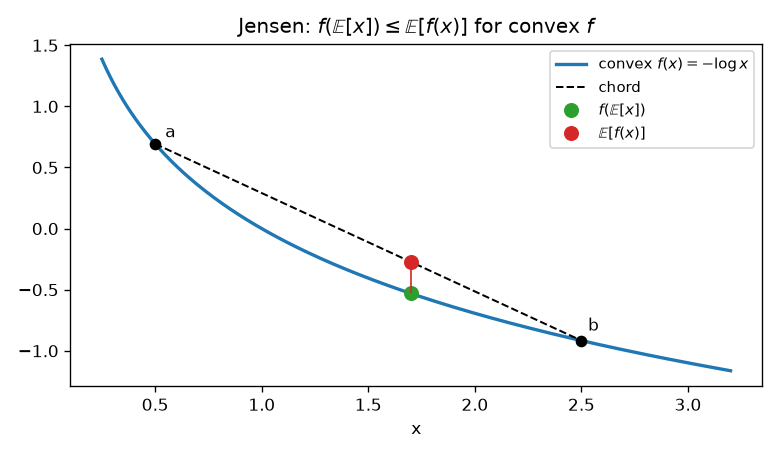
함수 \(f\) 가 볼록(convex)하다는 것은 그래프 위의 두 점을 이은 선분(현)이 늘 그래프 위에 있다는 뜻이다. 두 점 \(a, b\) 와 섞는 비율 \(w \in [0, 1]\) 에 대해
\(f\big(w\,a + (1 - w)\,b\big) \;\le\; w\,f(a) + (1 - w)\,f(b)\)
왼쪽은 두 점을 섞은 곳에서의 함숫값(곡선 위의 점), 오른쪽은 함숫값을 섞은 것(현 위의 점)이다. 현이 늘 그래프 아래에 있으면 오목(concave)이고 부등호가 뒤집힌다. 두 번 미분할 수 있는 함수는 \(f''(x) \ge 0\) 이면 볼록, \(f''(x) \le 0\) 이면 오목이다.
| 함수 | 이계도함수 | 판정 |
| \(x^2\) | \(2 \ge 0\) | 볼록 |
| \(-\log x\) (\(x \gt 0\)) | \(1/x^2 \gt 0\) | 볼록 |
| \(\log x\) | \(-1/x^2 \lt 0\) | 오목 |
| \(e^x\) | \(e^x \gt 0\) | 볼록 |
두 점에 대한 정의를 여러 점으로 넓히면 젠센 부등식이 된다. 가중치 \(w_i \ge 0\), \(w_1 + w_2 + w_3 = 1\) 인 세 점에서(\(w_1 \lt 1\) 인 경우), 뒤의 두 항을 한 점 \(m\) 으로 묶어 두 점 정의를 두 번 쓴다.
\(\begin{align} w_1 x_1 + w_2 x_2 + w_3 x_3 &= w_1 x_1 + (1 - w_1)\,m, \qquad m := \frac{w_2 x_2 + w_3 x_3}{1 - w_1} \\ f(w_1 x_1 + (1-w_1)\,m) &\le w_1 f(x_1) + (1 - w_1)\,f(m) \\ f(m) &\le \frac{w_2}{1 - w_1}f(x_2) + \frac{w_3}{1 - w_1}f(x_3) \\ f(w_1 x_1 + w_2 x_2 + w_3 x_3) &\le w_1 f(x_1) + w_2 f(x_2) + w_3 f(x_3) \end{align}\)
같은 방법을 되풀이하면(수학적 귀납법) 점이 몇 개든 성립한다. 가중치 \(w_i\) 를 확률 \(p(x_i)\) 로 보면 다음과 같이 쓸 수 있고 연속 분포에서도 같다.
\(\text{볼록 } f: \quad f(\mathbb{E}[X]) \le \mathbb{E}[f(X)], \qquad\qquad \text{오목 } f: \quad f(\mathbb{E}[X]) \ge \mathbb{E}[f(X)]\)
특히 \(\log\) 는 오목하므로 다음이 성립한다. 이 장과 8장에서 가장 많이 쓰는 부등식이다.
\(\log \mathbb{E}[X] \;\ge\; \mathbb{E}[\log X]\)
def jensen_check(rng: np.random.Generator, n: int) -> None:
    """log 는 오목(위로 볼록) 함수라서 log E[X] ≥ E[log X] 이다."""
    x = rng.uniform(0.5, 2.0, size=n)  # 양수인 확률변수
    print(f"[젠센] log E[X] = {math.log(x.mean()):.4f}  ≥  E[log X] = {np.log(x).mean():.4f}")
    x2 = rng.normal(0.0, 1.0, size=n)
    print(f"[젠센] (E[X])² = {x2.mean() ** 2:.4f}  ≤  E[X²] = {(x2**2).mean():.4f}   (x² 는 볼록)")
- 손계산: \(X\) 가 0.5 와 2 사이의 균등 분포면 \(\mathbb{E}[X] = 1.25\), \(\log 1.25 = 0.2231\) 이고 \(\mathbb{E}[\log X] = \frac{1}{1.5}\big[x\log x - x\big]_{0.5}^{2} = \frac{(1.3863 - 2) - (-0.3466 - 0.5)}{1.5} = 0.1553\) 이다.
- 둘째 줄은 2장의 "분산 ≥ 0, 곧 \(\mathbb{E}[X^2] \ge (\mathbb{E}[X])^2\)"과 같은 내용이다(\(x^2\) 이 볼록).
- 그림: 그림 3-2. 볼록 함수 -log x 에서 두 점 a = 0.5, b = 2.5 를 4:6 으로 섞으면 평균에서의 함숫값이 현 위의 함숫값 평균보다 아래에 있다
KL 이 0 이상인 이유
증명 1: 젠센 부등식
합은 \(p(x) \gt 0\) 인 곳만 돈다.
\(\begin{align} -D_{\mathrm{KL}}(p \,\|\, q) &= \sum_{x:\,p(x) \gt 0} p(x)\log\frac{q(x)}{p(x)} = \mathbb{E}_{x \sim p}\!\left[\log\frac{q(x)}{p(x)}\right] \\ &\le \log \mathbb{E}_{x \sim p}\!\left[\frac{q(x)}{p(x)}\right] = \log\sum_{x:\,p(x) \gt 0} q(x) \\ &\le \log 1 = 0 \end{align}\)
둘째 줄은 \(\log\) 의 오목성(\(\mathbb{E}[\log Y] \le \log\mathbb{E}[Y]\), \(Y = q(x)/p(x)\)), 셋째 줄은 \(q\) 의 일부 칸만 더한 합이 1 이하라는 사실에서 나온다.
증명 2: log t ≤ t − 1
\(g(t) = t - 1 - \log t\) 는 \(g''(t) = 1/t^2 \gt 0\) 으로 볼록하고 \(g'(1) = 0\), \(g(1) = 0\) 이므로 \(t = 1\) 에서 최솟값 0 을 갖는다. 따라서 \(\log t \le t - 1\) 이고 등호는 \(t = 1\) 일 때만 성립한다. 각 항에 \(t = q(x)/p(x)\) 를 넣는다.
\(\begin{align} -D_{\mathrm{KL}}(p \,\|\, q) &= \sum_{p \gt 0} p(x)\log\frac{q(x)}{p(x)} \le \sum_{p \gt 0} p(x)\left(\frac{q(x)}{p(x)} - 1\right) \\ &= \sum_{p \gt 0} q(x) - \sum_{p \gt 0} p(x) \le 1 - 1 = 0 \end{align}\)
등호는 모든 곳에서 \(q(x)/p(x) = 1\), 곧 \(p = q\) 일 때만 성립한다.
따라 나오는 결과
- 교차 엔트로피 ≥ 엔트로피(깁스 부등식): \(H(p, q) = H(p) + D_{\mathrm{KL}}(p \,\|\, q) \ge H(p)\). 같은 입력에도 정답이 여러 가지로 나올 수 있는 데이터에서는 분류 손실의 평균이 0 까지 내려가지 못하고 정답 분포의 엔트로피가 바닥이다. 정답이 늘 하나로 정해지는 원-핫이면 \(H(p) = 0\) 이라 바닥도 0 이다.
- 엔트로피 ≤ log K: 균등 분포 \(u(x) = 1/K\) 와의 KL 은 \(D_{\mathrm{KL}}(p \,\|\, u) = \sum_x p\log p + \log K\sum_x p = -H(p) + \log K \ge 0\) 이다. 따라서 \(H(p) \le \log K\) 이고 등호는 \(p = u\) 일 때 성립한다(3칸이면 \(\log 3 = 1.0986\)).
KL 의 방향: forward 와 reverse
맞추고 싶은 분포가 \(p\), 조절할 수 있는 모델이 \(q\) 일 때 방향이 두 가지 있다.
| 방향 | 식 | 성격 | 쓰이는 곳 |
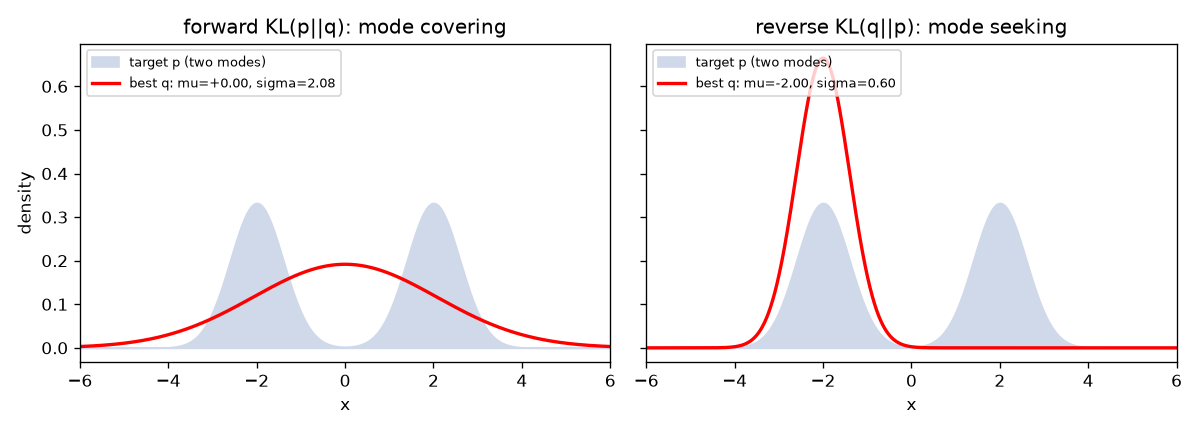
| forward KL | \(D_{\mathrm{KL}}(p \Vert q) = \mathbb{E}_{x\sim p}[\log p(x) - \log q(x)]\) | 평균을 \(p\) 로 낸다. \(p\) 가 있는 곳에서 \(q\) 가 작으면 \(-\log q\) 가 폭발하므로 \(q\) 는 \(p\) 가 있는 모든 곳을 덮으려고 넓게 퍼진다(mode covering). | 2장의 최대우도 |
| reverse KL | \(D_{\mathrm{KL}}(q \Vert p) = \mathbb{E}_{x\sim q}[\log q(x) - \log p(x)]\) | 평균을 \(q\) 로 낸다. \(q\) 가 있는 곳에서 \(p\) 가 작으면 벌을 받으므로 \(q\) 는 \(p\) 가 거의 없는 곳을 피해 봉우리 하나에 붙는다(mode seeking). | 8장의 변분 추론(VAE 인코더 학습) |
봉우리가 두 개인 분포 \(p(x) = \frac12\mathcal{N}(x; -2, 0.6^2) + \frac12\mathcal{N}(x; 2, 0.6^2)\) 에 가우시안 \(q = \mathcal{N}(\mu, \sigma^2)\) 하나를 맞추는 실험으로 확인한다.
forward KL 의 해: 모멘트 매칭
\(\begin{align} D_{\mathrm{KL}}(p \,\|\, q) &= \underbrace{\mathbb{E}_p[\log p(x)]}_{q \text{ 와 무관}} + \mathbb{E}_p\!\left[\frac12\log(2\pi) + \log\sigma + \frac{(x - \mu)^2}{2\sigma^2}\right] \\ \frac{\partial}{\partial\mu}: &\; -\frac{\mathbb{E}_p[x - \mu]}{\sigma^2} = 0 \;\Rightarrow\; \mu^\ast = \mathbb{E}_p[x] \\ \frac{\partial}{\partial\sigma}: &\; \frac{1}{\sigma} - \frac{\mathbb{E}_p[(x - \mu)^2]}{\sigma^3} = 0 \;\Rightarrow\; \sigma^{\ast 2} = \operatorname{Var}_p[x] \end{align}\)
2장의 가우시안 MLE 와 같은 계산이고, 평균과 분산을 그대로 맞추는 것을 모멘트 매칭(moment matching)이라고 한다. 혼합 분포에서 \(\mathbb{E}_p[x] = 0\), \(\mathbb{E}_p[x^2] = 0.6^2 + 2^2 = 4.36\) 이므로 \(\mu^\ast = 0\), \(\sigma^\ast = \sqrt{4.36} \approx 2.09\) 다. 실제로는 거의 아무것도 없는 \(x = 0\) 에 중심을 두고 넓게 퍼져 두 봉우리를 모두 덮는 가우시안이다.
reverse KL 의 크기 짐작
reverse KL 은 닫힌 꼴로 풀리지 않아 격자 탐색으로 구한다. \(q\) 가 왼쪽 성분 \(g_1 = \mathcal{N}(-2, 0.6^2)\) 과 같다고 하면, \(x \approx -2\) 는 오른쪽 봉우리 중심에서 표준편차의 약 6.7배 떨어져 있어 \(g_2(x) \approx 0\) 이고 \(p(x) \approx \tfrac12 q(x)\) 다.
\(D_{\mathrm{KL}}(q \,\|\, p) = \mathbb{E}_q\!\left[\log\frac{q(x)}{p(x)}\right] \approx \mathbb{E}_q\!\left[\log\frac{q(x)}{\frac12 q(x)}\right] = \log 2 \approx 0.693\)
오른쪽 봉우리를 통째로 무시해도 대가는 \(\log 2\) 뿐이다. 둘 사이로 넓게 퍼지면 \(p \approx 0\) 인 골짜기에 질량을 두게 되어 더 큰 벌을 받는다.
격자 탐색 실험
def forward_reverse_kl(fig_dir: str) -> None:
    """봉우리가 두 개인 p 에 가우시안 q 하나를 맞춘다. KL 의 방향에 따라 결과가 다르다."""
    xs = np.linspace(-8, 8, 4001)
    dx = xs[1] - xs[0]

    def normal_pdf(x, mu, s):
        return np.exp(-((x - mu) ** 2) / (2 * s**2)) / (s * math.sqrt(2 * math.pi))

    p = 0.5 * normal_pdf(xs, -2, 0.6) + 0.5 * normal_pdf(xs, 2, 0.6)
    eps = 1e-300  # log 0 을 피하는 아주 작은 수

    def kl_num(a, b):  # 격자 위에서 적분: Σ a(x) log(a(x)/b(x)) Δx
        return float(np.sum(a * (np.log(a + eps) - np.log(b + eps))) * dx)

    best_fwd, best_rev = (None, math.inf), (None, math.inf)
    for mu in np.linspace(-3, 3, 121):
        for s in np.linspace(0.2, 3.0, 141):
            q = normal_pdf(xs, mu, s)
            f, r = kl_num(p, q), kl_num(q, p)
            if f < best_fwd[1]:
                best_fwd = ((mu, s), f)
            if r < best_rev[1]:
                best_rev = ((mu, s), r)
(출력과 그림을 그리는 나머지는 ch03_information.py 의 region fwd_rev 에 있다.)
[forward KL(p‖q) 최소] μ = +0.00, σ = 2.08  (KL = 0.555)
[reverse KL(q‖p) 최소] μ = -2.00, σ = 0.60  (KL = 0.692)
[참고] p 의 평균 = 0, 분산 = 0.6² + 2² = 4.36 → 표준편차 2.09
- 격자 탐색 결과(forward 의 σ = 2.08, reverse 의 KL = 0.692)가 손계산(각각 2.09, log 2 = 0.693)과 맞는다.
- \(p\) 가 좌우 대칭이라 reverse KL 에서는 오른쪽 봉우리(\(\mu = +2\))도 똑같이 좋은 답이다.
- 그림: 그림 3-3. 왼쪽은 forward KL 로 맞춘 넓고 가운데에 놓인 가우시안, 오른쪽은 reverse KL 로 맞춘 한쪽 봉우리 가우시안
World Model 에서의 의미는 다음과 같다.
- MSE(가우시안 최대우도)로 학습한 World Model 이 갈림길에서 흐릿한 평균을 예측하는 것(1장의 다봉성 문제)은 forward KL 의 "덮기" 성질 때문이다.
- VAE 의 인코더는 reverse KL 로 학습되어 실제 사후 분포보다 좁은(자신만만한) 분포를 내는 경향이 있다.
- 어느 쪽이 좋고 나쁜 것이 아니라 성격이 다르다.
원문의 대화형 데모(두 가우시안의 KL 을 양방향으로 계산)가 보여 주는 사실도 같다. \(q\) 를 좁게 만들어 \(p\) 의 한가운데에 두면 \(D_{\mathrm{KL}}(q \,\|\, p)\) 는 작지만 \(D_{\mathrm{KL}}(p \,\|\, q)\) 는 크다(\(p\) 의 꼬리를 \(q\) 가 못 덮는다). \(q\) 를 넓게 하면 반대가 된다. 두 값이 같아지는 것은 두 분포가 같을 때(둘 다 0)나 두 표준편차가 같을 때(\(\sigma_p = \sigma_q = \sigma\) 이면 둘 다 \((\mu_p - \mu_q)^2/(2\sigma^2)\)) 같은 특별한 경우뿐이다.
가우시안 사이의 KL
VAE, RSSM, Dreamer 는 학습 스텝마다 두 가우시안 사이의 KL 을 계산한다. 이 값은 적분 없이 평균과 표준편차만으로 계산되는 닫힌 꼴(closed form)이 있다. \(q = \mathcal{N}(\mu_1, \sigma_1^2)\), \(p = \mathcal{N}(\mu_2, \sigma_2^2)\) 로 두고 \(D_{\mathrm{KL}}(q \,\|\, p)\) 를 구한다.
닫힌 꼴 유도
\(\begin{align} D_{\mathrm{KL}}(q \,\|\, p) &= \mathbb{E}_{x \sim q}\big[\log q(x) - \log p(x)\big] \\ \log q(x) - \log p(x) &= \log\frac{\sigma_2}{\sigma_1} - \frac{(x - \mu_1)^2}{2\sigma_1^2} + \frac{(x - \mu_2)^2}{2\sigma_2^2} \\ D_{\mathrm{KL}} &= \log\frac{\sigma_2}{\sigma_1} - \frac{\mathbb{E}_q[(x - \mu_1)^2]}{2\sigma_1^2} + \frac{\mathbb{E}_q[(x - \mu_2)^2]}{2\sigma_2^2} \end{align}\)
두 로그 밀도의 \(-\tfrac12\log(2\pi)\) 는 서로 지워진다. 남은 두 기댓값 가운데 첫째는 \(q\) 의 분산 정의 그대로 \(\sigma_1^2\) 이다. 둘째는 \(\mu_1\) 을 뺐다 더해 전개한다.
\(\begin{align} (x - \mu_2)^2 &= (x-\mu_1)^2 + 2(x - \mu_1)(\mu_1 - \mu_2) + (\mu_1 - \mu_2)^2 \\ \mathbb{E}_q[(x - \mu_2)^2] &= \sigma_1^2 + 2(\mu_1 - \mu_2)\underbrace{\mathbb{E}_q[x - \mu_1]}_{=\,0} + (\mu_1 - \mu_2)^2 = \sigma_1^2 + (\mu_1 - \mu_2)^2 \end{align}\)
대입하면 가운데 항이 \(\sigma_1^2/(2\sigma_1^2) = 1/2\) 이 되어 닫힌 꼴이 나온다.
\(D_{\mathrm{KL}}\big(\mathcal{N}(\mu_1, \sigma_1^2) \,\|\, \mathcal{N}(\mu_2, \sigma_2^2)\big) = \log\frac{\sigma_2}{\sigma_1} + \frac{\sigma_1^2 + (\mu_1 - \mu_2)^2}{2\sigma_2^2} - \frac12\)
점검은 다음과 같다.
- 같은 분포(\(\mu_1 = \mu_2\), \(\sigma_1 = \sigma_2\)): \(\log 1 + \frac{\sigma^2 + 0}{2\sigma^2} - \frac12 = 0\).
- \(q = \mathcal{N}(1, 0.5^2)\), \(p = \mathcal{N}(0, 1)\): \(\log\frac{1}{0.5} + \frac{0.25 + 1}{2} - \frac12 = 0.6931 + 0.625 - 0.5 = 0.8181\).
- 순서를 바꾼 \(D_{\mathrm{KL}}(p \,\|\, q)\) (\(\mu_1 = 0, \sigma_1 = 1, \mu_2 = 1, \sigma_2 = 0.5\)): \(\log\frac{0.5}{1} + \frac{1 + 1}{2 \times 0.25} - \frac12 = -0.6931 + 4 - 0.5 = 2.8069\). 비대칭이 크다.
- 분산이 같으면 \((\mu_1 - \mu_2)^2/(2\sigma^2)\) 로 줄어든다.
표준 정규와의 KL (VAE 가 쓰는 특수형)
8장에서는 기준 분포가 표준 정규 \(p = \mathcal{N}(0, 1)\) 인 경우만 쓴다. \(\mu_2 = 0\), \(\sigma_2 = 1\) 을 넣고 \(\log\frac{1}{\sigma} = -\frac12\log\sigma^2\) 을 쓰면
\(D_{\mathrm{KL}}\big(\mathcal{N}(\mu, \sigma^2) \,\|\, \mathcal{N}(0, 1)\big) = \frac12\big(\mu^2 + \sigma^2 - 1 - \log\sigma^2\big)\)
\(\mu = 0\), \(\sigma = 1\) 일 때만 0 이고, 평균이 0 에서 멀어지거나 표준편차가 1 에서 멀어질수록 커진다. \(\mu = 1\), \(\sigma = 0.5\) 이면 \(\frac12(1 + 0.25 - 1 - \log 0.25) = \frac12(0.25 + 1.3863) = 0.8181\) 로 일반식과 같은 값이다.
대각 가우시안: 차원별 KL 의 합
잠재 변수는 보통 수십 차원이고 각 차원이 독립인 대각 가우시안이다. 밀도가 차원별 밀도의 곱이므로 로그는 차원별 로그의 합이고, 각 항은 \(x_d\) 에만 의존한다.
\(\begin{align} D_{\mathrm{KL}}(q \,\|\, p) &= \sum_{d=1}^D \mathbb{E}_{x \sim q}\big[\log q_d(x_d) - \log p_d(x_d)\big] \\ &= \sum_{d=1}^D \mathbb{E}_{x_d \sim q_d}\big[\log q_d(x_d) - \log p_d(x_d)\big] = \sum_{d=1}^D D_{\mathrm{KL}}(q_d \,\|\, p_d) \end{align}\)
예: \(\mu = (1, -0.5, 0)\), \(\sigma = (0.5, 1, 2)\) 이면 차원별로 0.8181, \(\frac12(0.25 + 1 - 1 - 0) = 0.125\), \(\frac12(0 + 4 - 1 - \log 4) = 0.8069\) 이고 합은 1.75 다.
닫힌 꼴, 몬테카를로, PyTorch 비교
def kl_gauss(mu1: float, s1: float, mu2: float, s2: float) -> float:
    """KL( N(μ1, s1²) ‖ N(μ2, s2²) ) 닫힌 꼴 = log(s2/s1) + (s1² + (μ1-μ2)²) / (2 s2²) - 1/2"""
    return math.log(s2 / s1) + (s1**2 + (mu1 - mu2) ** 2) / (2 * s2**2) - 0.5


def kl_to_standard_normal(mu: float, s: float) -> float:
    """VAE 에서 쓰는 특수형: KL( N(μ, s²) ‖ N(0, 1) ) = ½ (μ² + s² - 1 - log s²)"""
    return 0.5 * (mu**2 + s**2 - 1 - math.log(s**2))


def gaussian_kl_check(rng: np.random.Generator, n: int, fig_dir: str) -> None:
    mu1, s1, mu2, s2 = 1.0, 0.5, 0.0, 1.0
    closed = kl_gauss(mu1, s1, mu2, s2)

    # 몬테카를로: x ~ q 를 많이 뽑아 log q(x) - log p(x) 를 평균 낸다.
    def log_normal(x, mu, s):
        return -0.5 * math.log(2 * math.pi) - math.log(s) - (x - mu) ** 2 / (2 * s**2)

    x = rng.normal(mu1, s1, size=n)
    terms = log_normal(x, mu1, s1) - log_normal(x, mu2, s2)
    mc = terms.mean()
    lib = kl_divergence(Normal(mu1, s1), Normal(mu2, s2)).item()
    print(f"[가우시안 KL] 닫힌 꼴 {closed:.4f}  /  몬테카를로({n}개) {mc:.4f}  /  torch {lib:.4f}")
    print(f"[가우시안 KL] 특수형 ½(μ²+σ²-1-log σ²) = {kl_to_standard_normal(mu1, s1):.4f}")
    print(f"[가우시안 KL] 순서를 바꾼 KL(p‖q) = {kl_gauss(mu2, s2, mu1, s1):.4f}")

    # 대각 다변량: 차원별 KL 의 합
    mu_vec = torch.tensor([1.0, -0.5, 0.0])
    s_vec = torch.tensor([0.5, 1.0, 2.0])
    per_dim = 0.5 * (mu_vec**2 + s_vec**2 - 1 - torch.log(s_vec**2))
    lib_vec = kl_divergence(Normal(mu_vec, s_vec), Normal(torch.zeros(3), torch.ones(3)))
(출력의 나머지와 수렴 그림은 region gauss_kl 의 뒷부분에 있다.)
[가우시안 KL] 닫힌 꼴 0.8181  /  몬테카를로(1000000개) 0.8176  /  torch 0.8181
[가우시안 KL] 특수형 ½(μ²+σ²-1-log σ²) = 0.8181
[가우시안 KL] 순서를 바꾼 KL(p‖q) = 2.8069
[대각 다변량] 차원별 [0.8181, 0.125, 0.8069] → 합 1.7500 (torch 1.7500)
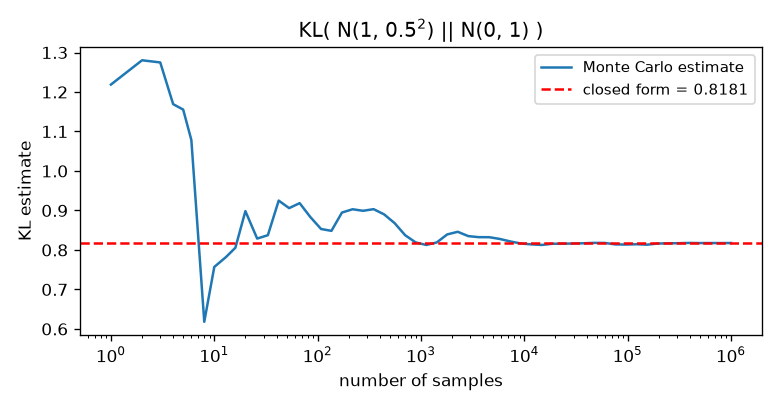
몬테카를로 추정은 표본 \(x \sim q\) 에서 \(\log q(x) - \log p(x)\) 를 평균 낸 값이고 2장의 큰 수의 법칙대로 수렴한다. 닫힌 꼴은 흔들림이 없고 빠르므로 가우시안끼리의 KL 은 늘 닫힌 꼴로 계산한다. 8장 VAE 코드에서는 이 식이 다음 한 줄이 된다.
# 인코더는 σ 대신 logvar = log σ² 를 출력한다 (σ² = exp(logvar) > 0 이 저절로 보장됨)
kl = 0.5 * torch.sum(mu.pow(2) + logvar.exp() - 1.0 - logvar) / batch   # 차원별 KL 을 모두 더해 그림 한 장당 평균
logvar.exp() 가 \(\sigma^2\), logvar 가 \(\log\sigma^2\), torch.sum(...) 이 차원별 KL 의 합, / batch 가 그림 한 장당 평균이다.
범주형 분포 사이의 KL
DreamerV2, V3(12장)는 잠재 변수를 가우시안 대신 범주형 분포 여러 개로 쓴다. 범주형 KL 은 정의 \(\sum_k q_k\log(q_k/p_k)\) 그대로 계산한다. \(q = (0.7, 0.2, 0.1)\) 과 균등 분포 \(p = (\frac13, \frac13, \frac13)\) 의 예는 다음과 같다.
\(\begin{align} D_{\mathrm{KL}}(q \,\|\, p) &= 0.7\log\frac{0.7}{1/3} + 0.2\log\frac{0.2}{1/3} + 0.1\log\frac{0.1}{1/3} \\ &= 0.7 \times 0.7419 + 0.2 \times (-0.5108) + 0.1 \times (-1.2040) = 0.5194 - 0.1022 - 0.1204 \\ &\approx 0.2968 = \log 3 - H(q) \end{align}\)
- 일부 항은 음수일 수 있지만 합은 늘 0 이상이다.
- \(H(q) = 0.2497 + 0.3219 + 0.2303 = 0.8018\) 이고 \(\log 3 - 0.8018 = 0.2968\) 이므로 \(D_{\mathrm{KL}}(q \,\|\, u) = \log K - H(q)\) 와 일치한다.
- DreamerV2 의 잠재 상태는 "32개 범주를 가진 범주형 변수 32개"이므로 KL 은 32개 범주형 KL 의 합이다(독립인 차원의 KL 은 더해진다).
상호정보량
상호정보량(mutual information)은 두 확률변수가 서로에 대해 얼마나 알려 주는지를 잰다. 실제 결합 분포가 독립이라고 가정한 분포(주변 분포의 곱)와 얼마나 다른지를 KL 로 잰 값이다.
\(I(X; Y) = D_{\mathrm{KL}}\big(p(x, y) \,\|\, p(x)\,p(y)\big) = \sum_{x, y} p(x, y)\log\frac{p(x, y)}{p(x)\,p(y)}\)
독립이면 \(I = 0\) 이고 그 밖에는 양수다. \(p(x, y)/p(y) = p(x \mid y)\) 를 써서 다른 모습으로 바꿀 수 있다.
\(\begin{align} I(X;Y) &= \sum_{x,y} p(x,y)\log\frac{p(x \mid y)}{p(x)} \\ &= -\sum_x p(x)\log p(x) - \Big(-\sum_{x,y} p(x,y)\log p(x \mid y)\Big) \\ &= H(X) - H(X \mid Y) \end{align}\)
\(H(X \mid Y) = -\sum_{x,y}p(x,y)\log p(x \mid y) = \sum_y p(y)\big[-\sum_x p(x \mid y)\log p(x \mid y)\big]\) 는 조건부 엔트로피로, \(Y\) 를 안 뒤에도 남는 \(X\) 의 불확실성이다(\(Y = y\) 인 경우별 엔트로피를 \(p(y)\) 로 가중 평균한 것). 상호정보량은 \(Y\) 를 알아서 줄어든 불확실성이다.
2장의 날씨·우산 결합 분포로 계산한다.
def mutual_information() -> None:
    # 날씨 X(맑음/비) 와 우산 Y(안 씀/씀) 의 결합 분포
    joint = np.array([[0.45, 0.05],  # 맑음: 안 씀, 씀
                      [0.10, 0.40]])  # 비  : 안 씀, 씀
    px = joint.sum(axis=1, keepdims=True)  # 주변 분포 p(x) (행의 합)
    py = joint.sum(axis=0, keepdims=True)  # 주변 분포 p(y) (열의 합)
    mi = np.sum(joint * np.log(joint / (px * py)))
    print(f"[상호정보량] p(x) = {px.ravel().tolist()}, p(y) = {py.ravel().tolist()}")
    print(f"[상호정보량] I(X;Y) = {mi:.4f} nats   (독립이면 0)")
    indep = px * py  # 독립이라면 결합 분포는 곱이 된다
    print(f"[상호정보량] 독립인 결합 분포로 계산하면 I = {np.sum(indep * np.log(indep / (px * py))):.4f}")
[상호정보량] p(x) = [0.5, 0.5], p(y) = [0.55, 0.45]
[상호정보량] I(X;Y) = 0.2754 nats   (독립이면 0)
[상호정보량] 독립인 결합 분포로 계산하면 I = 0.0000
손계산으로 점검하면 다음과 같다.
- \(H(X) = \log 2 = 0.6931\).
- 우산을 안 쓴 날의 날씨 분포는 \((0.45, 0.10)/0.55 = (0.818, 0.182)\) 로 엔트로피 0.4741, 쓴 날은 \((0.05, 0.40)/0.45 = (0.111, 0.889)\) 로 엔트로피 0.3488 이다.
- \(H(X \mid Y) = 0.55 \times 0.4741 + 0.45 \times 0.3488 = 0.4177\), \(I = 0.6931 - 0.4177 = 0.2754\). 우산을 보면 날씨에 대한 불확실성이 약 40% 줄어든다.
상호정보량은 이 튜토리얼에서 손실로 직접 쓰지 않지만 표현 학습 논문에 자주 나오는 개념이라 14장 용어집에도 정리되어 있다.
ELBO 미리 보기
잠재 변수 모델은 관측 \(x\) 의 확률을 숨은 \(z\) 에 대해 주변화한 적분으로 쓴다(00장 표기 규칙의 관측 \(o\) 와 같은 것이고, 8장이 VAE 논문의 관례대로 \(x\) 를 쓰므로 여기서도 \(x\) 를 쓴다).
\(p(x) = \int p(x \mid z)\,p(z)\,dz\)
이 적분은 보통 계산할 수 없다. 그래서 임의의 분포 \(q(z)\) 를 들여와(\(q(z) \gt 0\) 가정) 젠센 부등식으로 \(\log p(x)\) 의 하한을 만든다.
\(\begin{align} \log p(x) &= \log\int q(z)\,\frac{p(x \mid z)\,p(z)}{q(z)}\,dz = \log \mathbb{E}_{z \sim q}\!\left[\frac{p(x \mid z)\,p(z)}{q(z)}\right] \\ &\ge \mathbb{E}_{z \sim q}\!\left[\log\frac{p(x \mid z)\,p(z)}{q(z)}\right] \\ &= \mathbb{E}_{z \sim q}[\log p(x \mid z)] + \mathbb{E}_{z \sim q}\!\left[\log\frac{p(z)}{q(z)}\right] \\ &= \underbrace{\mathbb{E}_{z \sim q}[\log p(x \mid z)]}_{\text{복원 항}} \;-\; \underbrace{D_{\mathrm{KL}}\big(q(z) \,\|\, p(z)\big)}_{\text{규제 항}} \;=:\; \text{ELBO} \end{align}\)
첫 줄은 적분 안에 \(q(z)/q(z) = 1\) 을 곱한 것이고, 부등호는 \(\log\) 의 오목성(\(\log\mathbb{E}[Y] \ge \mathbb{E}[\log Y]\))이다. 오른쪽을 증거 하한(Evidence Lower BOund, ELBO)이라고 부른다. 첫째 항은 2장의 로그 가능도(NLL 의 반대), 둘째 항은 가우시안 KL 닫힌 꼴로 계산되고, 둘을 잇는 것이 젠센 부등식이다. 8장에서는 이 부등식이 언제 등식이 되는지, \(q\) 를 어떻게 고르는지(\(q_\phi(z \mid x)\)), \(\mathbb{E}_q\) 를 거쳐 어떻게 미분하는지(재매개변수화)를 다룬다.
정리
- 정보량 \(-\log p\) 는 "독립 사건의 놀람은 더해진다"는 요구에서 유일하게 나오는 꼴이다. 단위는 내트(자연로그) 또는 bit 다.
- 엔트로피 \(H(p) = \mathbb{E}_p[-\log p]\) 는 평균 놀람이자 불확실성이다. 균등 분포에서 최대 \(\log K\) 이고, 가우시안은 \(\frac12\log(2\pi e\sigma^2)\) 다.
- 교차 엔트로피는 \(H(p, q) = \mathbb{E}_p[-\log q]\), KL 은 \(H(p, q) - H(p) = \mathbb{E}_p[\log(p/q)]\) 다. 최대우도는 \(D_{\mathrm{KL}}(p_{\text{data}} \,\|\, p_\theta)\) 최소화와 같다.
- 젠센 부등식: 볼록 \(f\) 는 \(f(\mathbb{E} X) \le \mathbb{E} f(X)\), 오목한 \(\log\) 는 \(\log\mathbb{E} X \ge \mathbb{E}\log X\). 이것으로 \(D_{\mathrm{KL}} \ge 0\) 이 증명된다.
- forward KL \(D_{\mathrm{KL}}(p \,\|\, q)\) 은 모드를 덮고(평균·분산 맞추기), reverse KL \(D_{\mathrm{KL}}(q \,\|\, p)\) 은 모드 하나를 찾는다.
- 가우시안 KL 은 \(\log\frac{\sigma_2}{\sigma_1} + \frac{\sigma_1^2 + (\mu_1-\mu_2)^2}{2\sigma_2^2} - \frac12\), 표준 정규와는 \(\frac12(\mu^2 + \sigma^2 - 1 - \log\sigma^2)\), 대각이면 차원별 합이다.
- 상호정보량은 \(I(X;Y) = D_{\mathrm{KL}}(p(x,y) \,\|\, p(x)p(y)) = H(X) - H(X \mid Y)\) 다.
- ELBO: \(\log p(x) \ge \mathbb{E}_q[\log p(x \mid z)] - D_{\mathrm{KL}}(q(z) \,\|\, p(z))\). 8장의 출발점이다.
확인 문제
- 1. 공정한 주사위 한 번의 엔트로피
- 균등 분포이므로 \(H = \log 6 \approx 1.792\) 내트 \(= \log_2 6 \approx 2.585\) bit 다. 결과가 6가지인 분포가 가질 수 있는 최대 엔트로피다.
- 2. \(p = (0.5, 0.5)\), \(q = (0.9, 0.1)\) 의 양방향 KL
- \(D_{\mathrm{KL}}(p \,\|\, q) = 0.5(-0.5878) + 0.5(1.6094) = 0.5108\), \(D_{\mathrm{KL}}(q \,\|\, p) = 0.9(0.5878) + 0.1(-1.6094) = 0.3681\). 비대칭이다.
- 3. \(D_{\mathrm{KL}}(\mathcal{N}(2, 1) \,\|\, \mathcal{N}(0, 1))\) 과 \(D_{\mathrm{KL}}(\mathcal{N}(0, 4) \,\|\, \mathcal{N}(0, 1))\)
- 첫째는 특수형으로 \(\frac12(4 + 1 - 1 - 0) = 2\) 다. 둘째는 \(\sigma^2 = 4\) 이므로 \(\frac12(0 + 4 - 1 - \log 4) = \frac12(3 - 1.386) = 0.807\) 이다.
- 4. 젠센 부등식으로 산술평균 ≥ 기하평균 증명 (양수 \(a, b\))
- \(\log\) 는 오목하므로 \(\log\frac{a + b}{2} \ge \frac12\log a + \frac12\log b = \log\sqrt{ab}\) 이고, \(\log\) 는 증가 함수이므로 \(\frac{a+b}{2} \ge \sqrt{ab}\) 다.
- 5. 데이터 분포가 봉우리 두 개인데 모델이 가우시안 하나일 때 최대우도 해의 모양
- 최대우도는 forward KL \(D_{\mathrm{KL}}(p_{\text{data}} \,\|\, p_\theta)\) 최소화다. 데이터가 있는 곳에서 모델 확률이 작으면 큰 벌을 받으므로 두 봉우리를 모두 덮는 넓은 가우시안(평균은 두 봉우리 사이)이 된다.
- 6. ELBO 의 젠센 부등식이 등식이 되는 \(q(z)\)
- \(\frac{p(x \mid z)p(z)}{q(z)} = c\) (상수)이면 \(q(z) \propto p(x, z)\) 이고, 정규화하면 \(q(z) = p(x, z)/p(x) = p(z \mid x)\), 곧 진짜 사후 분포다. 이때 \(c = p(x)\) 이고 ELBO \(= \log p(x)\) 다. 8장에서 \(\log p(x) = \text{ELBO} + D_{\mathrm{KL}}(q \,\|\, p(z \mid x))\) 라는 등식으로 다시 유도한다.
See also
- World Models:Tutorial
- World Models
- Information Theory
- Entropy
- Cross entropy
- Maximum likelihood estimation
- Normal distribution
- VAE