WorldModels:Tutorial
lastmod 2026-11-18created 2026-11-173 edits
World Model 튜토리얼은 딥러닝의 World Model(세계 모델)을 머신러닝 초급자가 처음부터 끝까지 혼자 따라갈 수 있게 쓴 15개 장짜리 글이다. 확률, 정보 이론, 딥러닝, 강화학습을 차례로 쌓은 뒤, 64×64 그림만 보고 진자를 세우는 법을 상상 속에서 배우는 Dreamer 까지 PyTorch 로 직접 구현한다. 이 문서는 튜토리얼의 지도이고, 장마다 내용을 정리한 문서가 따로 있다.
- 원문: World Model 튜토리얼 (pages.unwiki.net)
- 무대: 처음부터 끝까지 진자 스윙업(pendulum swing-up) 환경 하나만 쓴다. 처음에는 숫자 3개로, 8장부터는 64×64 흑백 그림으로 본다.
- 수식 유도는 줄을 건너뛰지 않고, 모든 핵심 개념을 실제로 실행한 코드와 그 결과 그림으로 확인한다.
World Model 을 한 문장으로
World Model 은 "지금 상태에서 이 행동을 하면 다음에 무슨 일이 일어날까" 를 예측하도록 학습한 신경망이다. 이 예측기가 있으면 에이전트는 실제로 해 보지 않고도 머릿속에서 미리 시뮬레이션할 수 있고, 그 상상으로 계획을 세우거나 행동을 배울 수 있다.
\((s_t,\ a_t) \;\xrightarrow{\ \text{World Model}\ }\; (\hat{s}_{t+1},\ \hat{r}_t)\)
진짜 값 \(s_{t+1}\) 과 예측 \(\hat{s}_{t+1}\) 이 가까워지도록 신경망을 학습시키는 것이 가장 단순한 형태다. 여기에 "그림을 보고", "불확실성까지", "긴 시간을 기억하며", "상상 속에서 행동을 배우는" 능력을 하나씩 더해 가는 것이 튜토리얼의 줄거리다.
목차
전체는 네 단계로 나뉘고, 앞 단계가 뒤 단계의 재료가 된다.
1단계: 기초 체력 (01 – 05장)
World Model 이 왜 필요한지 설명하고, 가우시안 · 최대우도 · KL 발산을 손으로 계산하고, PyTorch 로 신경망을 학습하고, 벨만 방정식을 유도할 수 있게 된다.
- 01. World Model 이란 무엇인가 - 머릿속 시뮬레이터라는 직관, 강화학습에서의 모델, model-free 와 model-based, Dyna, 역사, 분류, 네 가지 어려움.
- 02. 수학 ① 확률과 최대우도 - 확률변수, 결합 · 조건부 확률, 베이즈 정리, 기댓값 · 분산, 몬테카를로, 가우시안 분포, 최대우도 추정, MSE · BCE · 교차 엔트로피 손실의 정체.
- 03. 수학 ② 정보 이론과 KL 발산 - 정보량, 엔트로피, 교차 엔트로피, KL 발산, 젠센 부등식, 가우시안 KL 의 닫힌 꼴, 상호정보량, ELBO 미리 보기.
- 04. 딥러닝과 PyTorch 기초 - 미분과 연쇄 법칙, 경사 하강법, 역전파 손계산, Adam, 과적합, CNN 과 전치 합성곱.
- 05. 강화학습 기초 - MDP, 리턴, 가치 함수, 벨만 방정식, 가치 반복, REINFORCE, 액터-크리틱, 재매개변수화 경사, POMDP.
2단계: 첫 World Model (06 – 07장)
숫자로 된 상태를 보고 다음 상태를 예측하는 모델을 만들고, 그 모델 안에서 계획을 세워 진자를 실제로 세운다.
- 06. 첫 번째 World Model - 진자의 운동 방정식 유도, 오일러 적분, MLP 동역학 모델, 표준화와 변화량 예측, 열린 고리 롤아웃과 오차 누적.
- 07. 상상으로 계획하기: MPC 와 CEM - 모델 예측 제어, 랜덤 슈팅, 교차 엔트로피 방법, 모델 착취, 확률적 앙상블과 PETS.
3단계: 그림을 보는 World Model (08 – 10장)
그림을 작은 잠재 벡터로 압축하고, 잠재 공간에서 미래를 예측하고, 모델이 꾸는 "꿈" 속에서 행동을 배운다.
- 08. 눈 만들기: VAE - 잠재 변수 모델, ELBO 의 두 가지 유도, KL 닫힌 꼴, 재매개변수화 트릭, 합성곱 VAE 구현, β-VAE 와 사후 붕괴.
- 09. 기억 만들기: RNN 과 MDN-RNN - RNN, BPTT 와 기울기 소실, LSTM · GRU, 혼합 밀도 네트워크, log-sum-exp, 온도 샘플링, 잠재 공간에서 꿈꾸기.
- 10. World Models (Ha & Schmidhuber) - V · M · C 구조, 진화 전략의 기울기 유도, CMA-ES 구현, 진짜 환경 학습과 꿈속 학습, 온도와 모델 착취.
4단계: 상상 속 학습과 현대 모델 (11 – 14장)
RSSM 의 학습 목표(순차 ELBO)를 직접 유도하고, Dreamer 를 구현해 그림만 보고 진자를 세우고, 현대 World Model 계열의 위치를 이해한다.
- 11. RSSM 과 PlaNet - 잠재 상태 공간 모델, RSSM 의 다섯 부품, 순차 ELBO 유도, 자유 내트, 잠재 공간 CEM, 구현과 결과.
- 12. Dreamer: 상상 속에서 배우는 행동 - 상상 궤적, n-스텝 · λ-리턴, 동역학을 거슬러 미분하는 액터 학습, DreamerV2 · V3 의 기법.
- 13. 현대 World Model 지형도 - MuZero, TD-MPC, Transformer World Model, 확산 World Model, JEPA, 대규모 비디오 · 상호작용 World Model.
- 14. 부록: 디버깅 · 용어집 · 다음 걸음 - 디버깅 점검 순서, 수치 안정성 공식, 하이퍼파라미터 참고표, 장별 핵심 수식, 용어집, 논문 지도, 공개 구현.
읽는 방법
| 길 | 대상 | 읽는 법 |
| A. 직관의 길 | 개념만 빨리 잡고 싶을 때 | 01, 05 앞부분, 06, 08, 10, 12, 13장의 설명 · 그림 · 핵심 상자만 읽고, 유도는 결과 줄만 본다. |
| B. 수학의 길 | 논문을 읽을 수 있게 되고 싶을 때 | 모든 장을 순서대로 읽으며 유도를 한 줄씩 종이에 따라 쓰고, 확인 문제를 푼다. |
| C. 구현의 길 | 직접 만들어 보고 싶을 때 | B 에 더해 각 장의 코드를 직접 실행하고, "직접 바꿔 보기" 실험을 한다. |
수식에서 막히면 2 · 3장으로 돌아가 해당 개념을 다시 보고, 모르는 용어는 14장 부록의 용어집에서 찾는다.
준비물
배경지식
- Python 기초: 변수, 함수, for 반복문, 리스트, 클래스를 읽을 수 있는 정도.
- 고등학교 수학: 함수, 지수 · 로그, 그래프, 간단한 미분.
- 선형대수, 확률, 미적분, 딥러닝, 강화학습은 몰라도 된다. 필요한 만큼 2 – 5장에서 처음부터 설명한다.
컴퓨터
- Windows · macOS · Linux 어느 것이든 되고, 메모리는 8GB 이상이면 충분하다.
- 10장까지는 GPU 가 없어도 된다. 2 – 7장은 CPU 로 몇 초 – 20분, 8 – 10장은 CPU 로 20분 – 1시간(GPU 면 2 – 15분)이 걸린다.
- 11 · 12장(그림을 보는 PlaNet · Dreamer)은 GPU 가 필요하다. 노트북 GPU(8GB)로 각각 45분 – 1시간 남짓 걸리고, CPU 로는 하루 이상 걸린다.
- 장별 실습 파일에는 몇 초 – 1분 안에 끝나는 축소판
--quick옵션이 있다(1초면 끝나는ch13_numbers.py만 예외).
설치
Python 3.10 이상이 필요하다.
python --version          # Python 3.10 이상인지 확인 (macOS · Linux 는 python3)
mkdir world-model && cd world-model
python -m venv .venv       # 이 폴더 전용 Python 환경 만들기
source .venv/bin/activate  # Windows 는: .venv\Scripts\activate
pip install torch numpy matplotlib   # 또는: pip install -r requirements.txt
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
requirements.txt 의 최소 버전은 torch>=2.2, numpy>=1.26, matplotlib>=3.8 이다. NVIDIA GPU 를 쓰려면 PyTorch 설치 안내에서 환경에 맞는 명령을 골라 CUDA 판 torch 를 설치한다.
실습 코드
각 장의 코드는 원문의 code/ 폴더에 있다(wm_envs.py 처럼 https://pages.unwiki.net/world-model/code/ 아래에서 받는다). 받은 파일은 모두 같은 폴더에 두고 그 폴더에서 실행하며, 실습 파일이 만드는 그림은 그 아래 figures/ 에 저장된다. 뒤 장의 파일은 앞 장의 파일이나 결과를 불러다 쓰므로 순서를 지킨다.
걸린 시간은 노트북 CPU 4스레드와 노트북 GPU 8GB 에서 기본 설정으로 잰 값이다.
| 파일 | 장 | 먼저 필요한 것 | 걸린 시간 |
| | 4장부터 | - | 몇 초 (진자 환경. 진자를 쓰는 실습 파일이 모두 불러온다) |
| | 02 | - | CPU 몇 초 |
| | 03 | - | CPU 몇 초 |
| | 04 | - | CPU 3 – 6분 |
| | 05 | - | CPU 30초 안쪽 |
| | 06 | - | CPU 약 1분 |
| | 07 | | CPU 6 – 10분 |
| | 07 | | CPU 약 20분 |
| | 08 | - | GPU 2 – 4분 / CPU 약 50분 |
| | 09 | | GPU 2 – 3분 / CPU 약 20분 |
| | 10 | | GPU 약 15분 / CPU 약 1시간 |
| | 11 | - | GPU 약 1시간 (CPU 는 하루 이상) |
| | 12 | | GPU 약 45분 (CPU 는 하루 이상) |
| | 13 | - | CPU 1초 · 약 2분 |
환경 파일만 먼저 실행하면 확인용 진자 그림 한 장이 실행한 폴더에 pixel_pendulum.png 로 저장된다.
$ python wm_envs.py
상태 관측 (201, 3) 행동 (200, 1) 보상 합 -1071.9
그림 관측 (201, 64, 64) uint8 값 범위 0 255
pixel_pendulum.png 저장
진자 환경
모든 실습은 진자 스윙업이라는 작은 세상에서 한다. 물리 법칙은 OpenAI Gym(지금의 Gymnasium)의 Pendulum-v1 과 같고, gymnasium 을 설치하지 않아도 되도록 numpy 만으로 직접 구현했다. 운동 방정식은 6장에서 뉴턴 법칙부터 유도한다.
- 상태: 막대의 각도 \(\theta\) 와 각속도 \(\dot{\theta}\). \(\theta = 0\) 이면 막대가 위로 똑바로 서 있고, \(\pm\pi\) 이면 아래로 매달려 있다.
- 행동: 축에 거는 토크 \(u \in [-2, 2]\).
- 보상: \(r = -(\theta^2 + 0.1\,\dot{\theta}^2 + 0.001\,u^2)\). 위에 가만히 서 있을 때 가장 큰 값 0 을 받는다.
- 관측: 숫자 판
Pendulum은 \([\cos\theta,\ \sin\theta,\ \dot\theta]\) 를 주고(5 – 7 · 13장), 그림 판PixelPendulum은 같은 진자를 64×64 흑백 그림으로 준다(4 · 8 – 12장). - 어려운 점: 토크 한계(2)가 중력이 막대를 돌리는 토크(최대 \(mgl/2 = 5\))보다 약해서 한 번에 들어 올릴 수 없다. 그네처럼 앞뒤로 흔들어 에너지를 모은 뒤 세워야 한다.
- 한 스텝은 0.05초이고 한 에피소드는 200 스텝(10초)이다. 각속도는 ±8 rad/s 로 잘린다.
- 그림: 64×64 흑백 그림으로 본 진자 환경 (무작위 행동, 25 스텝 간격)
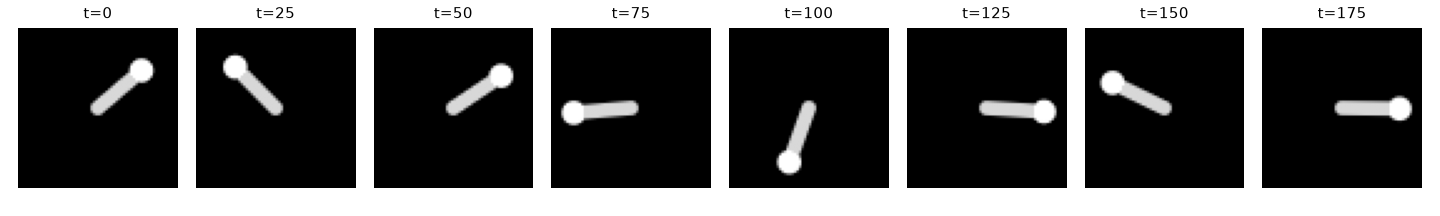
step() 안의 세 줄(속도 갱신, 속도 자르기, 각도 갱신)이 이 세상의 물리 법칙 전부다. World Model 은 이 세 줄을 보지 못한 채 (상태, 행동, 다음 상태) 데이터만 보고 비슷한 함수를 배워야 한다.
    def _obs(self) -> np.ndarray:
        # θ 를 그대로 주지 않고 (cos θ, sin θ) 로 주는 까닭:
        # θ = π 와 θ = -π 는 같은 자세인데 숫자로는 2π 나 떨어져 있다.
        # cos · sin 은 이 '이음매' 가 없어서 신경망이 배우기 쉽다.
        return np.array([np.cos(self.th), np.sin(self.th), self.thdot], dtype=np.float32)

    def step(self, action) -> tuple[np.ndarray, float, bool]:
        u = float(np.clip(np.asarray(action, dtype=np.float64).reshape(-1)[0], -self.max_torque, self.max_torque))
        th, thdot = self.th, self.thdot

        # 보상은 '움직이기 전' 상태로 계산한다 (Gym 과 같다).
        cost = angle_normalize(th) ** 2 + 0.1 * thdot**2 + 0.001 * u**2

        # 물리: θ̈ = (3g / 2l)·sin θ + (3 / m l²)·u     (6장에서 유도한다)
        # 오일러 적분: 속도를 먼저 갱신하고, 새 속도로 각도를 갱신한다 (semi-implicit Euler).
        thdot_new = thdot + (3.0 * self.g / (2.0 * self.l) * np.sin(th) + 3.0 / (self.m * self.l**2) * u) * self.dt
        thdot_new = float(np.clip(thdot_new, -self.max_speed, self.max_speed))
        th_new = th + thdot_new * self.dt

        self.th, self.thdot = th_new, thdot_new
        self.t += 1
        done = self.t >= self.max_steps
        return self._obs(), float(-cost), done
인터페이스는 obs = env.reset(), obs, reward, done = env.step(action) 으로 단순하게 했다(Gymnasium 의 step 은 값 다섯 개를 돌려준다).
표기 규칙
튜토리얼 전체와 장별 문서에서 같은 기호를 쓴다. \(\log\) 는 모두 자연로그다.
튜토리얼의 기호
| 기호 | 뜻 |
| \(s_t\) | 환경의 진짜 상태(state). 진자에서는 \((\theta, \dot{\theta})\) |
| \(o_t\) | 관측(observation). 에이전트가 실제로 보는 것. 6 · 7장은 \([\cos\theta, \sin\theta, \dot\theta]\), 8장부터는 64×64 그림 |
| \(a_t\) | 행동(action). 진자에서는 토크 \(u\) |
| \(r_t\) | 보상(reward). \(s_t\) 에서 \(a_t\) 를 했을 때 받는 점수 |
| \(z_t\) | 잠재 변수(latent). 관측을 압축한 작은 벡터 (8장부터) |
| \(h_t\) | 은닉 상태(hidden state). RNN 이 들고 다니는 기억 (9장부터) |
| \(T\), \(H\) | \(T\): 에피소드 · 시퀀스 길이. \(H\): 계획 · 상상의 길이(horizon) |
| \(p_\theta\) | 매개변수 \(\theta\) 를 가진 모델이 정하는 분포(World Model) |
| \(q_\phi\) | 매개변수 \(\phi\) 를 가진 인코더가 정하는 분포(관측을 보고 잠재 변수를 추측) |
| \(\pi_\psi\), \(v_\xi\) | 정책(actor)과 가치 함수(critic) |
| \(\mathcal{D}\) | 모아 둔 데이터(경험)의 집합. 리플레이 버퍼 |
그리스 문자
| 기호 | 읽는 법 | 주로 쓰는 뜻 |
| \(\theta\) | 세타 | ① 진자의 각도 ② World Model 신경망의 매개변수. 문맥으로 구별한다 |
| \(\phi\) | 파이 (phi) | 인코더 신경망의 매개변수 |
| \(\psi\) | 프사이 | 정책(actor)의 매개변수 |
| \(\xi\) | 크사이 | 가치 함수(critic) 신경망의 매개변수 |
| \(\mu\), \(\sigma\) | 뮤, 시그마 | 평균, 표준편차(\(\sigma^2\) 은 분산). 괄호가 붙은 \(\sigma(z)\) 는 시그모이드 함수 |
| \(\epsilon\) | 엡실론 | 표준 정규 분포에서 뽑은 잡음, 또는 아주 작은 수 |
| \(\gamma\) | 감마 | 할인율(0 – 1) |
| \(\lambda\) | 람다 | λ-리턴의 섞는 비율(12장). 고윳값(4 · 6장), CMA-ES 의 후보 수(10장)로도 쓴다 |
| \(\eta\) | 에타 | 학습률. 12장에서는 엔트로피 계수로도 쓴다 |
| \(\pi\) | 파이 (pi) | ① 원주율 ② 정책 \(\pi(a \mid s)\) ③ \(\pi_k\) 는 \(k\) 번째 범주 · 혼합 성분의 확률(2 · 9장) |
| \(\tau\) | 타우 | ① 궤적(trajectory) ② 진자에 거는 토크(6장) ③ 표본을 뽑을 때의 온도(9 · 10 · 13장) |
자주 쓰는 기호
| 기호 | 뜻 |
| \(x_{1:T}\) | \(x_1, x_2, \dots, x_T\) 를 한꺼번에 부르는 이름 |
| \(\hat{x}\) | 모델이 예측 · 추정한 \(x\) |
| \(\dot{\theta}\), \(\ddot{\theta}\) | \(\theta\) 의 시간 변화율(속도), 가속도 |
| \(x \sim p\) | \(x\) 를 분포 \(p\) 에서 뽑는다(샘플링) |
| \(\mathbb{E}_{x \sim p}[f(x)]\) | \(x\) 를 \(p\) 에서 여러 번 뽑아 \(f(x)\) 를 평균 낸 값 (2장) |
| \(\mathcal{N}(\mu, \sigma^2)\) | 평균 \(\mu\), 분산 \(\sigma^2\) 인 가우시안 분포 (2장) |
| \(D_{\mathrm{KL}}(q \,\Vert\, p)\) | 두 분포가 얼마나 다른지 재는 KL 발산 (3장) |
| \(\nabla_\theta L\) | \(L\) 을 \(\theta\) 의 각 성분으로 미분한 값을 모은 기울기 벡터 (4장) |
| \(\operatorname*{arg\,max}_x f(x)\) | \(f(x)\) 를 가장 크게 만드는 \(x\) |
| \(a \odot b\) | 원소별 곱 |
| \(\operatorname{sg}(x)\) | 기울기 차단(stop-gradient). 값은 그대로 쓰되 이 부분으로는 기울기를 흘리지 않는다 (12장) |
다루지 않는 것
- 대규모 모델의 분산 학습, 하드웨어 최적화.
- 로봇 실기 적용, 안전성 검증 같은 실무 배포 문제.
- Sora · Genie 같은 초대형 비디오 World Model 의 구현. 13장에서 원리와 위치만 설명한다. 그 바탕인 잠재 공간과 자기회귀 예측은 앞 장들에서, 확산 모델은 13장의 작은 실습에서 다룬다.
See also
- World Models
- Recurrent World Models Facilitate Policy Evolution - 10장이 다루는 Ha & Schmidhuber 의 논문
- Reinforcement learning
- Deep learning
- PyTorch
- VAE
- Physical AI